
这个项目的设计目标只有一句:装完依赖点一下运行,剩下全在网页上配。
不改配置文件,不跑初始化脚本,不重启服务。换厂商、换向量库、调 RAG 参数、
上传知识库,全部在管理后台点几下完成,改完立即生效。
- 在线仓库:https://github.com/vfaner/intelligent-customer-service
- 技术栈:Python 3.11+ / FastAPI / 原生 JS(前端零依赖、免构建)
- 协议:MIT,可自由商用
一、效果预览
1.1 模型配置:选厂商就自动填好
15 项厂商预设。选中厂商后 Base URL 和默认模型自动填充,协议下拉按该厂商实际
支持的协议动态生成。填完 Key 点「测试连接」,直接看到模型的真实回复。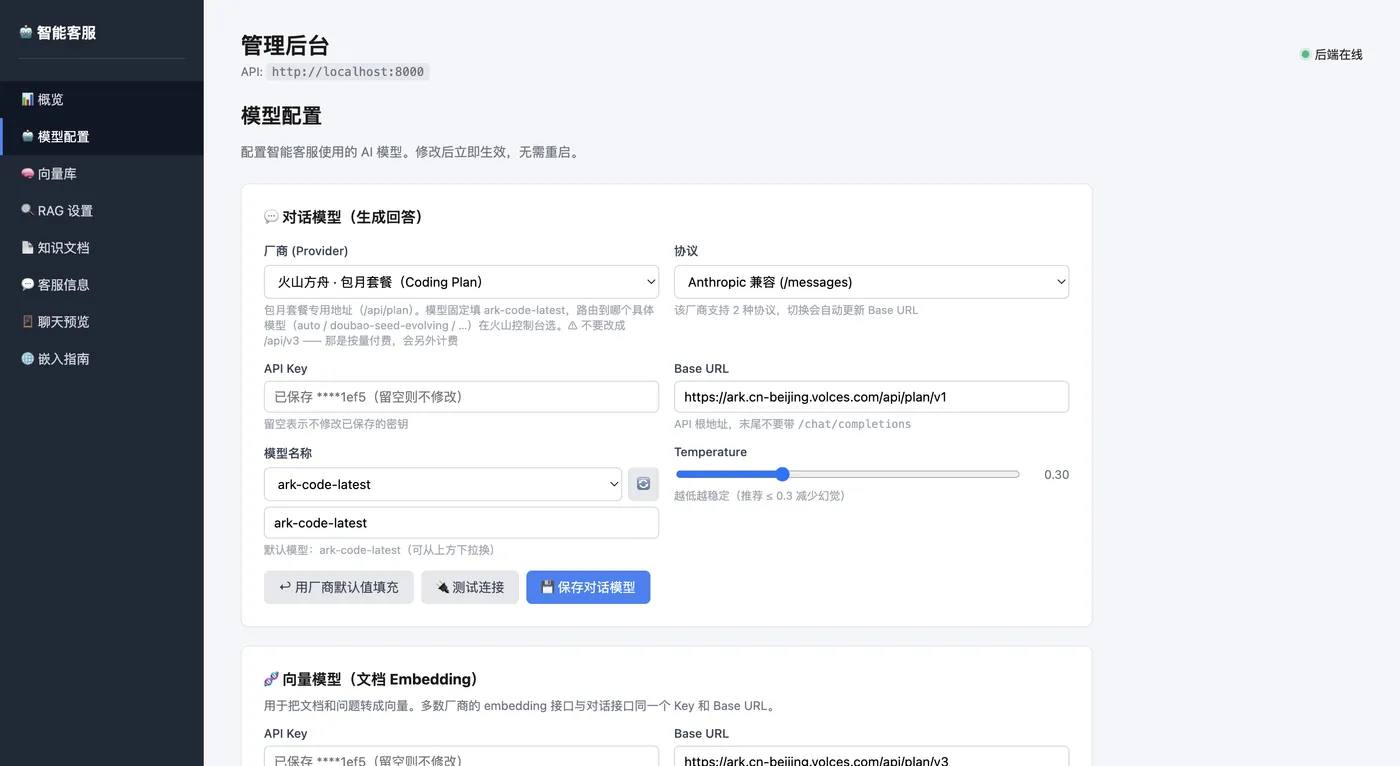
右边还有个「🔄」按钮 —— 点它会调厂商的 /models 接口,拉取你这个账号真正能用的
模型列表,而不是让你对着文档猜模型名。拉不到就自动回退到内置推荐列表,不会卡住。
1.2 RAG 设置:参数不用猜,能预览
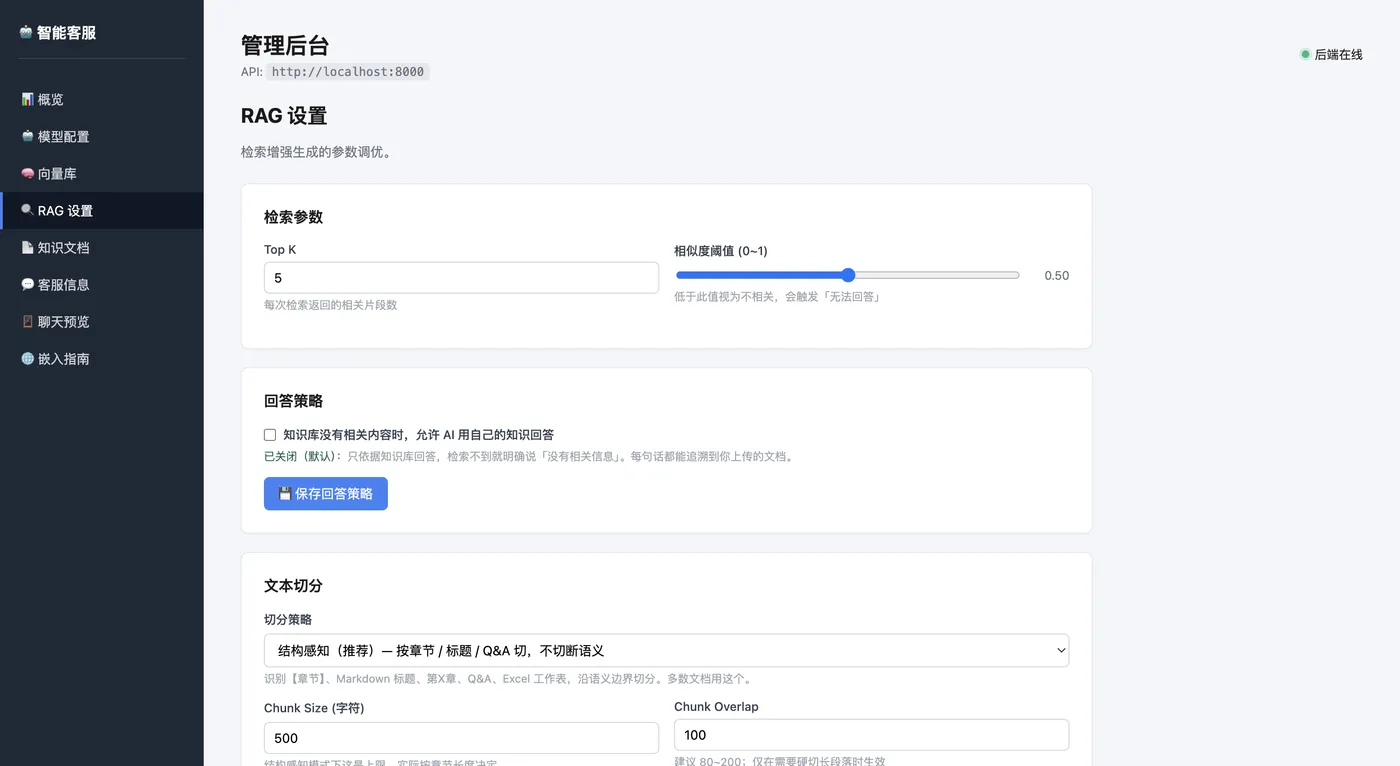
Top-K、相似度阈值、切分策略都在这里。关键是那个「🔍 预览切分效果」按钮 ——
选一份已上传的文档或直接粘贴文本,立刻看到会被切成多少片、每片多长、
归属哪个章节,不用真的入库消耗 embedding 配额。
调参数这件事,能看到结果和纯靠猜,完全是两种体验。
1.3 向量库:三选一,只显示相关字段
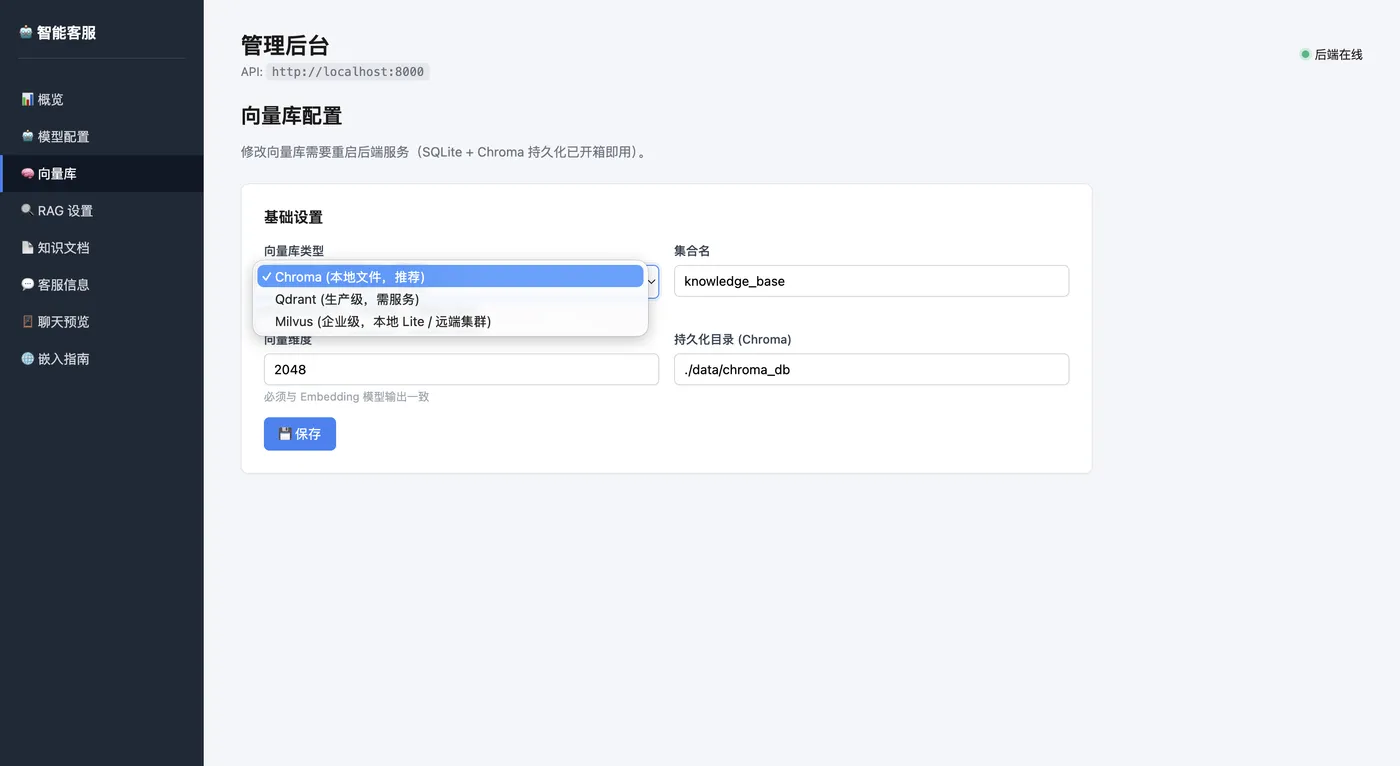
Chroma(默认,本地文件零部署)/ Qdrant / Milvus 三选一。选中哪个就只显示它需要的
字段 —— 选 Chroma 不会让你看到一堆 Qdrant 的连接参数。
Milvus 支持 Milvus Lite:Base URI 填个 .db 文件路径就能跑,不用装 etcd 和 minio。
1.4 客服信息:改一次,所有站点生效
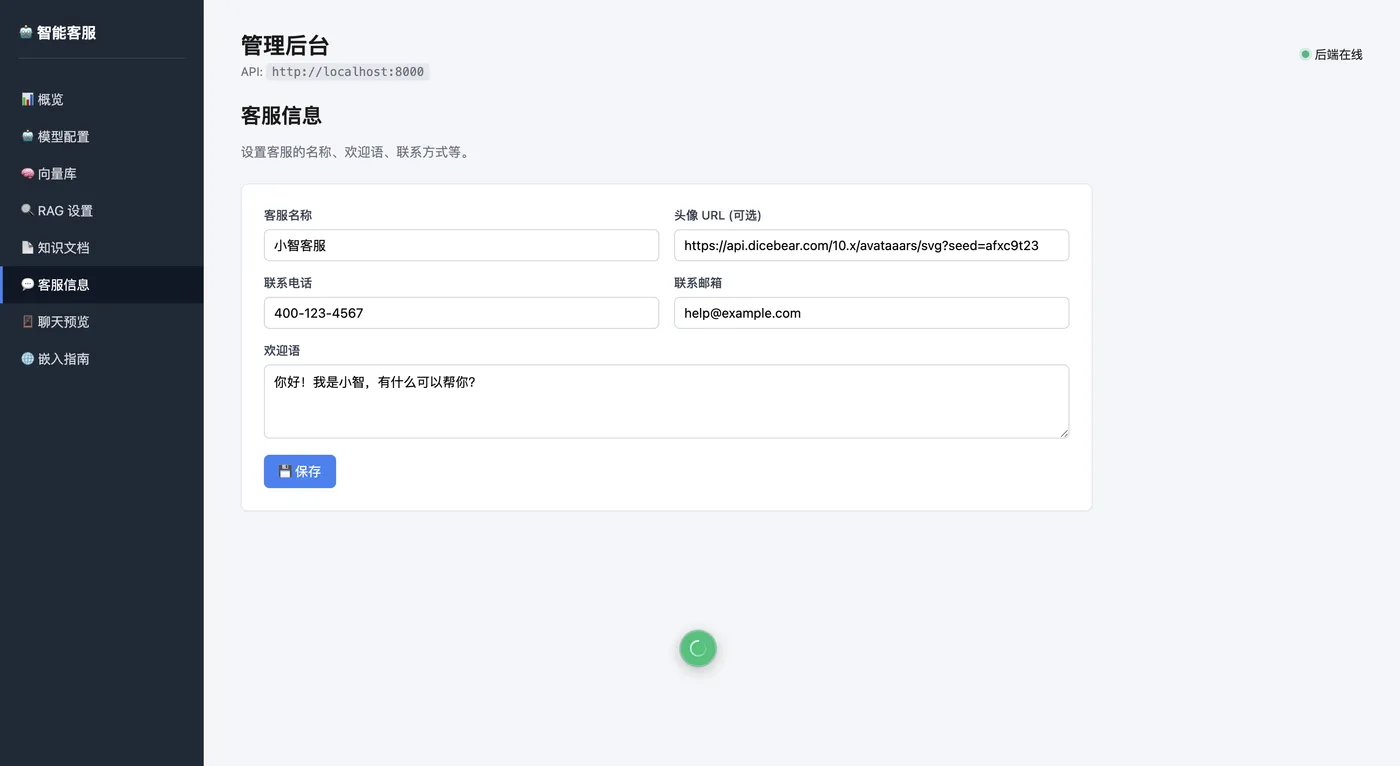
名称、头像、欢迎语、联系方式。这里改完,所有已经嵌入到各个网站的组件都会同步 ——
因为组件启动时会自己来读这份配置,不需要你去改每个站点的嵌入代码。
1.5 聊天预览:后台里直接测
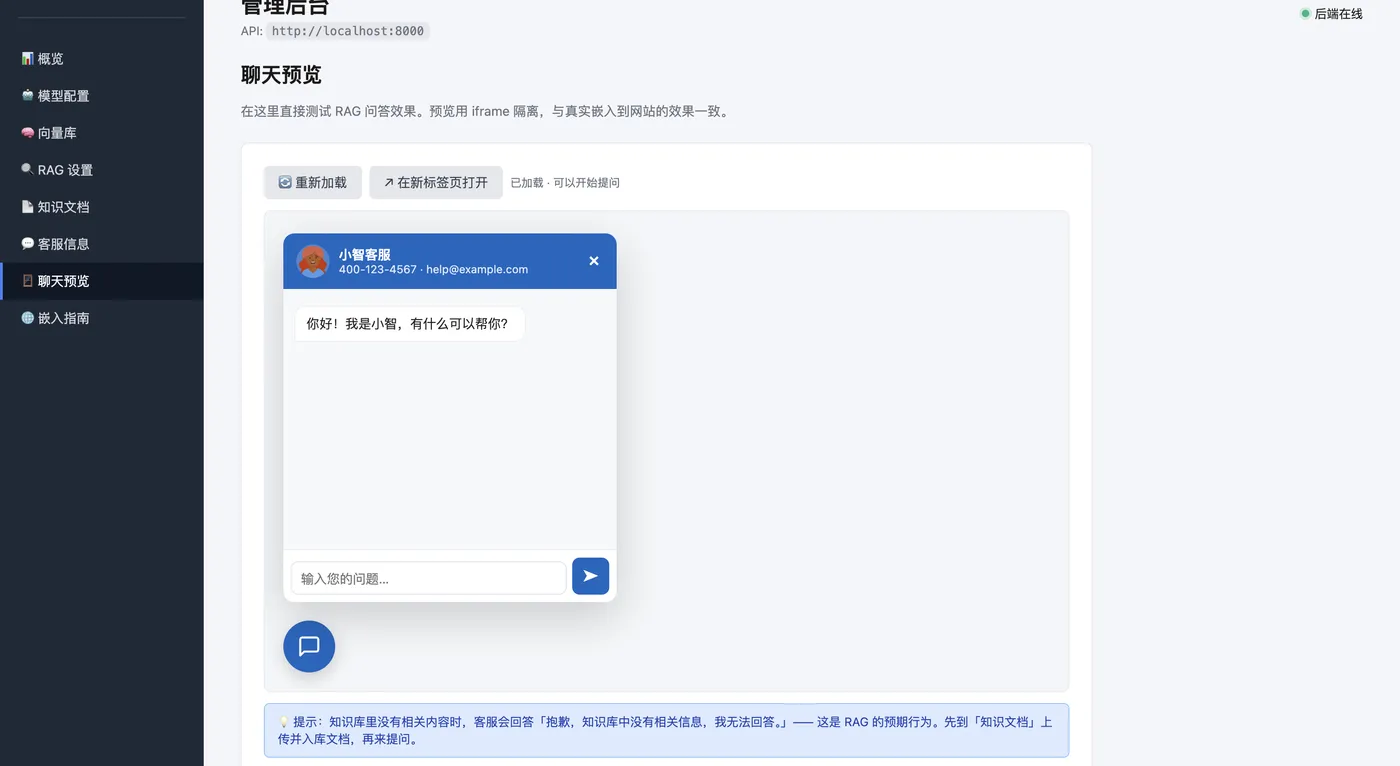
配完不用切页面,就在后台里问。答案里的 Markdown 会正常渲染(加粗、列表、代码块),
文章链接是可点击的超链接而不是一串纯文本。
1.6 嵌入指南:三种方式,一键复制
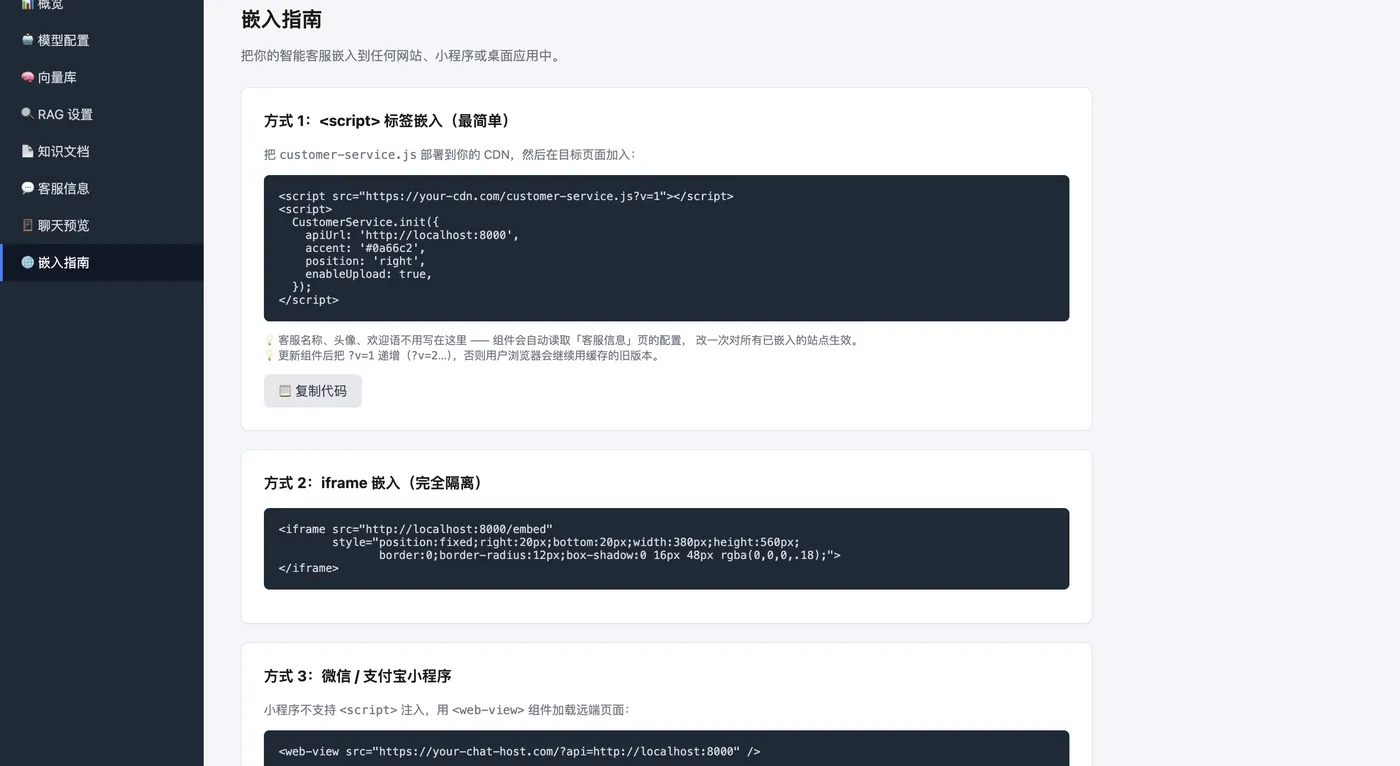
<script> 标签 / iframe / 小程序 web-view,代码直接复制。
1.7 装到网站上是什么样
右下角一个浮动按钮,点开就是聊天窗口: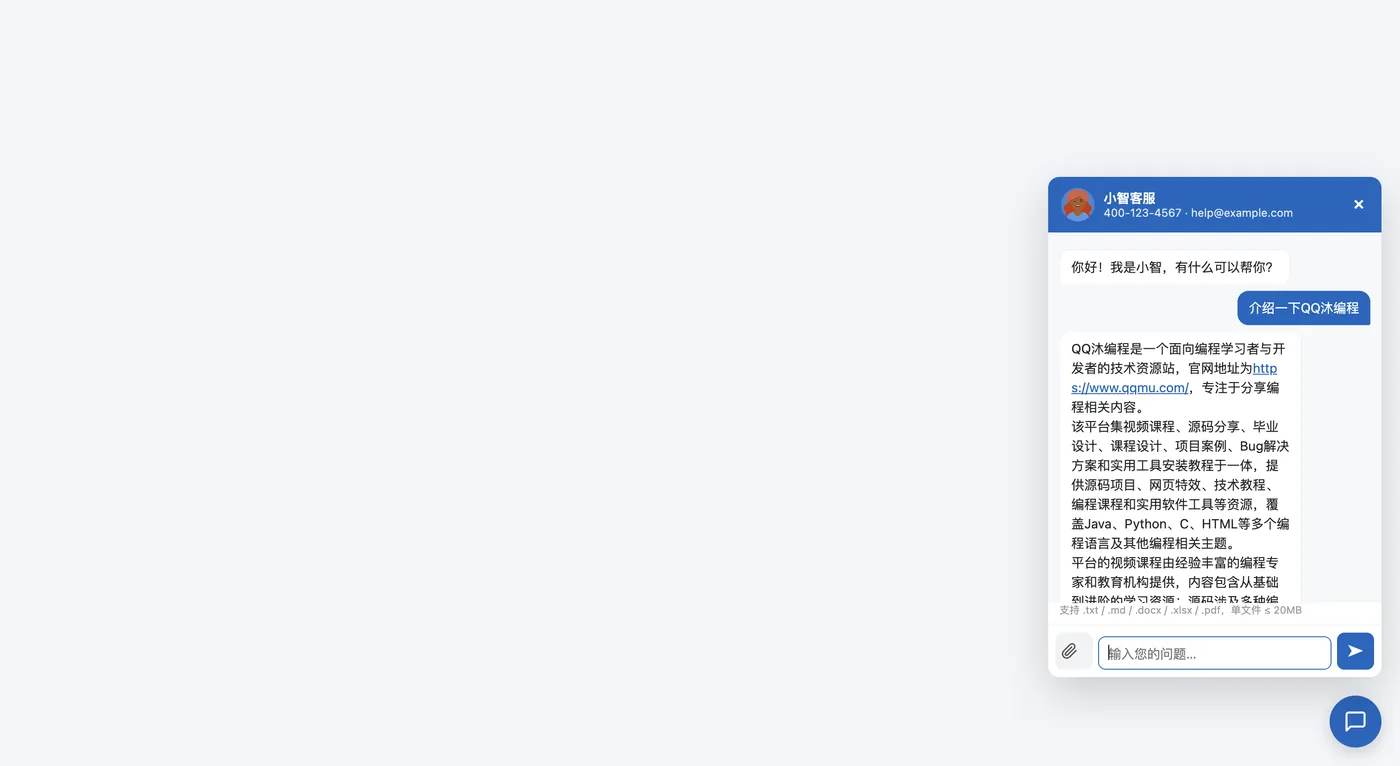
嵌入代码就这么几行:
<script src="https://你的域名/widget/customer-service.js?v=1"></script>
<script>
  CustomerService.init({
     apiUrl: 'https://你的域名' });
</script>
组件是单文件、零依赖、免构建的原生 JS,19KB。不用 npm,不用打包,
丢到任何页面都能跑。
二、源码介绍
2.1 整体结构
99 个文件 · 后端 Python 6,548 行 · 前端 2,823 行 · 24 个 API 端点

intelligent-customer-service/
├── backend/
│   ├── run.py                    ← 一键启动(PyCharm 右键 Run)
│   └── src/
│       ├── api/          (7)     admin · chat · config · documents · models · sessions
│       ├── services/     (6)     document · rag · llm · embedding · session
│       ├── adapters/     (5)     OpenAI / Anthropic 协议适配
│       ├── vector_store/ (6)     Chroma / Qdrant / Milvus
│       ├── embeddings/   (3)     向量化
│       ├── parsers/      (6)     txt · md · docx · xlsx · pdf
│       ├── prompts/              RAG 约束提示词
│       ├── core/                 配置 · 数据库 · 厂商注册表 · 异常
│       └── utils/                结构感知切分 · SSE · 哈希
└── frontend/
    ├── admin/index.html          管理后台(2,037 行,无框架)
    └── widget/customer-service.js 嵌入组件(786 行,零依赖)
2.2 多厂商适配:一个接口,两种协议
市面上的模型接口分两大派:OpenAI 风格(/chat/completions)和 Anthropic 风格
(/messages)。后者把 system 放在顶层字段而不是消息列表里,流式响应的事件结构
也不一样。
BaseProvider(async + SSE)
  ├── OpenAIStyleProvider     → POST {base}/chat/completions
  └── AnthropicStyleProvider  → POST {base}/messages
build_provider() 按 protocol 字段分发
一个踩坑记录:Anthropic 官方用 x-api-key 认证,但很多"兼容 Anthropic 协议"的
国内网关实际要 Authorization: Bearer。我最初只发前者,火山方舟直接返回 401。
现在两个头都发 —— 各家忽略自己不用的那个,兼容性问题就消失了。
def _headers(self) -> dict:
    key = self.config.api_key or ""
    return {

        "Content-Type": "application/json",
        "x-api-key": key,                      # Anthropic 官方
        "Authorization": f"Bearer {key}",      # 兼容层网关
        "anthropic-version": self.version,
    }
2.3 结构感知切分:让检索命中的片段"知道自己是谁"
这是我花时间最多、收益也最直观的一块。
问题:常规做法是按固定字数切(比如每 500 字一刀)。这会产生两种坏片段:
- 一个片段横跨三个不相关章节 → 它的向量是几个主题的模糊平均值,谁都能弱匹配
- 一个片段从「Q3:可以接入多个模型吗」的中间开始 → 丢了
【常见问题】这个上下文,
模型不知道这段话在讲什么
做法:先按结构切块,再打包成片段,打包时不跨标题,并给每片带上标题路径。
能识别的结构:
| 类型 | 示例 |
|---|---|
| CJK 方括号章节 | 【保修条款】 |
| Markdown 标题 | # 手册 / ## 安装(支持层级 手册 > 安装) |
| 中文章节 | 第一章 总则 |
| Q&A 对 | Q1:… / A:…(问答绝不分离) |
| Excel 工作表 | ## Sheet: 价格表 |
| PDF 页 | ## Page 3 |
编号列表如 1. 整机保修期为 12 个月。 不会被误判成标题 ——
判断规则里排除了含句末标点的行。
实测对比(595 字的示例文档):
| 固定窗口 | 结构感知 | |
|---|---|---|
| 片段数 | 2 | 6 |
| 问「保修期」Top-1 得分 | 0.719 | 0.791 |
| Top-1 命中内容 | 混杂大片段 | 精准的【保修条款】章节 |
2.4 回答策略:一个开关,两种人格
默认是严格 RAG:只依据知识库回答,检索不到就明确说"抱歉,知识库中没有相关信息"。
好处是每句话都能追溯到你上传的文档。
但有时你希望它更像个通用助手。所以加了个开关:
| 关闭(默认) | 开启 | |
|---|---|---|
| 知识库有相关内容 | 依据资料回答 | 依据资料回答,不足时补全 |
| 知识库没有 | 明确拒答 | 用模型自身知识回答 |
| 可追溯性 | ✅ | ❌ 用户分不清来源 |
| 适用 | 价格、政策、承诺 | 通用问答、技术咨询 |
这里有个不那么显然的技术细节。 我最初的实现是"检索零命中时才切换到自主回答",
结果开关完全不生效 —— 因为中文 embedding 的特性是:即使内容完全无关,
相似度也有 0.65 左右。而 similarity_threshold 必须保持低值(0.5),
否则「登录页」这种短查询会检索不到任何东西。
于是我实测了 12 个问题的分数分布:
站内问题: 0.813 0.827 0.833 0.836 0.850 0.859 0.905
站外问题: 0.649 0.665 0.680 0.702 0.711
间隔 +0.102  → 分界线取 0.76
据此引入 relevance_threshold = 0.76,区分"检索到了"和"检索到了答案"。
9 个路由测试全部正确:5 个站内问题走知识库,4 个站外问题走自主回答。
2.5 入库的可靠性:断点续传 + 自适应限流
大知识库入库会遇到两类现实问题,都不是写代码时能预料的:
① 厂商单批上限不统一。 火山方舟的 embedding 接口单次最多 10 条,
OpenAI 是 2048。写死成 10 会拖慢所有人。
做法是从错误信息里解析上限并自动降批:
Embedding batch of 13 rejected by vendor; shrinking batch size 32 → 10
只探测一次,之后记住。ARK 的报错文本 max 10, got 13 会被正则提取出 10,
一次到位而不用反复折半。
顺带一个反直觉的实测结果:并发调 embedding 反而慢 60 倍
(100 个片段:串行 3.4 秒 vs 并发 4 路 211 秒)。ARK 对并行请求限制极严。
所以默认改回串行,并在代码注释里写明"实测慢 60 倍,别改回去"。
② 配额是长周期累计的。 我最初的重试策略是"最多 40 次、总共等 44 秒",
但实测 ARK 的配额需要 90 秒以上才恢复 —— 所以每次入库跑完一个批次就死掉,
用户得手动点。
改成按时间预算(10 分钟)而不是按次数,等待序列 1→2→4→8→16→20…秒。
配合进度持久化,实现了断点续传:中断后再点「入库」从上次位置继续,
已完成的片段不重复消耗配额。
模拟测试(每 25 请求耗尽、静默 10 秒恢复):
1287 片段一次跑完,耗时 112s,其间 28 次 429 全部自动消化
2.6 火山方舟的计费陷阱
这个值得单独说,因为用错会花钱。
ARK 有两个产品,域名相同但路径不同:
| 产品 | Base URL | 模型名 | 计费 |
|---|---|---|---|
| Coding Plan 包月套餐 | /api/plan/v3、/api/plan/v1 |
ark-code-latest |
套餐内 |
| 豆包 按量付费 | /api/v3 |
doubao-* |
另外计费 |
我最初"去重"时只看域名相同就合并成一项 —— 这是个会让用户多花钱的错误。
现在拆成两个独立选项,包月套餐那项的说明里明确写着⚠ 不要改成 /api/v3 —— 那是按量付费,会另外计费。
还加了单元测试断言两者的 (base_url, protocol) 不冲突,防止以后又被合并回去。
2.7 测试:37 + 17
cd backend && python -m pytest src/tests/ -q     # 37 passed
cd frontend/widget && npm test                   # 17 项全部通过
后端 37 个测试覆盖厂商注册表去重、切分策略、向量库工厂分发、回答策略路由、
版本号解析等。
前端那 17 项断言值得单独说明为什么必要。 node -c 只做语法检查,
检不出「模板字符串被内部反引号截断」这类错误 —— 那会让整个组件在运行时抛错、
完全不工作,但静态检查一片绿。
所以自检脚本在真实 DOM 里用假 SSE 驱动完整渲染路径,断言链接可点击、
Markdown 正确渲染、引用标记被清除等。
写测试时我有个习惯:故意注入 bug 验证测试真的会失败。比如把版本比较从数值
退化成字符串比较(这会让 2.0 > 10.0),测试确实报了 3 项失败;把面板高度改掉,
尺寸守卫立刻拦住。能失败的断言才是有价值的断言。
三、其他实现细节
3.1 首次运行向导
打开管理后台,如果系统没初始化,顶部会出现横幅:
⚠️ 检测到系统未完成初始化
  • 客服配置未初始化
  [🚀 一键初始化]  [🔄 重新检测]
点一下完成建表、建目录、写默认配置。这是"不用跑脚本"这个目标的兑现方式。
顺带处理了一个容易被忽略的状态:如果入库过程中服务被重启,
数据库里会留下一条永远不会完成的 processing 记录。
现在列表查询会检测 15 分钟未更新的记录并标记为可重试,
而不是让用户对着一个假的"处理中"干等。
3.2 顶部工具栏
右上角三个常驻工具:
| 工具 | 说明 |
|---|---|
| 🟢 后端状态 | 每 15 秒自检。离线时悬停看完整错误(长报错不会撑破布局) |
| ⬆︎ 检测更新 | 比对 GitHub 最新 Release,有新版时按钮出现红点 |
| ☕ 打赏支持 | 微信 / 支付宝 / QQ 赞赏码 |
检测更新只检测不改代码 —— 发现新版展示更新说明和更新命令,由你决定何时执行。
自动 git pull 会覆盖本地未提交的修改,还可能因依赖变更导致服务起不来,
不适合放在一个按钮后面。
3.3 密钥处理
API Key 存在数据库里(backend/data/app.db),页面上永不回显真实值,
只显示 ****1ef5。留空表示不修改,填了才替换。
一个必须说明的局限:目前只做了 base64 混淆,不是加密。
生产环境应该换成 KMS / Vault。.gitignore 已经排除了这个数据库文件 ——
这一条我实测验证过:
git check-ignore -v backend/data/app.db # 确认被忽略
四、源码获取
4.1 仓库地址
https://github.com/vfaner/intelligent-customer-service
MIT 协议,可自由商用、二次开发。
4.2 三步跑起来
① 装依赖
git clone https://github.com/vfaner/intelligent-customer-service.git
cd intelligent-customer-service/backend
python3 -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
pip install -r requirements.txt
② 启动
PyCharm 用户:右键 backend/run.py → Run
命令行:
python run.py
启动后会打印:
==============================================================
  🤖 IntelligentCustomerService
==============================================================
  ⚙️  管理后台   http://localhost:8000/admin/     ← 从这里开始
  🪟  组件演示   http://localhost:8000/widget/demo/
  📖  API 文档   http://localhost:8000/docs
--------------------------------------------------------------
  ⚠  尚未配置对话模型 API Key
     → 打开管理后台「模型配置」填写即可,无需改文件
==============================================================
缺依赖时会提示当前解释器对应的安装命令(避免装到别的 Python 环境去),
也可以 python run.py --install 自动装。
③ 打开管理后台配置
浏览器访问 http://localhost:8000/admin/
| 顺序 | 做什么 |
|---|---|
| 1️⃣ | 顶部若有黄色横幅 → 点「🚀 一键初始化」 |
| 2️⃣ | 「模型配置」→ 选厂商 → 填 API Key → 「🔌 测试连接」→「💾 保存」 |
| 3️⃣ | 同页「🧬 向量模型」→「⬆︎ 复用对话模型的 Key/URL」→「🔌 测试并探测维度」 |
| 4️⃣ | 「知识文档」→ 拖入 txt/md/docx/xlsx/pdf → 自动解析入库 |
| 5️⃣ | 「聊天预览」→ 直接提问验证 |
全程不需要编辑任何文件。
4.3 环境要求
| 项目 | 要求 |
|---|---|
| Python | 3.11+(已在 3.14.5 上验证) |
| 数据库 | SQLite(默认,零配置)或 MySQL |
| 向量库 | Chroma(默认,零部署)/ Qdrant / Milvus |
| 模型 | 任意一个厂商的 API Key |
| Node.js | 仅跑前端自检时需要,运行项目不需要 |
不需要 GPU —— 推理都在厂商侧。
4.4 部署到服务器
仓库里有 docs/DEPLOYMENT.md,包含 Docker Compose 和
systemd 两套方案、Nginx 配置、HTTPS 证书、备份恢复、升级回滚、10 条故障排查。
有三个坑值得先知道:
只有 Nginx 该暴露公网。 应用绑
127.0.0.1:8000—— 管理后台没有内置登录,
直接对外等于把 API Key 配置页开放给所有人。文档里给了三种保护方式,
最推荐 SSH 端口转发(完全不对外开放)。SSE 必须在 Nginx 关闭缓冲,否则回答不会逐字出现,而是等全部生成完才一次性蹦出来:
location /api/chat/stream {

    proxy_pass http://127.0.0.1:8000;
    proxy_buffering off;
    proxy_cache off;
    chunked_transfer_encoding off;
}
iframe 嵌入要给够尺寸:
400 × 636(面板 360×540 + 按钮位 76 + 边距 20),
且background: transparent。给小了面板会被裁掉,不透明就会露出一块白底。
4.5 文档
| 文档 | 内容 |
|---|---|
| README.md | 中文总览、页面导览、配置项参考、FAQ |
| README.en.md | English version |
| docs/API.md | 24 个接口的详细说明 |
| docs/DEPLOYMENT.md | 服务器部署完整步骤 |
| docs/EMBED_GUIDE.md | 嵌入网站/小程序/桌面端 |
