在 RAG(检索增强生成)系统的实际落地中,很多开发者习惯在向量数据库中直接写死返回固定数量的切块(例如 top_k = 5)。
这种“机械式 Top-K”策略隐藏着一个致命隐患:即使知识库中完全没有用户提问的相关信息,向量检索依然会强行返回得分最高的前 5 个片段。
这些低相似度的“伪相关”内容被当作真实参考喂给 LLM 后,直接诱发了灾难性的模型幻觉(Hallucination)与答非所问。要打造高精度的工业级 RAG,相似度阈值截断(Similarity Threshold Cutoff) 是守住生成质量底线不可逾越的关键机制。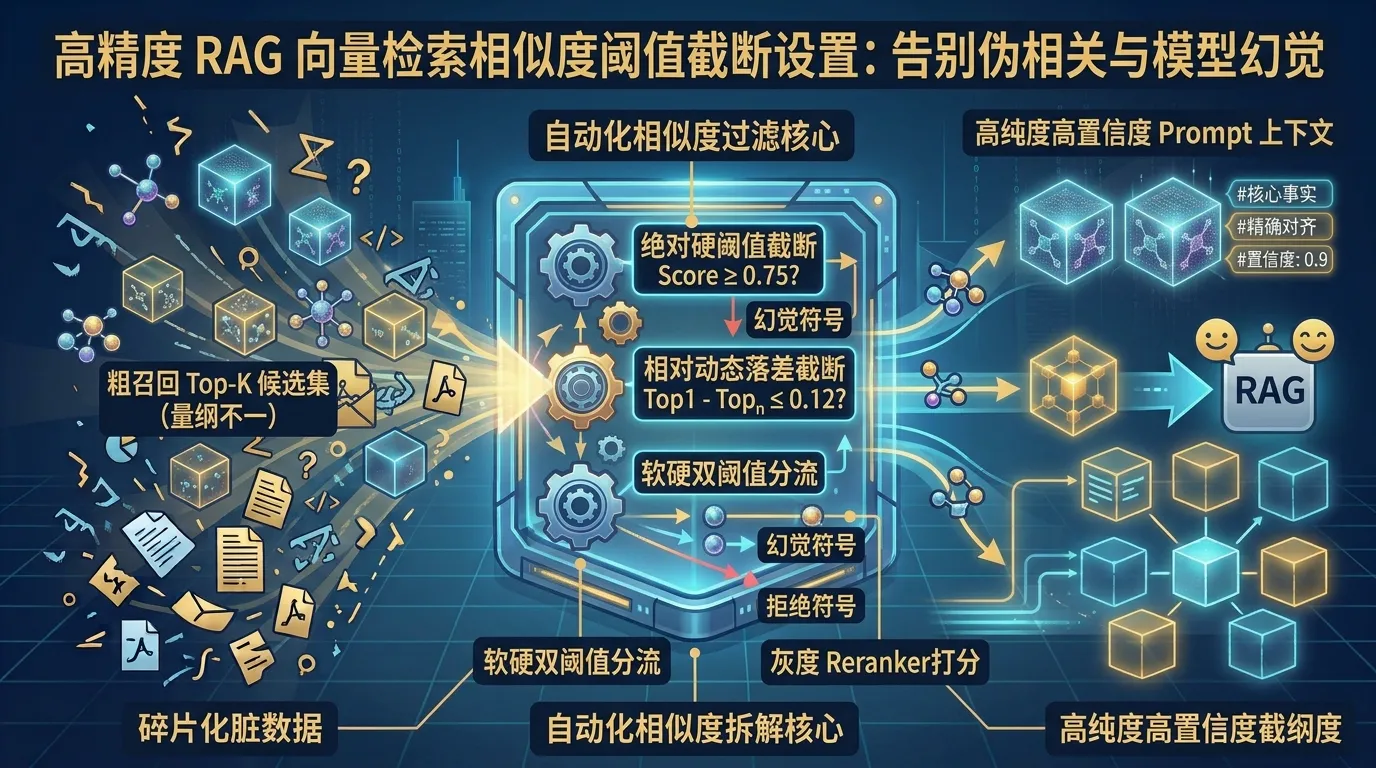
一、 为什么必须实施相似度阈值截断?
固定 Top-K 检索在面对“知识库边界之外(Out-of-Domain)”的 Query 时完全失效。引入阈值截断能够带来三个核心收益:
- 筑起拒答防线(Graceful Fallback): 当所有检索结果的相似度均低于设定阈值时,系统能够果断判定“知识库无相关记录”,直接触发标准拒答模板(如:“未在当前知识库中找到相关规范”),而非让模型强行编造。
- 剔除长尾噪声(Tail Noise Pruning): 很多时候只有排在第 1、2 位的切块高度相关,第 3~5 位则是强行拉来凑数的低质内容。阈值截断能动态保留真正有效的片段,提升 Prompt 的信息纯度。
- 节省 Token 消耗与推理延迟: 动态返回 1~3 个高置信度切块,而非机械塞满 5~10 个,大幅压缩了上下文长度,降低 API 成本与 TTFT(首字响应时间)。
二、 相似度度量方式与分数基准
设置阈值前,必须明确底层向量数据库采用的距离度量函数(Distance Metric),不同度量方式的分数范围与截断逻辑截然不同:
| 度量类型 | 数值范围 | 相似度变化趋势 | 截断方向 | 典型参考阈值区间 |
|---|---|---|---|---|
| 余弦相似度 (Cosine Similarity) | $[-1, 1]$ 或归一化到 $[0, 1]$ | 数值越大越相似 | 大于阈值保留 ($\text{Score} \ge \tau$) | $\ge 0.70 \sim 0.82$ |
| 点积 / 内积 (Dot Product / IP) | $(-\infty, +\infty)$(单位向量等同于余弦) | 数值越大越相似 | 大于阈值保留 ($\text{Score} \ge \tau$) | 视 Embedding 模长与归一化情况而定 |
| 欧氏距离 (L2 Distance) | $[0, +\infty)$ | 数值越小越相似 | 小于阈值保留 ($\text{Distance} \le \tau$) | 需根据向量维度进行平方根标定 |
关键提醒: 现代 Embedding 模型(如
text-embedding-3-small、BGE-Large-zh等)输出的向量通常经过了 L2 归一化(Unit Vector),此时点积等价于余弦相似度。
三、 四种高阶阈值截断工程策略
在复杂业务场景中,单一的固定静态阈值往往难以兼顾所有类型的 Query。业界通常采用以下四种进阶截断策略:
[用户提问 Query] ──→ 向量检索 (召回 Top 15 候选集)
                             │
       ┌─────────────────────┼─────────────────────┐
       ↓                     ↓                     ↓
【策略1: 绝对硬阈值】   【策略2: 相对动态落差】   【策略3: 软硬双阈值分流】
 Score ≥ 0.75?         Top1 - Top_n ≤ 0.12?   高分直接进 / 中分走重排 / 低分拒答
       │                     │                     │
       └─────────────────────┼─────────────────────┘
                             ↓
              [过滤后的纯净高置信度 Chunk]
1. 绝对硬阈值截断(Hard Thresholding)
- 逻辑: 设定全局固定阈值 $\tau$。仅保留 $\text{Score} \ge \tau$ 的切块。
- 适用场景: 规范明确、语料风格高度一致的垂直专业知识库(如医疗指南、API 文档)。
- 经验值建议: 使用 BGE 或 OpenAI Embedding 时,通常设置在 0.72 ~ 0.78 之间。
2. 相对动态落差截断(Relative Drop / Gap-based Cutoff)
- 逻辑: 观察相邻切块之间的得分断崖式下跌。以最高分 $S_{\max}$ 为基准,保留满足以下条件的切块:
$$\text{Score}_i \ge S_{\max} - \Delta \quad \text{且} \quad \text{Score}_i \ge \tau_{\text{base}}$$
- 优势: 避免当整体命中度极高时因硬阈值误杀次要切块,或当整体偏低时因为微弱差距拉入无关切块。
3. 软硬双阈值分流策略(Dual-Threshold Routing)
将阈值划分为三个区间,实现自适应流转:
- 高置信区 ($\text{Score} \ge 0.82$): 强相关,直接注入 Prompt 供模型生成。
- 灰度重排区 ($0.65 \le \text{Score} < 0.82$): 语义相关但不确定,送入 Cross-Encoder Reranker 进一步精排打分。
- 低置信拒答区 ($\text{Score} < 0.65$): 判定为无效噪声,直接丢弃;若候选全在此区间,直接触发拒答。
4. 混合检索融合截断(Hybrid Search Score Normalization)
在同时引入 BM25 和向量检索时,BM25 原生分数无上限。建议先采用 Min-Max 归一化 或 倒数排名融合(RRF),再在最终融合得分上执行分位数或阈值截断。
四、 如何科学确定最佳阈值?
切忌凭拍脑袋确定阈值。科学的标定流程如下:
- 构建基准黄金测试集(Golden Dataset): 准备包含 100~200 条问答对的评测集,明确标记每条提问的“标准检索切块”,并包含 20% 的负样本(知识库无法回答的 Query)。
- 绘制 Precision-Recall 曲线与 F1-Score:
- 遍历阈值 $\tau \in [0.50, 0.95]$,步长 0.02。
- 计算各阈值下的准确率(Precision)、召回率(Recall)以及拒答正确率(Rejection Accuracy)。
- 寻找 F1 最大值拐点:
- 找到 $F_1 = \frac{2 \cdot P \cdot R}{P + R}$ 最大的临界点,即为系统的最优静态阈值。
五、 常用问题 Q&A
Q1:为什么有时候相似度达到 0.75,内容依然不相关?
A1:向量双塔模型的“各向异性(Anisotropy)”和高维空间聚集现象会导致即使字面意思不同,某些高频通用词的向量余弦值也偏高。解决办法是:① 结合 BM25 关键词进行交集验证;② 叠加 Cross-Encoder Reranker 进一步打分;③ 在入库前对 Chunk 绑定元数据前缀(如 [分类: 财务]),拉大跨类别向量间距。
Q2:如果切块太短或太长,对相似度得分有影响吗?
A2:影响极大。切块太短(<50 token)缺乏上下文,容易产生极端的伪高分;切块太长(>1000 token)语义被稀释,会导致核心匹配处的得分被拉低。建议配合父子块架构(Parent-Child),用 100~200 token 的小切块做高分阈值匹配,命中后回溯父块输出。
六、 总结
相似度阈值截断是 RAG 系统从“玩具级 Demo”迈向“企业级高可用”的关键门槛。
抛弃盲目的固定 Top-K,采用“硬阈值兜底 + 动态落差截断 + Rerank 灰度分流”的组合策略,才能在确保高召回的同时,为大模型阻挡 90% 以上的上下文噪声,彻底杜绝无中生有的幻觉输出。