💡 一句话总结:DocClaw 的贡献不是发明新 backbone,而是把文档任务差异放到技能层、把可复用知识放到状态层、把感知动作放到工具层;技能提升质量,状态降低重复计算。
导语:同一份 PDF,为什么要被系统反复肢解?
想象一个很常见的文档智能工作台:用户先问“这页写了什么”,接着问“第三页的合同金额是多少”,然后又要求抽发票号、付款条件和供应商字段。
很多系统会把这三件事当成三个任务:OCR 跑一遍,DocQA 再跑一遍,KIE 又跑一遍。页面被重复解析,表格被重复识别,低质量区域每次都要重新裁剪。你看着 token 和延迟一起涨,心里只想问:它刚才不是已经读过这里了吗?
这正是 DocClaw 要处理的问题。论文提出一个统一的 agentic intelligent document processing 框架,让 OCR、文档问答(DocQA)和关键信息抽取(KIE)共享同一个 agent 与文档的交互过程。
想自己动手试?
- 📄 论文:arXiv 2608.18685
- 💻 代码:GitHub · sxiangag/DocClaw
这篇论文到底想解决什么问题?
论文的研究问题是:能否用一个共享的 agent 交互框架同时支撑 OCR、DocQA 和 KIE,而不是为每个文档任务单独设计模型或固定流水线?
作者把现有方案分成三类。单 pass 模型直接输出,速度快,但在长文档和低质量区域容易漏证据;任务专用 pipeline 有版面解析、裁剪、OCR 等工具,但流程固定,遇到不同 query 缺少弹性;通用 agent 能调工具,却常常缺少跨任务可复用的文档记忆。
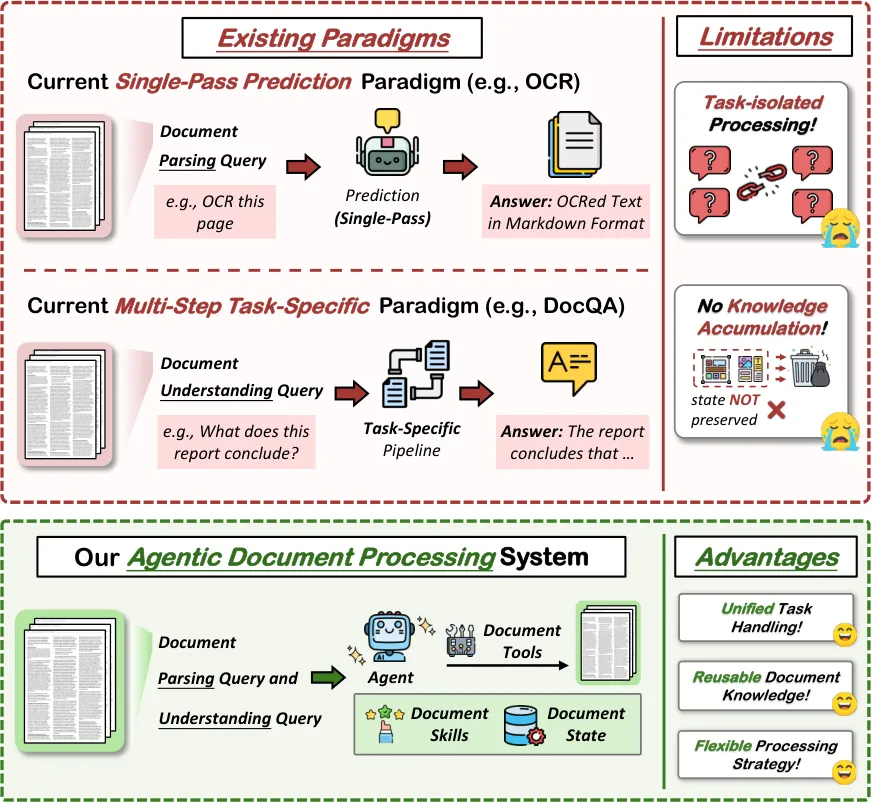
图说:DocClaw 试图同时避开单 pass 模型的静态感知、固定 pipeline 的僵硬流程和通用 agent 的记忆缺失。
真实业务里,同一份材料往往会被连续使用。扫描件的页面结构、区域坐标、表格 HTML、局部裁剪和 OCR 结果,本质上都是可以沉淀的中间知识。如果没有 document state,每个 query 都像第一次见到这份文档。
所以论文的核心抽象是 agent-document interaction:任务目标不同,但底层都需要识别证据、获取相关信息、逐步精炼输出。差别交给技能层处理,共性放进共享状态和工具循环。
它的思路是什么?
DocClaw 的整体流程可以概括为“选技能、建状态、进循环、写状态、出结果”。它采用 ReAct 式工具调用:模型根据当前观察决定下一步动作,工具返回新的 observation,状态随之更新。
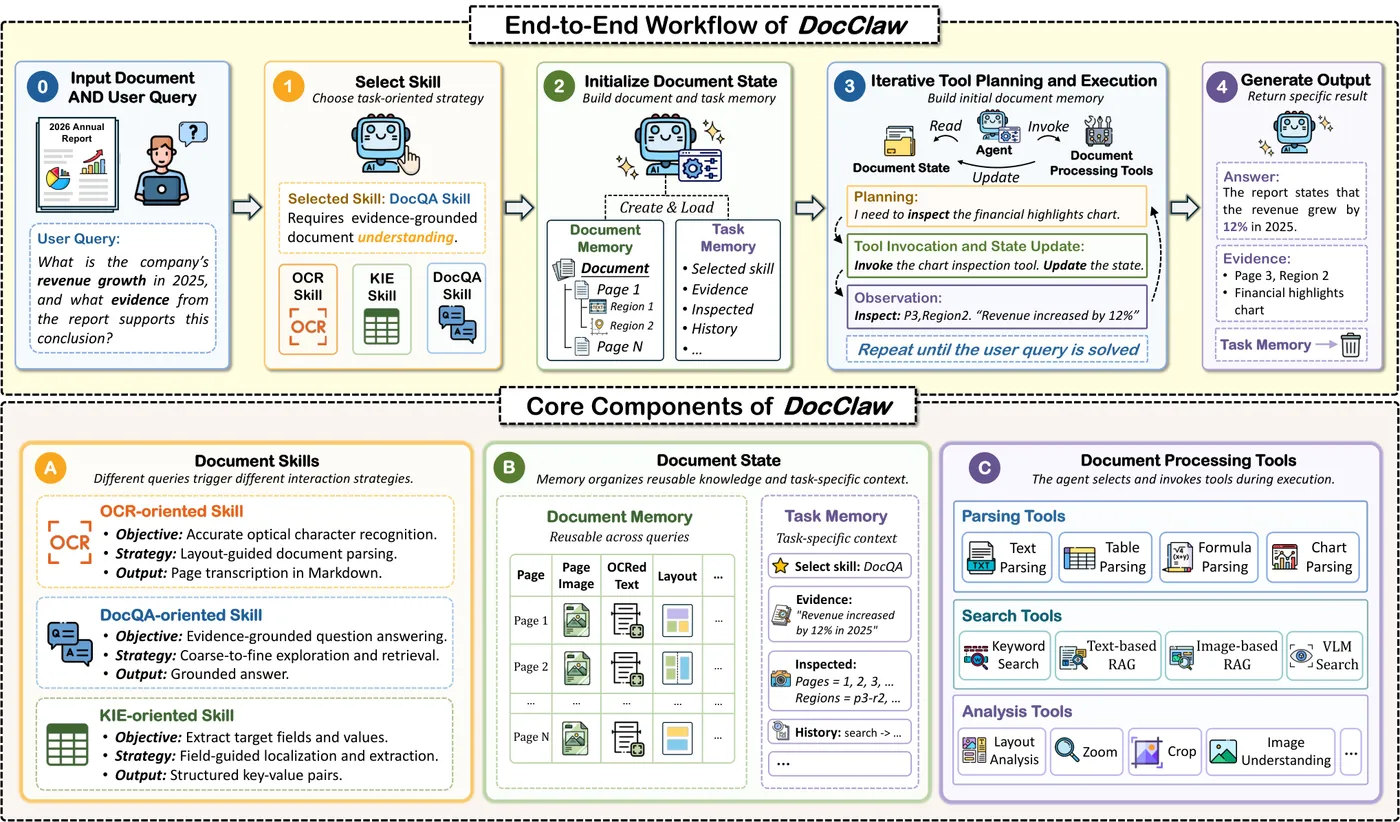
图说:query 先映射到任务技能,再进入共享工具循环;中间观察写入 task memory,可复用知识沉淀到 document memory。
这里有三个关键设计。
- 🧭 Task-oriented document skills:系统先判断任务是 OCR、DocQA 还是 KIE,再选择对应技能说明。技能规定优先查看的内容、可用工具、验证策略、输出 schema 和停止条件,避免 agent 在长文档里漫无目的游荡。
- 🧠 Structured document state:状态分为 document memory 与 task memory。前者保存页面、区域、OCR、表格、图像等跨 query 可复用内容;后者保存当前查询的中间证据。后续步骤读取状态,而不是重复解析同一区域。
- 🛠️ Shared tool loop:agent 检查证据是否足够;若不足,就从缩放、裁剪、旋转、OCR、检索、图像 grounded verification 等工具中选择一个。工具结果写回状态,直到满足停止条件。
为什么要把技能和状态分开?因为它们解决的是不同问题。技能回答“这个任务该怎么找证据”,状态回答“之前已经知道了什么”。一个提供任务先验,一个提供复用价值。
KIE 部分还加入了视觉验证。候选字段值会映射回页面区域,检查视觉证据与文本是否一致。这个设计很务实:字段抽取最怕幻觉和错位,仅靠生成概率无法保证值真的来自页面。
自问自答一下:为什么不直接上更大的 VLM?因为很多失败不是语义推理不足,而是输入表示不好。小字需要放大,表格需要局部结构,旋转页需要纠正;这些是感知动作,不是再多想一遍就能解决的问题。
效果到底怎么样?
论文在三类 benchmark 上验证同一个框架。最强配置在 OmniDocBench v1.6 达到 Overall 96.45,在 MMLongBench-Doc 达到 61.5,KIE 聚合分 86.9。
| 任务与基准 | 最强配置 | 结果 | 对比 |
|---|---|---|---|
| OCR,OmniDocBench v1.6 | Gemini-2.5-Pro | 96.45 | PaddleOCR-VL-1.6 为 96.34 |
| DocQA,MMLongBench-Doc | Gemini-2.5-Pro | 61.5 | 高于 baseline 3.4 分 |
| KIE 聚合 | Gemini-2.5-Pro | 86.9 | 比 Qianfan-OCR 高 2.9 分 |
这些数字要分开读。OmniDocBench 上 0.11 分的领先很小,不能单独证明“统一系统优于专用 OCR”。更有说服力的是 MMLongBench-Doc 的 3.4 分提升,因为长文档正好是证据定位和状态复用的主场。
消融比总榜更有信息量。state-enabled 版本加入 document skills 后,Overall 从 92.85 提升到 97.10;skill-enabled 版本加入 document state 后,平均延迟从 95.81 秒降到 60.70 秒。质量收益和效率收益来自不同组件,这是论文最清楚的一条证据链。
KIE 的中文子集变化很醒目:vanilla VLM 为 54.3,加 OCR 后到 77.5,再加验证到 78.7。英文子集也从 83.3 提升到 87.5。显式 OCR 和区域验证确实能弥补直接视觉抽取的弱点。
不过,我对“96.45”这类总分仍保持克制。三个 benchmark 的指标含义不同,不能相加成“文档智能通用能力”。它验证的是一个共同框架在三类任务上可行,而不是给出了单一能力分数。
为什么你要关心?
如果你正在做文档 Agent、RAG 前处理或企业内容工作台,DocClaw 有几个可以直接借鉴的做法。
- 🗂️ 把 document memory 当一等公民:页面、区域、OCR、表格结构和已验证证据都应带 provenance 存下来。连续 query 场景里,缓存命中率和状态复用直接决定成本。
- 🧩 用 query-to-skill 路由约束探索:通用 agent loop 容易“看遍全文档却不知道该看哪里”。技能层可以把任务先验写成工具偏好、验证方式和停止条件。
- 🔍 对 KIE 做区域级验证:字段值必须能映射回视觉或文本证据。尤其是金额、日期、证号和合同条款,幻觉代价比多一次工具调用高得多。
我的工程判断是,这篇论文最有迁移价值的不是 benchmark 数字,而是分层方式:任务差异放技能,文档知识放状态,感知动作放工具。这个边界清楚,也方便逐步移植到现有系统。
落地时建议先测连续 query 分布。如果你的系统每份文档只问一次,state 的收益可能有限;如果是工作台式多轮使用,它可能会显著改变延迟和费用。
理性看待
论文的主要限制在成本公平性。DocClaw 依赖多个强 VLM/LLM backbone 和丰富工具空间;收益可能部分来自更多推理时计算、强闭源模型和针对 benchmark 的工具配置,而不完全来自统一 agent 表述。论文报告了延迟,但缺少 token 费用、工具调用分布、失败恢复成本和缓存命中率的完整账本。
复现也有现实门槛。部分最佳结果依赖闭源 backbone,技能提示和配置需要检查仓库;不同部署环境的工具质量可能改变结论。
所以我的建议是把它当作架构参考,而不是直接照抄生产配置。先在固定 token 和工具预算下复现关键消融,再评估状态膨胀、错误传播和缓存策略。这样才不会把“看起来更聪明”误判成“更划算”。
作者:lusca
版本:lusca-paper-blog v1.5.0
出处:https://github.com/yjmm10/lusca-skill/tree/main/skills/lusca-paper-blog