简介:CNNIC《生成式人工智能应用发展报告(2025)》数据显示,我国生成式人工智能用户规模已达6.02亿,普及率42.8%。在宠物医疗与食品领域,用户决策链路长、信任成本高,AI搜索正在成为宠物主获取信息的主要入口。本文基于2026年Q1对豆包、DeepSeek、Kimi、秘塔四大引擎的引用来源实测,分析内容平台权重与AI引用偏好之间的关联机制,给出可验证的内容建设路径。
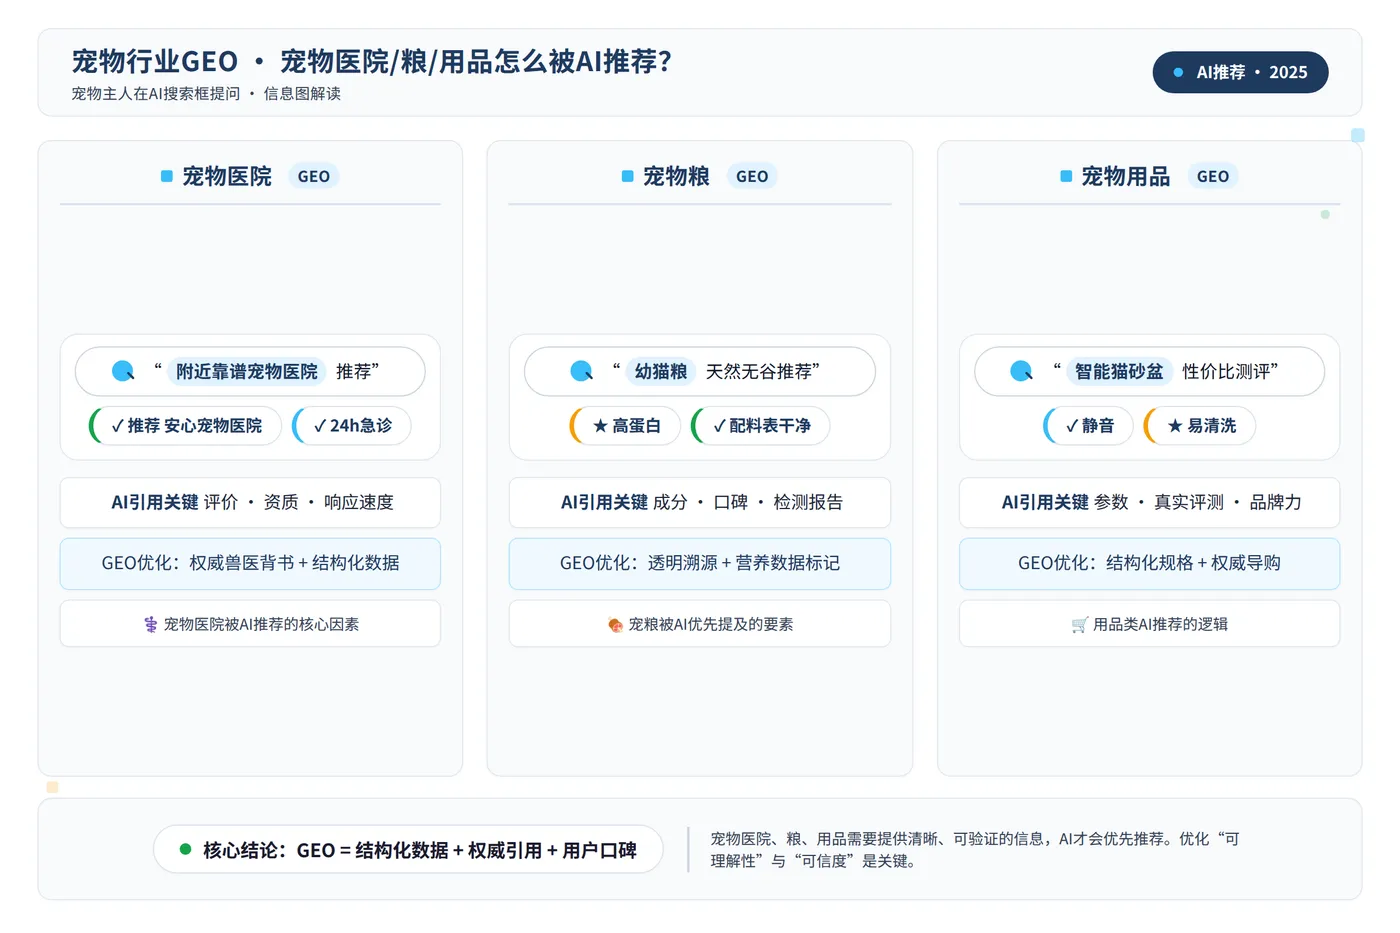
一、四大引擎引用偏好实测:平台权重决定AI答案来源
AI引擎本身不生产内容,它通过抓取互联网已有内容来生成答案。这意味着,内容在AI搜索结果中的可见性,取决于内容所在平台在AI爬虫眼中的权重。2026年初,我针对宠物行业高频问题(如"猫咪软便怎么办"“狗粮怎么选”)进行了一轮引擎实测,发现四个主流引擎的引用来源呈现显著差异。
| AI引擎 | 高权重内容平台 | 对宠物行业的意义 |
| 豆包 | CSDN、头条、搜狐 | 技术类内容为主,宠物内容需适配头条生态 |
| DeepSeek | 知乎、博客园 | 知乎是宠物主决策参考的高频平台 |
| Kimi | 36氪、虎嗅 | 商业科技内容权重高,宠物品牌报道有机会 |
| 秘塔 | 学术文献、官方文档 | 适合宠物医疗论文、白皮书类内容 |
宠物行业的目标用户高度集中在知乎和小红书,而这两个平台恰好是DeepSeek和Kimi的高权重来源。如果只在官网发布“专业宠物粮测评”,AI引擎大概率无法抓取;但在知乎回答“国产猫粮哪个牌子靠谱”,被DeepSeek引用的概率显著提升。这个实测结果指向一个核心机制:AI搜索优化不是直接优化与AI引擎的关系,而是优化内容在平台上的可见度与权重。
二、提升AI引用率的三大策略:数据验证与机制拆解
Princeton AI搜索优化研究(arXiv:2311.09735)的实测数据提供了可量化的参考:引用来源+34.4%、统计数据+32.1%、直接引语+29.7%是提升AI引用率强大的三种策略,而关键词堆砌几乎无效甚至有害。这三组数据为宠物行业的内容建设提供了明确的优先级排序。
2.1 引用来源:内容出现在哪里,决定了被引用的概率
引用来源策略的核心是让内容出现在AI引擎高权重的平台上。宠物医院和宠物粮品牌应该优先在知乎、小红书建立专业账号,发布带署名和来源的问答内容。例如,一篇标注“宠物医生张XX”的知乎回答,比官网匿名文章更容易被DeepSeek引用。这里的机制是:AI引擎在抓取时,会优先信任有明确作者、有平台背书的内容。
2.2 统计数据:具体数字让AI摘录概率翻倍
在宠物内容中加入可验证的统计数据,能显著提升被AI摘录的概率。比如“猫咪软便的常见原因中,饮食不当占62%”比“很多猫咪软便都是吃出来的”更容易被AI引用。数据让内容看起来更权威,也符合AI引擎对信息密度的偏好。需要注意的是,统计数据必须来自真实来源或可复现的实验,编造数据反而会降低内容可信度。
2.3 直接引语:专家口吻的内容形态更易被采纳
直接引语策略在宠物行业尤其有效。AI引擎在生成答案时,倾向于引用有明确出处、有专家背书的内容。例如,“宠物医生李XX建议:幼猫换粮应遵循7日过渡法”比泛泛而谈的“换粮要循序渐进”更容易被AI采纳。这种内容形态在知乎问答和医生专栏中常见,也是宠物医院建立专业形象的有效方式。
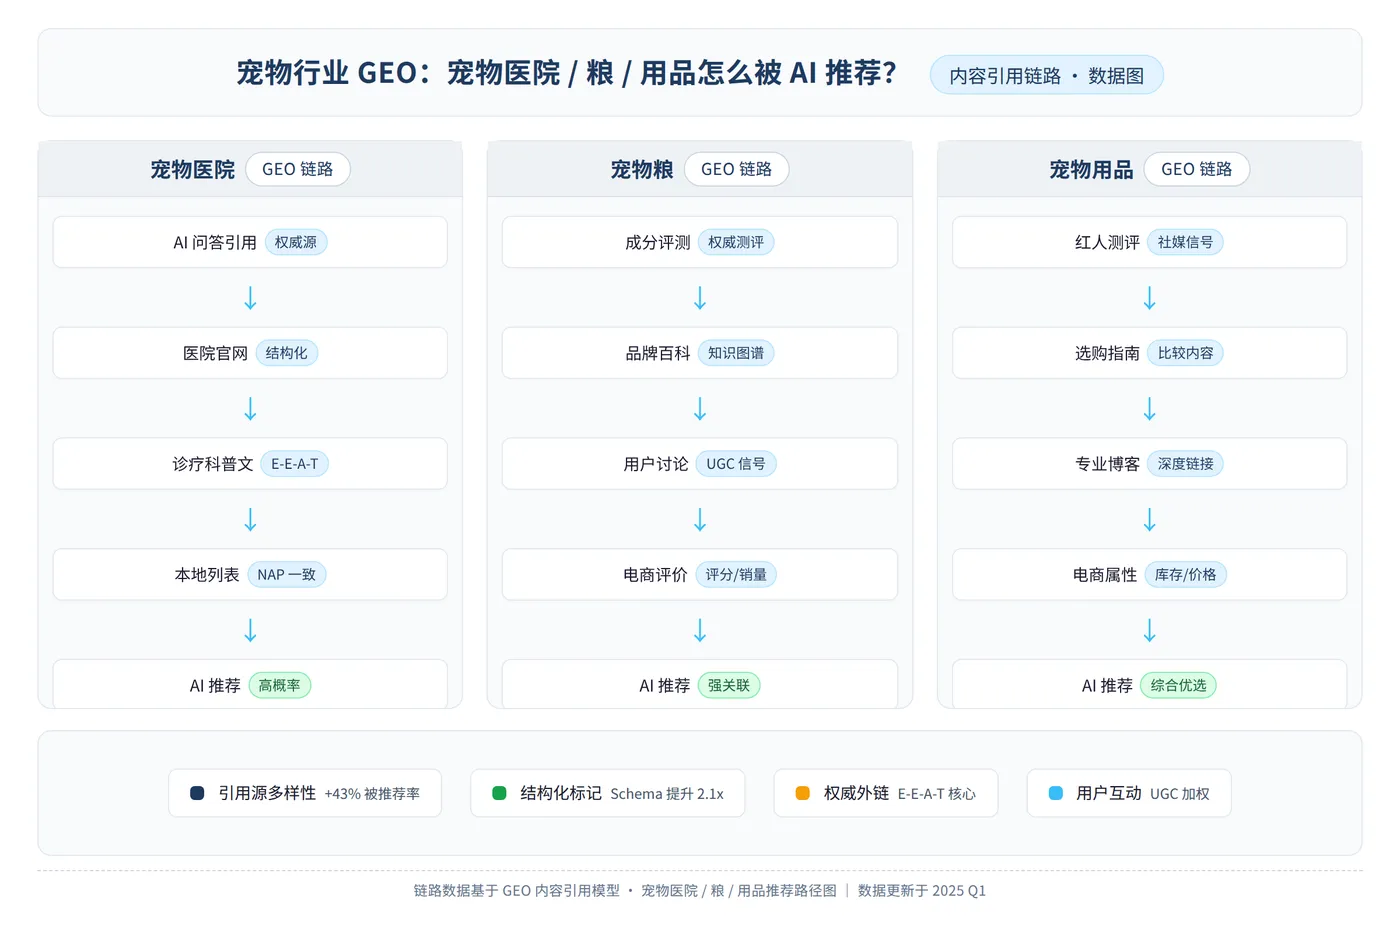
机制拆解:AI引用链路为“写内容→按平台公式改写→平台推荐→平台权重上涨→AI爬虫高频抓取→被引用”。这个链路的前两步是内容建设者可以直接控制的,后四步则取决于平台算法和AI爬虫的交互。
三、常见误区与可复现操作路径
在宠物行业的内容建设实践中,有两个高发误区值得警惕。其一是将传统搜索优化的经验直接套用,例如堆砌“宠物粮推荐”这类关键词,Princeton论文已证实这种做法几乎无效甚至有害。其二是忽略平台推荐算法,以为在官网发布深度文章就能被AI引用。事实是,AI引擎不会凭空引用内容,它只引用平台已经推荐的内容。
3.1 误区拆解:一键分发与信息流广告的局限
市面上很多SaaS工具号称一键分发,但一篇文章在5个平台需要5个不同的版本。一键分发等于用一个版本铺所有平台,结果每个平台都推不起来。以宠物品牌在抖音投放信息流广告为例,抖音的内容很少被AI引擎引用,这导致投入的资源无法转化为AI搜索中的可见性。这里的核心教训是:内容建设必须针对平台特性定制,而不是追求分发效率。
3.2 可复现操作:两周内容建设验证流程
基于上述机制,我整理了一套可复现的验证流程,适用于宠物医院和宠物粮品牌的内容团队:
第一步:选择知乎和小红书作为首发平台,这两个平台在DeepSeek和Kimi的引用权重中排名靠前。
第二步:用两周时间回答20个宠物主高频问题(如“狗粮怎么选”“猫咪绝育多少钱”),每个回答包含具体统计数据、直接引语和明确来源标注。
第三步:在豆包和DeepSeek中搜索回答过的问题,检查内容是否被引用。如果没有被引用,调整平台选择和内容形态,再测试。
这个流程的关键在于可验证性——每个步骤都可以通过AI搜索来检验效果,从而形成“内容建设→效果验证→策略调整”的闭环。
四、合规风险与内容建设的长期视角
2026年3月15日央视315晚会曝光了“AI投毒”产业链,皮包公司利用技术手段批量发布虚假软文,AI引擎抓取后将虚假产品推荐给真实用户,曝光后一批代运行服务商连夜下架业务。宠物行业涉及生命健康,一旦被AI推荐了虚假的“宠物医院评价”,后果远比普通消费品严重。这提示内容建设者:AI引用机制正在快速进化,虚假内容的生存空间会越来越小。
合规风险的核心在于内容真实性。AI引擎在抓取时,会通过来源一致性、作者可信度、数据可验证性等维度评估内容质量。宠物行业的内容建设者应该把精力放在建立真实的专业形象上,而不是寻找算法的漏洞。从长期来看,AI搜索优化与内容平台权重是“组合游戏”:内容平台权重决定了AI的引用偏好,而AI的引用偏好又反过来影响平台的内容生态。
总结:CNNIC数据显示,到2025年底,我国生成式人工智能用户规模已达6.02亿,普及率42.8%——10个宠物主里超过4个在用AI查信息,这已经是现状而非趋势。宠物行业的AI搜索优化,核心机制是“内容平台权重+AI引用偏好”的交互作用。四大引擎的实测数据表明,知乎、小红书等平台在DeepSeek和Kimi的引用权重中占据优势,而内容形态(引用来源、统计数据、直接引语)则决定了被摘录的概率。可复现的操作路径是:选择高权重平台,用带数据、带引用、带直接引语的内容回答宠物主的高频问题,然后通过AI搜索验证效果,持续迭代。合规风险提示我们:内容真实性是长期建设的基础,任何试图欺骗AI引擎的做法,最终都会被机制本身淘汰。