简介:本文从技术实现角度拆解AI搜索引擎的内容分发机制,对比百度传统收录模式的差异。通过豆包、DeepSeek等产品的实测数据,分析内容被AI引用的前提条件与操作路径。全文围绕「引用」与「收录」的本质区别展开,提供可复现的行业平台地图绘制方法。
一、AI搜索的「引用」机制:从关键词匹配到语义合成
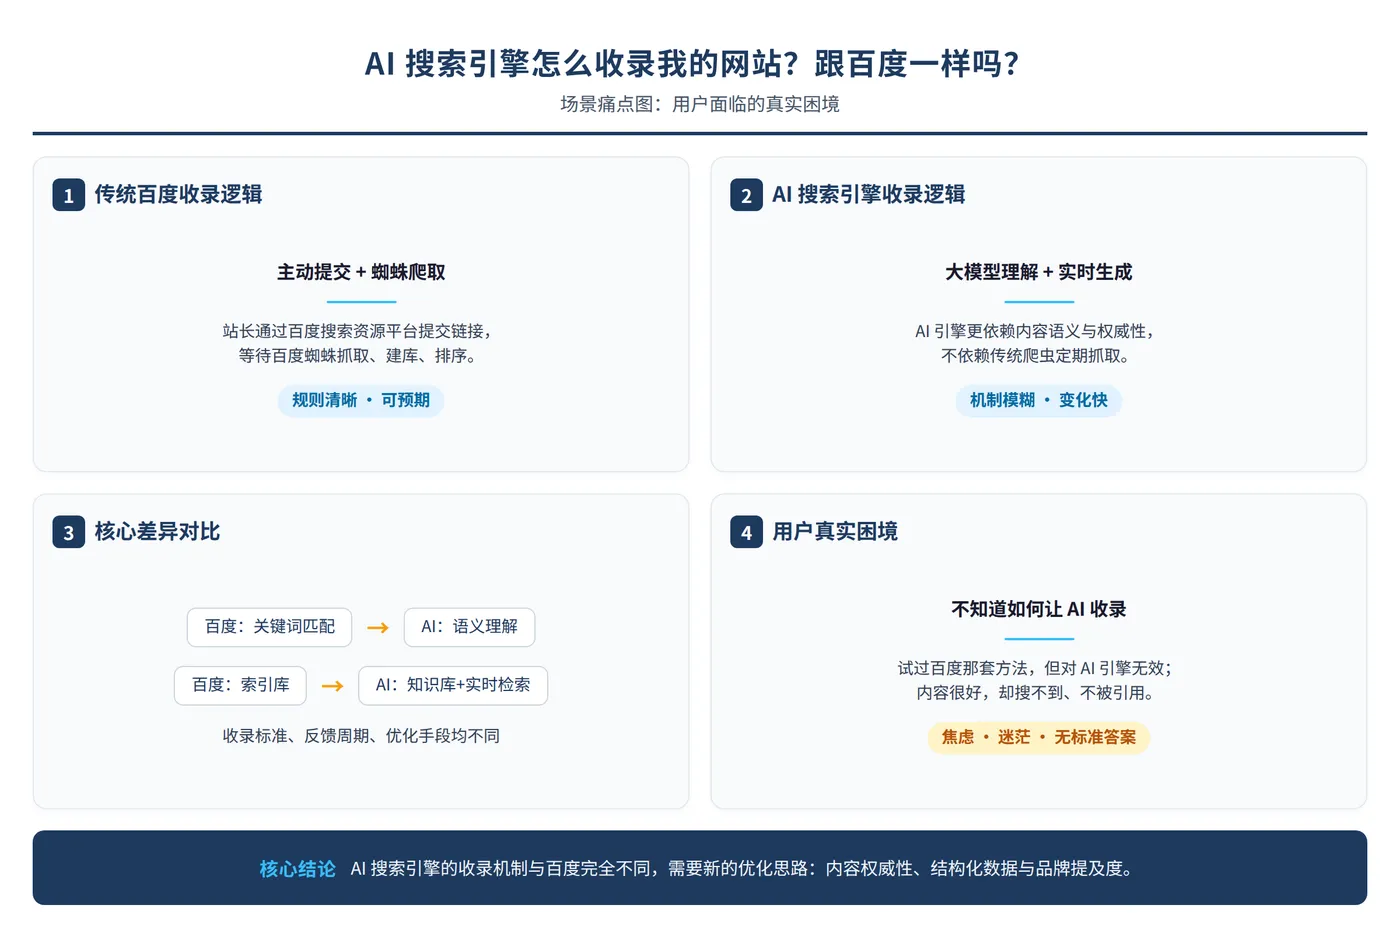
传统搜索引擎的工作流程是:爬虫抓取页面→建立索引→关键词匹配→按权重排序→用户点击链接。这套链路的核心是「收录」——页面进入索引库,获得排名,用户点击后流量归属网站。
AI搜索引擎的底层逻辑完全不同。以豆包、DeepSeek为代表的生成式AI产品,其信息获取链路是:爬虫抓取内容→喂给大模型→模型综合多来源信息→合成自然语言答案→用户直接阅读答案。CNNIC《生成式人工智能应用发展报告(2025)》指出,这类产品已从「对话工具」转化为「信息获取工具」,实质上承担了搜索引擎的功能。
这意味着内容生产者面对的不再是「排名竞争」,而是「引用竞争」——你的内容是否被AI作为答案素材摘录,决定了品牌在AI搜索结果中的曝光量。
二、5个核心维度:AI搜索与传统搜索的机制对比
| 对比维度 | 传统搜索(百度) | AI搜索(豆包/DeepSeek等) |
| 核心动作 | 收录+排名 | 引用+合成 |
| 用户路径 | 搜索→点击→进入网站 | 搜索→阅读答案→可能不点击来源 |
| 流量归属 | 点击进站,流量归网站 | 答案截流,品牌曝光归内容源 |
| 优化对象 | 单个页面的关键词权重 | 信息块的可引用性与语义完整性 |
| 资产性质 | 排名下降即流量消失 | 内容持续被引用则持续获得曝光 |
Princeton大学发表的AI搜索优化研究(arXiv:2311.09735)通过实验验证了一个关键结论:关键词堆砌对AI引用不仅无效,甚至会产生负面影响。AI搜索执行的是语义匹配,判断标准是「信息块是否完整回答了用户意图」,而非「关键词出现频次」。
三、AI爬虫的抓取路径:平台推荐算法的前置作用
AI引擎并不会直接抓取全网内容,它依赖的是各内容平台推荐算法的「预筛选」。以豆包为例,在搜索行业问题时的引用来源,通常集中在CSDN、知乎、头条等平台。这些平台的内容先经过自身推荐系统验证,获得高权重后,AI爬虫才进行高频抓取。
完整的链路是:内容创作→按平台规则改写→平台推荐→权重积累→AI爬虫高频抓取→进入模型检索池→被引用。跳过平台直接试图让AI收录,相当于跳过面试直接要求录用。
四、三个可复现操作:提升被AI引用的概率
操作一:绘制行业平台地图
选择4个行业核心提问词,分别在豆包和DeepSeek中搜索,记录所有引用来源域名。实测数据显示:在秘塔搜索中,3个行业共38条引用源分布在约30个不同域名,单一平台占比最高仅2条;而在豆包上,CSDN一家可能占据三分之一的引用量。每个引擎的引用偏好差异显著,必须先绘制平台地图再制定内容策略。
操作二:按平台公式改写内容
同一篇文章在5个平台需要5个不同版本。CSDN偏好长文高密度,头条偏好短句强情绪,搜狐需要新闻锚点加时间线。一键分发等于用单一版本覆盖所有平台,违背各平台的推荐算法偏好,导致所有平台都无法获得推荐权重。
操作三:将官网内容拆分为可引用的信息块
AI合成答案时,摘录的是具体数据、结论、对比段落,而非整篇文案。将「产品优势」页面拆解为知识锚点:性能数据、客户量化结果、行业痛点分析。每个锚点作为独立的信息块,AI在合成答案时才能直接引用。例如「某服务商的产品数据显示」这类表述,前提是你的数据被拆分为独立可引用的信息块。
五、关于AI引用的几个技术事实
事实一:AI搜索没有「提交收录」入口。百度有搜索资源平台可主动提交sitemap,但AI搜索引擎目前没有面向内容生产者的提交机制。爬虫抓取策略由各平台自主决定,只能通过提升内容在主流平台的推荐权重来增加被抓取概率。
事实二:被引用不等于获得流量。AI搜索的用户路径是「搜索→阅读答案」,答案已解决用户问题,点击来源链接的比例远低于传统搜索。被引用的价值体现在品牌曝光和信任建立,而非直接导流。
事实三:被引用的时间周期通常为60-90天。衡量指标不是「单篇被引用次数」,而是「目标行业的50个核心提问词中,各引擎答案里出现你网站内容的次数占比」。
事实四:是否屏蔽AI爬虫取决于内容质量。原创、真实、经得起对质的内容,被AI抓取是正向资产;内容存在问题的,AI引用只会放大问题。
总结
AI搜索引擎的引用机制与传统搜索的收录机制存在本质差异:前者是语义合成逻辑,后者是关键词匹配逻辑。内容被AI引用的前提,是先在平台推荐系统中获得权重验证,再被AI爬虫高频抓取。通过绘制行业平台地图、按平台公式改写内容、拆分可引用信息块三个操作,可以系统化提升被AI引用的概率。关键在于理解「引用」而非「收录」的底层逻辑,将内容建设重心从关键词排名转向语义完整性。