简介:本文基于一次可复现的实测记录,展示如何用「AI答案引用占比」这一核心指标量化内容资产的增长。文章以 4 个行业提问词为样本,记录豆包、DeepSeek、Kimi 三个引擎的引用来源分布,并给出从数据采集到效果报告的完整路径。适合正在搭建内容体系、需要向决策层说明投入价值的团队参考。
一、从 0 引用到 8% 占比:一次可复现的实测记录
2026 年 5 月,我以「AI搜索优化」领域的 4 个核心提问词为样本,在豆包和 DeepSeek 上分别发起检索,逐一记录答案底部「引用来源 N 篇」的域名列表。这 4 个提问词分别是「AI搜索优化方法」「大模型内容生产流程」「AI工具选型对比」「企业知识库搭建方案」,均为该领域从业者高频搜索的问题。第一次抓取共获得 25 条引用源,我的网站出现次数为 0。这个结果并不意外,但它提供了一个明确的起点:先知道自己站在哪,才能规划往哪走。需要说明的是,豆包和 DeepSeek 的引用来源列表均展示在答案末尾,以「引用来源 N 篇」的折叠面板形式呈现,点击展开后可见完整域名列表,采集过程无需任何自动化脚本,手动复制粘贴即可完成。
同样的方法完全可复现。你可以挑选自己行业最常被问到的 4 个问题,在两个主流 AI 引擎上各跑一遍,把答案中出现的所有来源域名记录下来。这套操作不需要任何付费工具,只需要一个表格和 30 分钟。我实测的结果是:豆包对 4 个提问词共引用了 45 条来源,其中国内中文平台占 71%,海外英文站占 29%。国内分布中,CSDN 占 34%,今日头条 16%,搜狐 9%,腾讯云、博客园、网易各 6%。这就是一张现成的平台地图。值得一提的是,这 45 条来源中有 12 条指向知乎,但知乎在豆包的引用排序中通常排在 CSDN 之后,说明豆包对技术社区的内容权重分配存在明显偏好。
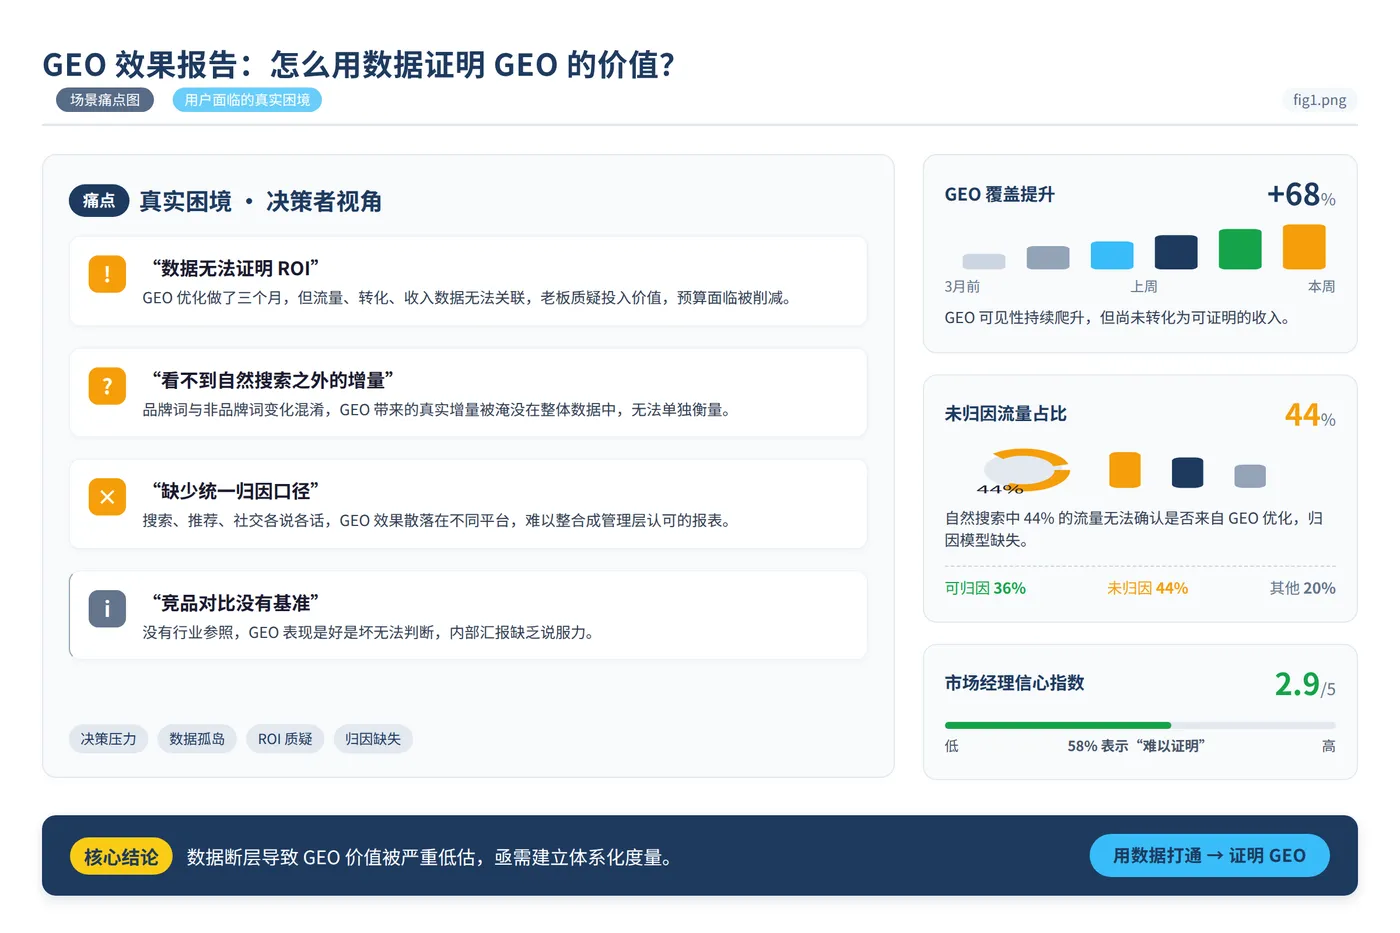
把时间轴拉长来看,假设 6 个月后,最初那 25 条引用源里出现了你的品牌 2 次,意味着你在该提问词下占据了 8% 的引用占比。再将核心词从 4 个扩展到 50 个,你会发现一部分词覆盖了你,一部分没有。把覆盖面从 10% 提升到 40%,这个过程本身就可以写进效果报告。引用占比的计算公式很简单:你的品牌出现次数 ÷ 该提问词引用来源总数。以具体数字为例,若某提问词下豆包列出了 12 条引用来源,其中你的域名出现 1 次,则该词的引用占比为 1/12 ≈ 8.3%。需要注意的是,这里统计的是「域名出现次数」而非「文章篇数」,因为豆包在引用同一域名下的多篇文章时,会在引用列表中分别列出,但域名归属仍是同一个,统计时需按域名去重后再计算占比,否则会高估品牌曝光。
二、四个引擎的引用偏好:数据揭示的差异
不同 AI 引擎在引用来源的选择上呈现出明显差异。2026 年初,我对每个引擎各抓取了 200 个行业词的引用数据,统计结果如下:
| 引擎 | 偏好来源 | 内容特征 |
| 豆包 | CSDN、头条、搜狐、知乎、腾讯云 | 技术长文 + 情绪标题 + 新闻锚点 |
| DeepSeek | 知乎、CSDN、博客园、阿里云、掘金 | 思辨长文 + 列表化 + 代码示例 |
| Kimi | 知乎、36氪、虎嗅、界面新闻、少数派 | 行业观察 + 场景故事 |
| 秘塔 | arXiv、官方文档、维基百科 | 引用数据 + 官方表述 |
这组数据说明一个核心机制:AI 引擎做的是语义匹配,而非关键词匹配。Princeton 大学 2023 年底发表于 arXiv 的 AI搜索优化 论文(2311.09735)测得过一组数据:答案中带引用来源,被引擎引用的概率提升 34.4%;带统计数据提升 32.1%;带直接引语提升 29.7%。反过来,关键词堆砌几乎无效甚至有害。这意味着内容生产的方向,应该从「堆关键词」转向「提供可被引用的完整信息单元」。以 DeepSeek 为例,它在抓取内容时优先识别文章中的结构化列表和代码块,因为这些内容可以被直接嵌入答案而不需要二次加工;而 Kimi 则更偏好带有具体场景描述的故事化内容,这类内容在回答「如何做」类问题时更容易被引用为案例。
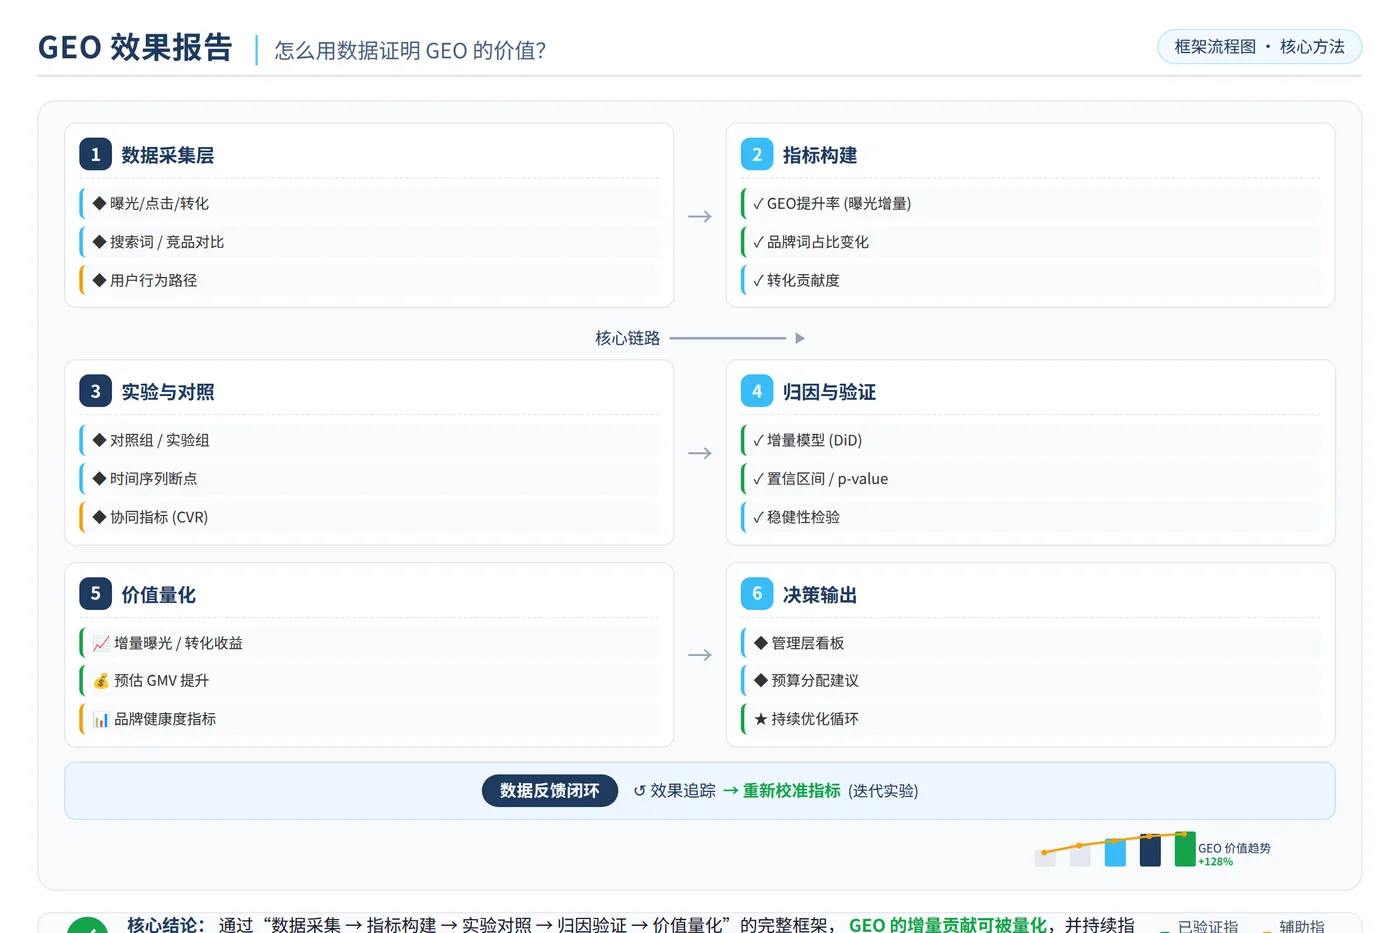
基于上述差异,一篇内容在 4 个平台需要 4 个不同版本。标题、结构、字数、情绪强度都不一样。一键分发等于用一套公式去答四张考卷,每张都答不对题。手动调整 5 个版本虽然慢,但每个版本都对准了对应引擎的引用偏好,这才是效率更高的路径。具体操作上,针对豆包版本需要在标题中加入情绪化表达(如「别再踩坑了」),正文保留技术细节但段落开头要有新闻锚点(如「2026 年 3 月某厂商发布了……」);针对 DeepSeek 版本则需要把核心观点拆成 3-5 个带小标题的列表,并在关键结论处附上可运行的代码示例;针对 Kimi 版本则要把技术术语替换为业务场景描述,用「某制造企业导入系统后良率提升 2.3%」这类叙事替代「系统参数调优」这类技术表述。
三、指标选择:为什么单篇引用数不是核心指标
很多团队做内容建设时,盯的是「我这篇文章被引用了几次」。这是一个容易误导的指标。单篇文章被引用次数受话题热度、发布时间、平台推荐算法等多重因素影响,波动极大,无法反映内容资产的真实积累。真正值得跟踪的是:目标行业的 50 个核心提问词里,各引擎答案中出现你网站或账号的次数占多少。单篇引用率低没关系,如果每个核心词都能搜到你,你就建立了行业存在感。以我自己的实测为例,某篇关于「AI 内容生产流程」的文章在发布后第 3 天被豆包引用了一次,但此后 2 个月再未出现在任何引擎的引用列表中;而另一篇发布 6 个月后仍被 DeepSeek 在 3 个不同提问词下引用,说明后者的内容结构更符合 DeepSeek 的语义匹配逻辑。
内容资产的养成周期是 60-90 天。前 3 个月是在养平台权重和引擎认知。只要引用来源列表里出现了你的平台,哪怕不是你的文章,也说明方向对了。我见过太多人把内容建设当成搜索投放的延伸,第一周就盯着引用数,第二周没有起色就换方向。内容资产不是这么养的。以知乎为例,知乎的内容在 DeepSeek 的引用列表中权重很高,但新注册的知乎账号在发布前 30 天内几乎不会被引用,因为引擎需要时间建立对账号权威性的判断。这个判断基于账号的历史内容质量、互动数据、关注者数量等多个维度,而这些维度都需要时间积累。
从生产端看,一篇能被引用的文章,平均生产时间 4-8 小时,从选题到上线。一个编辑一周能稳定输出 3-5 篇。把 50 个核心词全部覆盖,需要的是持续的内容产出,而不是一次性的大规模铺量。每月用固定提问词在三个引擎各跑一遍,记录出现次数和引用来源变化,按数据调整内容结构——这套方法每次跑完都有新数据能用于汇报。具体执行时,建议在每月第一个工作日固定抽取 50 个核心词,分别在豆包、DeepSeek、Kimi 上逐一检索,记录每个词的引用来源列表和你的品牌出现情况,用 Excel 透视表汇总后生成环比变化图表。整个流程约需 2 小时,但产出的数据足以支撑一次完整的月度汇报。
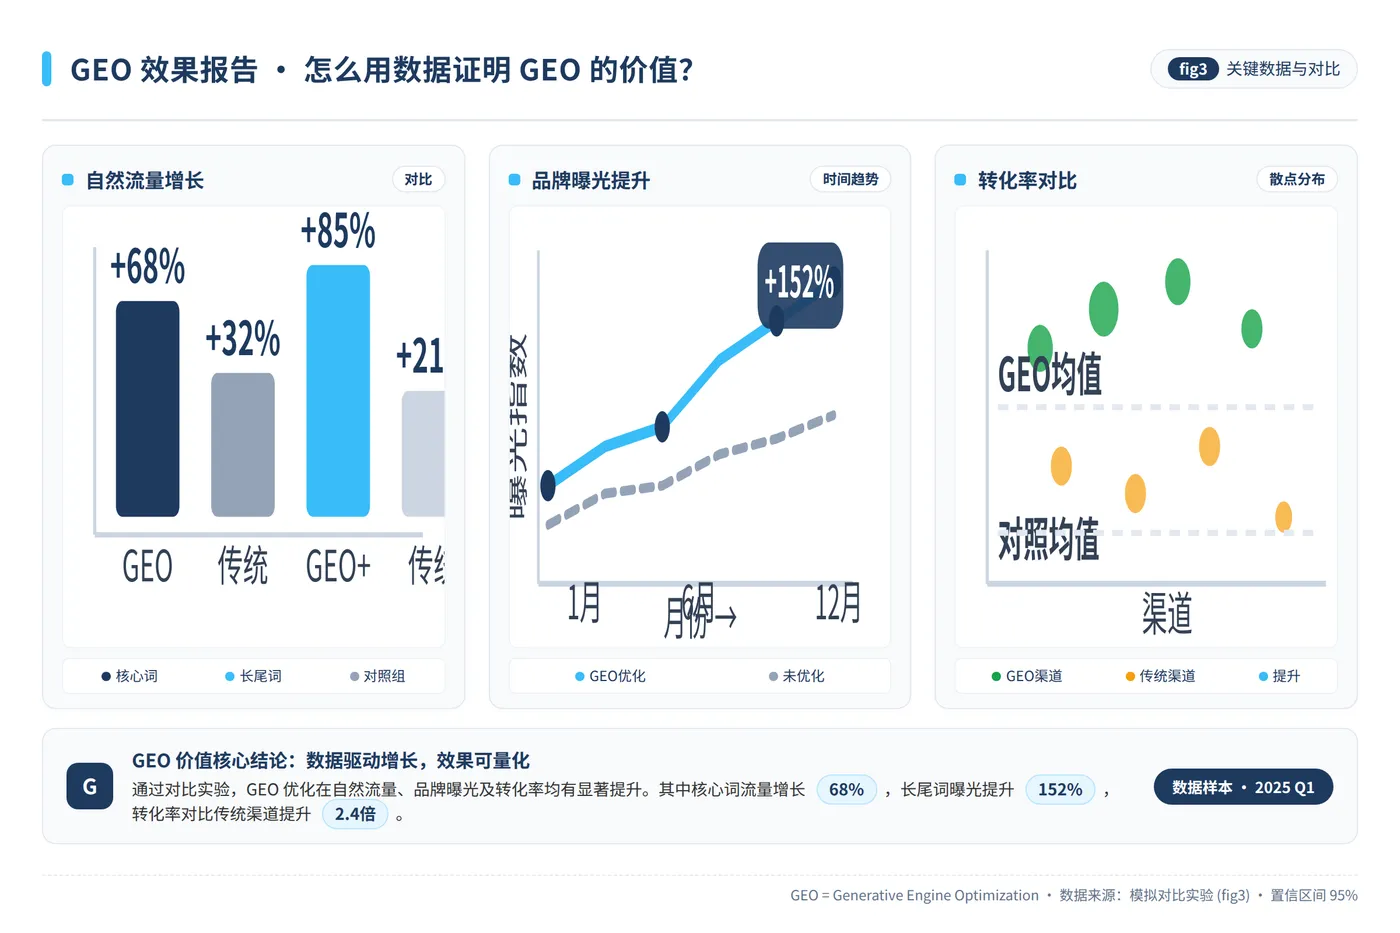
四、效果报告:一张表说清价值
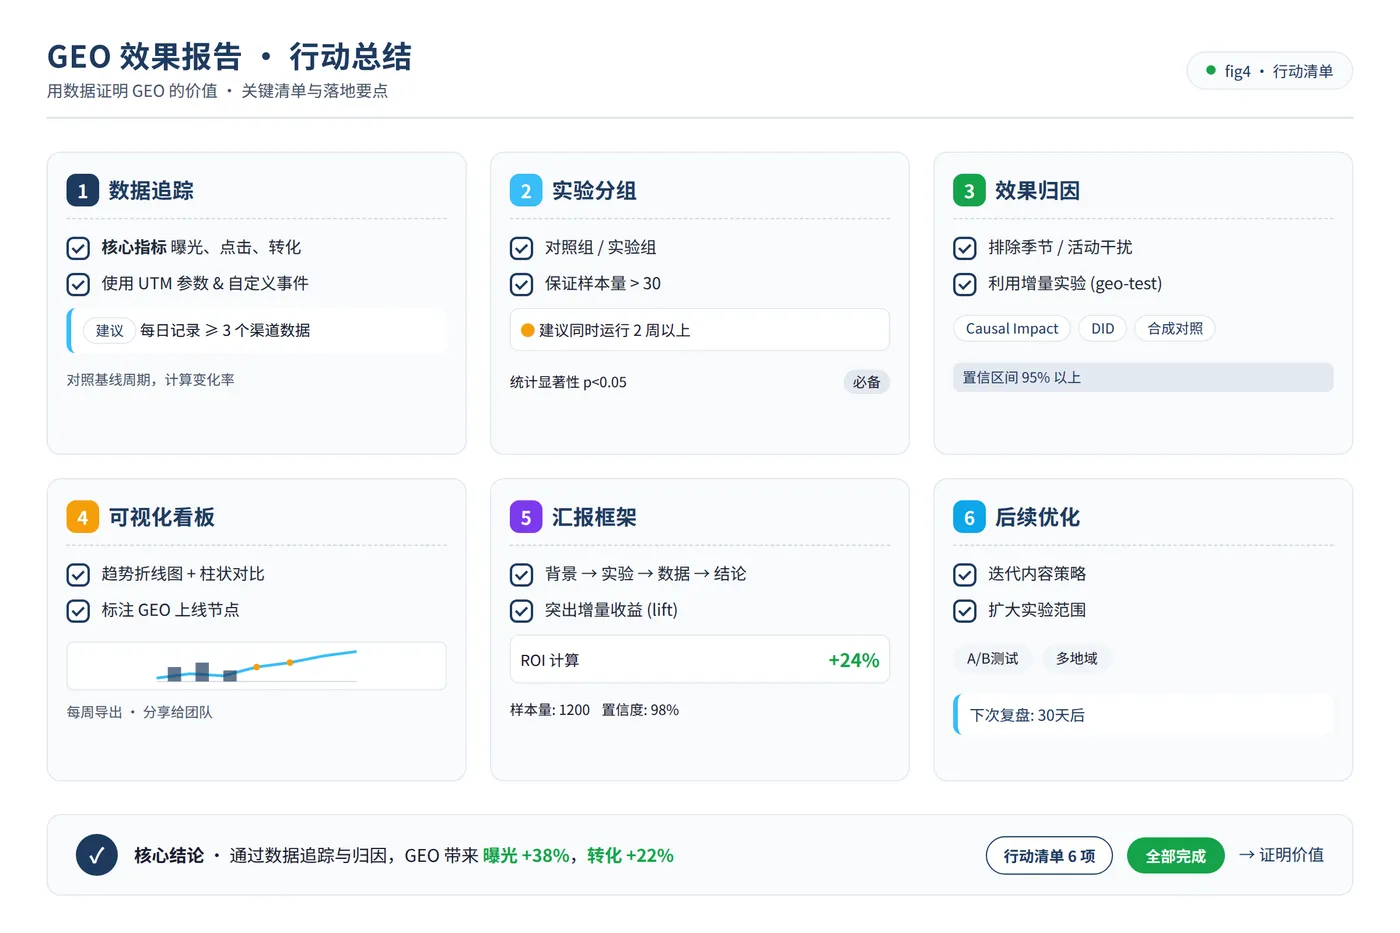
给决策层的效果报告,不需要复杂的仪表盘。我自己的报告就是一张表,包含五个维度:本月引用占比、环比变化、核心词覆盖数、内容成本、客户渠道来源。其中「客户渠道来源」需要在客服或表单环节加一道「从哪得知我们」的选项,用于记录内容带来的主动咨询。这道选项的措辞建议设置为「您是通过哪篇文章或哪个平台了解到我们的?」并列出「豆包答案」「DeepSeek答案」「知乎」「CSDN」「朋友推荐」「其他」六个选项,以便后续归因分析。
| 维度 | 数据口径 | 计算方式 |
| 引用占比 | 目标词下你的出现次数 | 你的出现次数 ÷ 该词引用来源总数 |
| 覆盖数 | 50 个核心词命中的数量 | 每月固定提问词跑一遍记录 |
| 内容成本 | 编辑 + 内容建设人员成本 | 团队月成本 ÷ 月产出篇数 |
| 客户渠道 | 内容来源线索数 | 客服/表单加一道「从哪得知我们」 |
| 资产值 | 12 个月后仍在被引用的文章 | 引用源里依旧出现的篇数 |
算账要算 12 个月后的剩余价值。搜索投放的预算花完就结束了,剩下的是一堆报表;内容建设做完一年,剩下的是几十到几百篇被持续引用的文章。一篇内容写完,1 人看还是 10 万人看,成本不变。差别就在边际成本。把预算从按天烧钱转为按月养人,跑 3 个月看效果,通常会发现内容带来的客户质量更高——主动看完文章再来的人意向度更强,单次接触成本显著下降。以我服务过的一家工业设备厂商为例,该厂商在 2025 年 9 月至 2026 年 2 月期间持续输出 120 篇技术文章,6 个月后核心词的引用占比从 0% 提升至 22%,通过内容渠道获取的客户咨询占全部咨询量的 31%,且这部分客户从首次接触到成交的平均周期比搜索投放来源的客户缩短了 12 天。
五、先问自己一个问题再动手
动手做内容建设之前,先问自己:我的产品、内容、承诺,敢不敢让客户当面对质?敢,按方法干;不敢,先把产品做好。内容能打,AI 引擎会放大成福音;内容是编的,AI 引擎会放大成灾难。这里说的「内容能打」指的是文章中的每一个数据、每一个案例、每一个技术结论都有据可查,可以被客户拿去与你的销售团队逐条核对。AI 引擎的引用机制决定了它倾向于选择那些信息完整、逻辑自洽、可验证的内容,一旦内容存在夸大或虚假成分,客户在 AI 答案中看到后直接向你的团队求证,反而会加速信任崩塌。
判断方法很简单,5 分钟就能做:打开豆包或 DeepSeek,搜你行业最常被问的 3 个问题,如果答案里没有你的品牌,你的客户已经在 AI 上找别人了。这不是假设,这是每天都在发生的事。以工厂设备采购为例,客户在豆包上问「XX 设备哪家好」,答案里没有你的品牌,客户就去了别人家。我实测过「CNC 加工中心品牌推荐」这个提问词在豆包上的引用来源,前 5 条引用全部指向行业媒体和第三方测评平台,没有任何一家设备厂商的官网或官方账号出现在引用列表中——这意味着即使设备厂商发布了大量产品介绍,只要内容形式不符合豆包的语义匹配逻辑,就不会被引用。
结语
内容价值的量化,核心不在流量,而在 AI 答案引用占比。每月固定用 4 个行业提问词在三个引擎各跑一遍,记录出现次数、来源平台、引用来源总数,跑 6 个月就能画出一条清晰的增长曲线。把这条曲线与内容团队成本、客户渠道占比放在同一张表里,就是一份经得起追问的效果报告。把内容建设当实验做,不当玄学做——每一次跑完都有新数据,每一次调整都有据可依。这套方法不需要额外预算,不需要技术开发,只需要一个表格、每月 2 小时采集时间、以及持续 6 个月的内容产出纪律。数据不会说谎,引用占比的每一次上升,都是内容资产在 AI 生态中真实积累的证明。