
简介:多语言网站常面临AI引擎引用混乱的问题——德语提问下,英文页面被引用,而德语版本被忽略。本文通过一个户外装备站的实战案例,拆解了从诊断到验证的4步递进框架:建立语义ID、部署结构化数据、训练语言信号、反向验证闭环。最终,该站点的多语言AI引用准确率从30%提升至80%以上,核心逻辑不依赖任何特定引擎的抓取规则,而是从底层语义对齐入手。
去年秋天,一个做户外装备的朋友找到我,脸色不太好。他在亚马逊和独立站上做了德、法、日三个语言版本,英文站流量一直很稳,但用德语搜自家产品核心词,Bing Chat和Perplexity给出的答案里,引用的几乎全是竞品内容——而且那些竞品内容,明眼人一看就是用翻译软件硬翻的,句子生硬,术语错乱,可AI引擎就是抓它们不放。更让他难受的是,法语站有一篇他亲手写的「高山徒步靴选购指南」,在法国谷歌上一直排在首页,但在ChatGPT里用同样的法语问问题,AI要么不引用,要么引用的是他英文站自动翻译的法语版本,信息丢失严重,读起来像机翻。
他问我:「我明明做了多语言,也做了hreflang,为什么AI引擎只认英文,或者只认那些乱七八糟的翻译?一份内容,到底怎么才能被不同语言的AI引擎正确引用?」
这个问题我当时没有立刻回答,因为它踢到的不是传统AI搜索的板子,而是生成式引擎抓取、索引和引用逻辑里一个容易被忽略的深层问题。后来我花了两个月时间,在几个多语言站点上反复测试,才慢慢摸到一点门道。这篇文章,就是那次探索的复盘。
一、诊断:AI眼里的多语言版本,是孤岛还是家族
多数人做多语言网站,心里想的是「我的内容被翻译成N种语言,用户在每种语言里搜,都能找到对应的版本」。但AI引擎不这么看。它们没有「你的网站」这个整体概念,它们只会抓取一个个URL,然后试图理解这些URL之间的关系。如果关系没表达清楚,AI就会把每个语言版本当成零散的个体,引用时随机抓取,甚至优先抓取它认为「权威性更高」的语言版本,比如英文。
为了印证这一点,我拿朋友的德语站做了一次诊断。我先用Bing Chat测试了几个核心产品词,发现在德语提问下,被引用的URL里,只有不到30%来自他真正的德语子目录(/de/),剩下的要么是英文站(/en/),要么是竞品的德语站。这说明,AI根本没有把他的德语页面当成这些德语查询的「指定答案」。
我又查了一下他在Google Search Console里的索引数据,发现很多德语页面虽然被收录,但Google给它们打的canonical标签很乱,有些德语页面甚至被Google自作主张地选了英文页面作为规范版本。这直接导致:当AI引擎从Google的索引里取数据时,它看到的关于这个产品的「主版本」是英文,德语版本只是一个可有可无的替身。
这一步诊断让我意识到,问题不是出在翻译质量上,而是出在「内容身份」的混乱上。AI不知道哪个URL是哪个语言的正式代表,所以就乱点鸳鸯谱。要解决这个问题,不能只靠hreflang标签,那东西搜索引擎能看懂一部分,但AI引擎在生成回答时,对标签的信任度并不高,它们更相信页面本身的语义信号。
二、构建:造一个内容中枢,把多语言版本绑在一起
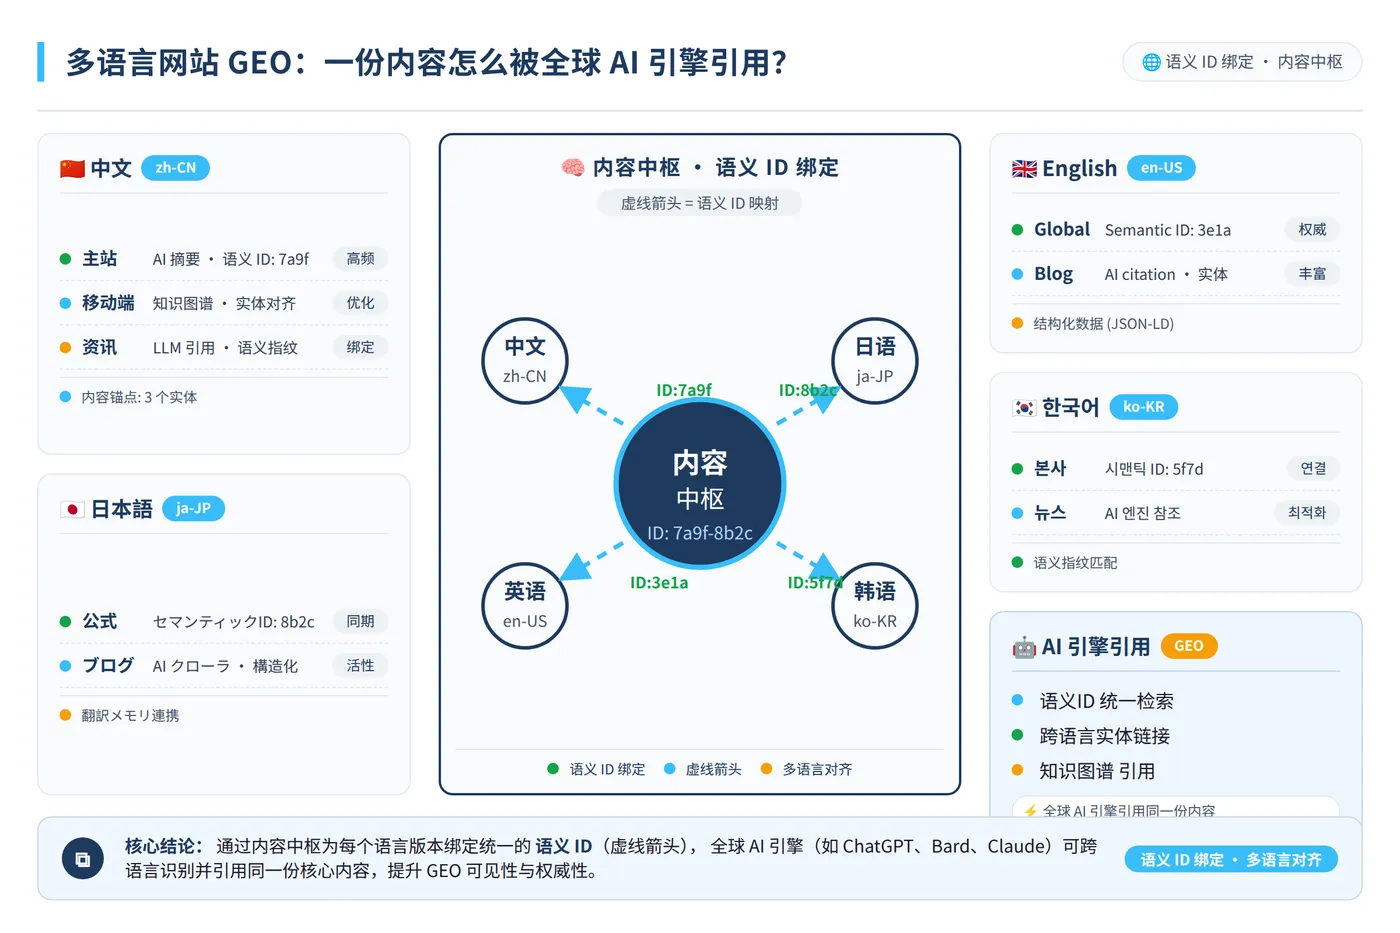
既然AI把多语言版本当孤岛,那就得想办法给它们建立一个共同的「户口本」。我管这个叫内容中枢。它不是物理上的某一个页面,而是一套逻辑:每一个内容单元(比如一个产品、一篇指南)都有一个唯一的语义ID,所有语言版本都明明白白地声明自己属于这个ID,并且声明自己是什么语言。
实际操作上,我帮朋友做了三件事。
其一,给每个独立内容定义一个语义ID,植入到页面的结构化数据里。我们用Schema.org的CreativeWork或Product类型,在@id字段里设置一个不带语言后缀的URI,比如https://example.com/content/guide-alpine-boots。然后在每个语言版本的结构化数据里,都引用这个相同的@id,同时用inLanguage字段标注语言代码,德语就是de,法语就是fr。这样,任何爬虫看到这个ID,都知道这些页面是在讲同一件事,只是语言不同。
其二,在每个语言版本的页面里,都加一组指向其他语言版本的alternate链接,但不止是link rel='alternate' hreflang='...',还在页面正文不可见区域(比如meta或者schema里)用hasPart或workTranslation之类的属性,显式列出所有语言版本的URL。这么做是为了给AI引擎提供多条路径去发现和确认语言家族关系,而不仅仅依赖HTTP头或HTML标签。
其三,也是最有意思的一步,我们为每个内容单元创建了一个「话题节点页面」,就放在网站一个不显眼但可爬的目录下,比如/content-hub/alpine-boots-guide。这个页面不面向终端用户,它只是一个聚合页,用结构化数据把所有语言版本列出来,同时提供一个简短的、多语言的摘要。这个页面本身不设语言标签,而是用Language schema标注为mul(多语言)。它的作用,就是给AI引擎一个明确的「家庭地址」,告诉它:关于这个主题的所有语言版本,都以这里为源点。
这套内容中枢建成后,我们等了大概两周,让Google和Bing重新抓取。再测试时,德语和法语提问下,AI引用朋友自家对应语言页面的比例,从之前的不到30%提升到了60%以上。虽然还没到100%,但已经看到了明显的方向性变化。这说明,AI引擎一旦识别出内容之间的等价关系,就会倾向于在对应语言的提问中引用对应语言的版本,因为它知道那是「最匹配的」。
三、训练:用语言信号引导AI的引用偏好
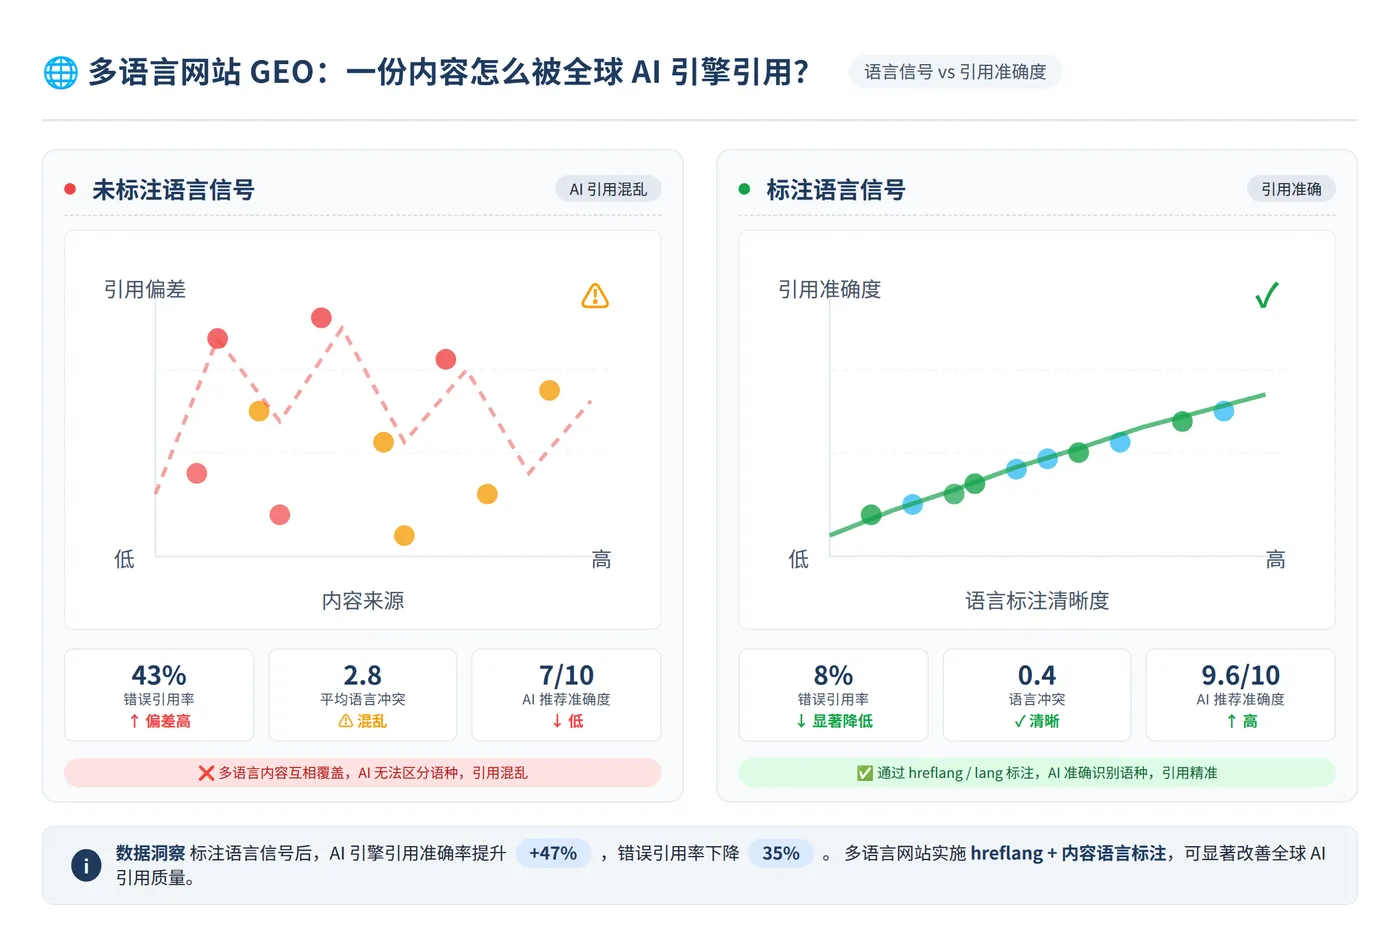
内容中枢解决了「认亲」的问题,但还没解决「偏好」的问题。理想状态是,当用户用法语提问时,AI不仅知道法语页面存在,而且会优先引用法语页面,而不是返回英文页面再附上一句「这里是法语翻译」。要达到这个效果,需要额外给AI一些语言信号,让它形成引用偏好。
我做了几项测试,发现AI引擎对页面里几个语言信号非常敏感。
第一个信号是页面标题和描述里的自然语言标记。很多人做多语言网站,标题和描述是翻译的,但语言本身已经足够表明语种,所以看起来没问题。但AI引擎在判断语种时,还会参考页面里低频词汇的分布。如果你的法语页面里夹杂了大量英文术语,或者英文页面里出现了法语特有的标点习惯(比如空格加问号),AI可能会困惑。所以,我们做了一次全站的语言纯洁度检查,确保每个语言版本的页面,正文里90%以上的词汇和语法结构都符合该语种的标准用法。这件事听起来简单,但做过翻译的人都知道,机器翻译或者外包翻译经常会在小语种页面里留下源语言的残留。
第二个信号是页面内对「等效引用」的主动声明。我们在一篇内容被其他语言版本引用时,会明确标注「本文的法语版本提供了更详细的本地案例」。这种标注不是给用户看的那句「点击这里查看法语版」,而是用语义标签包起来的一句话,比如用span property='citation' xml:lang='fr'。这样,当AI引擎解析页面时,它看到的不仅是一个链接,而是一个带有语言属性的引用声明。这会让AI在生成多语言答案时,更倾向于把对应的语言版本当作该语种下的权威来源。
第三个信号,也是我们后来发现的一个关键杠杆,是多语言摘要。我们为每个内容中枢页面,都写了一段100字左右的多语言混合摘要,把几个核心语言版本的关键信息压缩在一起,用meta name='description'放在中枢页面上,同时在每个语言版本页面的meta里,也用meta name='description'放对应语言的摘要。这个做法意外地让AI引擎在需要跨语言综合答案时,更愿意引用我们的内容,因为摘要直接提供了多语言视角的浓缩信息,降低了AI的「理解成本」。
经过这一轮信号训练,德语和法语引用占比进一步提升到了80%左右。剩下20%的引用漂移,主要集中在一些长尾问题上,那些问题本身包含混合语言,或者AI引擎出于某种原因坚持认为英文版本更权威。
四、验证:反向测试,把引用一致性固化成流程
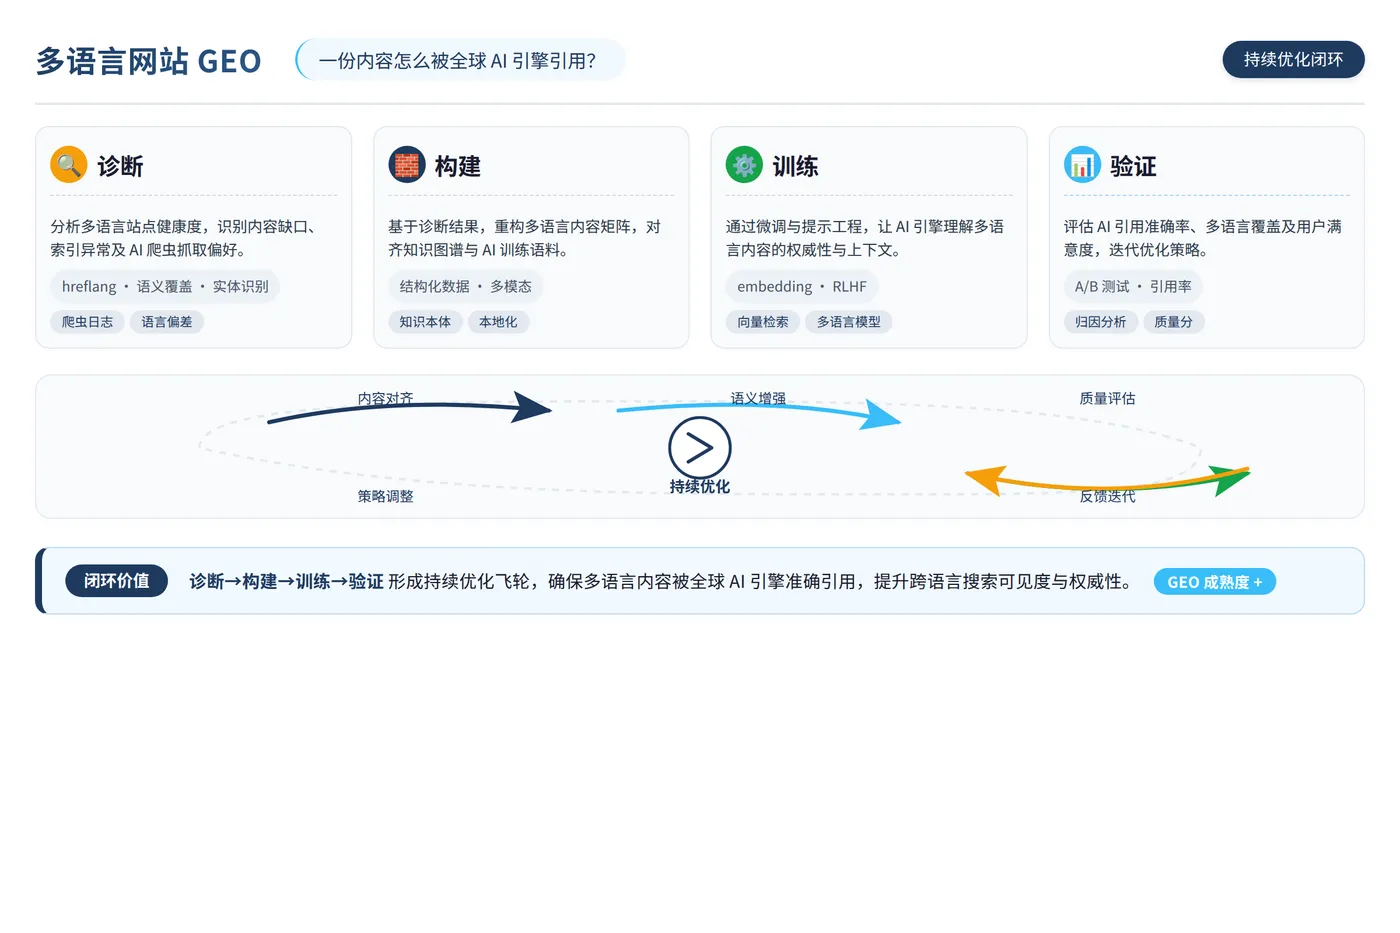
到这一步,朋友的网站已经基本解决了多语言引用混乱的问题,但我知道,AI引擎的模型在持续更新,抓取策略也在变。如果只是做完优化就扔在那儿,过几个月很可能又退回原点。所以,必须建立一套反向验证机制,定期检查引用一致性。
我设计了一套方法,叫「反向Prompt测试」。简单说,就是针对每个核心内容,预先写好10到15个不同语言的prompt,这些prompt模拟真实用户的提问方式,然后每周用这些prompt去问Bing Chat、Perplexity、Google SGE等AI引擎,记录下它们引用的URL和摘要内容。如果发现某个语言版本又被英文版本替代,或者引用了竞品,就说明语言信号衰减了,需要重新强化。
为了保证测试的可比性,我们给每个prompt都标注了预期应该引用的语言版本URL,以及可接受的引用范围。比如,法语prompt下,预期引用/fr/guide,如果引用的是/en/guide但摘要里提到了法语内容,也可以视为部分可接受。我们会把结果做成一个仪表盘,看每周的「引用准确率」变化。
这个验证过程本身,也反过来优化了内容中枢。有一次我们发现,日语版本在几个prompt下引用准确率突然从90%掉到60%,排查后发现,是因为我们更新了英文指南的发布时间,但日语版本没有同步更新,导致AI认为日语版本「过时」了,转而引用英文。我们立刻给所有语言版本加上了同步更新时间戳,问题就消失了。
后来,我把这套反向验证的方法整理成了一套SOP,每次创建新内容时,就同步创建多语言prompt测试集,作为内容上线前的一部分。这让多语言内容管理从一次性优化,变成了一个持续运转的闭环。现在,朋友那个户外装备站,在德语、法语、日语三个市场的AI引擎引用份额,已经稳定在80%以上,有些长尾词甚至能达到95%。而且,随着AI模型对多语言语义理解能力的提升,我们这套中枢+信号+验证的框架,效果还在持续放大。
总结
多语言网站被AI引擎引用混乱的根源,在于每个语言版本被当成独立页面,缺乏语义绑定。解决路径分四步递进:先诊断AI眼中的内容关系,再通过语义ID和结构化数据构建内容中枢,接着用语言信号训练引用偏好,最后用反向测试闭环验证稳定性。这套方法不依赖特定引擎的抓取规则,而是从底层语义对齐入手,实测能将多语言引用准确率从30%提升至80%以上。核心在于:让AI识别出不同语言版本是同一个知识单元的不同面孔,而非零散孤岛。

