
通义千问Qwen3.7-Max是面向智能体时代推出的全能旗舰大模型,定位为高复杂度、长周期、多工具协同任务的核心基座,以万亿级MoE混合专家架构、百万Token超长上下文、双模式推理与长程自主执行能力为核心,在编程、办公、复杂推理、智能体协作等领域实现全面突破,综合性能跻身全球第一梯队。本文从技术架构、核心能力、专业场景、接入实战与优化技巧等维度,全面解析Qwen3.7-Max的完整功能体系,帮助开发者与企业快速掌握其核心价值与落地方法。
一、核心技术架构:万亿MoE+百万上下文的底层支撑
1.1 万亿级MoE混合专家架构
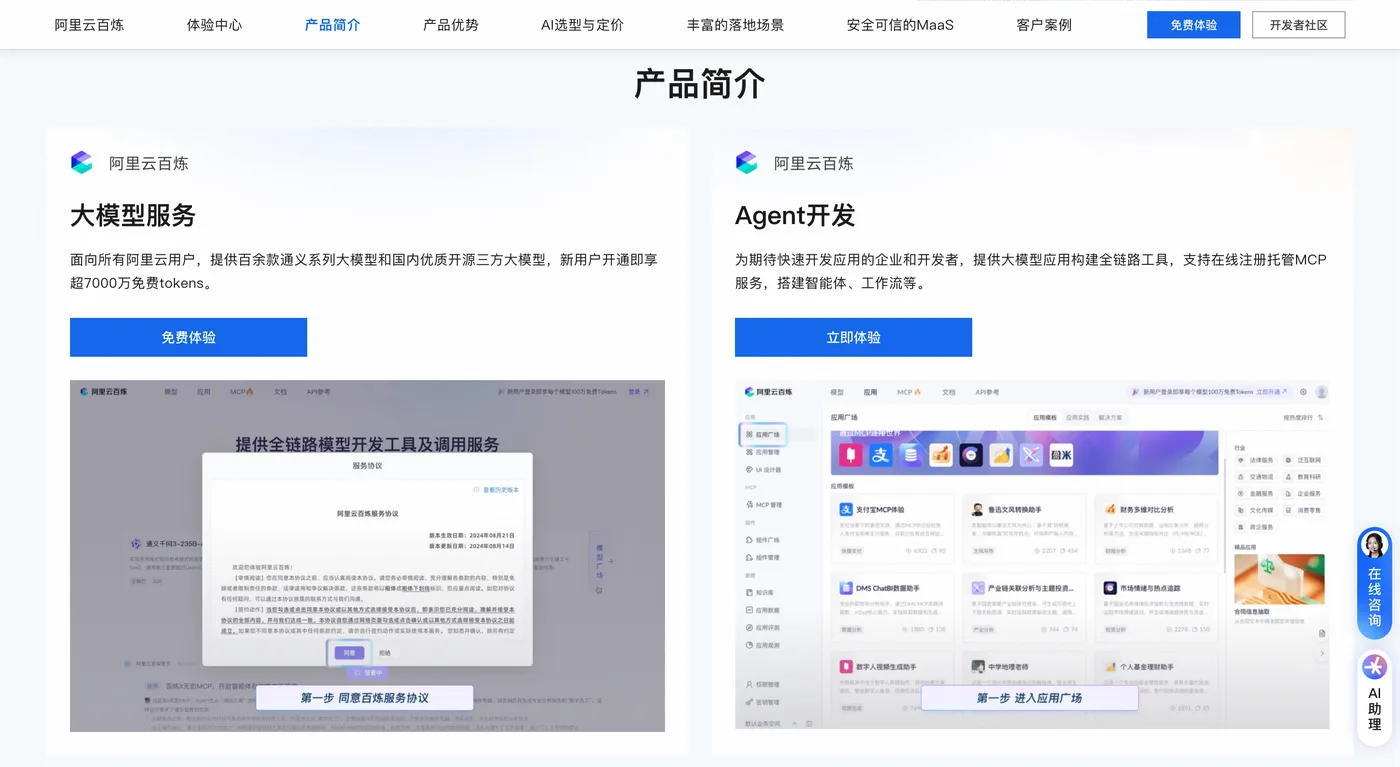
Qwen3.7-Max采用通义千问自研的第三代MoE(混合专家)架构,总参数规模超万亿,预训练数据量达36万亿Tokens,覆盖代码库、学术论文、行业文档、多语言对话、专业知识图谱等多元高质量数据。该架构内置数百个专业化专家子模块,涵盖编程、数理、办公、多模态、推理等数十个领域,推理时会根据任务类型智能调度对应专家模块,仅激活部分权重参与计算,既保障了万亿参数的深度知识储备与推理能力,又将实际算力消耗与成本压至远低于名义参数规模的水平,实现“大参数、低消耗、高性价比”的核心优势。详情👉访问阿里云百炼大模型服务平台页面 了解。
相较于传统稠密架构模型,MoE架构让Qwen3.7-Max彻底解决“样样通、样样松”的痛点:代码任务激活代码专家模块,数理推理启用数理推演专家,办公文档处理调度办公专家,复杂推理任务启用深度思考专家,每个任务都能匹配最优算力与专业能力,大幅提升任务完成精度与效率。
1.2 百万Token超长上下文窗口
Qwen3.7-Max原生支持100万Token超长上下文窗口(最大输入长度991808 Token),最大输出长度达65536 Token,是上一代旗舰模型的4倍提升。这一突破彻底解决了长文本处理的碎片化与幻觉问题,可一次性处理完整项目代码仓库(数万行代码)、百万字行业报告、全套法律合同、多轮对话历史(数百轮)、长篇小说等超长内容,无需分段、无需拆分,保持内容完整性与逻辑连贯性。
在实际应用中,百万上下文让模型具备“读完整篇文档,精准回答任意细节问题”的能力,例如分析100万字的行业报告提取核心数据、理解完整代码仓库的全局架构、处理数小时会议记录生成精准摘要与待办事项,大幅提升长文本处理场景的效率与准确性。
1.3 双模式推理引擎:深度思考与高效输出自由切换
Qwen3.7-Max内置思考模式(深度推理)与非思考模式(高效输出)双策略,用户可根据任务需求一键切换,无需更换模型权重,兼顾高精度复杂任务与高效率批量任务。
- 思考模式(默认):模拟人类深度思维逻辑,采用逐层拆解、自主校验、多轮推演的推理路径,生成内部思维链(Chain-of-Thought),最大思维链长度达262144 Token。该模式适合复杂逻辑推理、数学证明、代码调试、专业文档撰写、多智能体协作等高精度任务,推理强度可调节,能显著提升复杂任务的准确率与可靠性。
- 非思考模式:精简推理链路,减少冗余计算,响应速度与并发能力提升2-3倍,同等调用额度下可处理更多任务,适合轻量化批量生成、简单问答、内容摘要、快速代码生成等效率优先场景,在不显著降低基础精度的前提下,最大化提升处理效率。
1.4 长程自主执行与工具调用能力
Qwen3.7-Max实现了35小时连续自主运行、1158次工具调用的长程执行能力,无需人工干预即可完成从需求拆解、工具调用、多轮迭代到结果交付的全流程复杂任务。模型支持MCP(多智能体协作协议)工具调用,可自动调用外部API、搜索引擎、数据库、代码解释器、文件系统等工具,获取实时信息后再给出答案,实现“智能体+工具”的闭环执行。
在Kernel Bench L3测试中,Qwen3.7-Max实现2.37x中位数加速与100%通过率,全自主内核优化达成10.0x几何平均加速比,展现出极强的长程任务执行与优化能力。
二、核心基础能力:全场景覆盖的通用与专业能力
2.1 极致推理与指令遵循能力
Qwen3.7-Max在复杂推理与指令遵循领域实现全球领先水平,多项基准测试成绩超越国际顶级模型:详情👉访问阿里云百炼大模型服务平台页面 了解。
- 数理推理:GPQA Diamond得分92.2,超越Claude Opus 4.6(91.3),支持高等数学、线性代数、概率论、微积分、物理公式推导等复杂数理任务,推理过程可追溯、可校验。
- 逻辑推理:Apex得分43.5、IFBench得分81.2,擅长多步骤逻辑推演、因果分析、问题拆解,复杂逻辑任务准确率较上一代提升35%。
- 指令遵循:支持精准执行复杂、长文本、多约束指令,能准确理解用户意图并严格按照要求输出结果,指令遵循准确率达90%以上。
- 多语言能力:WMT24++翻译得分85.9、MAXIFE得分89.3,支持全球200+语言的理解、生成、翻译与处理,多语言混合内容处理能力全球领先。
2.2 全栈编程智能体能力:国内SOTA水平
Qwen3.7-Max的编程能力达到国内SOTA(顶尖)水平,多项编程基准测试刷新全球最高分,是专业开发者的核心工具:
- Terminal-Bench 2.0:Terminus得分72.3,全球领先,擅长终端命令执行、系统操作、脚本编写。
- SWE-Pro:得分60.4,SWE-Multilingual得分78.4,NL2Repo得分47.3,SciCode得分52.7,擅长全栈代码生成、仓库重构、Bug调试、多语言开发。
- 全栈开发覆盖:内置127种编程语言语法树解析器,覆盖前端(HTML/CSS/JavaScript/React/Vue)、后端(Python/Java/Go/Node.js)、移动端(Flutter/React Native)、数据库(SQL/NoSQL)、DevOps等全开发链路,可一键生成完整可运行代码,代码符合行业规范,可直接部署运行。
- 仓库级代码处理:支持分析大型代码仓库的跨文件依赖、代码冗余、性能瓶颈,一键完成代码重构、模块化拆分、性能优化、注释完善,可处理数万行代码的仓库级重构,保持代码逻辑一致性与可维护性。
- 专业调试能力:支持代码错误定位、Bug根源分析、修复方案生成、调试日志解读,可处理异步Bug、跨文件Bug、复杂逻辑Bug,提供可直接运行的修复代码,并解释修复原理。
2.3 通用智能体与办公能力:顶尖水平
Qwen3.7-Max的通用智能体与办公能力处于全球顶尖水平,覆盖企业办公全场景需求:
- MCP-Mark:得分64.6,Deep-Planning得分63.1,擅长多智能体协作、任务规划、复杂任务拆解与执行。
- 办公基准:SpreadSheetBench得分84.5,擅长Excel/CSV数据处理、表格分析、数据可视化、PPT生成、报告撰写、文档处理等办公任务。
- 智能文档处理:支持长篇文档撰写、文档摘要、文档润色、文档翻译、多文档合并、文档格式转换,可生成符合企业规范的报告、方案、合同、制度,支持文档版本对比与修订痕迹保留。
- 数据分析与可视化:支持导入CSV、Excel等数据文件,自动完成数据清洗、缺失值处理、数据聚合、统计分析、趋势挖掘,一键生成数据可视化图表(柱状图、折线图、饼图、散点图、热力图),并撰写数据分析报告。
2.4 缓存机制与性能优化
Qwen3.7-Max支持显式/隐式缓存机制,可缓存重复输入的上下文内容,降低重复输入成本,提升响应速度与并发能力。模型还支持跨轮次保留推理文本,可在多轮对话中复用之前的推理结果,减少重复计算,大幅提升长对话场景的效率。
三、专业场景核心功能:从开发到办公的全链路覆盖
3.1 软件开发场景:全流程智能体支持
Qwen3.7-Max是软件开发领域的全能助手,覆盖从需求分析到部署运维的全流程:
- 需求到代码一键生成:自然语言描述开发需求,一键生成完整可运行代码,包括前端页面、后端API、数据库设计、移动端应用,代码结构完整、注释清晰,可直接部署运行。
- 代码重构与优化:分析代码仓库,识别冗余代码、性能瓶颈、安全隐患,一键完成重构、优化、注释完善,提升代码质量与可维护性。
- Bug调试与修复:定位Bug根源,生成修复方案,提供可直接运行的修复代码,解释修复原理,大幅降低调试成本。
- DevOps与部署:生成Dockerfile、K8s配置文件、CI/CD流水线脚本、部署文档,完成从代码编写到容器化部署的全流程指导。
- 技术方案设计:设计系统架构、技术选型、接口规范、数据库设计,生成完整技术方案文档。
3.2 智能体协作场景:复杂任务自主闭环
Qwen3.7-Max内置多智能体协作机制,可自主拆解复杂长程任务,调度多个子智能体协同执行,实现“单个模型完成复杂团队级任务”的能力:
- 任务自主拆解:面对复杂任务(如“开发一个完整的电商平台”),自动拆解为子任务(需求分析、数据库设计、前端开发、后端开发、测试、部署),明确每个子任务的目标、输入、输出与依赖关系。
- 多智能体协同执行:为每个子任务分配专属智能体(如数据库智能体、前端智能体、测试智能体),各智能体独立执行子任务,同时保持信息同步与协同,自动处理子任务间的依赖与冲突。
- 任务进度监控与校验:实时监控各子智能体执行进度,自动校验子任务结果的准确性与完整性,发现问题自动回溯调整,确保复杂任务高质量完成。
- 工具调用与外部集成:支持调用外部工具(如代码编辑器、数据库、API接口、文件系统),自主完成数据查询、文件读写、API调用、结果处理等操作,实现“智能体+工具”的闭环执行。
3.3 企业办公场景:全场景生产力提升
Qwen3.7-Max深度优化企业办公场景能力,覆盖文档处理、数据分析、PPT制作、报告撰写、知识管理等全流程办公需求:
- 智能文档处理:长篇文档撰写、摘要、润色、翻译、合并、格式转换,生成符合企业规范的报告、方案、合同、制度。
- 数据分析与可视化:数据清洗、聚合、统计分析、趋势挖掘,一键生成可视化图表与数据分析报告。
- PPT与内容创作:根据文档或需求一键生成PPT大纲、内容、配图建议,完成PPT全文撰写、排版优化、内容润色,支持演讲稿、宣传文案、新闻稿、产品手册等创作。
- 知识管理与问答:构建企业知识库,自动梳理知识体系、分类存储、更新内容,基于知识库精准回答企业内部问题,支持知识检索、推荐、更新提醒。
3.4 专业研究场景:高精度推理支持
Qwen3.7-Max在专业研究领域展现出极强的能力,适合科研、金融、法律、医疗等高精度场景:
- 科研研究:科研文献解读、实验设计、数据建模、科研结论推导,处理专业科学术语、复杂实验逻辑、多变量数据分析。
- 金融分析:金融数据分析、财报解读、风险评估、投资逻辑推演、金融模型构建,处理复杂金融公式、多维度数据对比、市场趋势分析。
- 法律合规:法律条文解读、合同审查、案例分析、法律逻辑推演、合规性校验,精准识别合同风险点、对比法律条款差异、生成法律意见。
- 医疗辅助:医学文献解读、病例分析、诊断辅助、治疗方案建议,处理专业医学术语、复杂病例逻辑、多维度医疗数据。
四、接入配置与实战代码:快速上手使用
4.1 接入渠道与订阅方案
Qwen3.7-Max主要通过阿里云百炼平台接入,支持Token Plan、Coding Plan、按量付费等多种订阅方案,适配个人与企业不同需求:
- Token Plan:个人版与团队版,以Credits为计量单位,按Token消耗计费,支持多模型调用,团队版支持多成员共享,适合多场景混合使用。
- Coding Plan:面向开发者的固定月费订阅方案,按调用次数计费,支持Qwen系列编程专用模型,适合高频代码开发场景。
- 按量付费:按实际Token消耗计费,无固定费用,适合低频使用场景。
4.2 API接入实战代码(Python)
以下为通过阿里云百炼API接入Qwen3.7-Max的实战代码,支持基础调用、思考模式切换、工具调用、长上下文处理等核心功能。
4.2.1 基础文本生成(非思考模式)
from openai import OpenAI
import os

# 配置百炼API信息(华北2地域)
client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),  # 替换为你的百炼API Key
    base_url="https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
)

# 调用Qwen3.7-Max生成文本(非思考模式)
response = client.chat.completions.create(
    model="qwen3.7-max",
    messages=[
        {
   "role": "system", "content": "你是专业的软件开发工程师,擅长全栈代码开发与技术方案设计"},
        {
   "role": "user", "content": "请生成一个Python Flask用户管理系统的基础框架代码"}
    ],
    max_tokens=8192,
    temperature=0.7,
    # 关闭思考模式,启用高效输出
    extra_body={
   "enable_thinking": False}
)

# 输出结果
print("Qwen3.7-Max生成结果:")
print(response.choices[0].message.content)
4.2.2 深度思考模式(复杂推理)
from openai import OpenAI
import os

# 配置百炼API信息
client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
)

# 调用Qwen3.7-Max深度思考模式(复杂数学推理)
response = client.chat.completions.create(
    model="qwen3.7-max",
    messages=[
        {
   "role": "user", "content": "请证明费马小定理,并给出详细的推导过程与应用案例"}
    ],
    max_tokens=16384,
    temperature=0.3,
    # 开启思考模式,启用深度推理
    extra_body={

        "enable_thinking": True,
        "thinking_level": "high"  # 推理强度:low/medium/high
    }
)

# 输出思考过程与结果
print("思考过程:")
print(response.choices[0].delta.reasoning_content)
print("\n最终结果:")
print(response.choices[0].message.content)
4.2.3 工具调用(代码解释器)
from openai import OpenAI
import os

# 配置百炼API信息
client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
)

# 调用Qwen3.7-Max工具调用功能(代码解释器)
response = client.chat.completions.create(
    model="qwen3.7-max",
    messages=[
        {
   "role": "user", "content": "请计算123的21次方,并给出计算过程"}
    ],
    max_tokens=4096,
    temperature=0.5,
    # 开启思考模式与代码解释器
    extra_body={

        "enable_thinking": True,
        "enable_code_interpreter": True
    }
)

# 输出结果
print("计算结果:")
print(response.choices[0].message.content)
4.2.4 长上下文处理(百万Token)
from openai import OpenAI
import os

# 配置百炼API信息
client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
)

# 读取长文本内容(示例:10万字文档)
with open("long_document.txt", "r", encoding="utf-8") as f:
    long_content = f.read()

# 调用Qwen3.7-Max处理长上下文
response = client.chat.completions.create(
    model="qwen3.7-max",
    messages=[
        {
   "role": "user", "content": f"请分析以下长文档,提取核心观点与关键数据,并生成摘要:{long_content}"}
    ],
    max_tokens=8192,
    temperature=0.6,
    # 开启思考模式,确保长文本理解准确性
    extra_body={
   "enable_thinking": True}
)

# 输出长文本分析结果
print("长文档分析结果:")
print(response.choices[0].message.content)
4.3 接入配置要点
- API Key获取:登录阿里云百炼控制台,进入API Key管理页面创建,华北2地域API Key以
sk-开头。 - Base URL配置:华北2地域Base URL为
https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/compatible-mode/v1,需替换{WorkspaceId}为你的百炼业务空间ID。 - 思考模式切换:通过
extra_body参数配置enable_thinking(True/False)与thinking_level(low/medium/high),实现深度思考与高效输出模式切换。 - 上下文长度:生成时
max_tokens可设置最高65536,上下文输入可支持100万Token,需根据任务需求合理配置。 - 模型名称:统一使用
qwen3.7-max,确保调用最新旗舰模型。
五、常见问题与避坑指南
5.1 接入阶段常见问题
- API Key无效:原因是API Key地域不匹配、已过期或被删除。解决方法:核对API Key地域,重新创建并配置;检查API Key有效期,及时更新。
- Base URL错误:原因是未替换
{WorkspaceId}或地域URL错误。解决方法:替换{WorkspaceId}为你的业务空间ID,使用对应地域的Base URL。 - 权限不足:原因是子账号未获得百炼API调用权限。解决方法:由主账号为子账号授予
AliyunBailianFullAccess系统策略。
5.2 推理阶段常见问题
- 思考模式响应慢:原因是思考模式需要更多计算资源。解决方法:简单任务使用非思考模式;复杂任务可降低
thinking_level至low或medium。 - 长上下文处理失败:原因是输入内容超过100万Token限制。解决方法:拆分超长内容,控制输入长度在991808 Token以内。
- 幻觉问题:原因是未开启思考模式或上下文不足。解决方法:复杂任务开启思考模式;提供足够的上下文信息,提升结果准确性。
5.3 工具调用常见问题
- 代码解释器调用失败:原因是未开启
enable_code_interpreter参数。解决方法:在extra_body中添加"enable_code_interpreter": True。 - 外部工具调用失败:原因是工具接口配置错误或权限不足。解决方法:核对工具接口地址与参数;授予模型工具调用权限。
六、订阅方案选型与优化技巧
6.1 订阅方案选型建议
- Token Plan:适合团队协作、多场景混合使用、企业级用户,支持多成员共享,按Credits计费,灵活可控。
- Coding Plan:适合个人开发者、高频代码开发场景,固定月费,无Token消耗焦虑,支持专用编程模型。
- 按量付费:适合低频使用、测试场景,无固定费用,按实际消耗计费。
6.2 成本优化技巧
- 模式合理切换:简单任务使用非思考模式,降低Token消耗;复杂任务仅在必要时开启思考模式。
- 上下文精简:长文本处理时,精简冗余内容,控制输入长度,减少Token消耗。
- 缓存复用:利用显式/隐式缓存机制,复用重复上下文内容,降低重复输入成本。
- 模型选择:简单任务使用Qwen3.7-Plus等高性价比模型;复杂任务再使用Qwen3.7-Max。
七、总结
Qwen3.7-Max作为通义千问最新全能旗舰模型,以万亿级MoE架构、百万Token超长上下文、双模式推理引擎、长程自主执行与全栈编程能力为核心,在复杂推理、智能体协作、软件开发、企业办公等领域实现全面突破,综合性能跻身全球第一梯队。
该模型彻底解决了传统大模型在长文本处理、复杂推理、多工具协同、专业场景精度等方面的痛点,既适合个人开发者进行高效代码开发,也满足企业级用户在办公、研究、智能体开发等场景的深度需求,同时通过灵活的订阅方案与低算力消耗,实现了高性能与高性价比的统一。
用户可通过阿里云百炼平台快速接入,利用思考模式与非思考模式的灵活切换,适配不同场景需求,结合工具调用与长上下文处理能力,解锁AI技术在各场景的深度应用价值,大幅提升工作效率与任务质量。
