重磅!阿里云真武 M890 超节点 Day0 适配 Kimi K3,国产算力支撑近 3 万亿参数大模型

简介: 阿里云真武M890超节点实例Day0适配Kimi K3(近3万亿参数),国内首个跑通该规模模型的超节点。依托64卡全互联、9TB显存与ICN Switch高速网络,突破算力瓶颈;软硬协同优化后,首Token时延降35%,单卡吞吐提升1.8倍。在阿里云百炼官网:https://t.aliyun.com/U/fPVHqY 免费领取千万Tokens

最新!阿里云真武M890超节点实例已Day0适配Kimi K3,这是国内首个跑通近3万亿参数模型的超节点。双方将进一步展开国产算力合作,千问AI平台和阿里云百炼也将提供Kimi K3的模型API。本文转自阿里云公众号:
阿里云真武M890AI芯片.png


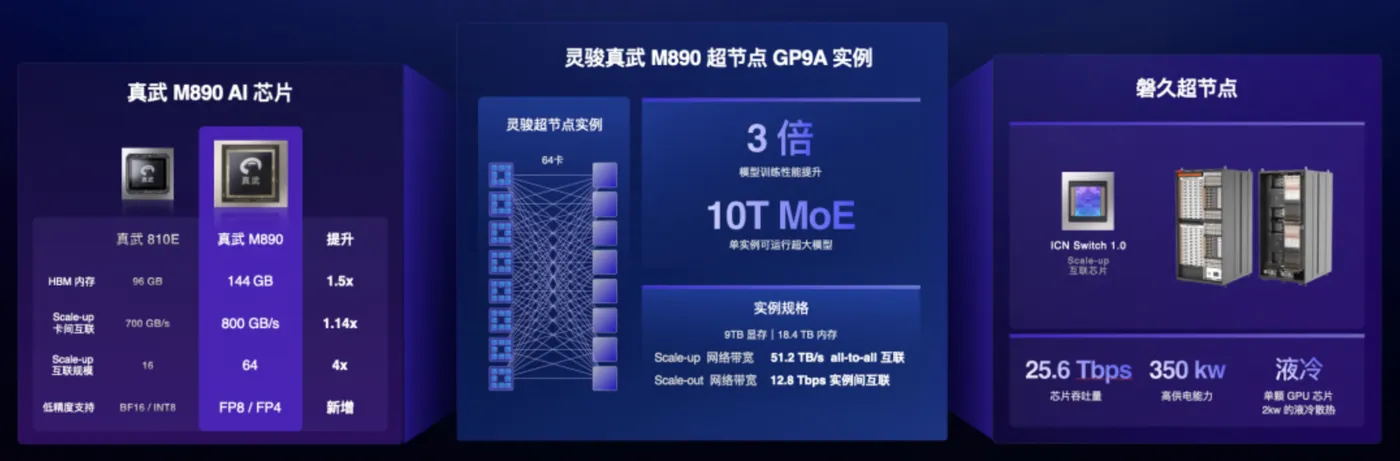
Kimi K3是目前业界参数规模最大的模型之一,跑通这一规模的模型需要将参数分散到几十张甚至上百张高速互联的GPU卡,让万亿参数“跑得又稳又快”。然而,普通AI集群因通信带宽的局限,无法满足高吞吐、低延迟、高并发的需求。


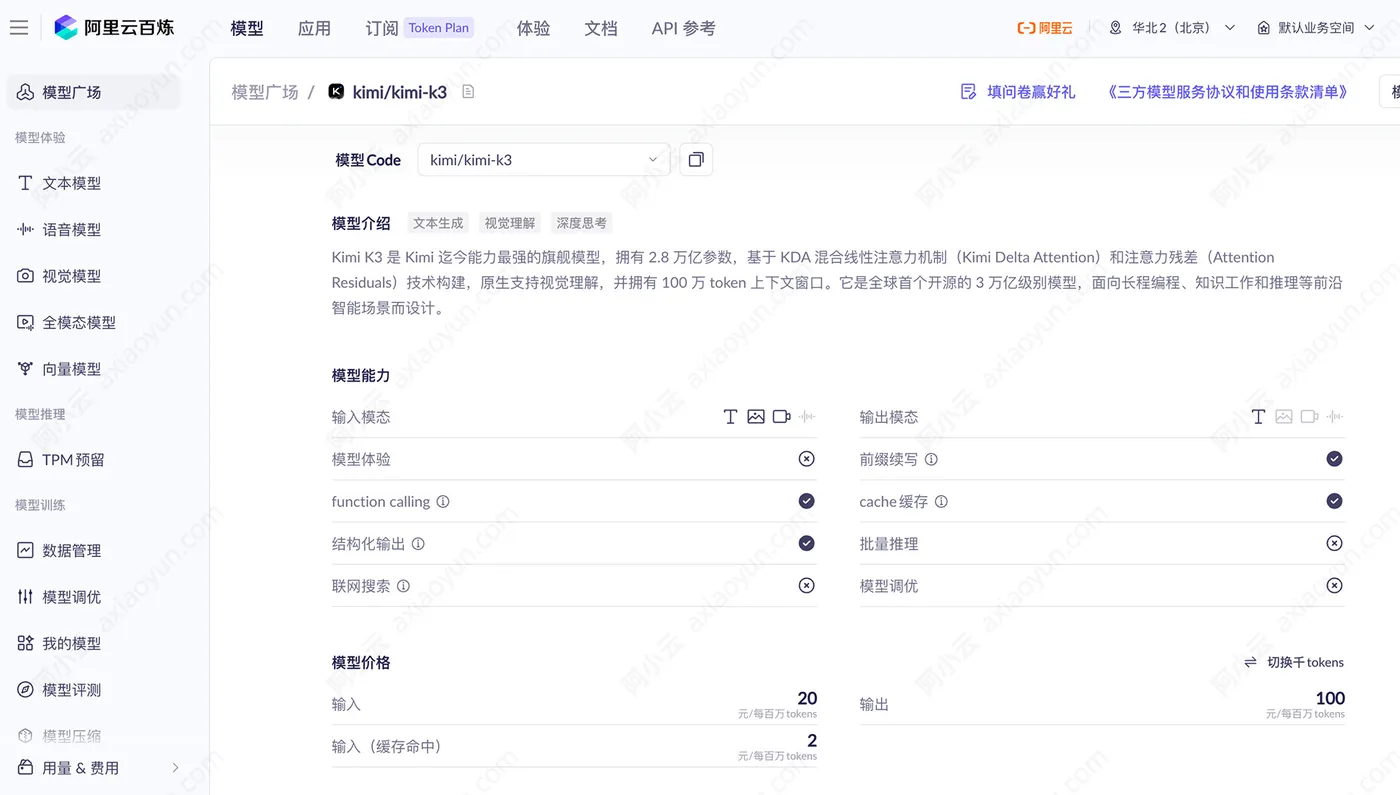
阿里云百炼AI模型平台:https://www.aliyun.com/product/bailian  体验Kimi K3的模型API,如下图:

阿里云百炼kimi_kimi-k3.jpg


阿里云真武超节点实例通过ICN Switch高速互联芯片,让64张平头哥真武M890实现800GB/s的全互联,其显存规模达到 9TB,可突破万亿参数模型运行的算力、显存和网络带宽的瓶颈,单实例即可支撑大规模万亿级参数MoE模型的专家并行需求。


为提升Kimi K3的运行效率,阿里云、平头哥与Kimi团队从软件栈、算子等层面进行了深度联合适配。例如,真武M890对Kimi K3模型架构的核心算子进行优化,显著提升推理的算力和带宽利用率,可稳定支持最1M长上下文,从容应对长文档理解、复杂推理等场景。测试显示,适配后模型的首Token时延降低约35%,单卡解码吞吐提升1.8倍。


目前,国内外主流模型已进入超2万亿参数规模的时代,阿里云真武超节点不仅跑通Kimi K3,还实现了模型的高效运行,意味着国产算力已具备支撑超大参数模型大规模应用的能力。

目录
相关文章
|
2月前
|
人工智能 缓存 网络协议
阿里云国际代理商:Kimi K3 部署实录
2026年7月,月之暗面Kimi K3(2.8万亿参数、896专家MoE)开源引发企业私有化部署热潮。本文详解GPU选型避坑指南:MoE不省显存,需全专家权重常驻;40G A100无法承载原生模型;H100/H200集群+RDMA网络为刚需,并提供Q4量化与FP16部署的实测配置建议。(239字)
|
缓存 Ubuntu Java
Tool之Bazel:Bazel的简介、安装、使用方法之详细攻略
|
1月前
|
存储 人工智能 安全
阿里云国际代理商:2026 年云栖大会 “无法计算的价值主论坛” 讲了什么?AI 共生共治共善解读
2026云栖大会以“智以致用”为主题,聚焦“为了无法计算的价值”,提出AI应超越算力堆叠,迈向产业赋能与人文共融。大会发布真武V900芯片、CPFS存储、AgentCore平台等全栈技术,并倡导“共生、共治、共善”三维范式,推动AI向绿色、安全、普惠演进。(239字)
|
2月前
|
人工智能 自动驾驶 搜索推荐
阿里云灵骏 GP9A 超节点详解:自研真武 M890 芯片、万亿参数 MoE 推理规格对比
阿里云灵骏GP9A超节点实例,基于自研真武M890P芯片,64卡全互联架构,提供9216GB显存、1024核CPU与18.4TB内存,支持MXFP4/FP8/BF16等多精度,原生兼容主流AI框架,专为万亿参数MoE模型训推、自动驾驶、搜推广及多模态场景优化。阿里云智能计算灵骏官网:https://t.aliyun.com/U/WjA3cK
671 0
|
3月前
|
机器学习/深度学习 缓存 人工智能
Kimi K3 登陆阿里云百炼:2.8万亿参数旗舰模型,输入仅20元/百万Token
全球首个开源3万亿级大模型Kimi K3(2.8万亿参数)正式上线阿里云百炼平台,支持100万Token超长上下文、原生视觉理解与深度推理。具备文本生成、多模态分析及复杂逻辑能力,输入20元/百万Token(缓存命中仅2元),定位高端AI开发场景。在阿里云百炼官网:https://t.aliyun.com/U/fPVHqY 免费领取千万Tokens
|
1月前
|
存储 人工智能 供应链
阿里云国际代理商:2026 AI 大模型出海 解析灵骏真武 M890
2026年,AI竞争转向底座能力。阿里云推出灵骏真武M890超节点——全球首款分钟级交付的64卡一体化PPU算力单元,搭载144GB HBM3显存、800GB/s卡间带宽,单机9TB显存池,可原生承载2.4万亿参数MoE模型训推一体,破解跨境算力供应与合规部署难题。(239字)
|
3月前
|
机器学习/深度学习 缓存 人工智能
一文读懂百炼 Kimi K3:2.8 万亿 MoE 模型、百万上下文、分层计费方案
全球首个开源3万亿级大模型Kimi K3正式上线阿里云百炼平台。该模型由月之暗面研发,参数达2.8万亿,支持100万Token超长上下文与原生视觉理解,具备文本生成、多模态推理及复杂逻辑深度思考能力,输入定价20元/百万Token(缓存命中仅2元)。在阿里云百炼官网:https://t.aliyun.com/U/fPVHqY 免费领取千万Tokens
|
3月前
|
分布式计算 运维 自然语言处理
EMR Serverless Spark PB级文本语义去重4倍加速的技术方案解读
针对大模型语料清洗中文本去重面临的性能瓶颈,某企业迁移至阿里云emr serverless spark后实现突破。新方案通过minhash-lsh内置函数将算法下沉引擎层,减少40%代码量;结合fusion engine向量化加速与shuffle优化,消除python udf跨进程开销并解决数据倾斜问题。实测去重性能提升4倍,任务耗时从天级降至小时级,且实现零shuffle失败与免运维。该实践验证了serverless架构在pb级数据预处理中的高效性与稳定性,显著加速模型迭代并降低计算成本。
397 0

热门文章

最新文章