去年双十一大促封网前夜,一位在拼多多做测试的朋友发了条朋友圈:“终于不用再通宵等回归结果了。”
底下炸出一堆同行。因为做过大促的人都知道,全量回归跑三天是常态。业务那边催命一样问“能不能上了”,你只能说“还在跑用例”。
后来我找他深聊了一次,信息量很大。他们一条核心业务线,从3万条回归用例压到几千条,再通过智能调度,把整个回归周期从3天压缩到了2小时以内。
不是靠堆机器,是靠换思路。
目录
大促前的回归噩梦,为什么突然消失了
回归的瓶颈不是执行速度,是决策速度
拆开这个AI大脑,里面就三件事
一个真实场景:订单状态机改动,AI怎么挑用例
想落地,先别急着上模型
测试工程师的新分工:写用例,还是写规则
大促前的回归噩梦,为什么突然消失了
过去拼多多的大促回归流程,和大多数厂一样:全量拉一遍自动化用例集,夜间跑,白天修脚本,晚上再跑。三万个用例,分布式执行最快也要几十个小时,中间还要处理环境抖动、数据冲突、脚本失效。
真正的痛苦不是时间长。是你跑完一轮,发现失败的用例里80%是环境问题,剩下20%才可能是真缺陷。排查又耗掉半天,大促窗口已经快关了。
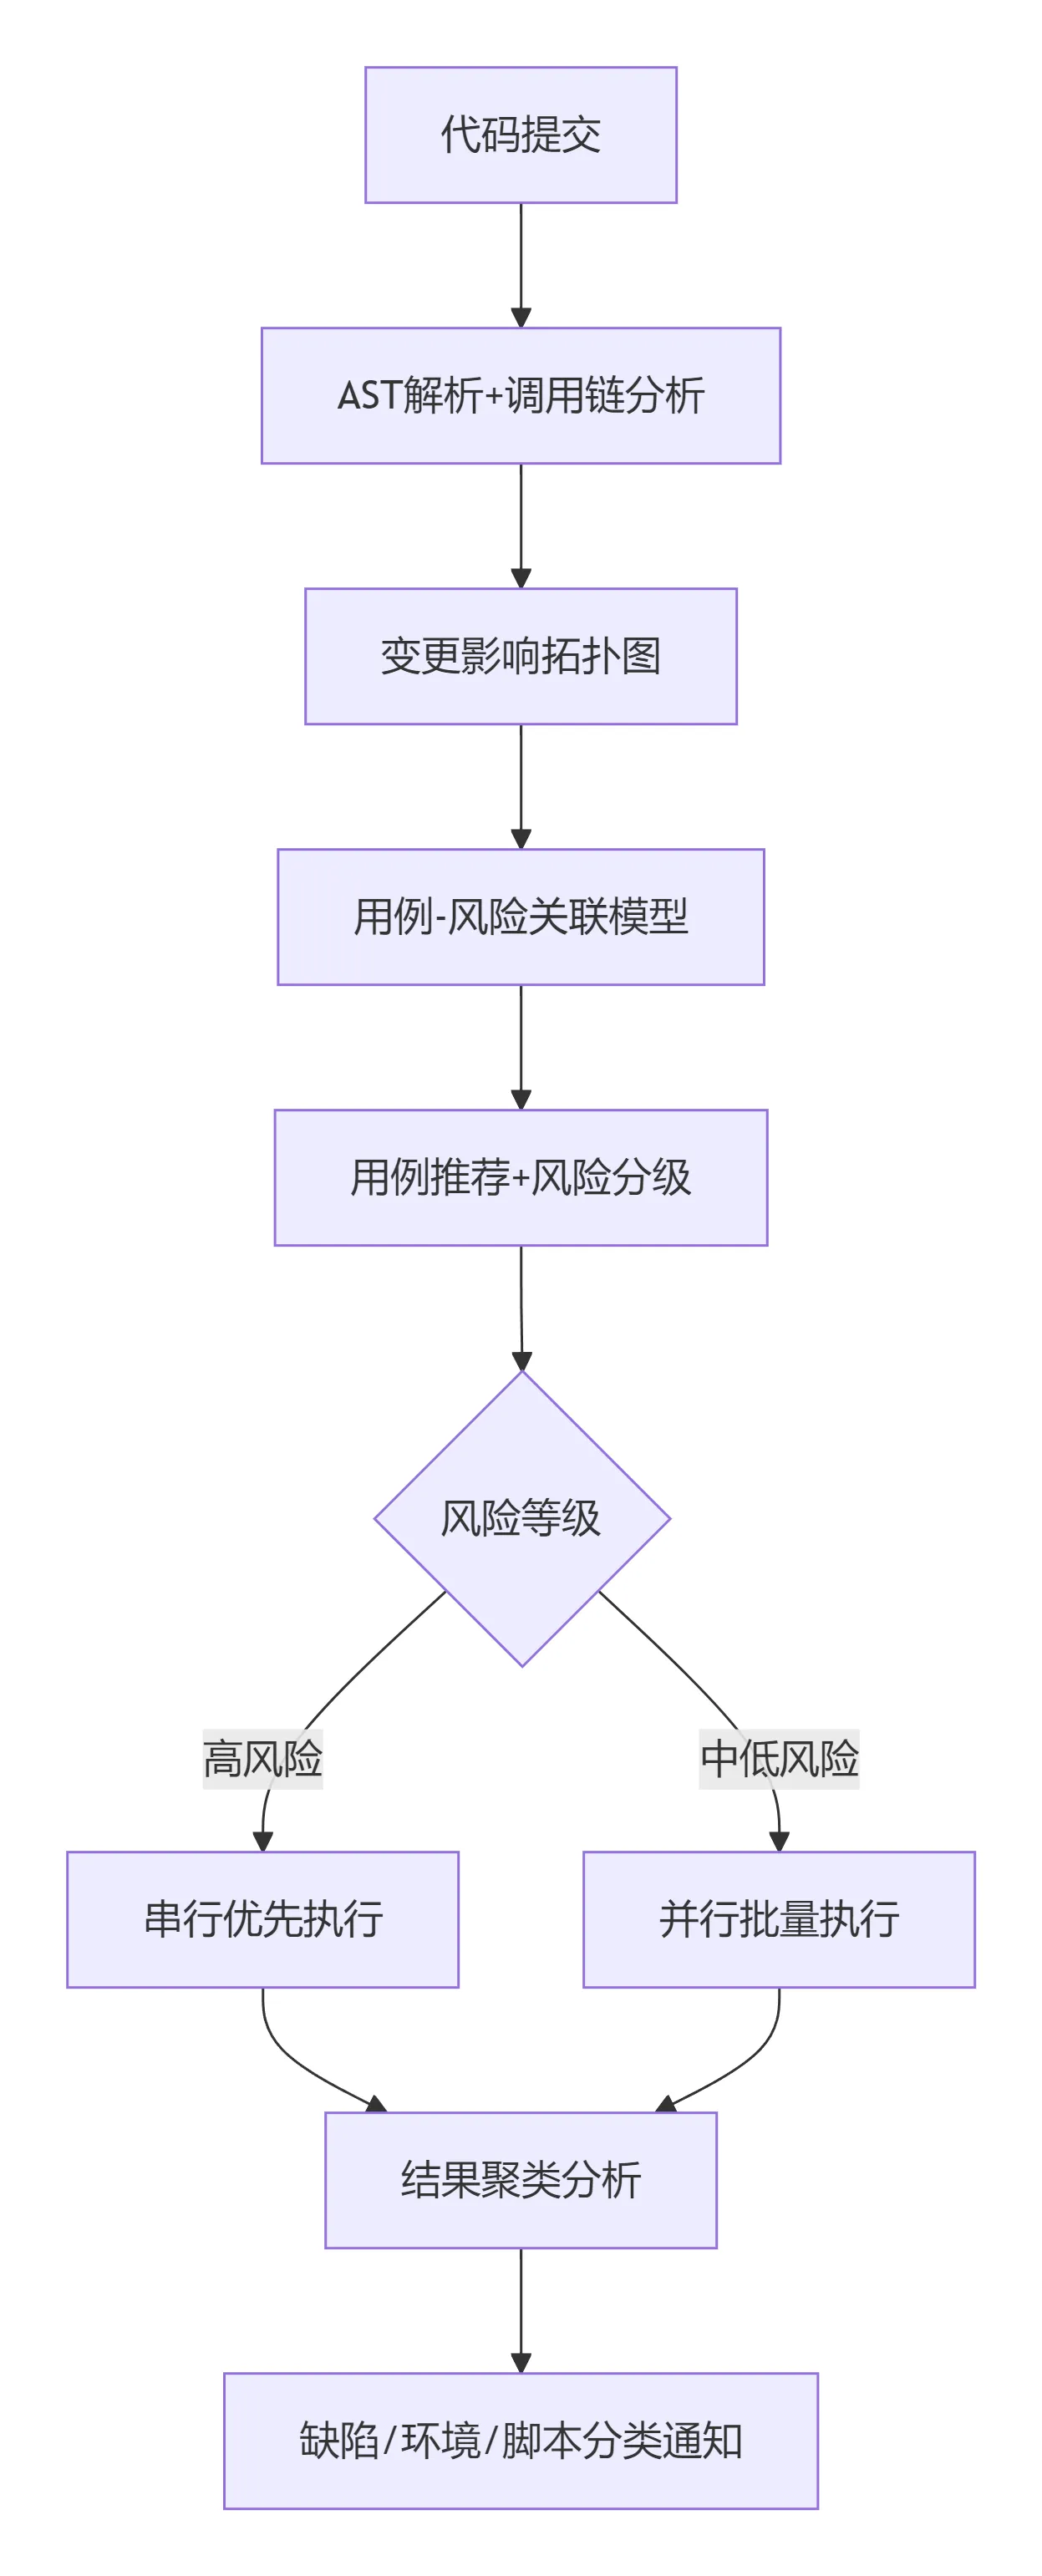
现在的做法是:代码一提交,AI自动分析变更影响面,从全量用例库里精准圈定一个最小必要集,按风险排序,然后在弹性容器集群里并发执行。高风险用例先跑,低风险的并行跑,结果实时推送。
全量回归是测试团队的体力遮羞布,AI把它扯下来了。
回归的瓶颈不是执行速度,是决策速度
以前大家总想着怎么把用例跑得更快。搞分布式、搞并发、搞执行机扩容。但很少有人问一个问题:这些用例,真的都需要跑吗?
拼多多那个团队做过统计,历次大促前回归发现的缺陷,91%集中在不到15%的用例覆盖范围内。剩下85%的用例,连续十几次回归零缺陷,纯属“陪跑”。
回归测试的核心瓶颈,从来不是执行速度,而是“该跑哪些”的决策速度。
人工决策的问题很明显:靠经验拍脑袋,要么怕漏测不敢减,要么减了不该减的。一个改动到底影响了哪些模块、哪些接口、哪些历史风险点,靠人脑已经算不过来了。
他们做的事,本质就是把“变更影响分析”这个决策过程,从人脑移交给了模型。
拆开这个AI大脑,里面就三件事
这个AI系统不神秘,拆开来看就三个核心引擎。
第一,变更影响分析引擎。
每次代码提交,系统通过AST解析和运行时调用链数据,自动生成一张“变更影响拓扑图”。改了一个下单接口的入参校验逻辑,拓扑图会告诉你:这个接口被哪些服务调用,这些服务又关联哪些前端页面和后台任务,最终波及哪些业务流程。
第二,用例-风险关联模型。
这一步是把历史数据变成知识。系统会把过去三年所有线上缺陷、回归发现的Bug,和当时的代码变更、用例执行结果做关联训练。学出来的模型能回答一个问题:上一次改这个函数的时候,哪些用例挂了?挂了的是什么类型的缺陷?这次类似的改动,同样类型的用例是不是应该优先跑?
第三,智能分群与调度。
圈定出来的用例集,不会无脑全跑。系统按风险等级分三群:高风险的串行先跑,确保核心链路优先验证;中低风险的并行跑,用弹性容器动态扩容。结果一出来,自动聚类失败原因,把环境问题、脚本问题和真实缺陷分开标记。
三个引擎串起来,是一条清晰的流水线:
挑不准用例,再快的执行都是浪费机器。
一个真实场景:订单状态机改动,AI怎么挑用例
说个具体的场景。有次他们改了订单状态机,新增了一个“部分发货”的中间状态。
人工评估影响面,通常会想到:正向的发货流程、确认收货流程、超时自动取消的定时任务。很容易漏掉的是退款逆向流程。部分发货状态下发起退款,金额怎么计算?已发货部分和未发货部分如何分摊?如果退款成功,状态机能不能正确扭转回“已取消”?
人工漏掉这个场景不奇怪,因为正向开发和测试的思维惯性就是盯着主流程。
但他们的AI模型在分析这次变更时,从历史缺陷库里匹配到一条记录:两年前一次状态机枚举值调整,曾导致退款金额计算异常,线上出了一次资损事故。模型自动把那次事故关联的用例簇标记为高风险,推荐优先执行。结果真的发现了一个类似问题——部分发货退款时,金额分摊的精度误差导致总退款多了1分钱。
这种事靠人很难想起来,但数据记得。
想落地,先别急着上模型
聊完我觉得这东西确实好,但中小团队怎么搞?朋友给的建议很实在,三步走。
第一步,先别想着搞AI。先把两件基础的事做了:代码提交和用例建立关联标签,每次提测时自动推荐一个用例集。这个推荐算法可以简单到“基于模块名映射+上一次回归结果”,花一两周就能跑通。
第二步,积累数据。每一次回归的结果、每一次线上缺陷,都结构化记录下来,尤其是“哪个变更导致了哪个用例失败”这个对应关系。这比什么模型都值钱。没有这个数据积累,上再好的AI也是空中楼阁。
第三步,等数据量够了,再引入轻量级模型做关联推荐。不需要自研,用开源方案结合embedding检索就能出效果。
他们也不是一开始就做这么重的。前两个版本就是靠规则+人工标签撑起来的,模型是后来喂了足够多的数据才真正起作用。
工程上的事,先解决有无,再解决好坏。
测试工程师的新分工:写用例,还是写规则
这套系统跑起来之后,他们团队里测试工程师的工作内容变了不少。
以前大量的时间花在“挑用例、排计划、盯执行、查脚本”上。现在这些事系统全干了。那测试工程师做什么?一部分人转去做测试策略设计——怎么给AI制定风险分级规则,怎么设计用例标签体系,怎么验证推荐模型的准确率。另一部分人把精力投到探索性测试和深度缺陷挖掘上,那些AI还没学会的事。
这件事最值得思考的地方是:AI没取代测试,但会写AI规则的测试工程师,正在把不会的那批甩开。
你是在每天被回归进度追着跑,还是在设计一套能让回归自动完成的规则体系?这是两条完全不同的职业路径。
你们团队现在一次全量回归跑多久?跑完的结果里,有多少用例已经连续十次没有发现过任何问题了?
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。