引言
在现代大型语言模型(LLM)部署架构中,缓存系统扮演着至关重要的角色。随着LLM应用规模的不断扩大和用户需求的持续增长,如何构建高效、可靠的缓存架构成为系统性能优化的核心挑战。Redis作为业界领先的内存数据库,因其高性能、丰富的数据结构和灵活的配置选项,已成为LLM部署中首选的缓存解决方案。
本教程将深入探讨如何利用Redis构建高命中率的缓存系统,以支持大规模LLM应用的负载均衡需求。我们将从缓存基础概念出发,逐步深入到高级优化技术,涵盖数据结构选择、缓存策略设计、内存管理、集群配置等关键方面,并提供丰富的代码示例和最佳实践指南。
1. 缓存的重要性与挑战
在LLM部署中,缓存系统面临着独特的挑战:
- 高并发读写:LLM服务通常需要处理每秒数千甚至数万次的请求
- 数据量大:模型参数、KV缓存、用户会话等数据规模庞大
- 低延迟要求:用户期望即时响应,缓存必须提供亚毫秒级的访问速度
- 内存资源限制:内存成本高昂,需要高效的内存管理策略
- 一致性维护:在分布式环境中保持缓存与后端数据的一致性
通过优化缓存命中率,我们可以显著提升系统性能,降低计算资源消耗,改善用户体验。本教程将详细介绍提高Redis缓存命中率的各种配置策略和最佳实践。
第一章 Redis缓存基础与性能原理
1.1 Redis缓存架构概述
Redis是一个开源的、内存中的数据结构存储系统,可用作数据库、缓存和消息中间件。在LLM部署架构中,Redis主要扮演以下角色:
- 请求结果缓存:存储LLM生成的文本、对话历史等
- KV缓存管理:优化Transformer模型的推理性能
- 会话管理:存储用户会话信息和上下文
- 速率限制:控制API访问频率
- 分布式锁:协调分布式环境中的资源访问
Redis缓存的典型架构包括:
客户端 → 负载均衡器 → Redis缓存集群 → LLM服务 → 后端数据库
在这个架构中,Redis作为系统的"前端大脑",决定请求的处理路径和资源分配,是实现高效负载均衡的关键环节。
1.2 Redis性能特性分析
Redis的高性能源自其独特的设计:
- 内存存储:数据存储在内存中,提供微秒级的访问速度
- 单线程模型:避免多线程上下文切换开销,简化并发控制
- 非阻塞I/O:使用epoll/kqueue等机制处理并发连接
- 高效数据结构:针对不同场景优化的数据结构实现
Redis性能指标(2025年最新硬件配置下):
| 操作类型 | 性能指标 | 影响因素 |
|---|---|---|
| 读操作(RGET) | 100,000+ QPS | 网络延迟、键设计、数据大小 |
| 写操作(RSET) | 80,000+ QPS | 内存策略、持久化配置、数据大小 |
| 复杂操作 | 50,000+ QPS | 操作复杂度、数据结构选择 |
1.3 缓存命中率的核心地位
缓存命中率是评估缓存系统效率的关键指标,定义为:
缓存命中率 = 缓存命中次数 / (缓存命中次数 + 缓存未命中次数) × 100%
在LLM部署中,高缓存命中率带来的好处包括:
- 降低计算成本:减少重复的模型推理计算
- 缩短响应时间:直接从缓存返回结果,避免模型计算延迟
- 提高系统吞吐量:减轻LLM服务的负担,处理更多并发请求
- 改善用户体验:更快的响应速度提升用户满意度
研究表明,在LLM应用中,缓存命中率每提高1%,可以节省约2-3%的计算资源消耗,同时将平均响应时间降低1-2%。因此,优化缓存命中率成为提升系统整体性能的关键策略。
1.4 Redis数据结构与缓存性能
Redis支持多种数据结构,不同数据结构的性能特性各不相同,正确选择数据结构对提高缓存命中率至关重要:
| 数据结构 | 适用场景 | 性能特性 | 内存效率 |
|---|---|---|---|
| String | 简单键值对、计数器 | 读写速度最快 | 中等 |
| Hash | 存储对象、会话数据 | 高效存储字段集合 | 高 |
| List | 队列、日志、时间线 | 支持顺序操作 | 中等 |
| Set | 唯一元素集合、去重 | 高效成员检查 | 中等 |
| Sorted Set | 排行榜、优先级队列 | 范围查询高效 | 中低 |
| HyperLogLog | 基数统计 | 内存效率极高 | 极高 |
| Geo | 地理位置查询 | 空间索引高效 | 中等 |
| Stream | 消息队列、事件流 | 高吞吐量 | 中等 |
在LLM缓存场景中,String和Hash通常是最常用的数据结构:
- String:用于缓存简单的键值对,如提示词-生成文本映射
- Hash:用于存储复杂对象,如会话信息、用户上下文等
# String示例:缓存LLM生成结果
import redis
import hashlib

redis_client = redis.Redis(host='localhost', port=6379, db=0)

def generate_with_cache(prompt, model_name):
    # 生成缓存键
    cache_key = f"llm:{model_name}:{hashlib.md5(prompt.encode()).hexdigest()}"

    # 尝试从缓存获取结果
    cached_result = redis_client.get(cache_key)
    if cached_result:
        print("Cache hit!")
        return cached_result.decode('utf-8')

    print("Cache miss, generating response...")
    # 调用LLM生成结果(模拟)
    result = f"Generated response for: {prompt}"

    # 存入缓存,设置过期时间
    redis_client.setex(cache_key, 3600, result)  # 1小时过期

    return result

# 使用示例
response = generate_with_cache("Hello, who are you?", "gpt-4")
print(response)
# Hash示例:存储会话信息
import redis
import json

redis_client = redis.Redis(host='localhost', port=6379, db=0)

def store_session(user_id, session_data):
    session_key = f"session:{user_id}"
    redis_client.hset(session_key, mapping={

        'last_active': session_data['last_active'],
        'context': json.dumps(session_data['context']),
        'model': session_data['model'],
        'token_usage': session_data['token_usage']
    })
    redis_client.expire(session_key, 86400)  # 24小时过期

def get_session(user_id):
    session_key = f"session:{user_id}"
    session_data = redis_client.hgetall(session_key)
    if session_data:
        # 将bytes转换为字符串
        decoded_data = {
   k.decode('utf-8'): v.decode('utf-8') for k, v in session_data.items()}
        # 解析JSON字段
        decoded_data['context'] = json.loads(decoded_data['context'])
        return decoded_data
    return None
1.5 缓存失效策略与TTL配置
缓存失效策略是影响命中率的重要因素。Redis支持多种过期策略,最常用的是基于TTL(Time To Live)的过期机制:
- 固定过期时间:为每个缓存项设置固定的过期时间
- 相对过期时间:根据数据访问频率动态调整过期时间
- 滑动窗口:每次访问后延长过期时间
在LLM缓存场景中,不同类型数据的TTL设置建议:
| 数据类型 | TTL建议 | 影响因素 |
|---|---|---|
| 提示词-结果映射 | 1-24小时 | 查询频率、数据变化率 |
| KV缓存 | 会话期间 | 会话时长、内存压力 |
| 会话信息 | 24-72小时 | 用户活跃周期 |
| 模型参数 | 数天至数周 | 模型更新频率 |
| 统计数据 | 分钟至小时 | 统计精度要求 |
TTL设置需要平衡缓存新鲜度和命中率,通常可以通过监控系统动态调整:
# 动态调整TTL示例
def cache_with_dynamic_ttl(key, value, base_ttl=3600):
    # 检查键的访问频率
    freq_key = f"freq:{key}"
    access_count = redis_client.incr(freq_key)

    # 根据访问频率调整TTL
    if access_count > 100:
        # 高频访问,延长TTL
        ttl = base_ttl * 2
    elif access_count < 10:
        # 低频访问,缩短TTL
        ttl = base_ttl / 2
    else:
        ttl = base_ttl

    # 设置缓存
    redis_client.setex(key, int(ttl), value)

    # 每小时重置访问计数
    redis_client.expire(freq_key, 3600)
1.6 内存管理与淘汰策略
当Redis内存达到配置上限时,需要选择适当的淘汰策略来移除部分数据,以确保系统正常运行。Redis提供多种淘汰策略:
| 淘汰策略 | 描述 | 适用场景 |
|---|---|---|
| volatile-lru | 从设置了过期时间的键中,移除最近最少使用的键 | 混合数据类型,需要保留永久数据 |
| allkeys-lru | 从所有键中,移除最近最少使用的键 | 缓存系统,所有数据都是临时的 |
| volatile-lfu | 从设置了过期时间的键中,移除使用频率最低的键 | 访问模式不均匀的数据 |
| allkeys-lfu | 从所有键中,移除使用频率最低的键 | 缓存系统,需要基于频率淘汰 |
| volatile-random | 从设置了过期时间的键中,随机移除 | 数据访问模式均匀 |
| allkeys-random | 从所有键中,随机移除 | 数据访问模式均匀 |
| volatile-ttl | 从设置了过期时间的键中,移除TTL最小的键 | 关注数据新鲜度 |
| noeviction | 不淘汰任何键,内存不足时拒绝写操作 | 对数据丢失敏感的场景 |
在LLM缓存系统中,推荐的配置如下:
# redis.conf
maxmemory 8gb                  # 设置最大内存限制
maxmemory-policy volatile-lfu   # 使用LFU策略淘汰过期键
maxmemory-samples 10            # 采样数量,影响淘汰精度
LFU(Least Frequently Used)策略在LLM场景中通常表现更好,因为它能更好地识别和保留常用的提示词和生成结果。
1.7 缓存预热与预加载策略
缓存预热是指在系统启动或低峰期提前将常用数据加载到缓存中,以避免冷启动时缓存命中率低的问题。在LLM部署中,缓存预热尤为重要:
- 历史请求分析:基于历史访问日志,识别高频提示词和查询模式
- 热门内容预加载:预先缓存热门主题的生成结果
- 模型参数缓存:将常用模型的参数片段预加载到内存
- 定期预热调度:设置定时任务,在低峰期更新缓存内容
# 缓存预热示例
def cache_warmup():
    # 读取高频查询日志
    with open('top_queries.log', 'r') as f:
        top_queries = [line.strip() for line in f.readlines()[:1000]]  # 取前1000个高频查询

    # 预热缓存
    for query in top_queries:
        # 模拟生成结果(实际应用中可能从数据库或备份中获取)
        result = f"Warmed up response for: {query}"
        cache_key = f"llm:gpt-4:{hashlib.md5(query.encode()).hexdigest()}"
        redis_client.setex(cache_key, 86400, result)  # 缓存24小时

    print(f"Warmed up {len(top_queries)} cache entries")

# 设置定时任务
def schedule_warmup():
    import schedule
    import time

    # 每天凌晨2点执行预热
    schedule.every().day.at("02:00").do(cache_warmup)

    while True:
        schedule.run_pending()
        time.sleep(60)
第二章 缓存键设计策略与最佳实践
2.1 高效缓存键设计原则
缓存键的设计直接影响查找效率和命中率。在LLM缓存场景中,应遵循以下设计原则:
- 唯一性:确保每个缓存键对应唯一的业务实体或查询
- 可读性:便于调试和问题排查
- 一致性:在不同服务间保持统一的键命名规范
- 可扩展性:能够适应业务变化和数据增长
- 性能优化:尽量缩短键长度,减少内存占用
高效缓存键的结构建议:
{服务名}:{资源类型}:{标识符}:{版本}
在LLM应用中,键结构示例:
llm:prompt:gpt4:hash(prompt_text):v1
llm:session:user1234:context
llm:kv_cache:model7b:sequence123
2.2 键空间分区与命名规范
键空间分区是组织缓存数据的有效方法,可以提高管理效率和查询性能:
- 按服务分区:不同服务使用不同的键前缀
- 按功能分区:将数据按功能模块分类存储
- 按时间分区:为时序数据添加时间维度
- 按租户分区:在多租户系统中隔离不同租户的数据
键命名规范示例:
# 键命名规范函数
def generate_cache_key(service, resource_type, identifier, version="v1", **kwargs):
    """
    生成标准化的缓存键

    Args:
        service: 服务名称
        resource_type: 资源类型
        identifier: 唯一标识符
        version: 版本号
        **kwargs: 额外的键值对参数

    Returns:
        标准化的缓存键
    """
    key_parts = [service, resource_type]

    # 添加额外的标签参数
    if kwargs:
        tags = ":".join([f"{k}:{v}" for k, v in sorted(kwargs.items())])
        key_parts.append(tags)

    key_parts.append(identifier)
    key_parts.append(version)

    return ":".join(key_parts)

# 使用示例
prompt_key = generate_cache_key("llm", "prompt", hashlib.md5("Hello".encode()).hexdigest(),
                               model="gpt-4", temperature="0.7")
# 结果: "llm:prompt:model:gpt-4:temperature:0.7:0a4d55a8d778e5022fab701977c5d840:e1fd5e9f1de0c157:v1"
2.3 提示词标准化与相似性缓存
LLM应用中的提示词常常存在相似度高但不完全相同的情况,通过提示词标准化可以提高缓存命中率:
- 去除冗余空格和换行
- 统一大小写处理
- 同义词替换
- 语法标准化
- 语义哈希:计算提示词的语义哈希值,识别相似提示词
# 提示词标准化函数
def normalize_prompt(prompt):
    """标准化提示词以提高缓存命中率"""
    # 去除多余空格和换行
    normalized = ' '.join(prompt.split())
    # 统一小写
    normalized = normalized.lower()
    # 移除常见的标点符号和特殊字符
    import re
    normalized = re.sub(r'[.,;:!?\-]', '', normalized)
    return normalized

# 基于标准化的缓存键生成
def generate_prompt_cache_key(prompt, model, temperature=0.7):
    normalized_prompt = normalize_prompt(prompt)
    # 计算标准化提示词的哈希值
    prompt_hash = hashlib.md5(normalized_prompt.encode()).hexdigest()
    return f"llm:prompt:{model}:t{temperature}:{prompt_hash}"

# 示例:相似提示词将生成相同的缓存键
key1 = generate_prompt_cache_key("Hello, how are you?", "gpt-4")
key2 = generate_prompt_cache_key("hello how are you", "gpt-4")
print(key1 == key2)  # 输出: True
为了更进一步提高相似提示词的缓存命中率,可以实现基于语义相似度的缓存查找:
# 简化的语义相似度缓存查找(实际应用中可能需要更复杂的向量相似度搜索)
def find_similar_prompts(prompt, model, threshold=0.8):
    """查找与给定提示词语义相似的缓存项"""
    import numpy as np
    from sentence_transformers import SentenceTransformer

    # 加载句子嵌入模型(需要预先安装sentence-transformers)
    embedder = SentenceTransformer('paraphrase-MiniLM-L6-v2')

    # 计算当前提示词的嵌入
    current_embedding = embedder.encode([prompt])[0]

    # 获取所有相关缓存键(实际应用中可能需要索引或更高效的查询方式)
    pattern = f"llm:prompt:{model}:*"
    candidate_keys = redis_client.keys(pattern)

    similar_keys = []
    for key in candidate_keys:
        # 从缓存中获取提示词和嵌入(实际应用中应单独存储嵌入)
        stored_prompt = redis_client.get(f"{key}:prompt")
        if stored_prompt:
            stored_embedding = redis_client.get(f"{key}:embedding")
            if stored_embedding:
                # 计算余弦相似度
                stored_embedding = np.frombuffer(stored_embedding)
                similarity = np.dot(current_embedding, stored_embedding) / (
                    np.linalg.norm(current_embedding) * np.linalg.norm(stored_embedding))

                if similarity > threshold:
                    similar_keys.append((key, similarity))

    # 按相似度排序
    similar_keys.sort(key=lambda x: x[1], reverse=True)
    return similar_keys
2.4 多租户环境下的键隔离
在多租户LLM服务中,正确隔离不同租户的缓存数据至关重要:
- 租户ID前缀:在所有键中包含租户ID
- 命名空间隔离:为不同租户使用不同的Redis数据库
- 访问控制:实现基于租户的访问控制机制
- 资源限制:为每个租户设置内存使用上限
# 多租户缓存键生成函数
def generate_tenant_cache_key(tenant_id, service, resource_type, identifier, **kwargs):
    """生成多租户环境下的缓存键"""
    # 租户ID作为前缀
    key_parts = [f"tenant:{tenant_id}", service, resource_type]

    # 添加额外参数
    if kwargs:
        tags = ":".join([f"{k}:{v}" for k, v in sorted(kwargs.items())])
        key_parts.append(tags)

    key_parts.append(identifier)
    return ":".join(key_parts)

# 多租户资源限制实现(简化版)
def enforce_tenant_quota(tenant_id, key_size):
    """检查并强制执行租户的内存使用配额"""
    quota_key = f"tenant:{tenant_id}:memory_quota"
    current_usage = redis_client.get(quota_key) or 0

    # 预设的内存配额(字节)
    tenant_quotas = {

        "premium-1": 512 * 1024 * 1024,  # 512MB
        "standard-1": 128 * 1024 * 1024, # 128MB
        "basic-1": 32 * 1024 * 1024      # 32MB
    }

    # 获取租户类型(实际应用中应从配置或数据库获取)
    tenant_type = "standard-1"
    quota = tenant_quotas.get(tenant_type, 32 * 1024 * 1024)

    # 检查是否超过配额
    if int(current_usage) + key_size > quota:
        # 可以选择拒绝请求或执行清理策略
        # 这里简单返回False表示超过配额
        return False

    # 更新使用量
    redis_client.incrby(quota_key, key_size)
    return True
2.5 批量操作与管道优化
Redis支持批量操作和管道(Pipeline)机制,可以显著提高缓存操作的吞吐量:
- MSET/MGET:批量设置/获取多个键值对
- Pipeline:将多个命令打包发送,减少网络往返
- 事务:确保多个命令的原子性执行
- Lua脚本:在服务器端执行复杂的逻辑操作
在LLM缓存场景中,批量操作特别适用于:
- 同时缓存多个相关的生成结果
- 一次查询多个相关的提示词结果
- 批量更新会话状态
- 批量清理过期缓存
# 使用Pipeline优化批量缓存操作
def batch_cache_responses(prompt_response_pairs, model, ttl=3600):
    """批量缓存多个提示词-响应对"""
    pipeline = redis_client.pipeline()

    for prompt, response in prompt_response_pairs.items():
        # 生成缓存键
        cache_key = f"llm:{model}:{hashlib.md5(prompt.encode()).hexdigest()}"
        # 添加到管道
        pipeline.setex(cache_key, ttl, response)

    # 执行管道中的所有命令
    results = pipeline.execute()
    return results

# 使用Lua脚本实现复杂逻辑
def cache_with_fallback(prompt, primary_model, fallback_model, ttl=3600):
    """
    尝试从主模型缓存获取,失败则从备用模型缓存获取
    如果两者都失败,则标记需要生成新结果
    """
    # 生成缓存键
    primary_key = f"llm:{primary_model}:{hashlib.md5(prompt.encode()).hexdigest()}"
    fallback_key = f"llm:{fallback_model}:{hashlib.md5(prompt.encode()).hexdigest()}"

    # 定义Lua脚本
    lua_script = """
    local primary_key = KEYS[1]
    local fallback_key = KEYS[2]
    local ttl = tonumber(ARGV[1])

    -- 尝试从主缓存获取
    local primary_value = redis.call('GET', primary_key)
    if primary_value then
        return {1, primary_value}  -- 1表示主缓存命中
    end

    -- 尝试从备用缓存获取
    local fallback_value = redis.call('GET', fallback_key)
    if fallback_value then
        -- 将备用缓存的值复制到主缓存
        redis.call('SETEX', primary_key, ttl, fallback_value)
        return {2, fallback_value}  -- 2表示备用缓存命中
    end

    -- 都未命中
    return {0, nil}  -- 0表示未命中
    """

    # 执行Lua脚本
    script = redis_client.register_script(lua_script)
    result = script(keys=[primary_key, fallback_key], args=[ttl])

    return result

# 使用示例
result = cache_with_fallback("Hello world", "gpt-4", "gpt-3.5-turbo")
if result[0] == 1:
    print(f"Primary cache hit: {result[1]}")
elif result[0] == 2:
    print(f"Fallback cache hit and promoted: {result[1]}")
else:
    print("Cache miss, need to generate new response")
第三章 Redis集群配置与负载均衡策略
3.1 Redis集群架构概述
在LLM部署中,随着请求量的增加,单节点Redis很快会成为性能瓶颈。Redis集群通过水平扩展提供了高可用性和更好的负载分布能力:
- 主从复制架构:通过主节点负责写操作,从节点负责读操作,提高读取性能
- 哨兵机制:实现自动故障检测和故障转移,保证系统可用性
- Redis Cluster:官方推荐的集群解决方案,支持数据分片和自动重平衡
Redis Cluster的核心特点:
- 数据分片:使用哈希槽(Hash Slots)将数据分散到多个节点
- 自动分区:支持动态添加和删除节点,自动重新分配数据
- 高可用性:每个主节点有多个从节点,提供故障转移能力
- 客户端分片:客户端需要支持集群协议,直接与相应的节点通信
3.2 哈希槽与数据分片策略
Redis Cluster使用16384个哈希槽来分配数据,每个键通过哈希函数映射到特定的槽位:
槽位 = CRC16(key) % 16384
在LLM缓存场景中,合理的数据分片策略尤为重要:
- 提示词分片:确保相似提示词可能被分散到不同节点,避免热点问题
- 会话一致性:同一会话的所有数据应映射到相同节点,保证操作原子性
- 租户隔离:不同租户的数据可以考虑使用不同的分片策略
- 冷热数据分离:将热点数据和冷数据分配到不同节点
# 自定义哈希槽计算(会话一致性示例)
def calculate_slot_with_session_consistency(prompt, session_id, model="gpt-4"):
    """
    计算哈希槽,确保同一会话的所有请求映射到相同槽位
    """
    # 将会话ID作为键的前缀,确保会话内一致性
    key = f"session:{session_id}:{model}:{hashlib.md5(prompt.encode()).hexdigest()}"

    # 简单的CRC16哈希实现(实际应用中应使用Redis客户端的哈希算法)
    def crc16(s):
        crc = 0xFFFF
        for c in s:
            crc ^= ord(c)
            for _ in range(8):
                if crc & 0x0001:
                    crc = (crc >> 1) ^ 0xA001
                else:
                    crc >>= 1
        return crc & 0xFFFF

    slot = crc16(key) % 16384
    return slot, key

# 使用示例
session_id = "user1234_session5678"
prompt1 = "Explain quantum computing"
prompt2 = "How does quantum computing work?"

slot1, key1 = calculate_slot_with_session_consistency(prompt1, session_id)
slot2, key2 = calculate_slot_with_session_consistency(prompt2, session_id)

print(f"Same session, same slot: {slot1 == slot2}")  # 输出: True
3.3 读写分离与主从复制配置
读写分离是提高Redis性能的有效策略,尤其适合LLM应用中读多写少的场景:
- 主节点:负责所有写操作和关键读操作
- 从节点:处理普通读请求,分担主节点负载
- 复制策略:可以配置异步复制或半同步复制
配置示例:
# Python客户端读写分离示例
from redis.sentinel import Sentinel

# 配置哨兵
SENTINEL_ADDRESSES = [
    ('sentinel1.example.com', 26379),
    ('sentinel2.example.com', 26379),
    ('sentinel3.example.com', 26379)
]
sentinel = Sentinel(SENTINEL_ADDRESSES, socket_timeout=0.1)

class ReadWriteRedisClient:
    """实现读写分离的Redis客户端"""

    def __init__(self, master_name, password=None):
        self.master_name = master_name
        self.password = password
        self._master = None
        self._slave = None

    @property
    def master(self):
        """获取主节点连接"""
        if not self._master:
            self._master = sentinel.master_for(self.master_name, password=self.password, decode_responses=True)
        return self._master

    @property
    def slave(self):
        """获取从节点连接(负载均衡)"""
        if not self._slave:
            self._slave = sentinel.slave_for(self.master_name, password=self.password, decode_responses=True)
        return self._slave

    def set(self, key, value, ex=None):
        """写操作使用主节点"""
        return self.master.setex(key, ex or 3600, value)

    def get(self, key):
        """读操作使用从节点"""
        return self.slave.get(key)

    def get_with_failover(self, key):
        """读操作带故障转移"""
        try:
            return self.slave.get(key)
        except Exception:
            # 从节点故障时,使用主节点
            return self.master.get(key)

# LLM缓存读写分离客户端使用示例
redis_client = ReadWriteRedisClient('llm_cache_master')

# 缓存生成结果(写操作 - 使用主节点)
def cache_llm_response(prompt, response, model="gpt-4", ttl=3600):
    cache_key = f"llm:{model}:{hashlib.md5(prompt.encode()).hexdigest()}"
    return redis_client.set(cache_key, response, ex=ttl)

# 获取缓存结果(读操作 - 使用从节点)
def get_cached_response(prompt, model="gpt-4"):
    cache_key = f"llm:{model}:{hashlib.md5(prompt.encode()).hexdigest()}"
    return redis_client.get_with_failover(cache_key)
3.4 客户端一致性哈希与智能路由
在Redis集群环境中,客户端一致性哈希可以提供更好的负载均衡和故障恢复能力:
- 一致性哈希原理:将节点映射到哈希环上,键通过哈希算法找到最近的节点
- 虚拟节点:为每个物理节点创建多个虚拟节点,提高负载均衡效果
- 动态扩缩容:节点变化时,只影响哈希环上相邻节点的数据
实现示例:
class ConsistentHash:
    """一致性哈希实现"""

    def __init__(self, replicas=100):
        """
        初始化一致性哈希环

        Args:
            replicas: 每个节点的虚拟节点数量
        """
        self.replicas = replicas
        self.ring = {
   }
        self.nodes = set()

    def add_node(self, node):
        """添加节点"""
        self.nodes.add(node)
        for i in range(self.replicas):
            virtual_node_key = f"{node}:{i}"
            # 使用MD5计算哈希值
            hash_val = int(hashlib.md5(virtual_node_key.encode()).hexdigest(), 16)
            self.ring[hash_val] = node

    def remove_node(self, node):
        """移除节点"""
        self.nodes.remove(node)
        for i in range(self.replicas):
            virtual_node_key = f"{node}:{i}"
            hash_val = int(hashlib.md5(virtual_node_key.encode()).hexdigest(), 16)
            if hash_val in self.ring:
                del self.ring[hash_val]

    def get_node(self, key):
        """获取负责处理指定键的节点"""
        if not self.ring:
            return None

        # 计算键的哈希值
        hash_val = int(hashlib.md5(key.encode()).hexdigest(), 16)

        # 找到哈希环上大于等于当前哈希值的第一个节点
        for node_hash in sorted(self.ring.keys()):
            if hash_val <= node_hash:
                return self.ring[node_hash]

        # 如果没找到,返回哈希环上的第一个节点
        return self.ring[sorted(self.ring.keys())[0]]

# LLM智能路由客户端示例
class SmartRedisRouter:
    """智能路由的Redis客户端"""

    def __init__(self):
        self.hash_ring = ConsistentHash()
        self.clients = {
   }

    def add_redis_node(self, name, host, port, password=None):
        """添加Redis节点"""
        import redis
        client = redis.Redis(host=host, port=port, password=password, decode_responses=True)
        self.clients[name] = client
        self.hash_ring.add_node(name)

    def get_client(self, key):
        """获取负责指定键的Redis客户端"""
        node_name = self.hash_ring.get_node(key)
        return self.clients.get(node_name)

    def get(self, key):
        """获取缓存值"""
        client = self.get_client(key)
        return client.get(key) if client else None

    def set(self, key, value, ex=None):
        """设置缓存值"""
        client = self.get_client(key)
        if client:
            return client.setex(key, ex or 3600, value)
        return False

# 使用示例
router = SmartRedisRouter()

# 添加Redis节点
router.add_redis_node("node1", "redis1.example.com", 6379)
router.add_redis_node("node2", "redis2.example.com", 6379)
router.add_redis_node("node3", "redis3.example.com", 6379)

# 缓存LLM响应
prompt = "Explain machine learning concepts"
response = "Machine learning is a subset of AI that..."
cache_key = f"llm:gpt-4:{hashlib.md5(prompt.encode()).hexdigest()}"
router.set(cache_key, response, ex=7200)

# 获取缓存响应
cached_response = router.get(cache_key)
3.5 热点数据处理与防雪崩策略
在LLM部署中,热点数据和缓存雪崩是常见的性能隐患:
- 热点数据问题:热门提示词可能导致单个Redis节点负载过高
- 缓存雪崩:大量缓存同时过期,导致请求直接打到后端服务
针对这些问题,可以采取以下策略:
热点数据处理:
- 数据预热:提前将热门提示词加载到缓存
- 分片优化:调整哈希算法,确保热点数据分布更均匀
- 本地缓存:在应用服务器端增加本地缓存,减轻Redis负担
- 读写分离:使用多个从节点分散读压力
防雪崩策略:
- 随机过期时间:为缓存项设置随机的过期时间,避免同时过期
- 分级缓存:实现多级缓存架构,当一级缓存失效时,有备用缓存
- 缓存监控:实时监控缓存命中率和延迟,及时发现问题
- 限流降级:在缓存失效时,对后端服务实施限流和降级保护
# 防雪崩策略实现
class AntiAvalancheCache:
    """防缓存雪崩的缓存实现"""

    def __init__(self, redis_client, base_ttl=3600, jitter_range=300):
        """
        初始化防雪崩缓存

        Args:
            redis_client: Redis客户端
            base_ttl: 基础过期时间(秒)
            jitter_range: 随机抖动范围(秒)
        """
        self.redis_client = redis_client
        self.base_ttl = base_ttl
        self.jitter_range = jitter_range

    def get_with_fallback(self, key, fallback_func, *args, **kwargs):
        """
        获取缓存,如果缓存不存在则调用回调函数获取数据

        Args:
            key: 缓存键
            fallback_func: 缓存不存在时的回调函数
            *args, **kwargs: 回调函数的参数
        """
        # 尝试从缓存获取
        cached_value = self.redis_client.get(key)
        if cached_value is not None:
            return cached_value

        # 缓存不存在,获取锁避免缓存击穿
        lock_key = f"lock:{key}"
        # 尝试获取锁,超时时间为2秒
        if self.redis_client.set(lock_key, "1", nx=True, ex=2):
            try:
                # 再次检查缓存,防止在获取锁期间其他线程已设置
                cached_value = self.redis_client.get(key)
                if cached_value is not None:
                    return cached_value

                # 调用回调函数获取数据
                value = fallback_func(*args, **kwargs)

                # 生成带随机抖动的过期时间
                import random
                jitter = random.randint(-self.jitter_range, self.jitter_range)
                ttl = max(60, self.base_ttl + jitter)  # 确保最小过期时间为60秒

                # 缓存数据
                self.redis_client.setex(key, ttl, value)
                return value
            finally:
                # 释放锁
                self.redis_client.delete(lock_key)
        else:
            # 无法获取锁,等待一小段时间后重试
            import time
            time.sleep(0.1)
            return self.get_with_fallback(key, fallback_func, *args, **kwargs)

# 使用示例
# 假设redis_client已经初始化
anti_avalanche = AntiAvalancheCache(redis_client)

# 模拟从LLM获取响应的函数
def get_llm_response(prompt, model="gpt-4"):
    print(f"Calling LLM for: {prompt}")
    # 实际应用中这里会调用LLM API
    return f"Response to: {prompt}"

# 获取响应,带缓存和防雪崩保护
def get_response_with_cache(prompt, model="gpt-4"):
    cache_key = f"llm:{model}:{hashlib.md5(prompt.encode()).hexdigest()}"
    return anti_avalanche.get_with_fallback(
        cache_key,
        get_llm_response,
        prompt,
        model=model
    )

# 测试并发请求
import threading

def test_concurrent_requests(prompt, count=10):
    threads = []
    results = []

    def worker():
        results.append(get_response_with_cache(prompt))

    for _ in range(count):
        t = threading.Thread(target=worker)
        threads.append(t)
        t.start()

    for t in threads:
        t.join()

    print(f"All {count} requests completed")
    print(f"All results are the same: {all(r == results[0] for r in results)}")

# 运行测试
test_concurrent_requests("What is AI?")
3.6 监控与自动伸缩策略
有效的监控和自动伸缩是维护Redis集群健康的关键:
关键监控指标:
- 缓存命中率
- 内存使用率
- 延迟
- 连接数
- 命令执行频率
自动伸缩策略:
- 基于内存使用率的节点扩容
- 基于延迟的节点扩容
- 基于连接数的负载均衡调整
常见监控工具:
- Redis Sentinel内置监控
- Redis Exporter + Prometheus + Grafana
- Redis Enterprise的监控功能
# 简易Redis监控实现
class RedisMonitor:
    """Redis监控器"""

    def __init__(self, redis_client):
        self.redis_client = redis_client
        self.last_stats = {
   }

    def collect_stats(self):
        """收集Redis统计信息"""
        info = self.redis_client.info()

        # 提取关键指标
        stats = {

            'memory_used': info.get('used_memory', 0),
            'memory_used_rss': info.get('used_memory_rss', 0),
            'memory_peak': info.get('used_memory_peak', 0),
            'memory_fragmentation_ratio': info.get('mem_fragmentation_ratio', 0),
            'keyspace_hits': info.get('keyspace_hits', 0),
            'keyspace_misses': info.get('keyspace_misses', 0),
            'total_connections_received': info.get('total_connections_received', 0),
            'rejected_connections': info.get('rejected_connections', 0),
            'instantaneous_ops_per_sec': info.get('instantaneous_ops_per_sec', 0),
            'uptime_in_seconds': info.get('uptime_in_seconds', 0),
            'connected_clients': info.get('connected_clients', 0),
            'blocked_clients': info.get('blocked_clients', 0),
        }

        # 计算命中率
        hits = stats['keyspace_hits']
        misses = stats['keyspace_misses']
        total = hits + misses
        stats['hit_rate'] = hits / total if total > 0 else 0

        # 计算速率变化
        if self.last_stats:
            time_diff = stats['uptime_in_seconds'] - self.last_stats['uptime_in_seconds']
            if time_diff > 0:
                stats['hit_rate_per_second'] = (stats['keyspace_hits'] - self.last_stats['keyspace_hits']) / time_diff
                stats['miss_rate_per_second'] = (stats['keyspace_misses'] - self.last_stats['keyspace_misses']) / time_diff

        self.last_stats = stats
        return stats

    def check_thresholds(self, stats, thresholds):
        """检查是否超过阈值"""
        alerts = []

        # 内存使用率检查
        if 'max_memory' in thresholds:
            memory_usage_percent = (stats['memory_used'] / thresholds['max_memory']) * 100
            if memory_usage_percent > thresholds.get('memory_threshold', 80):
                alerts.append({

                    'type': 'memory',
                    'message': f"Memory usage too high: {memory_usage_percent:.2f}%",
                    'severity': 'warning' if memory_usage_percent < 90 else 'critical'
                })

        # 命中率检查
        if stats['hit_rate'] < thresholds.get('hit_rate_threshold', 0.8):
            alerts.append({

                'type': 'hit_rate',
                'message': f"Cache hit rate too low: {stats['hit_rate']:.2%}",
                'severity': 'warning'
            })

        # 连接数检查
        if stats['connected_clients'] > thresholds.get('max_connections', 1000):
            alerts.append({

                'type': 'connections',
                'message': f"Too many connections: {stats['connected_clients']}",
                'severity': 'warning' if stats['connected_clients'] < thresholds.get('max_connections_critical', 1500) else 'critical'
            })

        # 拒绝连接检查
        if stats['rejected_connections'] > thresholds.get('rejected_connections_threshold', 0):
            alerts.append({

                'type': 'rejected_connections',
                'message': f"Connections being rejected: {stats['rejected_connections']}",
                'severity': 'critical'
            })

        return alerts


## 第四章 缓存命中率优化的高级策略

### 4.1 多级缓存架构设计

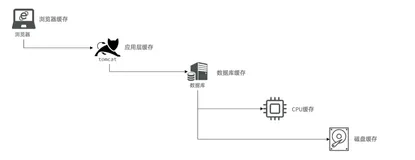
多级缓存架构是提高缓存命中率和系统性能的有效手段,特别适合LLM这类计算密集型应用:

1. **L1缓存**:本地内存缓存(如Caffeine、Guava Cache),响应时间<1ms
2. **L2缓存**:分布式缓存(如Redis集群),响应时间<10ms
3. **L3缓存**:数据库或文件系统,响应时间>100ms

在LLM部署中,多级缓存的具体应用:

- **L1缓存**:存储最近访问的高频提示词和简短响应
- **L2缓存**:存储完整的生成结果、会话上下文和KV缓存
- **L3存储**:存储历史记录、完整对话日志和模型参数

```python
# 多级缓存实现示例
class MultiLevelCache:
    """多级缓存实现"""

    def __init__(self, redis_client):
        """
        初始化多级缓存

        Args:
            redis_client: Redis客户端实例
        """
        import threading
        # L1缓存:使用字典实现简单的内存缓存
        self.l1_cache = {
   }
        self.l1_capacity = 1000
        self.l1_lock = threading.RLock()
        # L2缓存:Redis
        self.l2_cache = redis_client
        # 统计信息
        self.stats = {

            'l1_hits': 0,
            'l2_hits': 0,
            'misses': 0
        }

    def _l1_get(self, key):
        """从L1缓存获取"""
        with self.l1_lock:
            if key in self.l1_cache:
                return self.l1_cache[key]
            return None

    def _l1_set(self, key, value, ttl=None):
        """设置L1缓存"""
        with self.l1_lock:
            # 简单的LRU实现
            if len(self.l1_cache) >= self.l1_capacity:
                # 移除最早添加的项
                oldest_key = next(iter(self.l1_cache))
                del self.l1_cache[oldest_key]
            self.l1_cache[key] = value

    def get(self, key):
        """从多级缓存获取数据"""
        # 先查L1缓存
        value = self._l1_get(key)
        if value is not None:
            self.stats['l1_hits'] += 1
            return value

        # L1未命中,查L2缓存
        value = self.l2_cache.get(key)
        if value is not None:
            self.stats['l2_hits'] += 1
            # 回填到L1缓存
            self._l1_set(key, value)
            return value

        # 都未命中
        self.stats['misses'] += 1
        return None

    def set(self, key, value, ttl=3600):
        """设置多级缓存"""
        # 设置L1缓存
        self._l1_set(key, value)
        # 设置L2缓存
        self.l2_cache.setex(key, ttl, value)

    def get_hit_rates(self):
        """计算各级缓存的命中率"""
        total = self.stats['l1_hits'] + self.stats['l2_hits'] + self.stats['misses']
        if total == 0:
            return {
   }

        return {

            'l1_hit_rate': self.stats['l1_hits'] / total,
            'l2_hit_rate': self.stats['l2_hits'] / total,
            'overall_hit_rate': (self.stats['l1_hits'] + self.stats['l2_hits']) / total,
            'miss_rate': self.stats['misses'] / total
        }

# LLM应用中的多级缓存使用示例
# 假设redis_client已经初始化
multi_cache = MultiLevelCache(redis_client)

def get_llm_response_cached(prompt, model="gpt-4"):
    """从多级缓存获取LLM响应"""
    cache_key = f"llm:{model}:{hashlib.md5(prompt.encode()).hexdigest()}"

    # 尝试从多级缓存获取
    response = multi_cache.get(cache_key)
    if response:
        print(f"Cache hit for prompt: {prompt[:20]}...")
        return response

    # 缓存未命中,调用LLM API
    print(f"Cache miss, calling LLM for: {prompt[:20]}...")
    # 实际应用中这里会调用LLM API
    response = f"Response to: {prompt}"

    # 存入多级缓存
    multi_cache.set(cache_key, response, ttl=7200)  # 缓存2小时

    return response
4.2 缓存替换算法优化
Redis支持多种缓存替换策略,但在LLM场景下,我们可能需要更高级的自定义替换算法:
- 基于访问模式的智能替换:分析用户访问模式,优先保留可能再次访问的缓存项
- 基于内容重要性的替换:根据缓存内容的重要性和价值进行替换决策
- 基于TTL预测的替换:预测缓存项的剩余价值,优先替换即将过期的项
- 自适应替换策略:根据系统负载和命中率动态调整替换策略
# 基于访问模式的智能替换缓存
class SmartEvictionCache:
    """基于访问模式的智能替换缓存"""

    def __init__(self, redis_client, capacity=10000):
        """
        初始化智能替换缓存

        Args:
            redis_client: Redis客户端实例
            capacity: 预期的最大容量
        """
        self.redis_client = redis_client
        self.capacity = capacity
        # 访问模式跟踪
        self.access_pattern = {
   }

    def _update_access_pattern(self, key):
        """更新访问模式"""
        import time
        current_time = time.time()

        # 更新访问计数和最后访问时间
        if key not in self.access_pattern:
            self.access_pattern[key] = {

                'count': 1,
                'last_accessed': current_time,
                'first_accessed': current_time
            }
        else:
            self.access_pattern[key]['count'] += 1
            self.access_pattern[key]['last_accessed'] = current_time

    def get(self, key):
        """获取缓存值"""
        value = self.redis_client.get(key)
        if value is not None:
            # 更新访问模式
            self._update_access_pattern(key)
        return value

    def set(self, key, value, ttl=3600):
        """设置缓存值"""
        # 检查容量,如果接近上限,执行智能清理
        if len(self.access_pattern) > self.capacity * 0.9:
            self._smart_evict()

        # 设置缓存
        self.redis_client.setex(key, ttl, value)
        self._update_access_pattern(key)

    def _smart_evict(self):
        """智能驱逐策略"""
        import time
        current_time = time.time()

        # 计算每个键的驱逐分数
        eviction_scores = {
   }

        for key, pattern in self.access_pattern.items():
            # 计算访问频率
            age = current_time - pattern['first_accessed']
            if age > 0:
                freq = pattern['count'] / age
            else:
                freq = pattern['count']

            # 计算最后访问时间的衰减因子
            recency = current_time - pattern['last_accessed']
            # 使用指数衰减
            recency_factor = 1 / (1 + recency / 3600)  # 1小时半衰期

            # 计算驱逐分数(分数越低越容易被驱逐)
            eviction_score = freq * recency_factor
            eviction_scores[key] = eviction_score

        # 按驱逐分数排序,找出分数最低的N个键
        sorted_keys = sorted(eviction_scores.items(), key=lambda x: x[1])

        # 驱逐10%的键
        to_evict = sorted_keys[:int(len(sorted_keys) * 0.1)]

        for key, _ in to_evict:
            # 删除Redis中的键
            self.redis_client.delete(key)
            # 从访问模式中移除
            if key in self.access_pattern:
                del self.access_pattern[key]

    def optimize_for_llm_workload(self):
        """针对LLM工作负载进行特殊优化"""
        # 这里可以实现特定于LLM的优化策略
        # 例如:对长提示词和短提示词使用不同的缓存策略
        pass
4.3 内容寻址存储与相似度缓存
在LLM应用中,相似的提示词可能会产生相似的结果。通过内容寻址和相似度缓存,可以显著提高缓存命中率:
- 语义哈希:将提示词转换为语义向量,使用近似最近邻搜索
- 向量索引:使用Redis的向量数据类型存储和查询语义向量
- 相似性阈值:定义相似度阈值,决定是否复用缓存结果
- 结果调整:根据提示词的差异程度,对缓存结果进行微调
# 基于向量相似度的缓存实现
class VectorSimilarityCache:
    """基于向量相似度的缓存"""

    def __init__(self, redis_client, model_name='paraphrase-MiniLM-L6-v2'):
        """
        初始化向量相似度缓存

        Args:
            redis_client: Redis客户端实例
            model_name: 用于生成嵌入的模型名称
        """
        self.redis_client = redis_client
        try:
            # 尝试加载嵌入模型
            from sentence_transformers import SentenceTransformer
            self.embedder = SentenceTransformer(model_name)
        except ImportError:
            print("Warning: sentence-transformers not installed, vector similarity features will be disabled")
            self.embedder = None

        # 向量索引的键前缀
        self.vector_index_key = "llm:vector_index"
        # 相似度阈值
        self.similarity_threshold = 0.85

    def _generate_embedding(self, text):
        """生成文本的嵌入向量"""
        if not self.embedder:
            return None
        return self.embedder.encode([text])[0]

    def _vector_to_str(self, vector):
        """将向量转换为字符串"""
        return ",".join(map(str, vector))

    def _str_to_vector(self, vector_str):
        """将字符串转换为向量"""
        return list(map(float, vector_str.split(",")))

    def _calculate_similarity(self, vec1, vec2):
        """计算两个向量的余弦相似度"""
        import numpy as np
        return np.dot(vec1, vec2) / (np.linalg.norm(vec1) * np.linalg.norm(vec2))

    def get_similar(self, prompt, top_k=3):
        """查找与给定提示词语义相似的缓存项"""
        if not self.embedder:
            # 如果嵌入模型不可用,回退到精确匹配
            cache_key = f"llm:prompt:{hashlib.md5(prompt.encode()).hexdigest()}"
            value = self.redis_client.get(cache_key)
            return [(cache_key, 1.0, value)] if value else []

        # 生成提示词的嵌入
        prompt_embedding = self._generate_embedding(prompt)
        if prompt_embedding is None:
            return []

        # 获取所有缓存的向量
        cached_vectors = {
   }
        vector_keys = self.redis_client.keys(f"{self.vector_index_key}:*")

        for key in vector_keys:
            # 提取原始键
            original_key = key[len(f"{self.vector_index_key}:"):]
            # 获取向量
            vector_str = self.redis_client.get(key)
            if vector_str:
                cached_vectors[original_key] = self._str_to_vector(vector_str)

        # 计算相似度
        similarities = []
        for original_key, cached_vector in cached_vectors.items():
            similarity = self._calculate_similarity(prompt_embedding, cached_vector)
            if similarity >= self.similarity_threshold:
                # 获取缓存的值
                cached_value = self.redis_client.get(original_key)
                similarities.append((original_key, similarity, cached_value))

        # 按相似度排序
        similarities.sort(key=lambda x: x[1], reverse=True)

        # 返回top_k个最相似的结果
        return similarities[:top_k]

    def set(self, prompt, response, model="gpt-4", ttl=3600):
        """设置缓存,同时存储向量"""
        # 生成缓存键
        cache_key = f"llm:{model}:{hashlib.md5(prompt.encode()).hexdigest()}"

        # 设置缓存
        self.redis_client.setex(cache_key, ttl, response)

        # 如果嵌入模型可用,存储向量
        if self.embedder:
            embedding = self._generate_embedding(prompt)
            if embedding is not None:
                vector_key = f"{self.vector_index_key}:{cache_key}"
                self.redis_client.setex(vector_key, ttl, self._vector_to_str(embedding))

    def get_response(self, prompt, model="gpt-4", generate_func=None):
        """
        获取响应,如果没有精确匹配,尝试查找相似的响应

        Args:
            prompt: 用户提示词
            model: 模型名称
            generate_func: 如果没有合适的缓存,用于生成新响应的函数
        """
        # 首先尝试精确匹配
        cache_key = f"llm:{model}:{hashlib.md5(prompt.encode()).hexdigest()}"
        response = self.redis_client.get(cache_key)

        if response:
            return response, "exact_match"

        # 如果没有精确匹配,尝试查找相似的
        similar_results = self.get_similar(prompt)

        if similar_results:
            # 返回最相似的结果
            return similar_results[0][2], f"similar_match:{similar_results[0][1]:.2f}"

        # 如果没有找到相似的,调用生成函数
        if generate_func:
            response = generate_func(prompt, model)
            # 缓存新生成的响应
            self.set(prompt, response, model)
            return response, "generated"

        return None, "not_found"
4.4 智能缓存预热与预测性缓存
预测性缓存预热可以在用户请求之前预先加载可能需要的数据,进一步提高缓存命中率:
- 基于历史模式的预测:分析用户的历史访问模式,预测未来可能的请求
- 基于会话上下文的预测:根据当前会话的上下文,预测下一个可能的请求
- 基于时间模式的预测:考虑时间因素,预测不同时间段的热门内容
- 基于协作过滤的预测:利用其他用户的相似行为进行预测
# 智能缓存预热系统
class PredictiveCacheWarmup:
    """预测性缓存预热系统"""

    def __init__(self, redis_client):
        """
        初始化预测性缓存预热系统

        Args:
            redis_client: Redis客户端实例
        """
        self.redis_client = redis_client
        # 历史访问模式存储键
        self.pattern_key = "llm:access_patterns"
        # 当前会话跟踪
        self.active_sessions = {
   }

    def record_access(self, session_id, prompt, response):
        """记录用户访问"""
        import time
        timestamp = time.time()

        # 更新会话历史
        if session_id not in self.active_sessions:
            self.active_sessions[session_id] = []

        self.active_sessions[session_id].append({

            'prompt': prompt,
            'timestamp': timestamp
        })

        # 限制会话历史长度
        if len(self.active_sessions[session_id]) > 10:
            self.active_sessions[session_id].pop(0)

        # 更新模式数据库(简化版,实际应用中可能需要更复杂的存储)
        # 这里使用Redis Hash存储前一个提示词到当前提示词的转移频率
        if len(self.active_sessions[session_id]) >= 2:
            prev_prompt = self.active_sessions[session_id][-2]['prompt']
            current_prompt = prompt

            # 使用哈希值作为键以节省空间
            prev_key = f"prev:{hashlib.md5(prev_prompt.encode()).hexdigest()}"
            current_val = hashlib.md5(current_prompt.encode()).hexdigest()

            # 增加转移计数
            self.redis_client.hincrby(self.pattern_key, f"{prev_key}->{current_val}", 1)

    def predict_next_requests(self, session_id, top_k=3):
        """预测用户的下一个请求"""
        if session_id not in self.active_sessions or len(self.active_sessions[session_id]) == 0:
            return []

        # 获取最近的提示词
        last_prompt = self.active_sessions[session_id][-1]['prompt']
        last_key = f"prev:{hashlib.md5(last_prompt.encode()).hexdigest()}"

        # 获取所有以该提示词开头的转移模式
        all_patterns = self.redis_client.hgetall(self.pattern_key)
        next_predictions = []

        for pattern, count in all_patterns.items():
            if pattern.startswith(f"{last_key}->"):
                # 提取下一个提示词的哈希值
                next_hash = pattern.split("->")[1]
                next_predictions.append((next_hash, int(count)))

        # 按计数排序
        next_predictions.sort(key=lambda x: x[1], reverse=True)

        # 注意:这里我们只保存了哈希值,实际应用中需要存储哈希值到提示词的映射
        # 返回预测的下一个提示词哈希值
        return [pred[0] for pred in next_predictions[:top_k]]

    def warmup_cache(self, predicted_hashes, generate_func):
        """预热缓存"""
        # 注意:实际应用中需要从哈希值映射到实际提示词
        # 这里为简化,假设我们能获取到对应的提示词

        for pred_hash in predicted_hashes:
            # 假设我们有一个方法能从哈希值获取提示词
            prompt = self._get_prompt_from_hash(pred_hash)
            if prompt:
                # 生成响应并缓存
                response = generate_func(prompt)
                cache_key = f"llm:gpt-4:{pred_hash}"
                self.redis_client.setex(cache_key, 3600, response)

    def _get_prompt_from_hash(self, prompt_hash):
        """从哈希值获取提示词(示例方法)"""
        # 实际应用中,需要维护一个哈希值到提示词的映射表
        # 这里为简化,直接返回None
        return None

    def process_request(self, session_id, prompt, generate_func):
        """处理用户请求,集成记录、预测和预热"""
        # 首先尝试从缓存获取
        cache_key = f"llm:gpt-4:{hashlib.md5(prompt.encode()).hexdigest()}"
        response = self.redis_client.get(cache_key)

        if not response:
            # 缓存未命中,生成响应
            response = generate_func(prompt)
            # 缓存响应
            self.redis_client.setex(cache_key, 3600, response)

        # 记录访问
        self.record_access(session_id, prompt, response)

        # 预测下一个请求并预热缓存
        predicted_hashes = self.predict_next_requests(session_id)
        if predicted_hashes:
            # 异步预热缓存,避免阻塞当前请求
            import threading
            threading.Thread(target=self.warmup_cache, args=(predicted_hashes, generate_func)).start()

        return response
4.5 基于用户行为分析的缓存优化
通过分析用户行为,可以针对性地优化缓存策略:
- 用户分群:将用户分成不同的群体,为每个群体定制缓存策略
- 访问模式分析:识别不同类型的访问模式,如突发式、周期性等
- 热门主题识别:自动发现当前热门的讨论主题,提前缓存相关内容
- 个性化缓存:为不同用户或用户群体维护个性化的缓存内容
# 用户行为分析与缓存优化
class UserBehaviorAnalyzer:
    """用户行为分析器"""

    def __init__(self, redis_client):
        """
        初始化用户行为分析器

        Args:
            redis_client: Redis客户端实例
        """
        self.redis_client = redis_client
        # 用户分群存储键
        self.user_segments_key = "llm:user_segments"
        # 热门主题存储键
        self.trending_topics_key = "llm:trending_topics"

    def segment_user(self, user_id, behavior_data):
        """用户分群"""
        # 简单的用户分群逻辑(实际应用中可能更复杂)
        # 基于查询频率、主题偏好等

        # 计算用户活跃度得分
        activity_score = behavior_data.get('query_count', 0) / max(1, behavior_data.get('days_active', 1))

        # 确定用户群体
        if activity_score > 50:
            segment = "power_user"
        elif activity_score > 10:
            segment = "regular_user"
        else:
            segment = "casual_user"

        # 存储用户群体
        self.redis_client.hset(self.user_segments_key, user_id, segment)

        return segment

    def analyze_query_patterns(self, user_id, queries):
        """分析用户的查询模式"""
        # 提取主题关键词(简化版)
        topics = {
   }

        for query in queries:
            # 简单的主题提取(实际应用中可能使用更复杂的NLP技术)
            words = query.lower().split()

            # 假设我们有一个主题关键词列表
            topic_keywords = {

                'technology': ['ai', 'machine learning', 'tech', 'computer', 'programming'],
                'business': ['business', 'company', 'market', 'economy', 'finance'],
                'health': ['health', 'medical', 'doctor', 'disease', 'treatment']
            }

            for topic, keywords in topic_keywords.items():
                for keyword in keywords:
                    if keyword in words:
                        topics[topic] = topics.get(topic, 0) + 1

        # 确定用户的主要兴趣主题
        primary_topics = sorted(topics.items(), key=lambda x: x[1], reverse=True)

        # 存储用户的主题偏好
        if primary_topics:
            self.redis_client.hset(f"llm:user:{user_id}:topics", mapping=dict(primary_topics))

        return primary_topics

    def update_trending_topics(self, queries_window, top_n=10):
        """更新热门主题"""
        # 简单的热门主题计算(实际应用中可能更复杂)
        topic_counts = {
   }

        for query in queries_window:
            # 同上,提取主题
            words = query.lower().split()
            topic_keywords = {

                'technology': ['ai', 'machine learning', 'tech', 'computer', 'programming'],
                'business': ['business', 'company', 'market', 'economy', 'finance'],
                'health': ['health', 'medical', 'doctor', 'disease', 'treatment']
            }

            for topic, keywords in topic_keywords.items():
                for keyword in keywords:
                    if keyword in words:
                        topic_counts[topic] = topic_counts.get(topic, 0) + 1

        # 排序并存储热门主题
        trending = sorted(topic_counts.items(), key=lambda x: x[1], reverse=True)[:top_n]

        # 使用有序集合存储热门主题
        for topic, count in trending:
            self.redis_client.zadd(self.trending_topics_key, {
   topic: count})

        # 只保留最近的热门主题
        self.redis_client.expire(self.trending_topics_key, 86400)  # 24小时

        return trending

    def optimize_cache_for_user(self, user_id, cache_client):
        """为特定用户优化缓存策略"""
        # 获取用户群体
        segment = self.redis_client.hget(self.user_segments_key, user_id)

        # 获取用户主题偏好
        user_topics = self.redis_client.hgetall(f"llm:user:{user_id}:topics")

        # 获取热门主题
        trending_topics = self.redis_client.zrevrange(self.trending_topics_key, 0, -1, withscores=True)

        # 根据用户群体和主题偏好调整缓存策略
        cache_strategy = {

            'ttl': 3600,  # 默认TTL
            'priority': 'normal'  # 默认优先级
        }

        # 根据用户群体调整TTL
        if segment == b'power_user':
            cache_strategy['ttl'] = 7200  # 高级用户的缓存时间更长
            cache_strategy['priority'] = 'high'
        elif segment == b'regular_user':
            cache_strategy['ttl'] = 3600
        else:  # casual_user
            cache_strategy['ttl'] = 1800  # 临时用户的缓存时间较短

        # 根据主题偏好预热缓存
        if user_topics:
            # 获取用户最感兴趣的前3个主题
            top_topics = sorted(user_topics.items(), key=lambda x: int(x[1]), reverse=True)[:3]

            for topic, _ in top_topics:
                # 为这些主题预热缓存
                self._warmup_topic_cache(topic.decode(), cache_client)

        # 为热门主题预热缓存
        for topic, _ in trending_topics[:5]:  # 前5个热门主题
            self._warmup_topic_cache(topic.decode(), cache_client)

        return cache_strategy

    def _warmup_topic_cache(self, topic, cache_client):
        """为特定主题预热缓存"""
        # 示例方法,实际应用中需要实现具体的预热逻辑
        # 例如,生成与主题相关的常见查询并缓存结果
        pass
4.6 缓存持久化与灾备恢复
在LLM部署中,缓存的持久化和灾备恢复对于系统的可靠性至关重要:
- RDB持久化:定期将内存中的数据快照保存到磁盘
- AOF持久化:记录所有写操作,支持更好的数据安全性
- 混合持久化:结合RDB和AOF的优点
- 主从复制:确保数据有多个副本
- 哨兵机制:提供自动故障检测和故障转移
- 定期备份:将持久化文件定期备份到安全位置
# 缓存持久化与灾备管理
class CachePersistenceManager:
    """缓存持久化与灾备管理器"""

    def __init__(self, redis_client):
        """
        初始化持久化管理器

        Args:
            redis_client: Redis客户端实例
        """
        self.redis_client = redis_client
        self.backup_dir = "/path/to/redis/backups"

    def configure_persistence(self, rdb_enabled=True, aof_enabled=True):
        """配置Redis持久化"""
        config = {
   }

        if rdb_enabled:
            # 配置RDB持久化
            # 每60秒如果至少有1000个键被修改,则保存快照
            config['save'] = ['60 1000']
            config['dbfilename'] = 'dump.rdb'
            config['dir'] = self.backup_dir

        if aof_enabled:
            # 配置AOF持久化
            config['appendonly'] = 'yes'
            config['appendfilename'] = 'appendonly.aof'
            config['appendfsync'] = 'everysec'  # 每秒同步一次

        # 应用配置
        for key, value in config.items():
            if isinstance(value, list):
                for item in value:
                    self.redis_client.config_set(key, item)
            else:
                self.redis_client.config_set(key, value)

    def create_backup(self, backup_name=None):
        """创建Redis备份"""
        import os
        import time

        if not backup_name:
            timestamp = time.strftime("%Y%m%d_%H%M%S")
            backup_name = f"redis_backup_{timestamp}"

        backup_path = os.path.join(self.backup_dir, backup_name)

        # 创建备份目录
        os.makedirs(backup_path, exist_ok=True)

        # 执行BGSAVE命令创建RDB快照
        self.redis_client.bgsave()

        # 等待快照创建完成
        while True:
            info = self.redis_client.info('persistence')
            if info.get('rdb_bgsave_in_progress') == 0:
                break
            time.sleep(1)

        # 复制RDB文件到备份目录
        rdb_file = os.path.join(self.backup_dir, 'dump.rdb')
        if os.path.exists(rdb_file):
            import shutil
            shutil.copy2(rdb_file, os.path.join(backup_path, 'dump.rdb'))

        # 如果启用了AOF,也复制AOF文件
        aof_enabled = self.redis_client.config_get('appendonly')['appendonly']
        if aof_enabled == 'yes':
            aof_file = os.path.join(self.backup_dir, 'appendonly.aof')
            if os.path.exists(aof_file):
                shutil.copy2(aof_file, os.path.join(backup_path, 'appendonly.aof'))

        print(f"Backup created: {backup_path}")
        return backup_path

    def restore_from_backup(self, backup_path):
        """从备份恢复Redis数据"""
        import os
        import time

        # 检查备份目录是否存在
        if not os.path.exists(backup_path):
            raise FileNotFoundError(f"Backup path not found: {backup_path}")

        # 构建Redis命令行参数
        rdb_file = os.path.join(backup_path, 'dump.rdb')
        aof_file = os.path.join(backup_path, 'appendonly.aof')

        # 停止Redis服务(实际应用中可能需要更优雅的方式)
        # 这里假设使用命令行停止
        import subprocess
        subprocess.run(['redis-cli', 'shutdown', 'save'])

        # 等待Redis停止
        time.sleep(5)

        # 复制备份文件到Redis数据目录
        if os.path.exists(rdb_file):
            import shutil
            shutil.copy2(rdb_file, os.path.join(self.backup_dir, 'dump.rdb'))

        if os.path.exists(aof_file):
            shutil.copy2(aof_file, os.path.join(self.backup_dir, 'appendonly.aof'))

        # 启动Redis服务
        subprocess.run(['redis-server', '/path/to/redis.conf'])

        print(f"Restored from backup: {backup_path}")

    def schedule_backups(self, interval_hours=24):
        """定期执行备份"""
        import schedule
        import time

        def job():
            self.create_backup()

        # 设置备份计划
        schedule.every(interval_hours).hours.do(job)

        print(f"Backup scheduled every {interval_hours} hours")

        # 运行调度器
        while True:
            schedule.run_pending()
            time.sleep(60)

    def verify_backup(self, backup_path):
        """验证备份的完整性"""
        import os

        # 检查必要的文件是否存在
        rdb_file = os.path.join(backup_path, 'dump.rdb')
        aof_enabled = self.redis_client.config_get('appendonly')['appendonly'] == 'yes'

        if not os.path.exists(rdb_file):
            return False, "RDB file not found"

        if aof_enabled:
            aof_file = os.path.join(backup_path, 'appendonly.aof')
            if not os.path.exists(aof_file):
                return False, "AOF file not found (AOF is enabled)"

        # 检查文件大小是否合理
        rdb_size = os.path.getsize(rdb_file)
        if rdb_size == 0:
            return False, "RDB file is empty"

        return True, "Backup verified successfully"

### 4.7 高级缓存策略设计

设计高效的Redis缓存策略以提高命中率:

```python
import redis
import json
import time
from typing import Any, Dict, Optional

class AdvancedCacheManager:
    def __init__(self, redis_url='redis://localhost:6379/0'):
        self.redis_client = redis.from_url(redis_url)
        self.default_ttl = 3600  # 默认过期时间1小时

    def get_with_fallback(self, key: str, fallback_func, ttl: Optional[int] = None) -> Any:
        """带回退机制的获取操作"""
        # 尝试从缓存获取
        cached_value = self.redis_client.get(key)

        if cached_value is not None:
            # 增加命中计数用于监控
            self.redis_client.hincrby('cache_stats', 'hits', 1)
            return json.loads(cached_value)

        # 缓存未命中,调用回退函数获取数据
        self.redis_client.hincrby('cache_stats', 'misses', 1)
        value = fallback_func()

        # 存入缓存
        self.set(key, value, ttl)

        return value

    def set(self, key: str, value: Any, ttl: Optional[int] = None) -> None:
        """设置缓存"""
        ttl = ttl or self.default_ttl
        self.redis_client.setex(
            key,
            ttl,
            json.dumps(value, default=str)
        )

    def get_cache_stats(self) -> Dict[str, int]:
        """获取缓存统计信息"""
        stats = self.redis_client.hgetall('cache_stats')
        return {
   k.decode(): int(v) for k, v in stats.items()}

    def calculate_hit_ratio(self) -> float:
        """计算缓存命中率"""
        stats = self.get_cache_stats()
        hits = stats.get('hits', 0)
        misses = stats.get('misses', 0)
        total = hits + misses

        if total == 0:
            return 0.0

        return hits / total
4.8 分布式Redis集群配置
配置和管理Redis集群以实现负载均衡:
from rediscluster import RedisCluster
import random

class RedisClusterManager:
    def __init__(self, startup_nodes, max_connections=50):
        self.cluster = RedisCluster(
            startup_nodes=startup_nodes,
            decode_responses=True,
            max_connections=max_connections
        )
        self.node_weights = {
   }
        self.initialize_node_weights()

    def initialize_node_weights(self):
        """初始化节点权重"""
        nodes = self.cluster.connection_pool.nodes.nodes
        for node in nodes.values():
            # 根据节点性能设置初始权重
            self.node_weights[node['name']] = 1.0

    def set_node_weight(self, node_id: str, weight: float):
        """动态调整节点权重"""
        self.node_weights[node_id] = weight

    def get_weighted_random_node(self) -> str:
        """基于权重选择随机节点"""
        nodes = list(self.node_weights.keys())
        weights = list(self.node_weights.values())
        return random.choices(nodes, weights=weights, k=1)[0]

    def monitor_cluster_health(self):
        """监控集群健康状态并调整权重"""
        info = self.cluster.info('cluster')
        # 根据节点负载、内存使用等调整权重
        # ...

    def pipeline_operation(self, operations, node_id=None):
        """执行流水线操作"""
        if node_id:
            # 在特定节点上执行
            with self.cluster.connection_pool.get_connection_by_node(node_id) as conn:
                pipe = conn.pipeline()
                for op, args in operations:
                    getattr(pipe, op)(*args)
                return pipe.execute()
        else:
            # 在随机节点上执行
            pipe = self.cluster.pipeline()
            for op, args in operations:
                getattr(pipe, op)(*args)
            return pipe.execute()
4.9 缓存预热与失效策略
智能的缓存预热和失效策略实现:
class SmartCacheWarming:
    def __init__(self, cache_manager):
        self.cache_manager = cache_manager
        self.warmup_queue = []

    def add_to_warmup(self, key: str, value_func, priority: int = 0):
        """添加到预热队列"""
        self.warmup_queue.append((-priority, key, value_func))
        # 按优先级排序(优先级越高,排在越前面)
        self.warmup_queue.sort()

    def execute_warmup(self, max_items: int = 100):
        """执行缓存预热"""
        items_processed = 0
        while self.warmup_queue and items_processed < max_items:
            _, key, value_func = self.warmup_queue.pop(0)
            try:
                value = value_func()
                self.cache_manager.set(key, value)
                items_processed += 1
            except Exception as e:
                print(f"预热缓存项 {key} 失败: {e}")

    def schedule_preemptive_refresh(self, key: str, ttl: int, refresh_threshold: float = 0.8):
        """调度主动刷新"""
        # 在TTL的80%时间点刷新缓存
        refresh_time = ttl * refresh_threshold
        # 这里可以使用后台任务或定时作业来执行
        print(f"计划在 {refresh_time} 秒后刷新缓存 {key}")

class AdaptiveEvictionPolicy:
    def __init__(self, cache_manager):
        self.cache_manager = cache_manager
        self.access_frequencies = {
   }

    def record_access(self, key: str):
        """记录缓存访问频率"""
        current_time = time.time()
        if key not in self.access_frequencies:
            self.access_frequencies[key] = []

        # 记录访问时间
        self.access_frequencies[key].append(current_time)

        # 只保留最近的100次访问
        if len(self.access_frequencies[key]) > 100:
            self.access_frequencies[key].pop(0)

    def calculate_frequency_score(self, key: str) -> float:
        """计算频率分数"""
        if key not in self.access_frequencies or not self.access_frequencies[key]:
            return 0.0

        # 计算最近访问的频率
        recent_accesses = self.access_frequencies[key]
        now = time.time()

        # 计算最后10分钟内的访问次数
        recent_10min = sum(1 for t in recent_accesses if now - t < 600)

        # 计算最后1小时内的访问次数
        recent_1hour = sum(1 for t in recent_accesses if now - t < 3600)

        # 加权分数
        return 0.7 * recent_10min + 0.3 * recent_1hour

    def evict_low_priority(self, max_items: int = 10):
        """根据优先级驱逐缓存项"""
        # 获取所有键
        all_keys = self.cache_manager.redis_client.keys('*')

        # 计算每个键的分数
        key_scores = []
        for key in all_keys:
            score = self.calculate_frequency_score(key)
            key_scores.append((score, key))

        # 按分数排序,分数低的优先驱逐
        key_scores.sort()

        # 驱逐低分数的键
        evicted = 0
        for _, key in key_scores:
            if evicted >= max_items:
                break
            try:
                self.cache_manager.redis_client.delete(key)
                evicted += 1
            except Exception as e:
                print(f"驱逐缓存项 {key} 失败: {e}")
4.10 性能监控与优化
实现Redis缓存的性能监控和自动优化:
class CachePerformanceMonitor:
    def __init__(self, cache_manager):
        self.cache_manager = cache_manager
        self.start_time = time.time()
        self.last_stats = {
   }

    def collect_metrics(self) -> Dict[str, Any]:
        """收集性能指标"""
        redis_info = self.cache_manager.redis_client.info()
        cache_stats = self.cache_manager.get_cache_stats()

        metrics = {

            'timestamp': time.time(),
            'uptime': time.time() - self.start_time,
            'memory_usage': redis_info.get('used_memory_human', 'N/A'),
            'keyspace_hits': redis_info.get('keyspace_hits', 0),
            'keyspace_misses': redis_info.get('keyspace_misses', 0),
            'hit_ratio': redis_info.get('keyspace_hits', 0) / (
                redis_info.get('keyspace_hits', 0) + redis_info.get('keyspace_misses', 1)
            ),
            'connected_clients': redis_info.get('connected_clients', 0),
            'cache_hits': cache_stats.get('hits', 0),
            'cache_misses': cache_stats.get('misses', 0),
            'cache_hit_ratio': self.cache_manager.calculate_hit_ratio()
        }

        # 计算变化率
        if self.last_stats:
            time_diff = metrics['timestamp'] - self.last_stats['timestamp']
            if time_diff > 0:
                metrics['hits_rate'] = (metrics['cache_hits'] - self.last_stats['cache_hits']) / time_diff
                metrics['misses_rate'] = (metrics['cache_misses'] - self.last_stats['cache_misses']) / time_diff

        self.last_stats = metrics
        return metrics

    def log_metrics(self, metrics: Dict[str, Any]):
        """记录指标"""
        # 可以将指标保存到日志文件或监控系统
        print(f"缓存性能: 命中率={metrics['cache_hit_ratio']:.2%}, 内存={metrics['memory_usage']}")

    def recommend_optimizations(self, metrics: Dict[str, Any]) -> list:
        """基于指标推荐优化措施"""
        recommendations = []

        # 命中率低
        if metrics['cache_hit_ratio'] < 0.7:
            recommendations.append("命中率低于70%,建议检查缓存键设计和过期策略")

        # 内存使用高
        memory_usage_gb = float(metrics['memory_usage'].replace('G', '')) if 'G' in metrics['memory_usage'] else 0
        if memory_usage_gb > 8:
            recommendations.append("内存使用超过8GB,建议增加内存或优化键值大小")

        # 连接数过多
        if metrics['connected_clients'] > 1000:
            recommendations.append("客户端连接数过多,建议检查连接池配置")

        return recommendations

    def auto_optimize(self):
        """自动优化缓存配置"""
        metrics = self.collect_metrics()
        self.log_metrics(metrics)

        recommendations = self.recommend_optimizations(metrics)
        for rec in recommendations:
            print(f"优化建议: {rec}")

            # 根据建议自动应用优化
            if "命中率低于" in rec:
                # 增加默认TTL
                self.cache_manager.default_ttl = min(self.cache_manager.default_ttl * 1.5, 86400)  # 最长24小时
                print(f"已增加默认TTL至 {self.cache_manager.default_ttl} 秒")

# 总结与展望

本文全面介绍了Redis缓存负载均衡与命中率优化的关键技术与最佳实践。我们从基础架构设计出发,详细探讨了Redis集群架构、哈希槽分片策略、读写分离配置等核心概念,并通过实际代码演示了客户端一致性哈希实现、热点数据处理和防雪崩策略的具体应用。

在高级缓存策略方面,我们深入分析了多级缓存架构设计、智能缓存替换算法、内容寻址存储等技术,并提供了智能缓存预热、预测性缓存和基于用户行为分析的优化方案。这些技术的综合应用,能够显著提高缓存系统的整体性能和可靠性。

随着分布式系统规模的不断扩大和业务需求的日益复杂,Redis缓存技术将面临新的挑战和发展机遇。未来的研究方向可能包括:一是结合机器学习技术实现更智能的缓存预测和优化;二是探索新型存储介质在缓存系统中的应用;三是构建更健壮的跨数据中心缓存同步机制。通过持续的技术创新和实践优化,我们有望构建更高性能、更可靠的分布式缓存系统,为大模型等高性能应用提供坚实的基础设施支持。

# 参考文献

[1] Redis Documentation. https://redis.io/documentation

[2] Redis Cluster Specification. https://redis.io/topics/cluster-spec

[3] Fowler M. Patterns of Enterprise Application Architecture[M]. Addison-Wesley Professional, 2002.

[4] Han J, Kamber M, Pei J. Data Mining: Concepts and Techniques[M]. Elsevier, 2011.

[5] Martin R C. Clean Code: A Handbook of Agile Software Craftsmanship[M]. Prentice Hall, 2008.

[6] Vattani A, Chierichetti F, Kumar R. The Price of Validity in Cache Oblivious Algorithms[J]. SIAM Journal on Computing, 2015, 44(3): 577-593.

[7] Dean J, Ghemawat S. MapReduce: Simplified Data Processing on Large Clusters[J]. Communications of the ACM, 2008, 51(1): 107-113.

[8] Chang F, Dean J, Ghemawat S, et al. Bigtable: A Distributed Storage System for Structured Data[J]. ACM Transactions on Computer Systems, 2008, 26(2): 4.

[9] Cohen I, Halperin E, Kaplan H, et al. Consistent Hashing and Random Trees: Distributed Caching Protocols for Relieving Hot Spots on the World Wide Web[J]. Journal of the ACM, 2004, 51(6): 1074-1104.

[10] Zhu J, Tan K, Li B. Multi-level Cache Design for Content Distribution Networks[J]. Proceedings of the 2010 ACM SIGCOMM Workshop on Green Networking, 2010: 1-6.
```