
9 月 2 日,腾讯混元宣布,其3D世界模型系列最新成员——HunyuanWorld-Voyager(简称混元Voyager)发布并开源,这将推动AI在空间智能领域的应用扩展,为虚拟现实、物理仿真、游戏开发等领域提供高保真3D场景漫游能力,加速行业应用落地。
作为业界首个支持原生3D重建的超长漫游世界模型,混元Voyager突破了传统视频生成在空间一致性和探索范围上的局限,能够生成长距离、世界一致的漫游场景,支持将视频直接导出为3D格式。混元Voyager 3D输入-3D输出的特性,与此前已开源的混元世界模型1.0 高度适配,可进一步扩展 1.0 模型漫游范围,提升复杂场景的生成质量,并可对生成的场景做风格化控制和编辑。
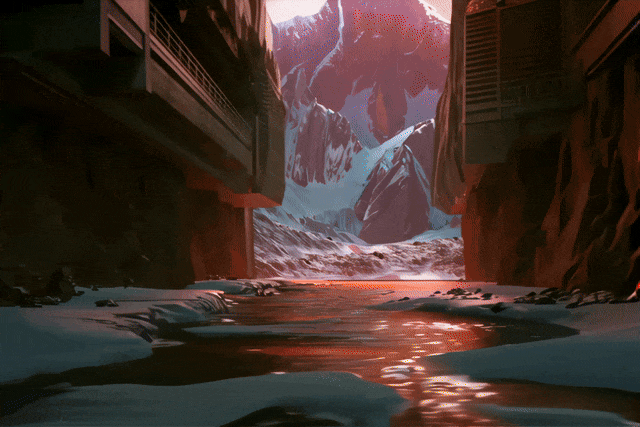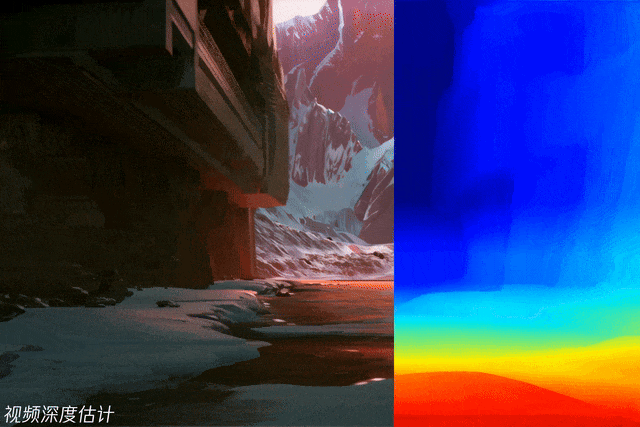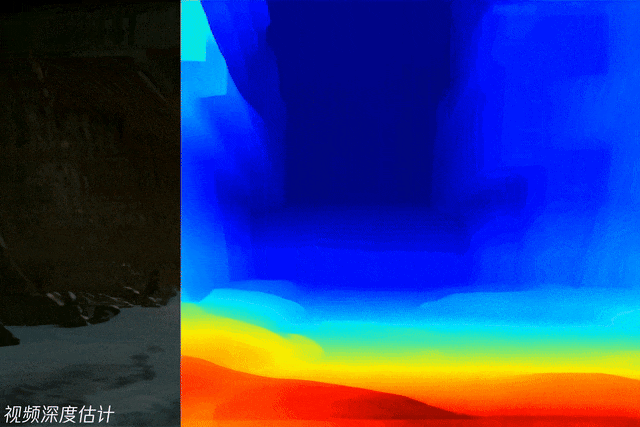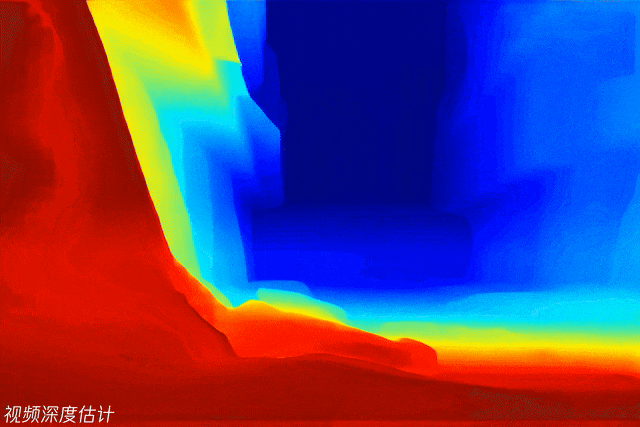
不仅如此,混元Voyager 还可支持视频场景重建、3D物体纹理生成、视频风格定制化生成、视频深度估计等多种3D理解与生成应用,展现出空间智能的潜力。该模型现已正式上线,相关技术报告已公开,源代码在GitHub和Hugging Face上免费开放,供全球开发者下载和使用。
 编辑
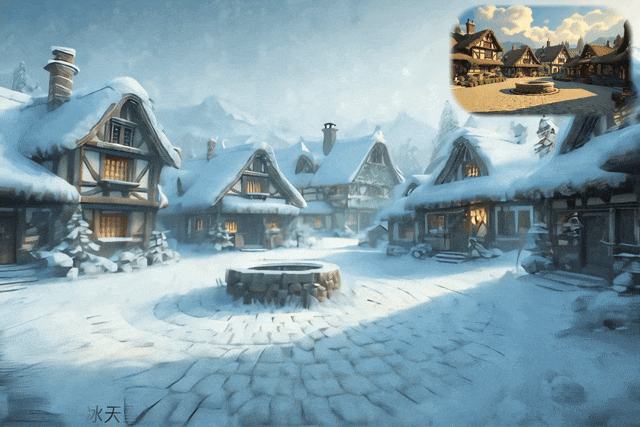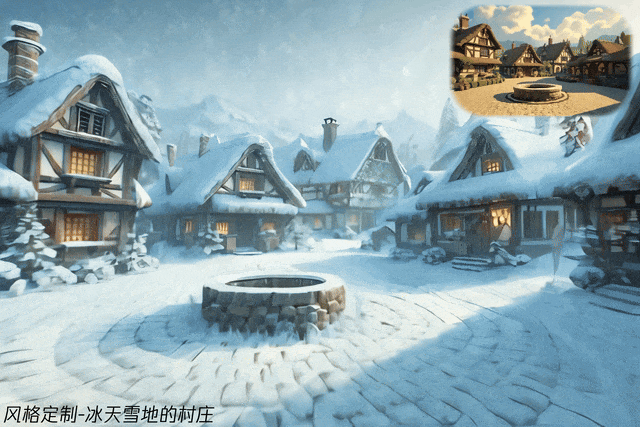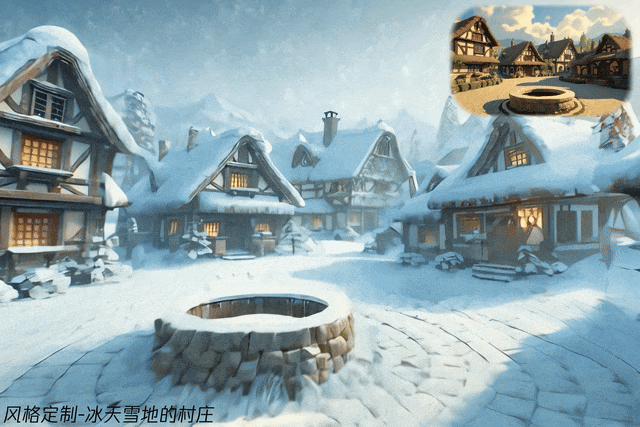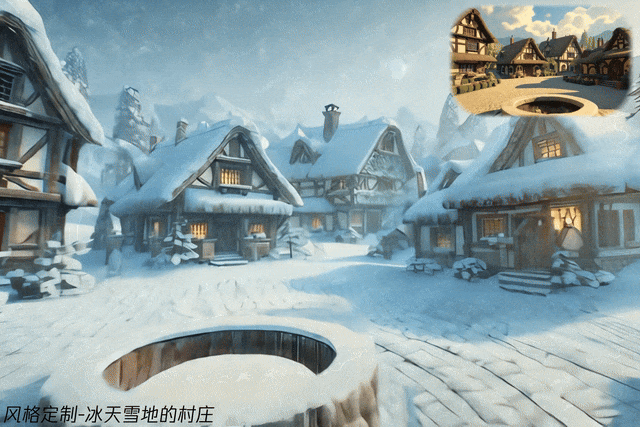
 编辑
 编辑
当前,谷歌Genie3等支持实时交互的视频生成世界模型备受关注,但其纯2D输出难以满足虚拟现实和物理仿真等应用的3D交互需求。另一方面,直接生成3D场景虽具备空间结构优势,却面临训练数据稀缺和内存效率低下的挑战,无法泛化到更大场景。
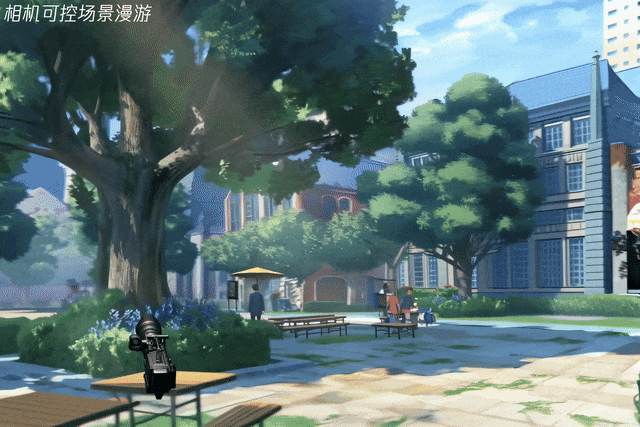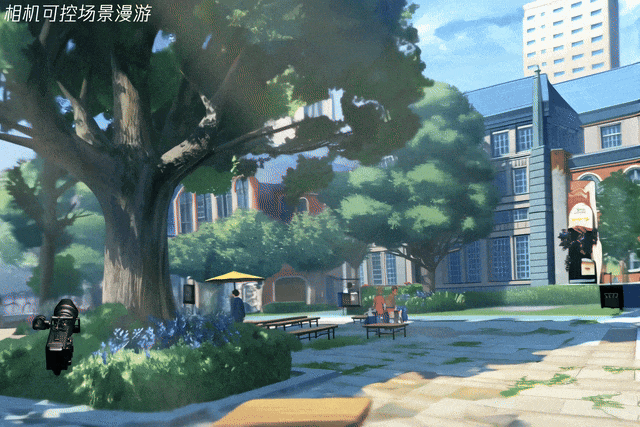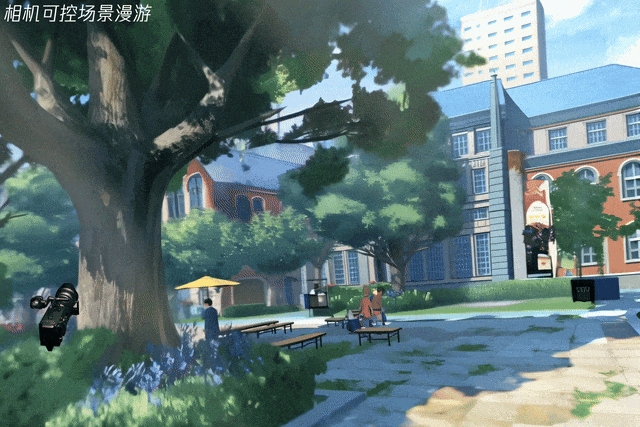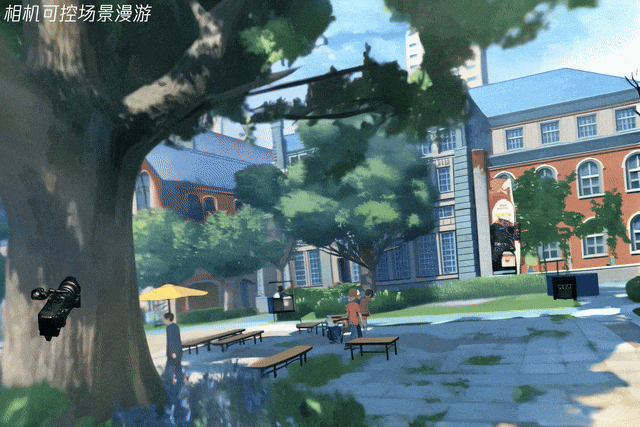
混元Voyager是混元世界模型1.0的官方扩展模型,创新性地将场景深度预测引入视频生成过程,融合了视频生成与3D建模优势,基于相机可控的视频生成技术,从初始场景视图和用户指定相机轨迹中,合成可自由控制视角、空间连贯的RGB-D视频(包含RGB图像和深度信息的点云视频)。
用户可通过键盘或者摇杆即可控制生成对应的视频画面,并可以通过3D空间记忆保持画面的高度一致性,实现Genie3相同的能力。同时,Voyager还支持将生成视频无损导出3D点云,无需依赖COLMAP等额外重建工具。

 编辑
混元Voyager首次通过空间与特征结合的方式,支持原生的3D记忆和场景重建,避免了传统后处理带来的延迟和精度损失。同时,在输入端加入3D条件保证画面视角精准,输出端直接生成3D点云,适配多种应用场景。额外的深度信息还能支持视频场景重建、3D物体纹理生成、风格化编辑和深度估计等功能。
混元Voyager 还引入了可扩展的世界缓存机制,基于混元 3D 世界模型1.0生成的初始3D点云缓存,将其投影到目标相机视图,为扩散模型提供指导。此外,生成的视频帧还会实时更新缓存,形成闭环系统,支持任意相机轨迹,同时维持几何一致性。这不仅扩展了漫游范围,还为1.0模型补充新视角内容,提升整体生成质量。

 编辑
该模型在斯坦福大学李飞飞团队发布的世界模型基准测试WorldScore上位居综合能力首位,超越现有开源方法,在视频生成和3D重建任务中均表现出色。在视频生成和视频3D重建两个任务上,Voyager也均取得更好的结果。
Voyager在斯坦福大学团队的世界模型排行榜 WorldScore上,取得了综合能力第一名的成绩

 编辑
WorldScore:https://huggingface.co/spaces/Howieeeee/WorldScore_Leaderboard

 编辑
在和现有开源方法的比较中,Voyager可根据生成的视频帧重建出更加精确的3DGS场景
腾讯混元世界模型系列开源正不断加速。7月,混元3D世界模型1.0发布并开源,成为业界首个兼容传统CG管线的可漫游世界生成模型。8月,推出1.0 Lite版,降低显存需求,支持消费级显卡部署。仅两周后,针对遮挡视图和探索范围限制,混元团队进一步优化,推出超长漫游世界模型Voyager。
此前,混元已陆续开源业界领先的文生图、视频生成和3D生成能力,提供接近商业模型性能的开源模型。在基础模型方面,混元开源了MoE架构的代表性模型混元large、混合推理模型Hunyuan-A13B,以及多个面向端侧场景的小尺寸模型,最小仅0.5B参数。最新开源的翻译模型Hunyuan-MT-7B在国际翻译比赛中斩获31个语种中的30项冠军。
混元3D生成能力全球领先,其最新版本混元3D v2.5在质感上显著提升,于6月上海人工智能实验室评测中荣登全球第一。混元3D系列开源模型下载量位居开源社区榜首,混元3D世界模型1.0上线后迅速登顶Hugging Face论文热榜第一、模型热榜第二。
项目主页:
https://3d-models.hunyuan.tencent.com/world/
Github:
https://github.com/Tencent-Hunyuan/HunyuanWorld-Voyager
ModelScope:
https://modelscope.cn/models/Tencent-Hunyuan/HunyuanWorld-Voyager
技术报告:
https://3d-models.hunyuan.tencent.com/Voyager/Voyager_en/assets/HYWorld_Voyager.pdf
点击链接,即可跳转模型链接~
https://modelscope.cn/models/Tencent-Hunyuan/HunyuanWorld-Voyager

