
在Qwen2.5发布之后,我们听到社区对处理更长序列的需求。在这段时间,我们针对长序列处理能力以及长序列下的推理效率进行了很多优化。今天,我们正式推出新的Qwen2.5-Turbo版本,其特点在于:
1)更长的上下文支持:我们首次将模型的上下文长度从128k tokens扩展到1M tokens,该长度约为100万个英文单词或150万个汉字,相当于10本长篇小说、150小时的演讲稿、3万行代码。
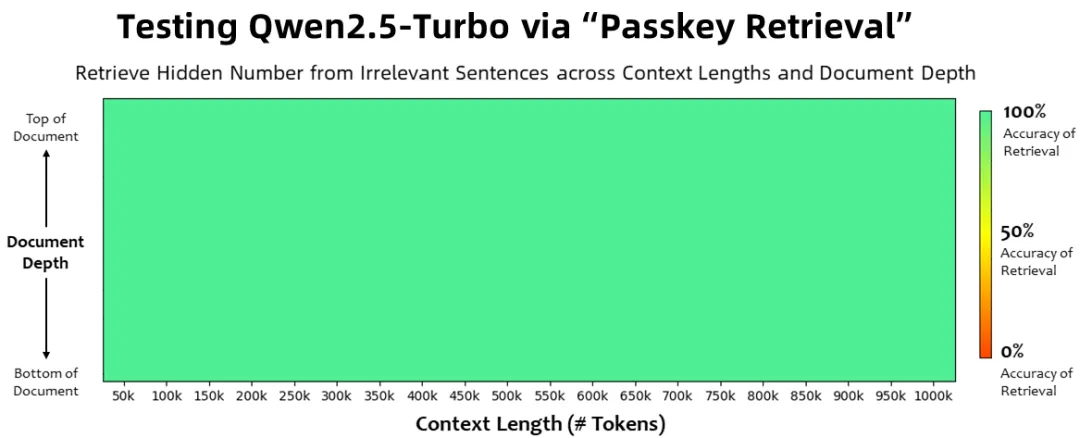
该模型在1M长度的大海捞针(Passkey Retrieval)任务中的准确率可达到100%,在长文本评测集RULER上获得93.1分,超越GPT-4的91.6分,GLM4-9B-1M的89.9分。在短序列能力上,该模型仍然保持着非常强的竞争力,与GPT-4o-mini持平。
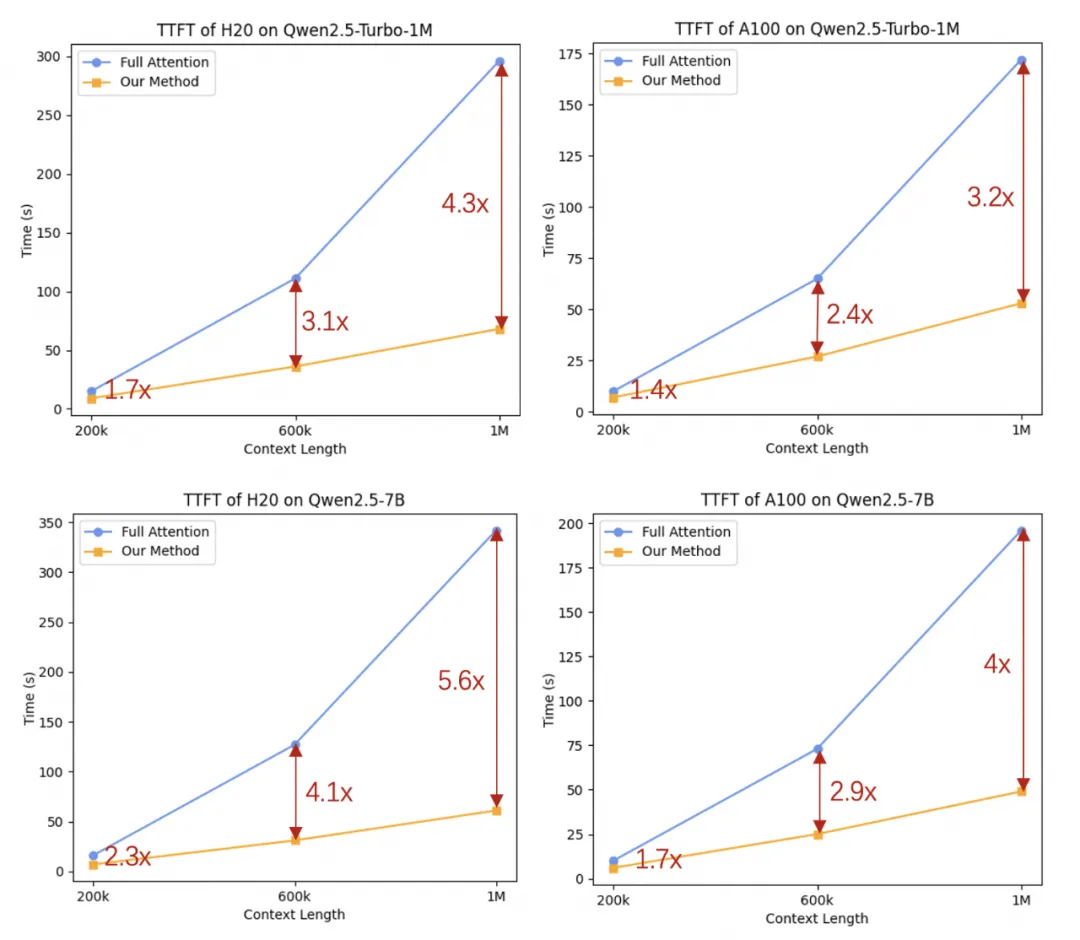
2)更快的推理速度:利用稀疏注意力机制,我们成功将处理1M tokens上下文时的首字返回时间从4.9分钟降低到68秒,实现4.3倍加速比。
3)更低的价格:价格仍为0.3元/1M tokens。在相同成本下,相比GPT-4o-mini,Qwen2.5-Tubo能够处理3.6倍的Token。 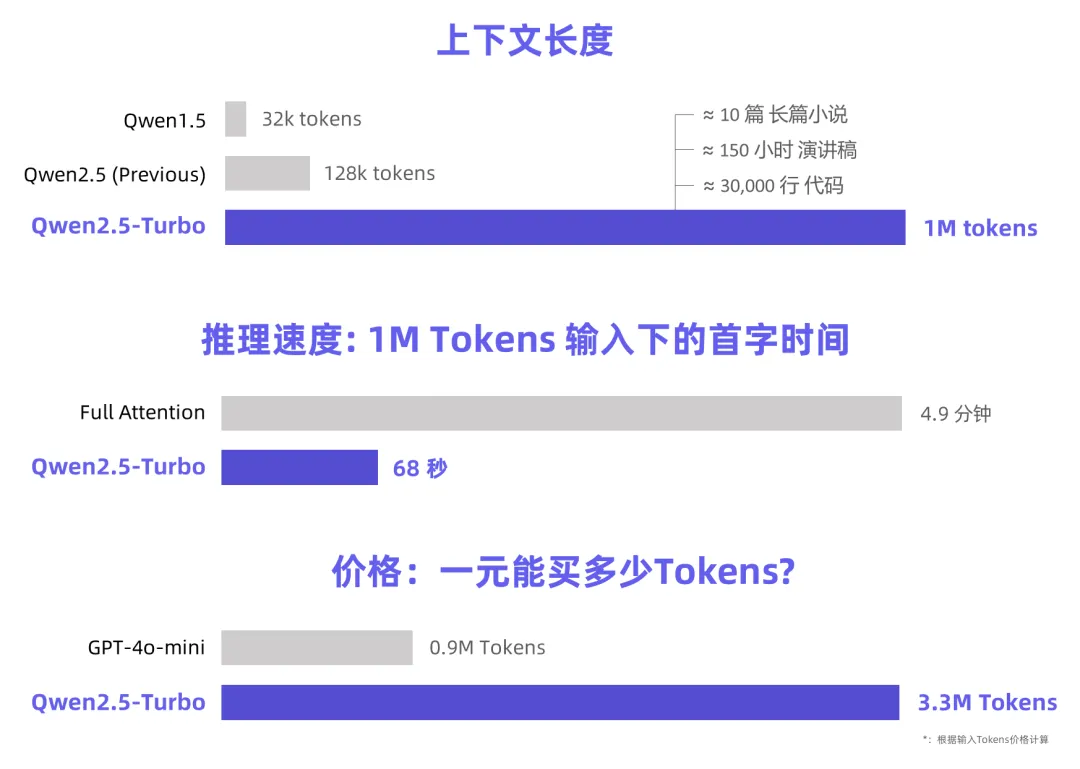
现在,你可以通过阿里云百炼(大模型服务平台)的API服务,或者通过Hugging Face Demo、魔搭社区ModelScope Demo进行体验。
- 阿里云百炼:
https://help.aliyun.com/zh/model-studio/developer-reference/what-is-qwen-llm - 魔搭社区ModelScope:
https://www.modelscope.cn/studios/Qwen/Qwen2.5-Turbo-1M-Demo - Hugging Face:
https://huggingface.co/spaces/Qwen/Qwen2.5-Turbo-1M-Demo
实例演示
我们准备了一些实例演示来展现Qwen2.5-Turbo带来的新用法,涵盖长篇小说深入理解、仓库级别代码助手、多篇论文阅读等。
如何使用API?
我们最新支持的1M tokens的Qwen2.5-Turbo的使用方法,和Qwen API的标准用法一致,并且与OpenAI API兼容。
下面是一个简单的Python调用示例(注意:你需要将环境变量YOUR_API_KEY设置为你的API Key,欲了解更多细节,请访问阿里云大模型服务快速入⻔):
import os

from openai import OpenAI

# 读取长文本文件
with open("example.txt", "r", encoding="utf-8") as f:
     text = f.read()
user_input = text + "\n\nSummarize the above text."

client = OpenAI(
     api_key=os.getenv("YOUR_API_KEY"),
     base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
     model="qwen-turbo-latest",
     messages=[
        {'role': 'system', 'content': 'You are a helpful assistant.'},
        {'role': 'user', 'content': user_input},
       ],
)

print(completion.choices[0].message)
- 阿里云大模型服务快速入门链接:
https://help.aliyun.com/zh/model-studio/getting-started/first-api-call-to-qwen
模型表现
我们通过各类基准测试来评估Qwen2.5-Turbo的性能及其推理速度的进步。
大海捞针
我们首先在1M大海捞针(Passkey Retrieval)任务上进行了实验。结果显示,Qwen2.5-Turbo能在1M长度的无关文本中完美捕捉所有隐藏的数字,证明模型在超长上下文中捕捉细节信息的能力。
更复杂的长文本任务
我们选取了若干长文本任务数据集对模型进行了测试,包括:
· RULER:在大海捞针基础上的扩展基准,任务包括在无关上下文中查找多“针”或回答多个问题,或找到上下文中出现最多或最少的词。数据的上下文长度最长为128K。
· LV-Eval:要求同时理解众多证据片段的基准测试。我们对LV-Eval原始版本中的评估指标进行了调整,避免因为过于严苛的匹配规则所导致的假阴性结果。数据的上下文长度最长为256K。
· LongbenchChat:一个评价长文本任务中人类偏好对齐的数据集。数据的上下文长度最长为
100K。
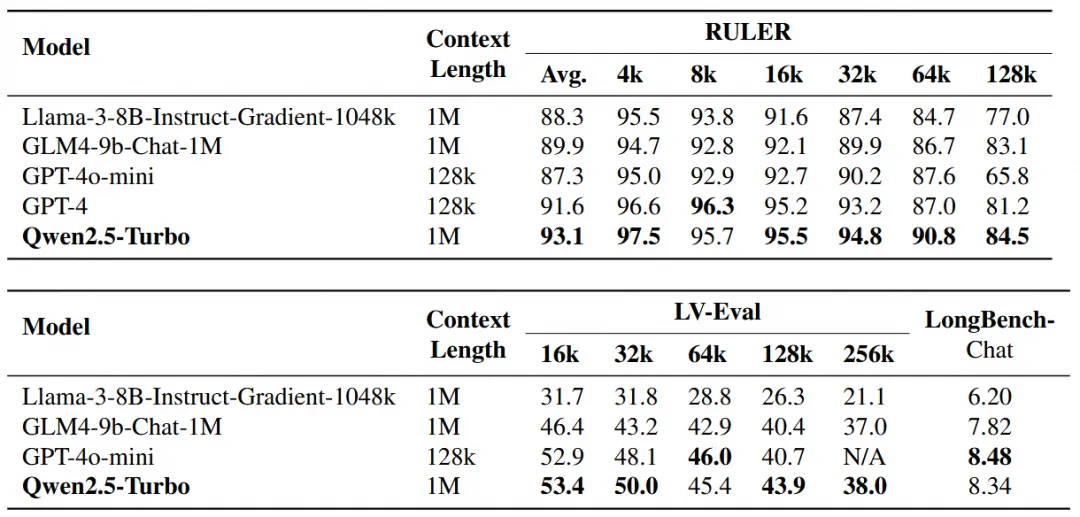
从结果可以看出,Qwen2.5-Turbo在各类长文本任务中均有优势:
· 在RULER基准测试中,Qwen2.5-Turbo取得了93.1分,不仅超越了GPT-4o-mini,甚至超越了GPT-4,证明了其处理长文本任务的卓越能力。
· 在LV-Eval、LongBench-Chat等更加接近真实情况的长文本任务中,Qwen2.5-Turbo在多数维度超越了GPT-4o-mini,并且能够进一步扩展到超过128K tokens上下文的问题上。
短文本任务
除了长序列任务的性能提升外,我们也同样关心模型在短文本任务上的性能。现有的上下文长度扩展方案经常会导致模型在处理短文本时性能大幅下降,因此,我们在构建Qwen2.5-Turbo的过程中特别关注了该问题,保证在扩展上下文长度的同时,几乎不会影响短文本任务的能力。
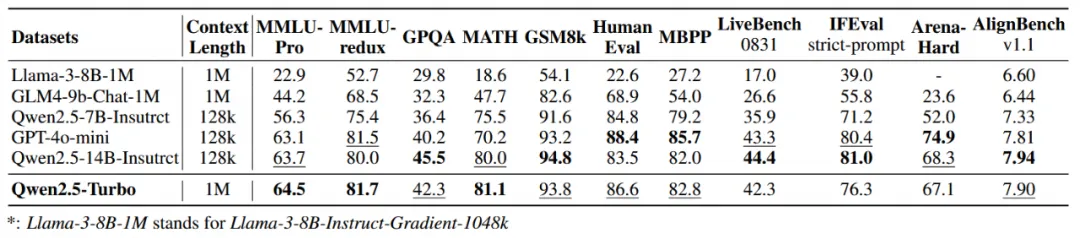
传统短文本基准上的结果显示,Qwen2.5-Turbo在大部分任务上的表现显著超越之前上下文长度为1M tokens的开源模型;和GPT-4o-mini、Qwen2.5-14B-Instruct模型相比,Qwen2.5-Turbo在短文本任务性能接近的同时,能支持其8倍长度的上下文。
推理速度
我们对不同长度的输入在多种模型架构下的首包延时时间进行了测试。在1M tokens的序列上,我们利用稀疏注意力机制将注意力部分的计算量压缩了约12.5倍,在不同硬件配置下实现了3.2至4.3倍的速度提升。
下一步目标
我们很高兴终于能够将Qwen2.5-Turbo的上下文扩展到1M tokens,同时,我们也清楚地认识到,当前模型在解决实际长序列任务上并不总是令人满意。这里存在很多未解决的挑战,例如,模型在长序列任务中的表现更加不稳定,推理成本使得使用更大规模的模型变得困难等。
我们将积极进一步探索长序列人类偏好对齐,优化推理效率以减少运算时间,尝试推出更大、更强的长序列模型。我们期望能够很快向大家分享在长序列上的新进展,敬请关注!

