Hologres+Flink企业级实时数仓核心能力介绍-2024实时数仓Hologres线上公开课03
内容介绍:
一、Hologres+Flink企业级实时数仓核心能力
二、解决实时数仓分层问题
三、Hologres+Flink企业级实时数仓核心能力基于
四、Flink Ctalog 的Streaming Warehouse
五、实践典型客户案列
本次分享的主题是Hologres+Flink企业级实时数仓核心能力介绍-2024实时数仓Hologres线上公开课03,由Hologres产品经理骆撷冬(观秋)分享。
课程链接:https://developer.aliyun.com/live/254101
更多学习内容可跳转阿里云培训中心https://edu.aliyun.com/

本内容是关于Hologres+Flink搭建起企业级实时数仓核心能力的解读。
一、Hologres+Flink企业级实时数仓核心能力

1. 简介
随着业务发展,业务对于时效性的要求在逐渐提升,各种场景都需要实施。比如春晚实时直播大屏,双11gmv实时大屏、实时个性化推荐等,各种场景对数据的时效性有着非常高的要求。随着实时性要求的发展,大数据技术也开始发展出实时数仓的概念。
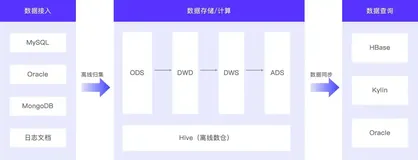
相比于传统的离线数仓,有明确的方法论,通过离线的定时调度来实现调度方式,通过ods- dwd-dws -ads这样明确的数仓分层方式来完成,是离线数仓的搭建,但是实时数仓在业内并没有明确的方法论,实践方案多,且没有标准方法,也没有明确的数据流转的方法论。所以业内提出了streamingwherehouse的概念,本质上是希望能够解决数据实时流动的问题,从而解决数据实时分层的问题,这是企业及实时数仓的本质。
2.传统实时数仓分层多方案

2.1基于flink+kafka的实时数仓分层方案
实时数据经过flink实时处理、加工后,将最终结果写入到kY6引擎中,供应用来查询。通过flink和kafka的反复交互,实现数据从ods到dwd到dws的每一层收藏构件业务,如果需要查询中间层,需要把中间层的数据实时写到实时数仓中来供应业务使用。这样的架构优势在于,数仓层次是完备的,各层值级间也很清晰,整个处理链路也相对分工明确。
这样的架构有多个劣势:
(1)大量的数据同步任务。资源消耗非常大,处理链路非常复杂。
(2)中间层的kafka的数据无法直接排查费用性差。如果需要中间数据可读,则需把数据双写到数仓中。
(3)无法做到快速响应schema动态变化,比如百色沟原表,发生了夹裂、改数据类型等情况,会使整个数据链路都需要做改动。
2.2定时调度数仓方案

通过flink把数据源的数据实时写入实数仓中形成dwd层。再通过数仓或周边工具的高频调度能力以分钟级为例来构建dws和ads层,实现分钟级的数据增量更新,最终供下游使用。它的优势在于成本相对flink+kafka来说更低,也偏向于成熟;劣势在于它增加了数仓数据处理电路的延时,整个实时数仓退化成了净时实数仓。并且调度层级越多,延时越大。
2.3.物化视

flink需负责将原表数据实时写入实时数仓中来形成dwd层,再通过实时数仓的雾化视图来加工形成bws或者ads层,最终为下游做服务。这样的架构优势在于整个数仓的处理加工的链路功能都是系统内置的,并且物化视图的结果能够提供一些高QPS的点查和简单查询能力。不足之处在于业内在实时物化视图方面的能力是不成熟的。对于算计各方面的支持都很有限。其次,很多系统提供的基本上都是一种时效性比较差的P模式的物化,通常无法满足持续数仓对于时效性的需求。
二、解决实时数仓分层问题
1.通过Hologres+Flink来解决实时数仓分层的问题

Hologres+Flink是阿里云一站式实时入仓,batchgres包含多方面的数据应用能力,olap多维分析,包括在线服务的检查能力,包括湖仓一体,向量计算和大模型服务等。
Hologres是一款支持各种场景的一站式的实时数仓。传统实时数仓可以解决亚秒级多交互式分析的能力,支持行业共存的方式,可以实现高吞吐的数据实时写入更新。Hologres通过兼容达摩院自研proxima向量引擎,从而实现向量进行高性能计算。同时Hologres还支持一系列高可用架构实现业务的弹性高可用以及业务的负载隔离。
2.基于Flink+Hologres的streaming warehouse 方案

数据源通过mysql或其他数据源,通过flink 实时写入hologres中,形成ods层。hologres支持binlog,可以提供表的增量变化信息,来成为flink的语言表,通过flink 全增量消费hologres元表,加工后再写入hologres中,再形成dwd层。dwd层的数据再次生成binlog的供flink消费,再次写入hologres 中,形成聚合层DWS以此最终为下游提供服务。
这样的架构优势有:
(1)解决传统中间层kafka数据不易查、不易更新、不易修正这些问题。hologres是一款实时数据,仓库数据写入即可查。不管是聚合层的dws层,还是中间ods ,dwd层,每一层都实时可查,实时更新。
(2)中间层,不仅可以供flink消费,还可以供下游直接提供服务,比如业务可直接查询oddst或dwd做olap分析,甚至是做在线服务等场景都可以直接实现。
(3)整个链路的数据都是复用的模型统一,架构简化,一份存储,一份引擎。
hologres与Flink结合形成streaming warehouse方案得益于hologres与Flink多年以来的深度集成。主要分四个方面。

(1)hologres可以作为flink的原表。因为hologres支持生成binlog类似于传统数字数据库的binlog可以供flink进行消费,以此实现多方面能力,包括全量能数据读取,binlog数据读取、cdc读取以及全能量一体化读取。
(2)hologres可以作为flink的维表,hologres支持行存或者行列共存的模式。以此可以用flink来进行维表关联。本质上对于hologres,对于维表的检查基于其高性能的防维表的检查能力,可以提供对于维表的百万rps查询。
(3)hotokafka可以作为flink的结果表格,hologres支持强大的实时数据写入能力与整行更新能力,完美匹配flink对于结构表的要求。同时hologres还支持宽表高性能的局部更新能力,可以极大程度地简化flink多流教育场景。
(4)整个链路通过flink创建Hologres catalog来完成。flink支持holgress catalog实现统一的原数据服务,以此可以支撑整库原表、整库同步以及schema- evolution数据类型变更,包括加力等场景,通过四个方面的深度集成,来承载flink加hologres搭建的screaming warehouse解决方案。
三、Hologres+Flink企业级实时数仓核心能力
screaming warehouse解决方案依托于hologres的三大核心能力:binlog、行列并存和资源隔离。
1.binlog

它可以助力整个实时数仓全链路的数据实时流动。类似于传统数据库,比如masygy或pg的binlog可以用来记录单表数据修改日志,包括insert, delete,before,update这四种数据事件类型,还可以提供表的增量变化信息,有多种场景的应用。首先最重要的就是用于本所说的解决方案,在数仓分层间进行数据的实时加工,可以通过flink 全增量消费holo表加工之后再次写入holo实现整个全链路数据的实时流动,还有其他一些场景。比如可以进行多实力之间的数据同步、数据的行列转换以及数据的变化检测。
holdress的binlog表包含下图所示的这些字段。

这些字段用来记录用户的表数据变更的信息。通过flink+hologres binlog就可以实现状态的全链路的事件实时驱动开发。
2.行列并存
第1点,行列并存的核心能力是hologres 的核心共享能力,行业共存可以助力高性能的binlog消费,以及高性能的微表观点。hologres支持行列共存的表存储格式,即一张表可以同时存储一份行存数据和一份列存数据。下游只感知到一张表,可以用于多个场景。比如作为实数层的中间层,ods层或dwd层,可以生成binlog表存储的行列构成的方式来供flink进行高性能的binlog消费。本质上就是高性能的点查来完成实时数仓的分层。第2点是可以作为flink的尾表来实现高性能的实时检查,以此来完成高性能的维表办理完成dwd层表的实施构建。第3点,典型应用场景是所有的表,如果存储成了行列共存,不仅可以完成上述两种场景binlog消费,以及实时检查,这些表还都可以同时用于对接下游业务系统用作olap分析。以下是holo的三种表存储格式:包括行存,列存和行列共存,分别可以面向不同的场景。

3.hologres的资源能力
hlogres的资源能力是最重要的能力。它推出了计算组实力高级的、可以实现极致的负载隔离的一个架构架构图,如下图所示。

首先是一个弹性弹性的计算存储分离的格式。在存储层只有一份存储,在计算层,把一个实力分隔成不同的计算组,以此来实现计算之间的完全隔离。比如可以通过一份数计算组来实现离线写入,通过一份计算组来做实时写入,通过一份计算组来做olap查询,通过第四份计算组来做在线在线服务。整个架构共享一份存储,对于不同的计算组之间计算资源完全完全隔离,可以实现写写隔离、读写隔离、读读隔离等多种隔离方式。并且每一个计算组可以支持独立的弹性rop通融。
对于业务层的应用来说,使用统一的n的point来为下游提供服务。通过标准的c口接口,实现复载的自动录自动路由、自动切换,以此来实现极致的负载隔离。那么针对于hologres+flink搭建实时入仓的场景而言,就可以实现hologres写入使用一份计算组。binlog再使用另外一个计算组。对于业务的olap查询场景,在线服务场景,也可以分别使用不同的计算组来承载以此实现极致的负载隔离。
四、基于Flink Ctalog 的Streaming Warehouse实践
1.典型的电商场景

典型的电商平台Streaming Warehouse构建好的架构。电商平台的数据源存储在mycql,包括orders订单表、orderspay支付表以及product catalog商品信息三张表。
首先通过flink的catalog功能,将mycql整个的数据实时同步到hologres中,形成ods层。
第二步,通过flink的多流效应以及维表关联能力,将ods层的三张表实时打翻,形成dwg层写入到hotogres。
第三步,通过flink的实施指标计算,实施聚合能力,实时聚合,Orders表中的不同维度,形成dws层写入hologres。DWS层可以直接为下游用户特征推荐系统提供服务。
第四步,统计信息查询的运营需求可以通过Dwd层的管理hologres表来承担。
2.ODS实时同步

首先第一步是ods层的实时同步能力。业务将存储订单支付和商品信息三张表,通过flink 的catalog功能,可以直接将mysql整库实时同步到中形成ods。右边的c口,只需要通过在flink中创建flink catalog后通过crazytabase as语句,即可将mysql 整库同步到hologres 中,整个操作步骤简化,数据同步效率极度提升。

在ods同步的场景中,有很多功能是hologres +flink 共建的,非常的易用。
2.1对于表结构变更,支持自动同步
通过flink catalog,就可以实现原数据的自动发现和管理,再配合great table as的语法,实现数据的同步和表结构自动变更,同时支持读取数据的变更以及表结构的问题变更并且实时同步到下游的Hologres表中,并且数据和表结构的变更都可以保证顺序。
2.2整库同步
对于业务业界的整个同步能力而言,在以前有明显的缺点,一是整库同步需要浪费很多资源;二是会对于上游的数据库产生比较大的压力。而hologres 加blink,可以通过great database as语法配合catolog来实现不同步功能解决了传统整库同步能力带来的诸多问题。
2.3分库分表合并同步。

传统数据库通常为了解决数据量较大的难题时,会选择进行分库分表操作。对于实时入仓hologres而言,只需要把数据存储到同一张表中,依托于hologres的强大的mpp架构,就可以实现对于下游的在线分析在线查询。阿里云flink实现了对于原表、分表合并同步的核心,只需要通过create tables语法以及对于原表的正则表达式,就可以将原表的数据库的分库分表高效的合并同步到下游的hologres出仓中。
3.DWD实时构建

当时数据实时写入ODS层后,hologres表中新生成Binlog的flink 来读取hologres ods 层binlog,并且采用多流合并、维表关联等等方式,把订单交易商品三张表打成一个大宽表,并且实时写入hologres的dwd层形成订单汇总表。
具体c口通过greatable 语句形成dwd表的创建是通过flink c口中两个insert语句可以实现多流合并和维表关联。
3.1 orders表的实施打宽
通过和商品表的维表关联,形成实时打宽的能力。
3.2写入交易相关的信息
对于insert语句,最重要的本质上的能力就是每一个Insert语句都是对于DWDoders 这张表的局部更新,通过两个局部更新语句,最终将hologres 的bwd orders这张表实时打宽,形成订单汇总表的构件。DWD层实时打宽的能力中,其中很重要的一步是多流合并。

对于传统的多流合并的能力,通过flink +kafka来实现的多流交易能力无法使用维表关联的方式,成本非常高,非常复杂,需要将多流使用flink的多流join把结果写到卡kafka或者Date hup中,再通过复印的加工一层形成ads或dws层供下游服务。
但是对于blink+hologres 的方案,可以依托于holo的强大的局部更新,也就是部分列更新的能力。把多张流同时写入到holo的打宽表中。同时针对于维表也在这个过程中实现维表关联,每条流只是更新HOLO大宽表的部分分裂,形成实时宽表,从而来简化操作,同时节约计算成本。
dwd层实施构建Hologres做到这样高的性能的实时写入与更新依托于Hologres的一个高级功能:fixplan。传统的Holo引擎,针对于一条c口是需要经过优化器生产执行计划,经过协调器,查询引擎、存储引擎等多个组件,最终完成了c口的执行。但如果使用了fixplan,则可以绕过优化器、协调器等多个组件直接使用固定的plan来实现数据的高性能实时写入与更新。这个功能也有测试结果作为参考,如下图。

针对于open only写入无主键表的场景、隐私写入有主见表的场景、两种数据更新场景。几乎都可以达到近百万,甚至是2百万的rps,这依托于fix plan功能。这可以实现对于数据的高性能实施写入与更新,从而完成DWD层的实时构建。
4.DWS层的实时聚合

当构件完成DWD层后再次生成HologresBinlog,通过flank读取hologres的Dwd层的binlog数据来进行实时指标的聚合计算。比如可以形成用户维度的聚合表,也可以形成商户维度的聚合表等,取决于业务需求。最终把每一个维度的聚合表,分别写入到Hologres的dws层的表中,形成实时聚合表。整个c口如图所示,首先我们可以再通flink c口就可以完成两个聚合表的创建,再通过flink cql执行写入。
在写入过程中,完成聚合计算,即可以完成整个 dws层的构件。
5.应用

当整个数据的分层和加工完成之后,业务可以通过hologres查询数据,并且应用到业务层。业务可以直接查询dwd层的数据,如图内场景6的C口。对于宽表数据来展示实时报表统计最近30天每个品类的订单总量、退单总量等信息,可以通过直接查询层的明细表来明细拍表来实现。同样,对于下游有一些在线服务的场景,比如根据用户特征来推荐商品,本质上是对dws users这张表的一次点检查。再比如根据商铺特征推荐商品这样的场景可以直接查询dws层的hologres 表来提供百万级的qps查询。
五、典型客户案列
三七手游是holo使用flink+hologres 搭建实时数仓的典型客户。通过Hologres 完成了整个实时数仓的架构升级,实现统一数据平台。在使用flink+hologres 前的架构如图所示。

1. 构建缺点
通过flink数据原则,数据经过flink +kafka收藏搭建方式来形成实时数仓分层。其次,将实时数据通过flink写入到数据仓库和数据服务中来形成离线收藏的搭建。当实时数仓和离线数仓搭建完成之后,针对于下游的不同业务需求,使用不同的开源引擎进行服务。对于进行查询的需求,通过impala对接报表。对于交互式分析大屏而言可以使用hologres来完成报表分析。对于一些实时分析实时查询的需求,通过Doris来做话下分析。这样的架构非常复杂且割裂。主要缺点包括两个方面:第一个方面是1t2链路非常复杂,开元flink 缺少以smart evolution能力,当上游的数据源的表结构发生变更,每次变更需要重启blank任务,运维操作复杂。其次,对于数据湖而言,估计的查询性能有待提升,客户需要额外使用,presso来做加速等一个链路非常冗余。第二方面是OLAP架构冗余查询缓慢。整个架构里的OLAP组件非常多,需要开发在不同的c口之间切换,整个操作非常繁琐。且这些开源的OLAP屏查询引擎技能,很难满足日益增长的业务需求。第三方面是整个架构系统非常多,每不同的系统会带来不同的存储,整个存储方面冗余,成本显著增加。造成整个架构非常复杂,运维非常困难。使用Hologre +Flink+max构建出了实时离线一体化的收藏架构后,客户的痛点得到了极大的满足。
2. 计划后的架构及优势

如上图中左下角所示,实时数仓使用的是Flink+Hologres 形成的实时数仓分层。关于离线数仓,通过Date or+maxcom cute离线数据完成时实时数仓分层,在实时数仓和离线数仓之间,可以通过Holo,像xcompute写入数据来实现离线数据归档,也可以通过max -compute,如Hologres来完成对于实时数据的修正,holo也可以直接对接max -compute来实现数据的加速查询和联邦查询,holdress作为一款统一数仓出口,为下游的数据分析提供服务。这样的架构带来了明显的业务收益。
首先整个数据处理链路是写入即可见的。百万级的数据更新,可以实现毫秒级的延时,业务的时效性得到了显著提升。
第二,阿里云的flink+hologres 可以加速,可以提供完整的study的能力。上游数据发生了表结构的变更,不需要重启flink作业,可以显著降低开发和运维管理难度。
第三,在实数链路中,flink直接读取hologres binlog,以此替换kafka,可以减少数据的流转。
第四,作为统一数据服务出口来提供服务查询毫秒级延时,相比flicos性能提升超过100%,在教育场景,性能快了10倍,整个架构更加简化、更加灵活,运维变得更加简单,业务更加敏捷。
三七手游将整个架构应用于很多业务场景,包括但不限于买量优化、报表分析、精细化运营、用户画像分析、智能诊断等多种场景。

欢迎扫码加入Hologres 和 Flink钉钉交流群,购买59元Hologres 15000c位值计算资源抵扣包以及59元Flink计算资源抵扣包。