OneSQL OLAP实践问题之Flink SQL Gateway的功能如何解决

简介: OneSQL OLAP实践问题之Flink SQL Gateway的功能如何解决

问题一:在 Onesql OLAP 分析平台的查询流程中,Flink SQL Gateway 扮演了什么角色?


在 Onesql OLAP 分析平台的查询流程中,Flink SQL Gateway 扮演了什么角色?


参考回答:

"在 Onesql OLAP 分析平台的查询流程中,Flink SQL Gateway 负责接收从 OneSQL 后端转发来的 SQL 查询,提交这些查询到 Flink Session 集群上执行,并获取查询任务的执行进度返回给 Hue 页面,最终将查询结果也返回给 Hue 页面。

"


关于本问题的更多问答可点击原文查看:

https://developer.aliyun.com/ask/666313


问题二:实时数据仓库在 ABTest 业务中的主要作用是什么?


实时数据仓库在 ABTest 业务中的主要作用是什么?


参考回答:

"实时数据仓库在 ABTest 业务中的主要作用是处理用户的原始行为日志数据。这些数据经过 Flink 任务聚合后生成用户明细数据,再与维表数据进行流维表 JOIN,最终输出到 ClickHouse 生成多维明细宽表。这些多维明细宽表按照不同维度汇总后,应用于不同的业务场景。


关于本问题的更多问答可点击原文查看:

https://developer.aliyun.com/ask/666314


问题三:"通过实时数据仓库改造 ABTest 业务带来了哪些主要优势?


"通过实时数据仓库改造 ABTest 业务带来了哪些主要优势?


参考回答:

"通过实时数据仓库改造 ABTest 业务,将该业务的结果指标的生成时间提前了 8 个小时,同时减少了使用资源一倍以上,显著提高了业务效率并降低了资源消耗。


关于本问题的更多问答可点击原文查看:

https://developer.aliyun.com/ask/666315


问题四:未来规划中对 Flink OLAP 分析平台的完善包括哪些方面?


未来规划中对 Flink OLAP 分析平台的完善包括哪些方面?


参考回答:

"未来规划中对 Flink OLAP 分析平台的完善主要包括两方面:一是完善 Hive SQL 语法支持,提升 SQL 兼容性;二是解决计算过程中出现的 JOIN 数据倾斜问题,优化查询性能。


关于本问题的更多问答可点击原文查看:

https://developer.aliyun.com/ask/666316


问题五:为什么要在实时数仓建设中引入数据湖技术?


为什么要在实时数仓建设中引入数据湖技术?


参考回答:

在实时数仓建设中引入数据湖技术是为了解决实时数仓中任务数据的可重跑回溯范围小的问题。数据湖技术可以提供更大的数据存储能力和更灵活的数据访问方式,从而扩大数据的可重跑回溯范围。


关于本问题的更多问答可点击原文查看:

https://developer.aliyun.com/ask/666317

相关实践学习
基于Hologres+Flink搭建GitHub实时数据大屏
通过使用Flink、Hologres构建实时数仓,并通过Hologres对接BI分析工具(以DataV为例),实现海量数据实时分析.
实时计算 Flink 实战课程
如何使用实时计算 Flink 搞定数据处理难题?实时计算 Flink 极客训练营产品、技术专家齐上阵,从开源 Flink功能介绍到实时计算 Flink 优势详解,现场实操,5天即可上手! 欢迎开通实时计算 Flink 版: https://cn.aliyun.com/product/bigdata/sc Flink Forward Asia 介绍: Flink Forward 是由 Apache 官方授权,Apache Flink Community China 支持的会议,通过参会不仅可以了解到 Flink 社区的最新动态和发展计划,还可以了解到国内外一线大厂围绕 Flink 生态的生产实践经验,是 Flink 开发者和使用者不可错过的盛会。 去年经过品牌升级后的 Flink Forward Asia 吸引了超过2000人线下参与,一举成为国内最大的 Apache 顶级项目会议。结合2020年的特殊情况,Flink Forward Asia 2020 将在12月26日以线上峰会的形式与大家见面。
相关文章
|
SQL 人工智能 JSON
Flink 2.1 SQL:解锁实时数据与AI集成,实现可扩展流处理
简介:本文整理自阿里云高级技术专家李麟在Flink Forward Asia 2025新加坡站的分享,介绍了Flink 2.1 SQL在实时数据处理与AI融合方面的关键进展,包括AI函数集成、Join优化及未来发展方向,助力构建高效实时AI管道。
1434 43
|
SQL 人工智能 JSON
Flink 2.1 SQL:解锁实时数据与AI集成,实现可扩展流处理
本文整理自阿里云的高级技术专家、Apache Flink PMC 成员李麟老师在 Flink Forward Asia 2025 新加坡[1]站 —— 实时 AI 专场中的分享。将带来关于 Flink 2.1 版本中 SQL 在实时数据处理和 AI 方面进展的话题。
733 0
Flink 2.1 SQL:解锁实时数据与AI集成,实现可扩展流处理
|
SQL 分布式计算 DataWorks
破界·融合·进化:解码DataWorks与Hologres的湖仓一体实践
基于阿里云DataWorks与实时数仓Hologres,提供统一的大数据开发治理平台与全链路实时分析能力。DataWorks支持多行业数据集成与管理,Hologres实现海量数据的实时写入与高性能查询分析,二者深度融合,助力企业构建高效、实时的数据驱动决策体系,加速数字化升级。
|
SQL Java 关系型数据库
在 RDB 上跑 SQL------SPL 轻量级多源混算实践 1
SPL 支持通过 JDBC 连接 RDB,可动态生成 SQL 并传参,适用于 Java 与 SQL 结合的各类场景。本文以 MySQL 为例,演示如何配置数据库连接、编写 SPL 脚本查询 2024 年订单数据,并支持参数过滤和 SQL 混合计算。脚本可在 IDE 直接执行或集成至 Java 应用调用。
|
存储 SQL 运维
中国联通网络资源湖仓一体应用实践
本文分享了中国联通技术专家李晓昱在Flink Forward Asia 2024上的演讲,介绍如何借助Flink+Paimon湖仓一体架构解决传统数仓处理百亿级数据的瓶颈。内容涵盖网络资源中心概况、现有挑战、新架构设计及实施效果。新方案实现了数据一致性100%,同步延迟从3小时降至3分钟,存储成本降低50%,为通信行业提供了高效的数据管理范例。未来将深化流式数仓与智能运维融合,推动数字化升级。
912 0
中国联通网络资源湖仓一体应用实践
|
SQL 关系型数据库 Java
SQL 移植--SPL 轻量级多源混算实践 7
不同数据库的 SQL 语法存在差异,尤其是函数写法不同,导致 SQL 移植困难。SPL 提供 sqltranslate 函数,可将标准 SQL 转换为特定数据库语法,实现 SQL 语句在不同数据库间的无缝迁移,支持多种数据库函数映射与自定义扩展。
|
SQL 存储 运维
Apache Doris 在菜鸟的大规模湖仓业务场景落地实践
本文介绍了 Apache Doris 在菜鸟的大规模落地的实践经验,菜鸟为什么选择 Doris,以及 Doris 如何在菜鸟从 0 开始,一步步的验证、落地,到如今上万核的规模,服务于各个业务线,Doris 已然成为菜鸟 OLAP 数据分析的最优选型。
809 2
Apache Doris 在菜鸟的大规模湖仓业务场景落地实践
|
SQL 消息中间件 Kafka
Flink SQL 详解:流批一体处理的强大工具
Flink SQL 是 Apache Flink 提供的 SQL 引擎,支持流批一体处理,统一操作流数据与批数据,具备高性能、低延迟、丰富数据源支持及标准 SQL 兼容性,适用于实时与离线数据分析。
1398 1
|
存储 消息中间件 Java
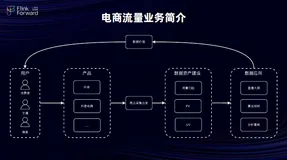
抖音集团电商流量实时数仓建设实践
本文基于抖音集团电商数据工程师姚遥在Flink Forward Asia 2024的分享,围绕电商流量数据处理展开。内容涵盖业务挑战、电商流量建模架构、流批一体实践、大流量任务调优及总结展望五个部分。通过数据建模与优化,实现效率、质量、成本和稳定性全面提升,数据质量达99%以上,任务性能提升70%。未来将聚焦自动化、低代码化与成本优化,探索更高效的流批一体化方案。
1013 12
抖音集团电商流量实时数仓建设实践