FlinkSQL

简介: FlinkSQL自制脑图,主要为大家介绍了迅速入门并掌握 FlinkSQL 的技巧,包含FlinkSQL出现的背景介绍以及与 Table API 的区别,API调用方式更是介绍的非常详细全面,Flink SQL 是 Flink 实时计算为简化计算模型,降低用户使用实时计算门槛而设计的一套符合标准 SQL 语义的开发语言。

FlinkSQL自制脑图,
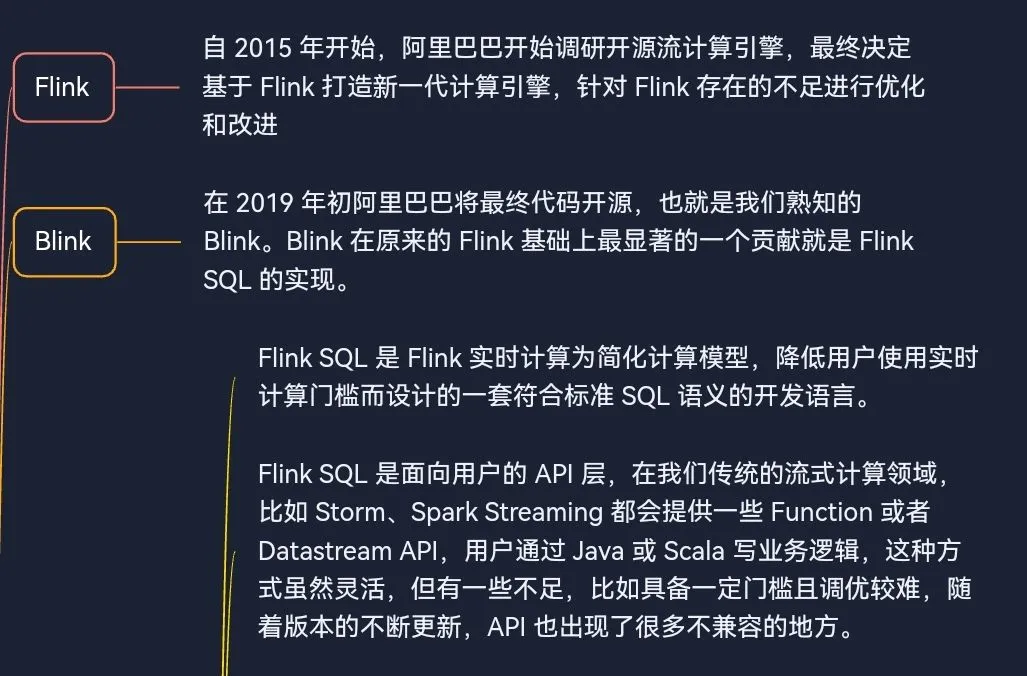
Flink SQL 是 Flink 实时计算为简化计算模型,降低用户使用实时计算门槛而设计的一套符合标准 SQL 语义的开发语言。
Flink SQL 是面向用户的 API 层,在我们传统的流式计算领域,比如 Storm、Spark Streaming 都会提供一些 Function 或者 Datastream API,用户通过 Java 或 Scala 写业务逻辑,这种方式虽然灵活,但有一些不足,比如具备一定门槛且调优较难,随着版本的不断更新,API 也出现了很多不兼容的地方。
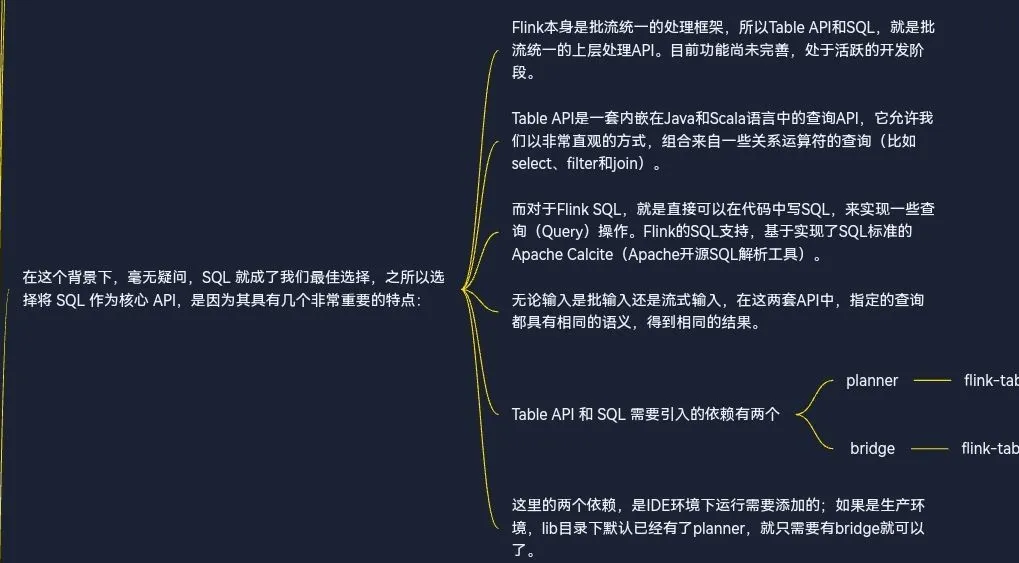
Flink本身是批流统一的处理框架,所以Table API和SQL,就是批流统一的上层处理API。目前功能尚未完善,处于活跃的开发阶段。
Table API是一套内嵌在Java和Scala语言中的查询API,它允许我们以非常直观的方式,组合来自一些关系运算符的查询(比如select、filter和join)。
而对于Flink SQL,就是直接可以在代码中写SQL,来实现一些查询(Query)操作。Flink的SQL支持,基于实现了SQL标准的Apache Calcite(Apache开源SQL解析工具)。
无论输入是批输入还是流式输入,在这两套API中,指定的查询都具有相同的语义,得到相同的结果。
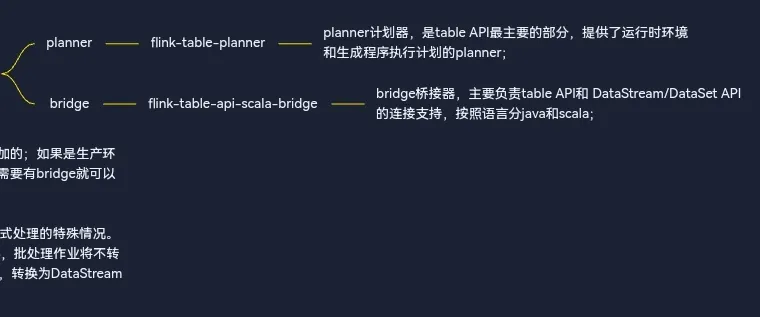
Table API 和 SQL 需要引入的依赖有两个:
planner——flink-table-planner——planner计划器,是table API最主要的部分,提供了运行时环境和生成程序执行计划的planner
bridge——flink-table-api-scala-bridge——bridge桥接器,主要负责table API和 DataStream/DataSet API的连接支持,按照语言分java和scala;
这里的两个依赖,是IDE环境下运行需要添加的;如果是生产环境,lib目录下默认已经有了planner,就只需要有bridge就可以了。
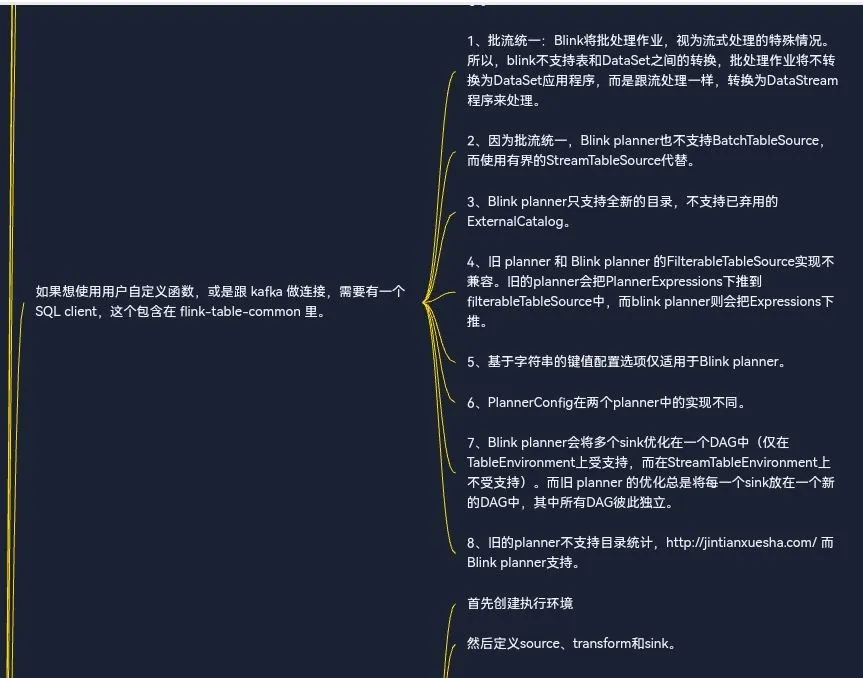
如果想使用用户自定义函数,或是跟 kafka 做连接,需要有一个SQL client,这个包含在 flink-table-common 里。
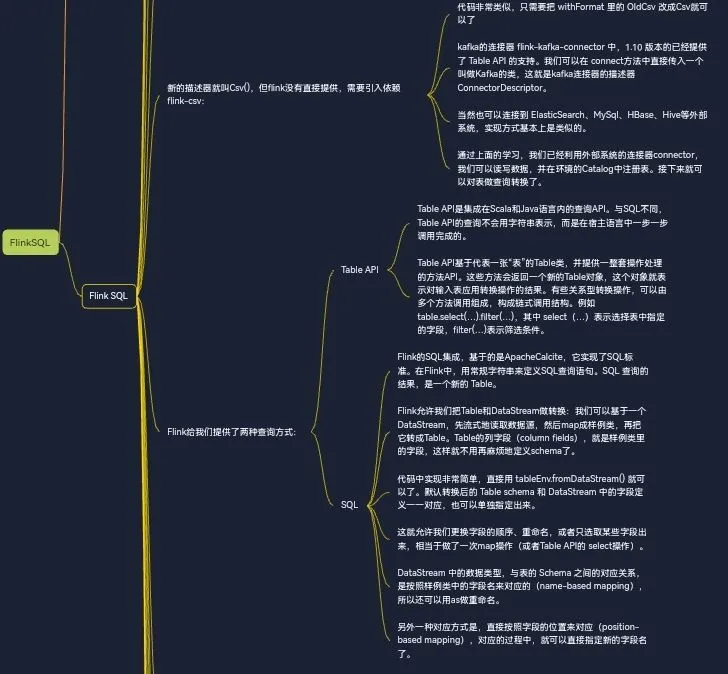
Flink给我们提供了两种查询方式:Table API和SQL。
Table API是集成在Scala和Java语言内的查询API。与SQL不同,Table API的查询不会用字符串表示,而是在宿主语言中一步一步调用完成的。
Flink的SQL集成,基于的是ApacheCalcite,它实现了SQL标准。在Flink中,用常规字符串来定义SQL查询语句。SQL 查询的结果,是一个新的 Table。
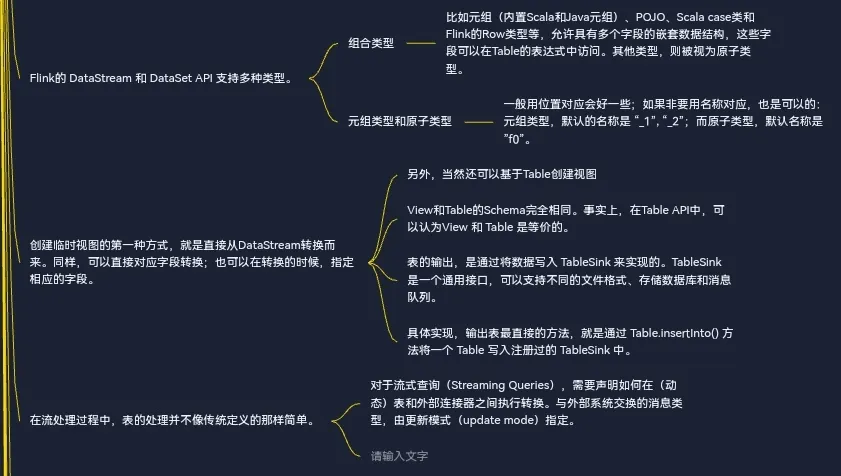
Flink的 DataStream 和 DataSet API 支持多种类型。组合类型、元组类型和原子类型。
比如元组(内置Scala和Java元组)、POJO、Scala case类和Flink的Row类型等,允许具有多个字段的嵌套数据结构,这些字段可以在Table的表达式中访问。其他类型,则被视为原子类型。
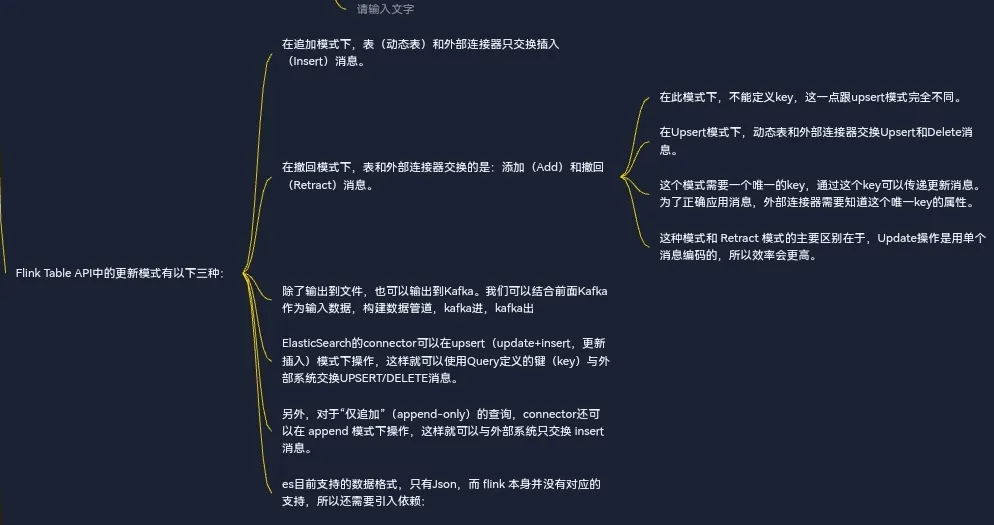
对于流式查询(Streaming Queries),需要声明如何在(动态)表和外部连接器之间执行转换。与外部系统交换的消息类型,由更新模式(update mode)指定。
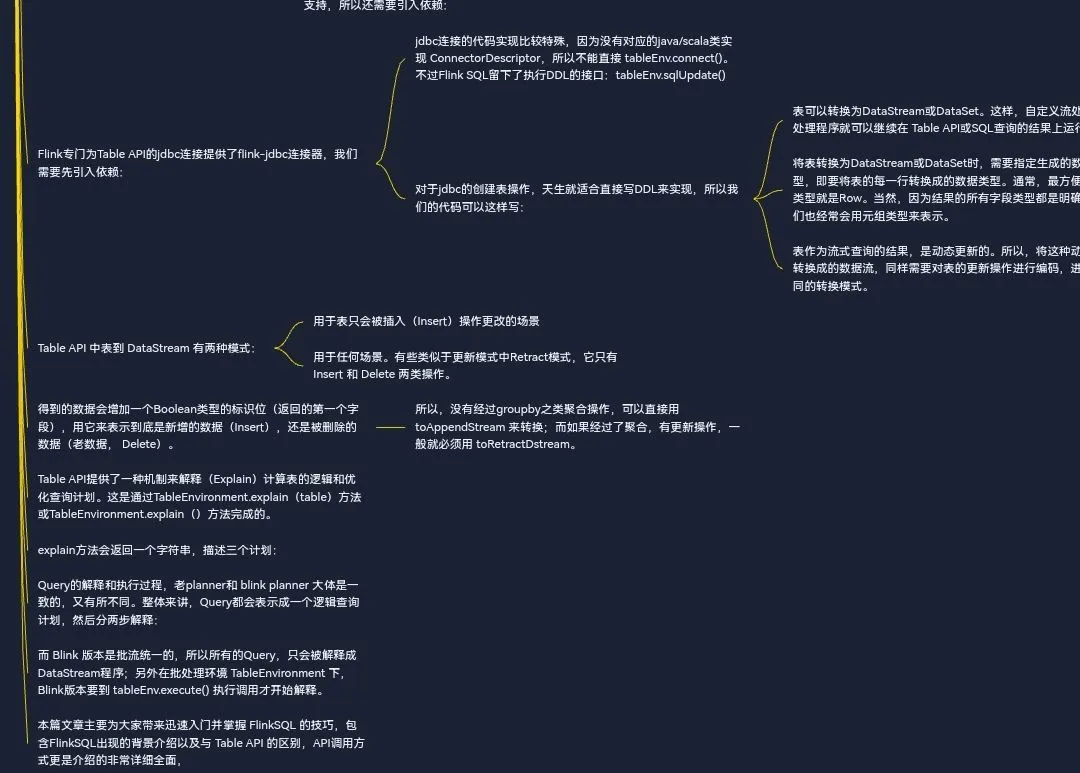
Flink专门为Table API的jdbc连接提供了flink-jdbc连接器,我们需要先引入依赖:jdbc连接的代码实现比较特殊,因为没有对应的java/scala类实现 ConnectorDescriptor,所以不能直接 tableEnv.connect()。不过Flink SQL留下了执行DDL的接口:tableEnv.sqlUpdate()。
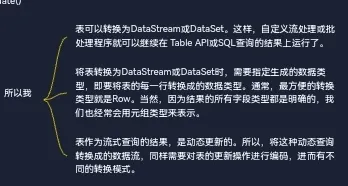
对于jdbc的创建表操作,天生就适合直接写DDL来实现,所以我们的代码可以这样写:表可以转换为DataStream或DataSet。这样,自定义流处理或批处理程序就可以继续在 Table API或SQL查询的结果上运行了。
将表转换为DataStream或DataSet时,需要指定生成的数据类型,即要将表的每一行转换成的数据类型。通常,最方便的转换类型就是Row。当然,因为结果的所有字段类型都是明确的,我们也经常会用元组类型来表示。
表作为流式查询的结果,是动态更新的。所以,将这种动态查询转换成的数据流,同样需要对表的更新操作进行编码,进而有不同的转换模式。
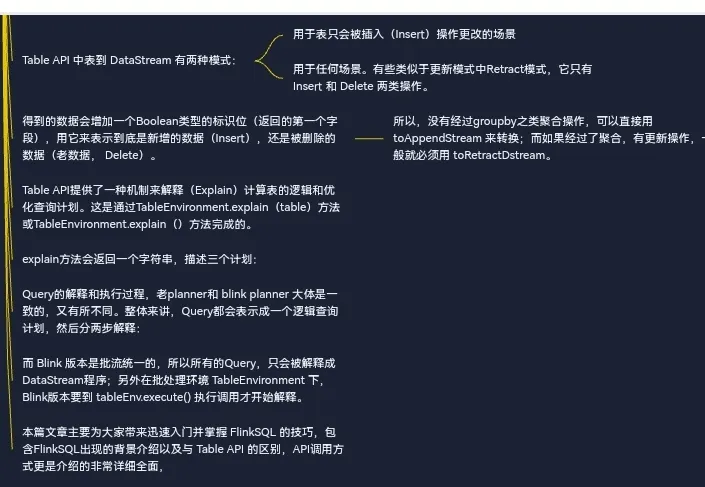
Table API 中表到 DataStream 有两种模式:用于表只会被插入(Insert)操作更改的场景,用于任何场景。有些类似于更新模式中Retract模式,它只有 Insert 和 Delete 两类操作。
Screenshot_20221214_151338_com.alibaba.android.rimet_edit_61729174689538.jpg
Screenshot_20221214_151408_com.alibaba.android.rimet_edit_61750959543701.jpg
Screenshot_20221214_151426_com.alibaba.android.rimet_edit_61767324201511.jpg
Screenshot_20221214_151434_com.alibaba.android.rimet_edit_61786919161925.jpg
Screenshot_20221214_151451_com.alibaba.android.rimet_edit_61807060579109.jpg
Screenshot_20221214_151456_com.alibaba.android.rimet_edit_61825596131711.jpg
Screenshot_20221214_151503_com.alibaba.android.rimet_edit_61849202087957.jpg
Screenshot_20221214_151511_com.alibaba.android.rimet_edit_61877759996286.jpg
Screenshot_20221214_151518_com.alibaba.android.rimet_edit_61900420336908.jpg
Screenshot_20221214_151543_com.alibaba.android.rimet_edit_61915633778572.jpg
Screenshot_20221214_151551_com.alibaba.android.rimet_edit_61940273524922.jpg
Screenshot_20221214_151557_com.alibaba.android.rimet_edit_61965698161377.jpg

相关实践学习
基于Hologres+Flink搭建GitHub实时数据大屏
通过使用Flink、Hologres构建实时数仓,并通过Hologres对接BI分析工具(以DataV为例),实现海量数据实时分析.
实时计算 Flink 实战课程
如何使用实时计算 Flink 搞定数据处理难题?实时计算 Flink 极客训练营产品、技术专家齐上阵,从开源 Flink功能介绍到实时计算 Flink 优势详解,现场实操,5天即可上手! 欢迎开通实时计算 Flink 版: https://cn.aliyun.com/product/bigdata/sc Flink Forward Asia 介绍: Flink Forward 是由 Apache 官方授权,Apache Flink Community China 支持的会议,通过参会不仅可以了解到 Flink 社区的最新动态和发展计划,还可以了解到国内外一线大厂围绕 Flink 生态的生产实践经验,是 Flink 开发者和使用者不可错过的盛会。 去年经过品牌升级后的 Flink Forward Asia 吸引了超过2000人线下参与,一举成为国内最大的 Apache 顶级项目会议。结合2020年的特殊情况,Flink Forward Asia 2020 将在12月26日以线上峰会的形式与大家见面。
相关文章
|
SQL 存储 API
Flink教程(20)- Flink高级特性(双流Join)
1817 0
|
SQL 大数据 数据处理
Flink SQL 详解:流批一体处理的强大工具
Flink SQL 是为应对传统数据处理框架中流批分离的问题而诞生的,它融合了SQL的简洁性和Flink的强大流批处理能力,降低了大数据处理门槛。其核心工作原理包括生成逻辑执行计划、查询优化和构建算子树,确保高效执行。Flink SQL 支持过滤、投影、聚合、连接和窗口等常用算子,实现了流批一体处理,极大提高了开发效率和代码复用性。通过统一的API和语法,Flink SQL 能够灵活应对实时和离线数据分析场景,为企业提供强大的数据处理能力。
2555 27
|
SQL 存储 大数据
Flink 基础详解:大数据处理的强大引擎
Apache Flink 是一个分布式流批一体化的开源平台,专为大规模数据处理设计。它支持实时流处理和批处理,具有高吞吐量、低延迟特性。Flink 提供统一的编程抽象,简化大数据应用开发,并在流处理方面表现卓越,广泛应用于实时监控、金融交易分析等场景。其架构包括 JobManager、TaskManager 和 Client,支持并行度、水位线、时间语义等基础属性。Flink 还提供了丰富的算子、状态管理和容错机制,如检查点和 Savepoint,确保作业的可靠性和一致性。此外,Flink 支持 SQL 查询和 CDC 功能,实现实时数据捕获与同步,广泛应用于数据仓库和实时数据分析领域。
11723 42
|
SQL 关系型数据库 Apache
从 Flink 到 Doris 的实时数据写入实践 —— 基于 Flink CDC 构建更实时高效的数据集成链路
本文将深入解析 Flink-Doris-Connector 三大典型场景中的设计与实现,并结合 Flink CDC 详细介绍了整库同步的解决方案,助力构建更加高效、稳定的实时数据处理体系。
4168 0
从 Flink 到 Doris 的实时数据写入实践 —— 基于 Flink CDC 构建更实时高效的数据集成链路
|
SQL 分布式计算 数据处理
FlinkSQL开发经验分享
FlinkSQL开发经验分享
770 8
|
SQL 消息中间件 Kafka
Flink SQL 详解:流批一体处理的强大工具
Flink SQL 是 Apache Flink 提供的 SQL 引擎,支持流批一体处理,统一操作流数据与批数据,具备高性能、低延迟、丰富数据源支持及标准 SQL 兼容性,适用于实时与离线数据分析。
1400 1
|
关系型数据库 API Apache
Flink CDC:基于 Apache Flink 的流式数据集成框架
本文整理自阿里云 Flink SQL 团队研发工程师于喜千(yux)在 SECon 全球软件工程技术大会中数据集成专场沙龙的分享。
24397 11
Flink CDC:基于 Apache Flink 的流式数据集成框架

热门文章

最新文章