【Python精彩案例】随拍文档转PDF扫描版
在需要扫描文件时,附近没有打印店怎么办?今天分享如何使用Python实现文档转pdf扫描。
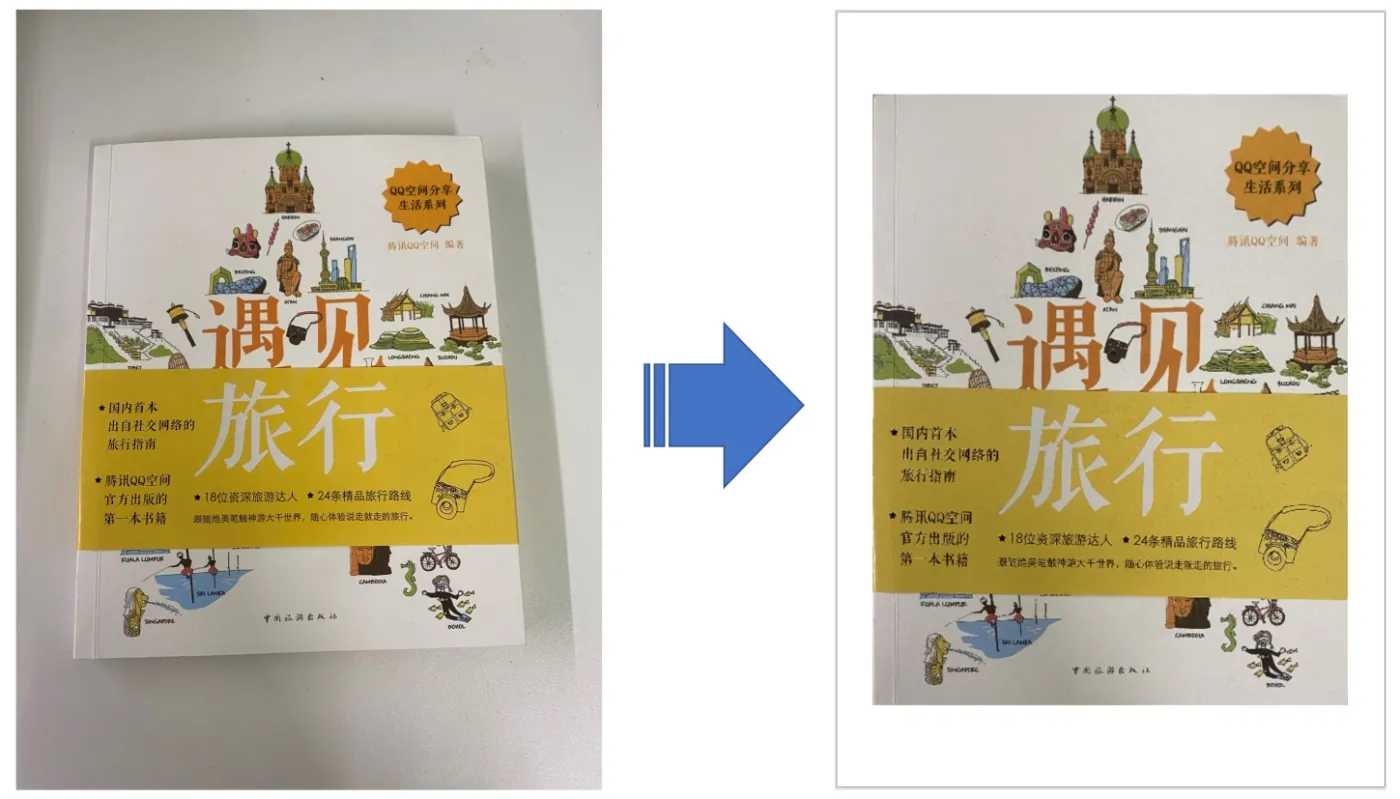
老规矩,在进入正文之前,咱们先看看最终效果:
1 文档矫正
如下图所示,手持相机拍摄出来的图片一般都是不标准的矩形。
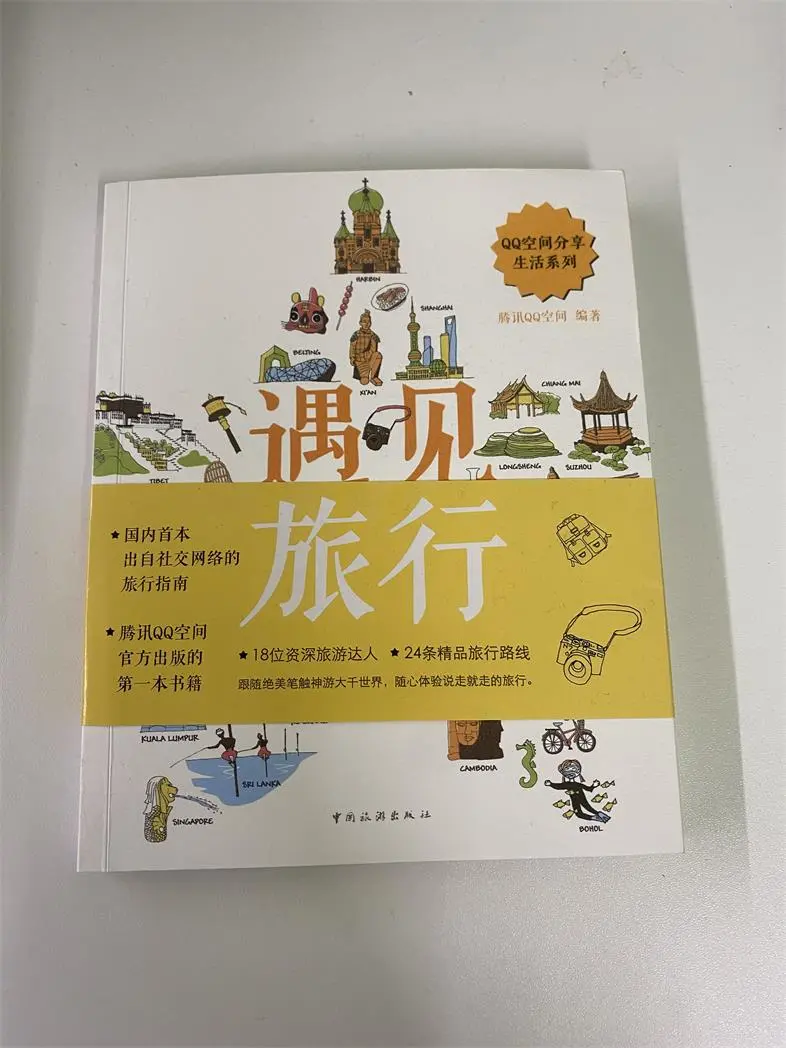
需要通过技术手段将其矫正为标准的矩形,通过透视投影变换可以将任意四边区域内容投影到另一个四边形区域。
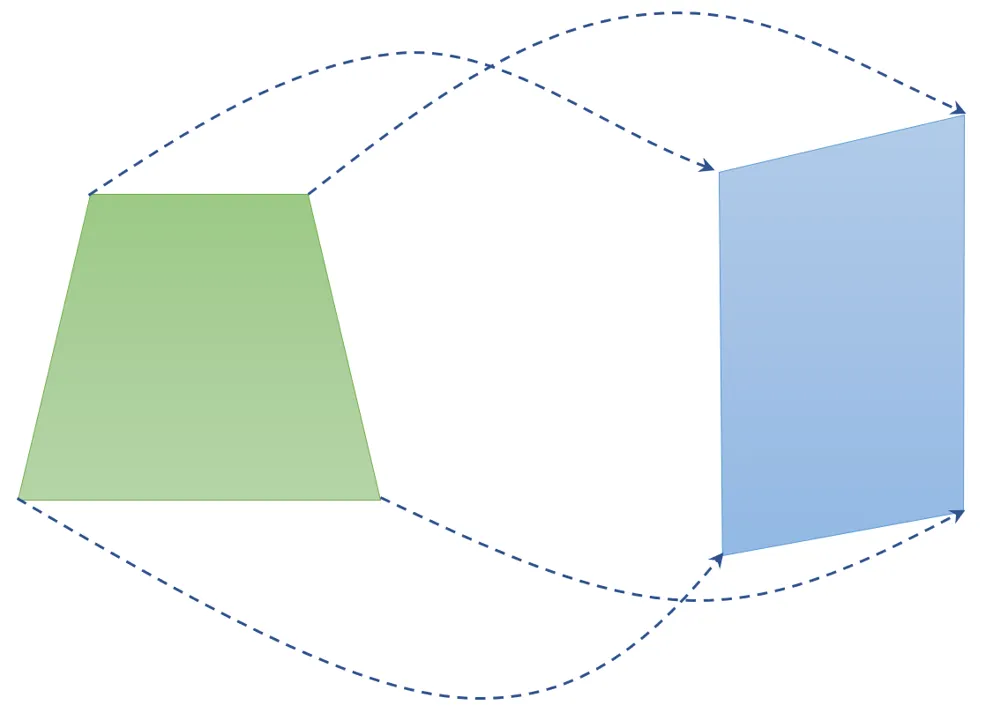
首先确定需要变换的4个点,然后确定投影后的4个点,可以得到一个变换矩阵,最后通过调用opencv的warpPerspective即可实现矫正。
投影后的四个点其实只需通过宽高即可确定,因为4个点位置为(0,0)、(w,0)、(w,h)、(0,h)。那么如何确定输入的4个点呢?这里简单写了个图片显示:
from matplotlib import pyplot as plt
def show_img(path):
    img = plt.imread(path)
    plt.imshow(img)
    plt.show()
鼠标移动到图像各个位置时,右下角会显示当前点坐标。如下图所示:
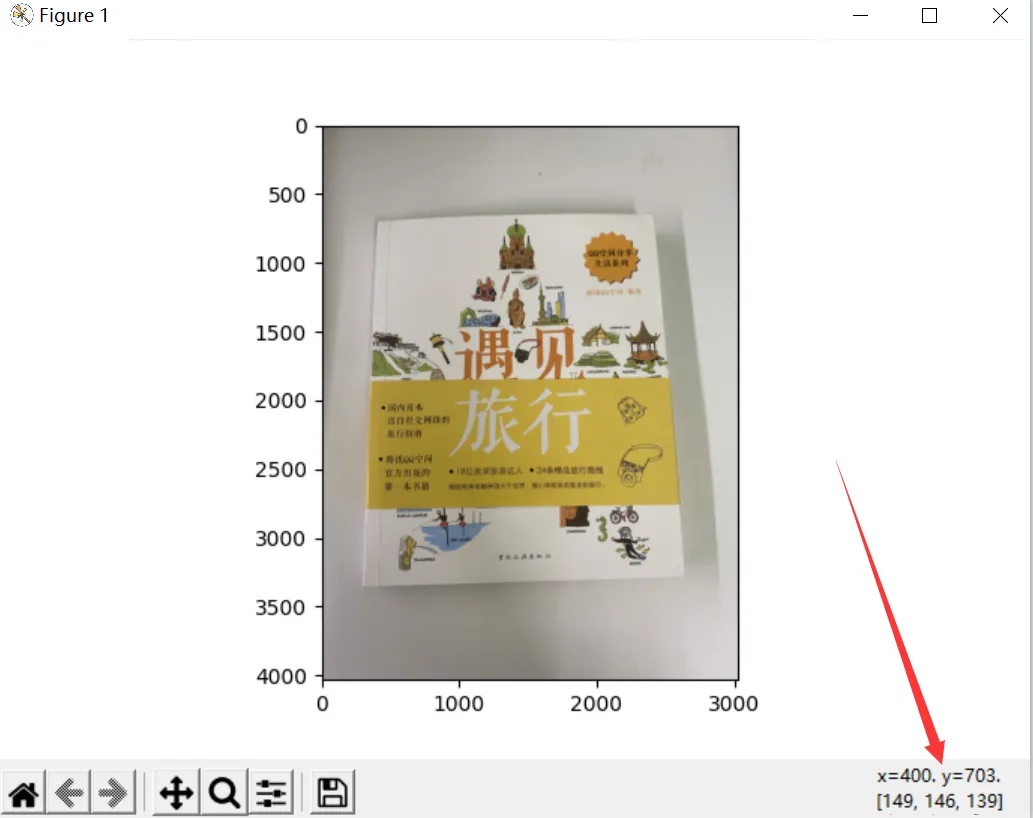
找到左上、右上、右下、左下四个点位置分别为[400, 703], [2384, 656], [2635, 3280], [294, 3357]。可以根据实际的文档宽高设置投影变换后的尺寸,这里设置为宽度为515, 高度为663。
def warp(src, dst, src_pts, dw, dh):
    img = cv2.imread(src)
    dst_w = int(dw)
    dst_h = int(dh)
    src_pts = np.float32(src_pts)
    dst_pts = np.float32([[0, 0], [dst_w, 0], [dst_w, dst_h], [0, dst_h]])
    M = cv2.getPerspectiveTransform(src_pts, dst_pts)
    img = cv2.warpPerspective(img, M, [dst_w, dst_h], flags=cv2.INTER_CUBIC)
    cv2.imwrite(dst, img)
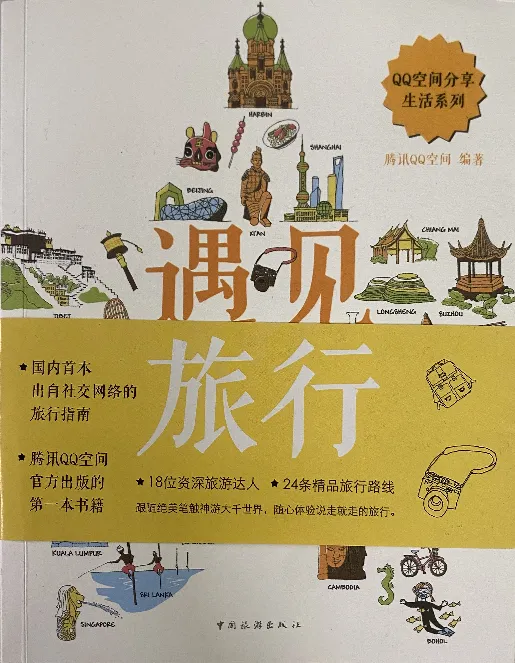
src, dst, src_pts, dw, dh分别表示输入图路径、矫正后图路径、原始四个点,目标宽高。将各个参数传入如上函数,得到矫正后图如下:
2 创建PDF文件并添加图片
有了矫正后的图片,接下来任务是创建PDF文件并将图片插入到PDF文件中。
2.1 创建PDF
首先通过pip install reportlab安装reportlab库。接下来创建PDF:
from reportlab.lib.pagesizes import A4
from reportlab.pdfgen import canvas
def create_pdf(filename, width_height=A4):
    cvs = canvas.Canvas(filename, pagesize=width_height)
    return cvs
reportlab.pdfgen生成PDF文件,将PDF看成是一个画板Canvas。Canvas可以指定页面的宽高。但需要注意,这里的宽高是以点为单位。关于点的单位换算如下:
1 inch = 72 点1 inch = 25.4 mm
因此,我们可以轻易得到毫米(mm)转点单位换算:
1 mm = 72/25.4 点
对于A4纸张,其宽高分别为210 mm和297 mm。当然了,reportlab已经提供了常用的尺寸如:
from reportlab.lib.pagesizes import A4
2.2 插入图片
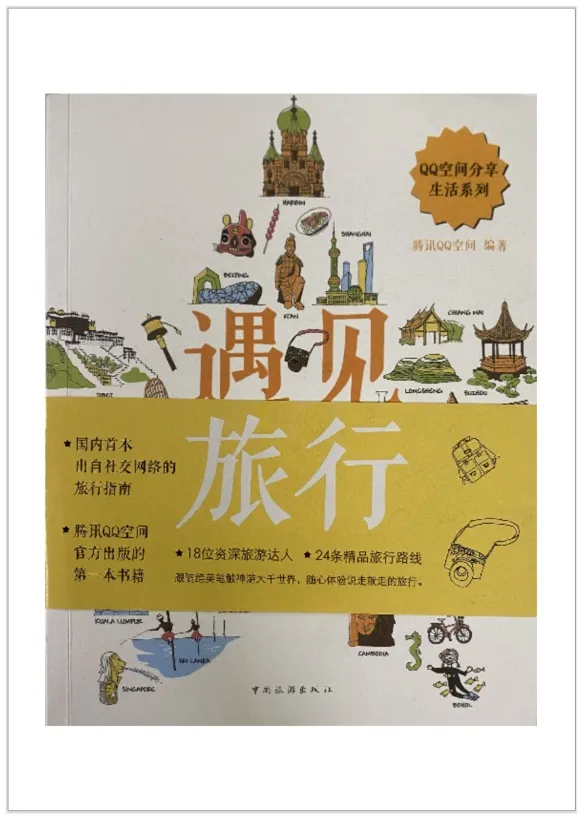
调用Canvas的drawImage函数实现图像插入。并最后通过save函数保存pdf文件
def insert_imgs(cvs, img_path, rect):
    x, y, w, h = rect
    cvs.drawImage(img_path, x, y, width=w, height=h)
    cvs.save()
2.3 其他功能
不仅仅是插入图片,对于插入文字,reportlab也是轻松可以实现:
cvs.drawString(x, y, "hello world")
创建新一页:
cvs.showPage()
调用showPage函数后,如果后面还有新的添加元素,则会开启新的一页,并添加到新的一页上。更多细节,可以参考https://www.reportlab.com/docs/reportlab-userguide.pdf
完整代码关注【Python学习实战】公众号,回复2202获取完整的代码。