5.0 把数字字段的索引结构换成 BKD tree。迁移文档说磁盘占用预计更少、范围查询预计更快,代价是数字字段上的
term查询不再有文档频率的贡献,一律返回常量分。读 v5.6.16 源码能补上文档没写的一条:这个变化只发生在 5.0.0-alpha2 及之后创建的索引上,老索引沿用旧结构,升级后分数不会变,要等重建索引才会变。
说明
来源和边界先交代:本文的依据出自 v5.6.16 标签下的官方文件(mapping.asciidoc、LegacyNumberFieldMapper.java、NumberFieldMapper.java),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
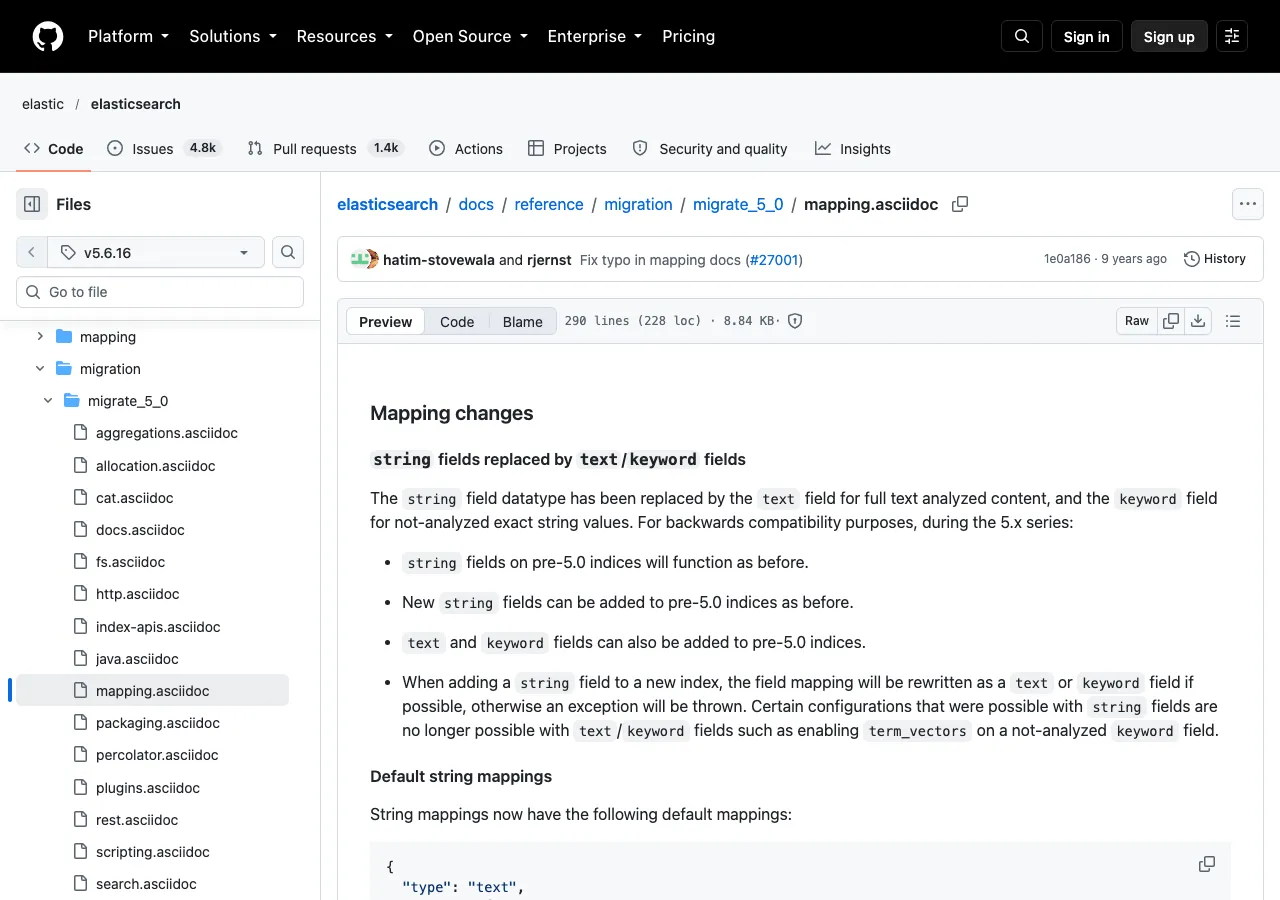
图 1:官方文件 mapping.asciidoc(v5.6.16 标签)。来源:GitHub elastic/elasticsearch v5.6.16 mapping.asciidoc
官方说明
5.0 迁移文档(migrate_5_0/mapping.asciidoc 第 39–77 行)的原文:
Numeric fields are now indexed with a completely different data-structure, called BKD tree, that is expected to require less disk space and be faster for range queries than the previous way that numerics were indexed.
Term queries will return constant scores now, while they used to return higher scores for rare terms due to the contribution of the document frequency, which this new BKD structure does not record. If scoring is needed, then it is advised to map the numeric fields as
keywords too.
文档用的是 "expected to",没有给磁盘占用或查询耗时的数字,本文也不编数字。同一节还有一句:precision_step 参数现在不再有意义,在 5.0 及以后创建的索引上会被拒绝。
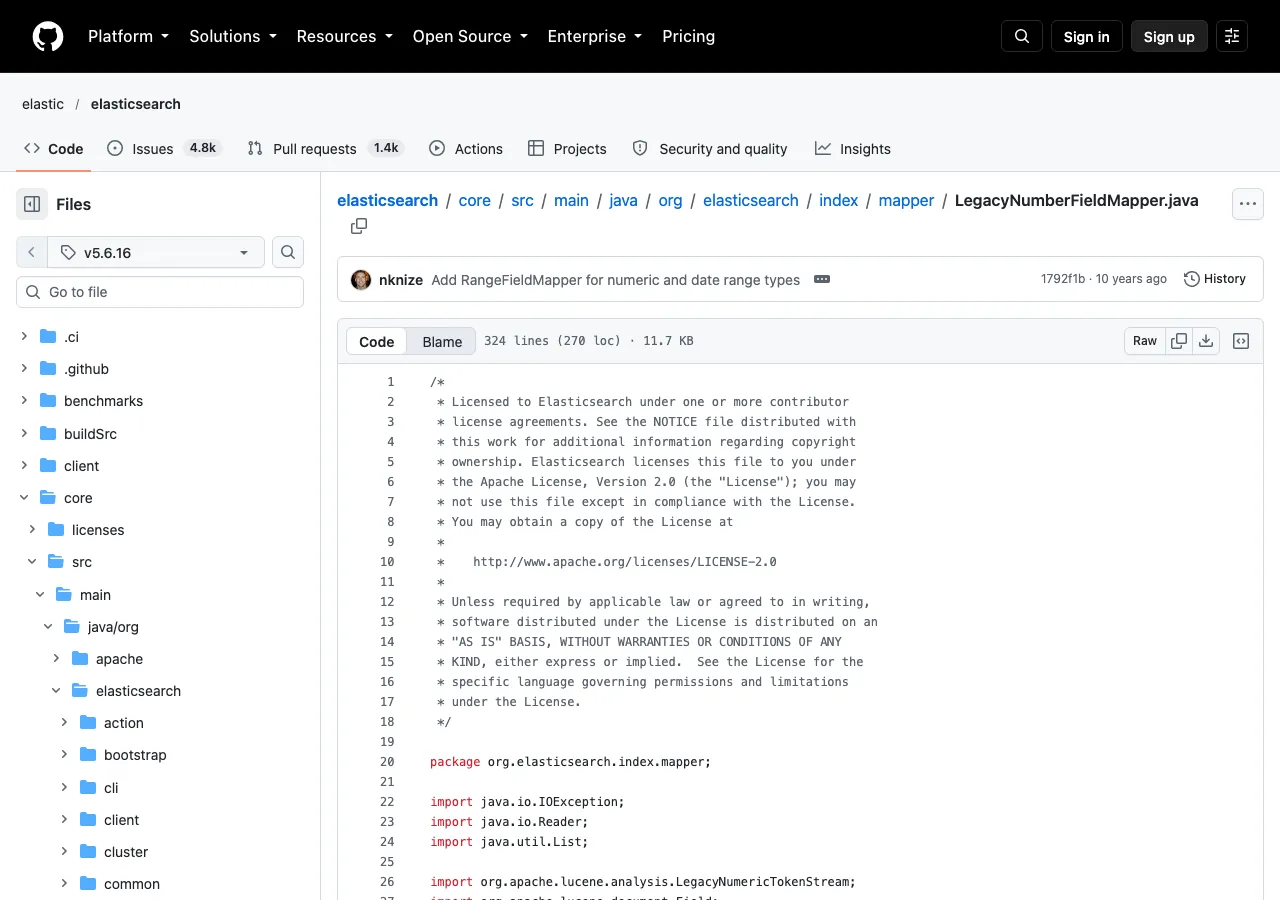
图 2:官方文件 LegacyNumberFieldMapper.java(v5.6.16 标签)。来源:GitHub elastic/elasticsearch v5.6.16 LegacyNumberFieldMapper.java
换了什么
旧实现按 precision_step 把一个数值拆成多个不同精度的前缀词项写进倒排索引。默认的步长在 LegacyNumberFieldMapper 第 51–54 行:8 位类型是 Integer.MAX_VALUE,16 位和 32 位是 8,64 位是 16。所以数字的每个取值在倒排里都对应词项,有文档频率。
新实现在 NumberFieldMapper 里用 Lucene 的点(point)类型,例如 IntPoint、LongPoint、DoublePoint、HalfFloatPoint、FloatPoint。点不进倒排词典,没有词项,也就没有文档频率。
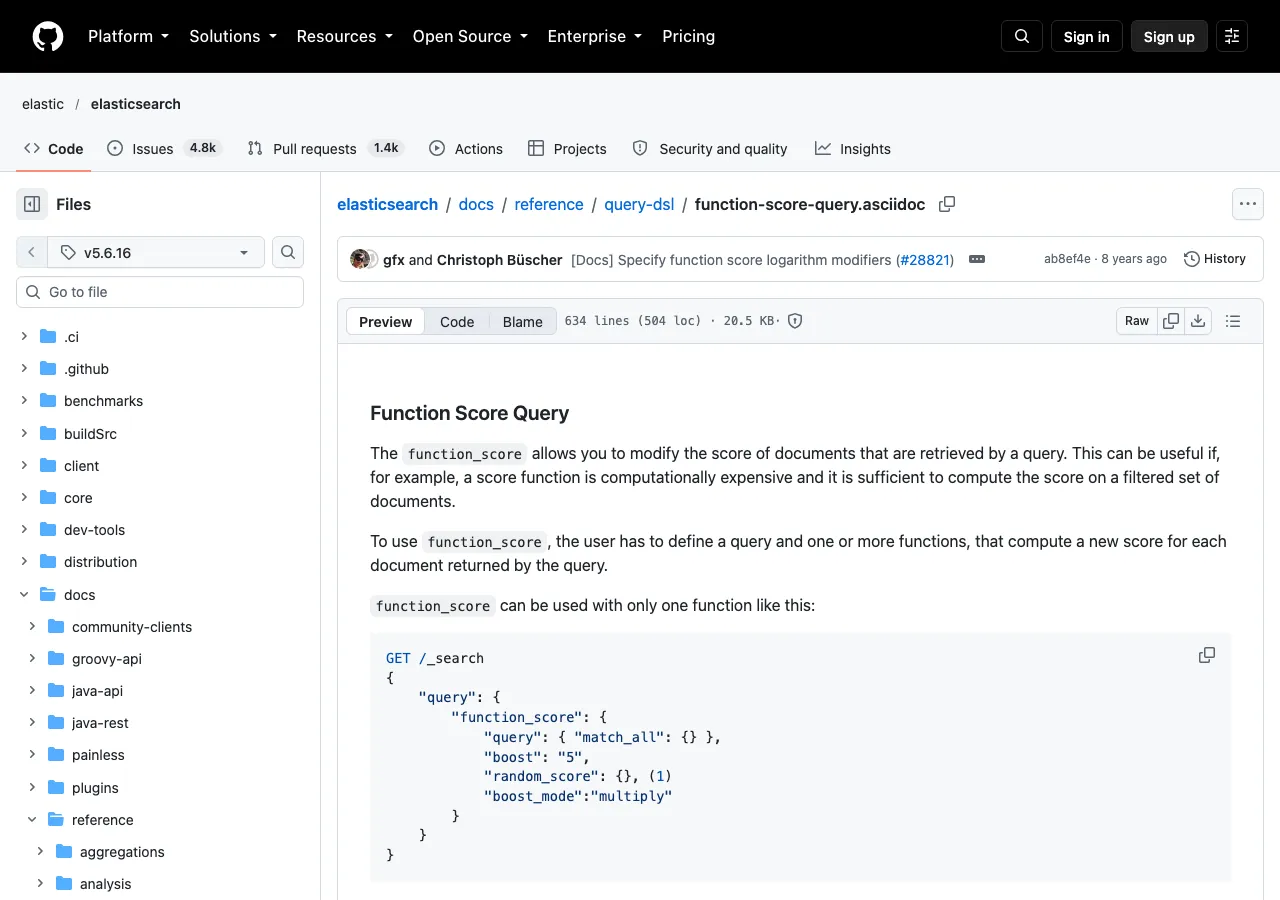
图 3:官方文件 function-score-query.asciidoc(v5.6.16 标签)。来源:GitHub elastic/elasticsearch v5.6.16 function-score-query.asciidoc
看索引创建版本
源码里选用哪种实现取决于索引的创建版本。NumberFieldMapper 第 136–140 行的 TypeParser.parse 开头:
if (parserContext.indexVersionCreated().before(Version.V_5_0_0_alpha2)) {

    switch (type) {

    case BYTE:
        return new LegacyByteFieldMapper.TypeParser().parse(name, node, parserContext);
    ...
创建版本早于 5.0.0-alpha2 的索引,数字字段仍然走 Legacy*FieldMapper,也就是旧的词项结构。所以这篇文章讲的变化有一个前提:
- 2.x 创建的索引升到 5.x,数字字段结构不变,
term查询的分数也不变; - 在 5.0.0-alpha2 及之后新建的索引,数字字段才是 BKD 结构,
term查询才是常量分; - 重建索引(reindex 到新索引)的时刻,才是分数变化真正发生的时刻。
这一点会影响排查顺序:升级当天结果排序没变化,不代表没有风险,风险推迟到了重建索引之后。同一个别名后面如果新老索引并存,同一个查询在两类索引上的分数会不一致,混排时尤其容易看出来。以上是读源码的推断,没有在集群上跑过。
打分上的影响
旧结构里数字的每个取值是一个词项,有文档频率,稀有值能拿到更高的 IDF 分。新结构不记录这个信息。看 NumberFieldMapper 第 604–609 行,integer 的 termQuery 返回的是 IntPoint.newExactQuery(field, v);long 在第 741–746 行同理,返回 LongPoint.newExactQuery。点查询是 Lucene 的 constant score 查询,没有 TF-IDF 的贡献。字段上配置了 boost 时,第 955–962 行的 termQuery 会用 BoostQuery 包一层,所以 boost 仍然有效,只是乘在常量上。
后果是:如果结果排序依赖"稀有数字值排前面"这种隐式 IDF 行为,在新建索引上排序会变平,表现为最相关的结果不再靠前。
match 查询落在数字字段上也是同样的结果。MatchQuery 第 290–292 行最终调用 fieldType.termQuery,数字字段的 termQuery 就是上面的点查询。这是读代码的推断,没有逐条验证。
官方给的解决方法
If scoring is needed, then it is advised to map the numeric fields as
keywords too.Note that this
keywordmapping do not need to replace the numeric mapping. For instance if you need both sorting and scoring on your numeric field, you could map it both as a number and akeywordusing multi-fields.
用多字段同时映射成数字和 keyword:
PUT my_index
{

  "mappings": {

    "my_type": {

      "properties": {

        "my_number": {

          "type": "long",
          "fields": {

            "keyword": {
    "type": "keyword" }
          }
        }
      }
    }
  }
}
这样 my_number 保留数字语义,范围查询、数值排序都用它;my_number.keyword 作为词项存在,需要按词项打分时查这个子字段。两者并存,不是二选一。
多数场景不用处理,要处理的是"靠 IDF 排序"的查询
数字字段上的查询大多是范围过滤(时间、价格、年龄区间)或精确匹配(status: 1、type: 3)。精确匹配本来不需要相关性,匹配就是匹配,固定分合理。范围查询在 filter context 里不计分,常量分和旧行为也没有差别。
真正会受影响的是少数用法:
- 靠数字
term的 IDF 做"稀有值优先"; - 多个数字
term用should组合,以前各子句的分不同,现在都是常量,组合后的相对顺序会变; - 数字字段参与
match,同样落到常量分。
遇到"重建索引后排序变平",先问这个字段是不是本来就不该参与算分。如果答案是应该,就加 keyword 子字段;如果只是想表达"值大更重要",用 function_score 显式写。
稀有值优先和 function_score 不是一回事
function_score 的 field_value_factor 用的是字段的数值本身(文档里 modifier 有 log1p、ln、sqrt 等),表达的是"值大排前面",不是"值稀有排前面":
{

  "query": {

    "function_score": {

      "query": {
    "match_all": {
   } },
      "field_value_factor": {
    "field": "price", "factor": 1.2, "modifier": "log1p" }
    }
  }
}
所以两种诉求要分开处理:想要"价格高的排前面",用 field_value_factor,意图写在查询里;想要真正的"稀有值得分更高",只能保留词项,也就是加 keyword 子字段,让它参与 TF-IDF。把后者改写成前者会改变语义。
怎么查、怎么改
第一步,找出哪些查询在数字字段上用 term 或 match。先拿到业务代码和保存的查询模板,按字段名人工筛选;字段名猜不准,最后要用 mapping 确认类型:
curl -s 'localhost:9200/my_index/_mapping?pretty' | grep -B1 -A1 -E '"type" : "(integer|long|short|byte|double|float|half_float|scaled_float)"'
第二步,确认索引的创建版本,判断它是不是 BKD 结构:
curl -s 'localhost:9200/my_index/_settings?pretty' | grep created
输出是数字形式的版本号,创建于 5.0.0-alpha2 之前的索引还是旧结构。
第三步,在新建索引上用 explain 对比数字字段和 keyword 子字段。预期是数字字段上的 term 分数不随值稀有程度变化,keyword 子字段上会不同,这是按源码推断的,请在测试集群上确认:
curl -s 'localhost:9200/my_index/_search?explain=true' -d '{
  "query": { "term": { "my_number": 3 } }
}'
curl -s 'localhost:9200/my_index/_search?explain=true' -d '{
  "query": { "term": { "my_number.keyword": "3" } }
}'
第四步,需要打分就按上面的多字段方式改 mapping。改 mapping 不会给老数据补上子字段,要重建索引。
升级前后怎么对比
挑一批有代表性的查询,升级前记录前 10 条的 _id 和 _score,重建索引后用同样的查询再跑一次做对比。分数对不上就查是不是数字字段参与了算分。这个对比成本低,能在业务方反馈之前发现排序变化。
收益侧可以对比同一批数据重建前后的磁盘占用和范围查询耗时:
curl -s 'localhost:9200/_cat/indices?v&bytes=b' | grep my_index
官方文档只说"预计"更省、更快,实际差异取决于数据,以你自己的对比为准。
写在最后
数字字段换成 BKD 之后,term 查询变成点查询,返回常量分。它只发生在 5.0.0-alpha2 及之后创建的索引上,老索引升级后不变,重建索引时才会变。
多数场景不需要处理。靠 IDF 排序的少数查询,要么给数字字段加 keyword 子字段,要么按真实意图改成 function_score;这两者表达的意思不同,不能互相替换。重建前后做一次 top N 的 id 和分数对比,是最便宜的验证。
参考
本文对照 Elasticsearch
v5.6.16标签的官方文档核对,引文逐字取自原文。撰写时未启动集群、未运行测试。