基于NEO4J图模型的关系计算
一、原始图模型
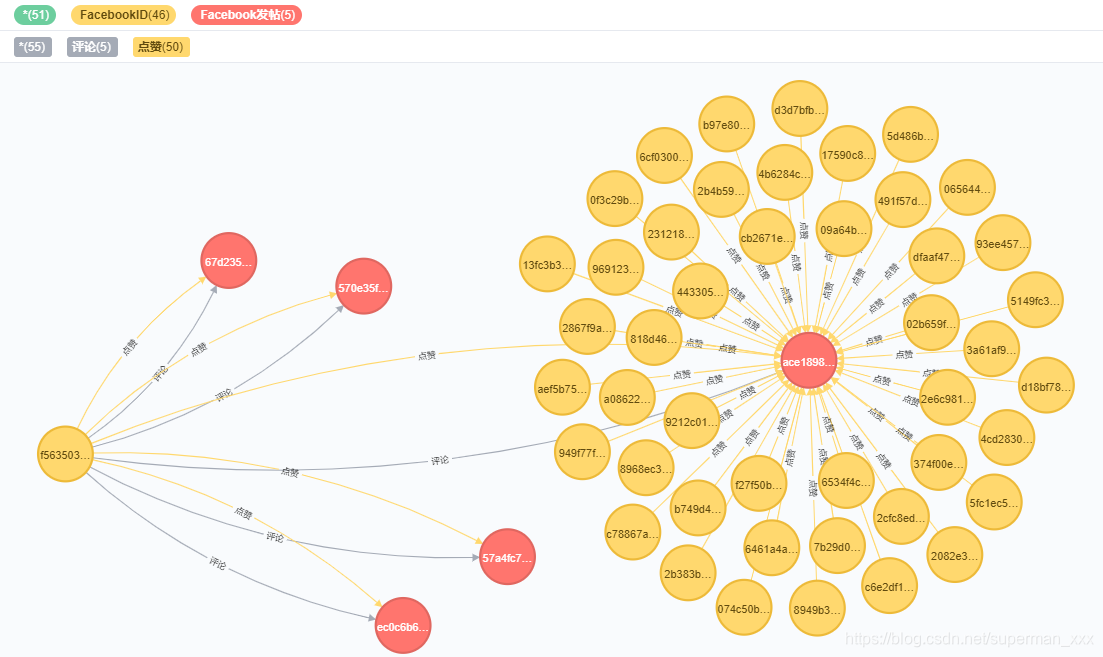
原始图模型只有人与发帖之间的关系(这种关系符合建立图谱的一般逻辑)
二、计算关系(不溯源)
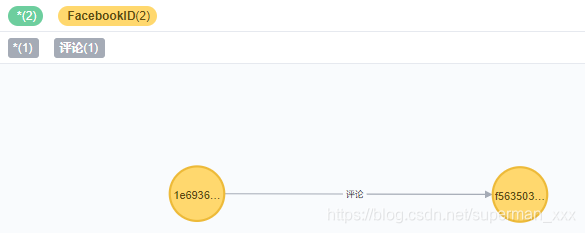
根据原始图模型生成人物之间的关系
MATCH p=(n)-[:评论|发帖]-()-[:评论|发帖]-(m) WHERE zdr.apoc.relatCalculateRestrict(labels(n),labels(m),'FacebookID')=true AND id(n)=519565 AND id(m)=519595 WITH p,n AS startNode,m AS endNode
CALL apoc.merge.relationship(startNode, '评论', NULL, NULL, endNode) YIELD rel WITH id(rel) AS idRel
MATCH path=()-[r]-() WHERE id(r)=idRel SET r.tracingSourceBool='false' WITH r.tracingSourceBool AS tracingSourceBool WITH
CASE
WHEN tracingSourceBool='true'
THEN 'MATCH p=(n)-[:评论|发帖]-()-[:评论|发帖]-(m) WHERE id(n)={idN} AND id(m)={idM} WITH p,n AS startNode,m AS endNode MATCH path=(startNode)-[:评论]-(endNode) RETURN p,path'
ELSE 'MATCH path=(n)-[:评论]-(m) WHERE id(n)={idN} AND id(m)={idM} RETURN path'
END
AS cypher
CALL apoc.cypher.run(cypher,{idN:519565,idM:519595}) YIELD value RETURN value.p AS p,value.path AS path
三、计算关系(溯源)
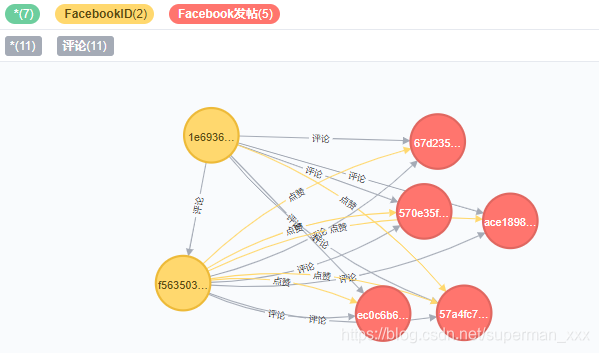
溯源是指过滤出计算关系的详细过程(原始图模型到->人物关系)-计算过程
MATCH p=(n)-[:评论|发帖]-()-[:评论|发帖]-(m) WHERE zdr.apoc.relatCalculateRestrict(labels(n),labels(m),'FacebookID')=true AND id(n)=519565 AND id(m)=519595 WITH p,n AS startNode,m AS endNode
CALL apoc.merge.relationship(startNode, '评论', NULL, NULL, endNode) YIELD rel WITH id(rel) AS idRel
MATCH path=()-[r]-() WHERE id(r)=idRel SET r.tracingSourceBool='true' WITH r.tracingSourceBool AS tracingSourceBool WITH
CASE
WHEN tracingSourceBool='true'
THEN 'MATCH p=(n)-[:评论|发帖]-()-[:评论|发帖]-(m) WHERE id(n)={idN} AND id(m)={idM} WITH p,n AS startNode,m AS endNode MATCH path=(startNode)-[:评论]-(endNode) RETURN p,path'
ELSE 'MATCH path=(n)-[:评论]-(m) WHERE id(n)={idN} AND id(m)={idM} RETURN path'
END
AS cypher
CALL apoc.cypher.run(cypher,{idN:519565,idM:519595}) YIELD value RETURN value.p AS p,value.path AS path
四、批量人员关系计算(一对多的计算)<仅供参考>
首先找到需要与当前人计算关系的节点,然后使用UNWIND批量计算
MATCH p=(n)-[:评论|发帖]-()-[:评论|发帖]-(m) WHERE id(n)=519565 WITH collect(m) AS nodes
UNWIND nodes AS stopNode
MATCH p=(n)-[:评论|发帖]-()-[:评论|发帖]-(m) WHERE id(n)=519565 AND id(m)=id(stopNode) WITH p,n AS startNode,m AS endNode
CALL apoc.merge.relationship(startNode, '评论', NULL, NULL, endNode) YIELD rel WITH id(rel) AS idRel,id(endNode) AS endNodeId
MATCH path=()-[r]-() WHERE id(r)=idRel SET r.tracingSourceBool='true' WITH r.tracingSourceBool AS tracingSourceBool,endNode(r) AS stopNode WITH
CASE
WHEN tracingSourceBool='true'
THEN 'MATCH p=(n)-[:评论|发帖]-()-[:评论|发帖]-(m) WHERE id(n)={idN} AND id(m)={idM} WITH p,n AS startNode,m AS endNode MATCH path=(startNode)-[:评论]-(endNode) RETURN p,path'
ELSE 'MATCH path=(n)-[:评论]-(m) WHERE id(n)={idN} AND id(m)={idM} RETURN path'
END
AS cypher,id(stopNode) AS endNodeId
CALL apoc.cypher.run(cypher,{idN:519565,idM:endNodeId}) YIELD value RETURN value.p AS p,value.path AS path
// 此函数限制可计算关系的标签,详情请参考下方GITHUB链接
zdr.apoc.relatCalculateRestrict(labels(n),labels(m),'FacebookID')=true