Jstorm 反压(Backpressure)

简介: 限流控制,又称 反压 (backpressure), 这个概念现在在大数据中非常火爆, 尤其是最近Heron/Spark都实现了这个功能。其实在jstorm 0.9.0 时,底层netty的同步模式,即可做到限流控制, 即当接收端能处理多少tuple, 发送端才能发送多少tuple, 但随着大面积使

背景

限流控制,又称 反压 (backpressure), 这个概念现在在大数据中非常火爆, 尤其是最近Heron/Spark都实现了这个功能。其实在jstorm 0.9.0 时,底层netty的同步模式,即可做到限流控制, 即当接收端能处理多少tuple, 发送端才能发送多少tuple, 但随着大面积使用, 发现netty的同步模式会存在死锁问题, 故这种方式并没有被大量使用。

原理

后来自2015年6月,twitter发布了heron的一篇论文, 描叙了,当下游处理速度跟不上上游发送速度时, 他们采取了一种暴力手段,立即停止spout的发送。 这种方式, jstorm拿过来进行压测, 发现存在大量问题, 当下游出现阻塞时, 上游停止发送, 下游消除阻塞后,上游又开闸放水,过了一会儿,下游又阻塞,上游又限流, 如此反复, 整个数据流一直处在一个颠簸状态。

真正合适的状态时, 上游降速到一个特定的值后, 下游的处理速度刚刚跟上上游的速度

什么样才能触发反压

jstorm的限流机制, 当下游bolt发生阻塞时, 并且阻塞task的比例超过某个比例时(现在默认设置为0.1), 即假设一个component有100个并发,当这个component 超过10个task 发生阻塞时,才会触发启动反压限流

什么样的情况才能判断是阻塞

在jstorm 连续4次采样周期中采样,队列情况,当队列超过80%(可以设置)时,即可认为该task处在阻塞状态

触发谁限流

根据阻塞component,进行DAG 向上推算,直到推算到他的源头spout, 并将topology的一个状态位,设置为 “限流状态”

怎么限流

当task出现阻塞时,他会将自己的执行线程的执行时间, 传给topology master, 当触发阻塞后, topology master会把这个执行时间传给spout, 于是, spout每发送一个tuple,就会等待这个执行时间。storm 社区的人想通过动态调整max_pending达到这种效果,其实这种做法根本无效。

怎样解除限流

当spout降速后, 发送过阻塞命令的task 检查队列水位连续4次低于0.05时, 发送解除反应命令到topology master, topology master 发送提速命令给所有的spout, 于是spout 每发送一个tuple的等待时间--, 当spout的等待时间降为0时, spout会不断发送“解除限速”命令给 topology master, 而topology master确定所有的降速的spout都发了解除限速命令时, 将topology状态设置为正常,标志真正解除限速

如何使用

  • 反压总开关
topology.backpressure.enable: true
  • 高水位 -- 当队列使用量超过这个值时,认为阻塞
topology.backpressure.water.mark.high: 0.8
  • 低水位 -- 当队列使用量低于这个量时, 认为可以解除阻塞
topology.backpressure.water.mark.low: 0.05
  • 阻塞比例 -- 当阻塞task数/这个component并发 的比例高于这值时,触发反压
topology.backpressure.coordinator.trigger.ratio: 0.1
  • 反压采样周期, 单位ms
topology.backpressure.check.interval: 1000
  • 采样次数和采样比例, 即在连续4次采样中, 超过(不包含)(4 *0.75)次阻塞才能认为真正阻塞, 超过(不包含)(4 * 0.75)次解除阻塞才能认为是真正解除阻塞
topology.backpressure.trigger.sample.rate: 0.75
topology.backpressure.trigger.sample.number: 4
  • 动态调整

  1. update_topology topology-name -conf confpath

作者:glowd

原文:https://blog.csdn.net/zengqiang1/article/details/78451055
版权声明:本文为博主原创文章,转载请附上博文链接!

相关文章
|
PyTorch 算法框架/工具
pytorch中torch.clamp()使用方法
1864 0
pytorch中torch.clamp()使用方法
|
Python Windows
Windows定时任务 每隔一段时间(最小到秒级)执行一次指定的Python脚本
|
存储 前端开发 安全
webhook是什么 与API的区别在哪里
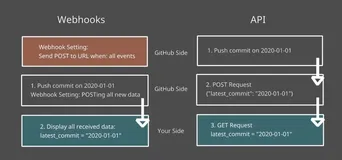
webhooks是一个api概念,是微服务api的使用范式之一,也被成为反向api,即:前端不主动发送请求,完全由后端推送。 举个常用例子,比如你的好友发了一条朋友圈,后端将这条消息推送给所有其他好友的客户端,就是 Webhooks 的典型场景。
webhook是什么 与API的区别在哪里
|
7月前
|
人工智能 JavaScript API
【保姆级教程】一键搭建AI协作团队!阿里云/本地搭建OpenClaw通用多Agent框架(开发/投资/内容)+Coding Plan配置指南
2026年,OpenClaw的多Agent玩法已从“单一团队搭建”升级为“多团队并行运作”——越来越多用户需要同时推进多个项目(如一边开发软件,一边做投资分析),但传统手动配置Agent的方式存在三大痛点:重复踩坑、配置混乱、团队隔离困难。而Multi-Agent Dev Team v2.2技能的推出,彻底解决了这些问题:它不是特定场景的脚手架,而是通用的多AI代理协作框架,通过交互式向导,可快速搭建任意类型的专业团队,支持多团队并行运行,还解决了子代理会话超时的治理难题。
1406 4
|
人工智能 自然语言处理 前端开发
从文案到设计,我用通义版Artifacts生成了365张灵感日历
本文介绍了如何利用通义AI的“代码模式”功能,轻松制作个性化日历。作者通过实例展示了从设计日历样式、推荐每日生活小事到赋予小事新解的过程,强调了AI在创意实现上的强大助力。此外,还探讨了AI代码生成技术对未来创造力的影响,以及通义AI代码模式如何降低创作门槛,提高效率,让每个人都能成为应用开发者。
|
存储 SQL 人工智能
Apache Flink 2.0:Streaming into the Future
本文整理自阿里云智能高级技术专家宋辛童、资深技术专家梅源和高级技术专家李麟在 Flink Forward Asia 2024 主会场的分享。三位专家详细介绍了 Flink 2.0 的四大技术方向:Streaming、Stream-Batch Unification、Streaming Lakehouse 和 AI。主要内容包括 Flink 2.0 的存算分离云原生化、流批一体的 Materialized Table、Flink 与 Paimon 的深度集成,以及 Flink 在 AI 领域的应用。
2014 13
Apache Flink 2.0:Streaming into the Future
|
人工智能 前端开发 Java
DDD四层架构和MVC三层架构的个人理解和学习笔记
领域驱动设计(DDD)是一种以业务为核心的设计方法,与传统MVC架构不同,DDD将业务逻辑拆分为应用层和领域层,更关注业务领域而非数据库设计。其四层架构包括:Interface(接口层)、Application(应用层)、Domain(领域层)和Infrastructure(基础层)。各层职责分明,避免跨层调用,确保业务逻辑清晰。代码实现中,通过DTO、Entity、DO等对象的转换,结合ProtoBuf协议,完成请求与响应的处理流程。为提高复用性,实际项目中可增加Common层存放公共依赖。DDD强调从业务出发设计软件,适应复杂业务场景,是微服务架构的重要设计思想。
|
SQL 分布式计算 Ubuntu
基于Hadoop的数据仓库Hive安装
基于Hadoop的数据仓库Hive安装
1285 0
|
存储 SQL 缓存
一文带你了解MySQL之Adaptive Hash Index
在InnoDB体系架构图的内存结构中,还有一块区域名为:Adaptive Hash Index,翻译成中文:自适应哈希索引,缩写:AHI,它是一个纯内存结构,我们今天就来了解它。
3720 0
|
程序员 开发者
IDEA插件-Power Mode II键盘炫酷效果
Power Mode II 是一款为 IntelliJ IDEA 设计的插件,旨在为编码过程增添动感和趣味性。这款插件通过在代码编写时添加视觉特效、声音效果和其他动态元素,为开发者提供了一个独特且富有创意的编程体验。
1986 0
IDEA插件-Power Mode II键盘炫酷效果

热门文章

最新文章