
scrapy 爬取到结果后,将结果保存到 sqlite3,有两种方式
- item Pipeline
- Feed Exporter
方式一
使用 item Pipeline 有三个步骤
- 文件 pipelines.py 中,编写
Sqlite3Pipeline类 - 文件 settings.py 中,添加
ITEM_PIPELINES - 开始运行爬虫: scrapy crawl example
1. 文件 pipelines.py
说明:
参考了官网文档的 MongoDB 的例子
要求:
表格 SQLITE_TABLE 要在爬虫运行之前先创建好。否则会报错,原因不详。
代码:
import sqlite3


class Sqlite3Pipeline(object):

    def __init__(self, sqlite_file, sqlite_table):
        self.sqlite_file = sqlite_file
        self.sqlite_table = sqlite_table

    @classmethod
    def from_crawler(cls, crawler):
        return cls(
            sqlite_file = crawler.settings.get('SQLITE_FILE'), # 从 settings.py 提取
            sqlite_table = crawler.settings.get('SQLITE_TABLE', 'items')
        )

    def open_spider(self, spider):
        self.conn = sqlite3.connect(self.sqlite_file)
        self.cur = self.conn.cursor()

    def close_spider(self, spider):
        self.conn.close()

    def process_item(self, item, spider):
        insert_sql = "insert into {0}({1}) values ({2})".format(self.sqlite_table,
                                                                ', '.join(item.fields.keys()),
                                                                ', '.join(['?'] * len(item.fields.keys())))
        self.cur.execute(insert_sql, item.fields.values())
        self.conn.commit()

        return item
补充:
Github 有一个使用 twisted 操作 sqlite3 的例子,见这里。请自行对比。
2. 文件 settings.py
激活前面的 Sqlite3Pipeline 类,需要
添加:
SQLITE_FILE = 'example.db'
SQLITE_TABLE = 'dmoz'

ITEM_PIPELINES = {
    'myproject.pipelines.Sqlite3Pipeline': 300,
}
3. 运行爬虫
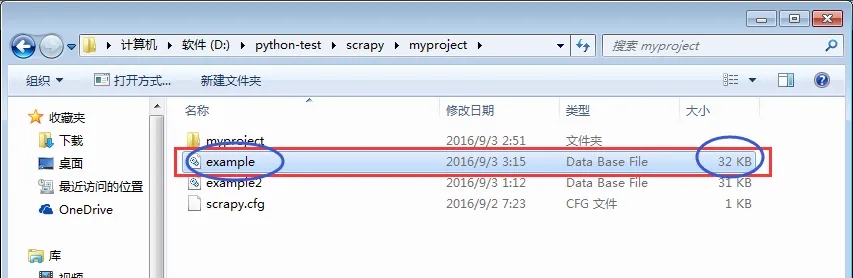
$ scrapy crawl example运行效果图:
方式二
使用 Feed Exporter 有三个步骤
- 文件 exporters.py 中,编写
Sqlite3ItemExporter类 - 文件 settings.py 中,添加
FEED_EXPORTERS - 开始运行爬虫: scrapy crawl example -o example.db -t sqlite3
1. 文件 exporters.py
说明:
参考了Github的例子,基本没变
代码:
from scrapy.exporters import BaseItemExporter
import sqlite3

class Sqlite3ItemExporter(BaseItemExporter):

    def __init__(self, file, **kwargs):
        self._configure(kwargs)
        self.conn = sqlite3.connect(file.name)
        self.conn.text_factory = str
        self.created_tables = []

    def export_item(self, item):
        item_class_name = type(item).__name__

        if item_class_name not in self.created_tables:
            keys = None
            if hasattr(item.__class__, 'keys'):
                sqlite_keys = item.__class__.sqlite_keys
            self._create_table(item_class_name, item.fields.iterkeys(), sqlite_keys)
            self.created_tables.append(item_class_name)

        field_list = []
        value_list = []
        for field_name in item.iterkeys():
            field_list.append('[%s]' % field_name)
            field = item.fields[field_name]
            value_list.append(self.serialize_field(field, field_name, item[field_name]))

        sql = 'insert or ignore into [%s] (%s) values (%s)' % (item_class_name, ', '.join(field_list), ', '.join(['?' for f in field_list]))
        self.conn.execute(sql, value_list)
        self.conn.commit()

    def _create_table(self, table_name, columns, keys = None):
        sql = 'create table if not exists [%s] ' % table_name

        column_define = ['[%s] text' % column for column in columns]
        print('type: %s' % type(keys))
        if keys:
            if len(keys) > 0:
                primary_key = 'primary key (%s)' % ', '.join(keys[0])
                column_define.append(primary_key)

            for key in keys[1:]:
                column_define.append('unique (%s)' % ', '.join(key))

        sql += '(%s)' % ', '.join(column_define)

        print('sql: %s' % sql)
        self.conn.execute(sql)
        self.conn.commit()

    def __del__(self):
        self.conn.close()
2. 文件 settings.py
激活前面的 Sqlite3ItemExporter 类,需要
添加:
FEED_EXPORTERS = {
    'sqlite3': 'myproject.exporters.Sqlite3ItemExporter',
}
3. 运行爬虫
$ scrapy crawl example -o example.db -t sqlite3说明:
第二种方式未测
本文转自罗兵博客园博客,原文链接:http://www.cnblogs.com/hhh5460/p/5836136.html,如需转载请自行联系原作者
