Spark 程序开发,调试和运行,intellij idea开发Spark java程序。
分两部分,第一部分基于intellij idea开发Spark实例程序并在intellij IDEA中运行Spark程序.第二部分,将开发程序提交到Spark local或者hadoop YARN集群运行。Github项目源码
图1,直接在intellij IDEA(社区版)中开发调试,直接run。
图2,直接在intellij IDEA(社区版)中用hadoop YARN模式。
Github项目源码
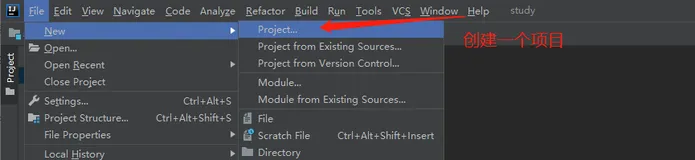
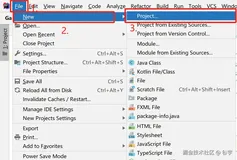
1.(第一部分)使用intellij IDEA创建一个Java的Maven项目。Github项目源码
初始化的MAVEN项目如下
2.根据Spark官网实例做二次开发Github项目源码
2.1.创建SimpleApp.java文件 SimpleApp.java
/**
* MIT.
* Author: wangxiaolei(王小雷).
* Date:17-2-7.
* Project:SparkJavaIdea.
*/
import org.apache.spark.api.java.*;
import org.apache.spark.SparkConf;
import org.apache.spark.api.java.function.Function;
public class SimpleApp {
public static void main(String[] args) {
String logFile = "file:///opt/spark-2.1.0-bin-hadoop2.7/README.md";
SparkConf conf = new SparkConf().setAppName("Simple Application");
JavaSparkContext sc = new JavaSparkContext(conf);
JavaRDD<String> logData = sc.textFile(logFile).cache();
long numAs = logData.filter(new Function<String, Boolean>() {
public Boolean call(String s) { return s.contains("a"); }
}).count();
long numBs = logData.filter(new Function<String, Boolean>() {
public Boolean call(String s) { return s.contains("b"); }
}).count();
System.out.println("Lines with a: " + numAs + ", lines with b: " + numBs);
sc.stop();
}
}
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
- 27
- 28
- 29
- 30
- 31
2.2.修改pom.xml文件 pom.xml
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
<modelVersion>4.0.0</modelVersion>
<groupId>wangxiaolei</groupId>
<artifactId>SparkJavaIdea</artifactId>
<version>1.0-SNAPSHOT</version>
<dependencies>
<dependency>
<groupId>org.apache.spark</groupId>
<artifactId>spark-core_2.11</artifactId>
<version>2.1.0</version>
</dependency>
</dependencies>
</project>
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
3.在intellij IDEA中运行Spark程序
3.1 设置IDEA运行项的Configuration中的VM opthion 增加-Dspark.master=local
3.2.右键SimpleApp.java 点击运行,稍等片刻看到运行成功。
已经将Readme.md中的单词a和b统计出来了Lines with a: 62, lines with b: 30
至此,Spark在intellij IDEA中开发,并在IDEA中运行成功!
4.(第二部分)将intellij IDEA中的Spark java程序打包成jarGithub项目源码
5.spark local模式运行
--class "SimpleApp" \
--master local[4] \
target/SparkJavaIdea-1.0-SNAPSHOT.jar
至此,Spark local模式程序开发和运行成功!
6.YARN集群模式(或伪分布式)运行.——需要有集群环境或者提前配置好了伪分布式环境,伪分布式环境搭建参考另一篇博文Ubuntu16.04安装Hadoop2.6+Spark1.6+开发实例
6.1.开启hadoop集群,开启Spark。
# 初次搭建集群需要格式化namenode(已经初始化过可省略)
/opt/hadoop-2.7.3/bin/hdfs namenode -format
#开启hadoop集群(伪分布式)
/opt/hadoop-2.7.3/sbin/start-all.sh
#开启Spark
/opt/spark-2.1.0-bin-hadoop2.7/sbin/start-all.sh
#查看开启状态
jps
/opt/spark-2.1.0-bin-hadoop2.7/bin/spark-submit --class SimpleApp --master yarn --deploy-mode cluster target/SparkJavaIdea-1.0-SNAPSHOT.jar
至此,Spark在intellij IDEA中开发,并在hadoop YARN模式下运行成功!
6.3.在Web中查看Github项目源码
http:
至此,Spark在intellij IDEA中开发,并在hadoop YARN模式下运行成功!