一句话定位:这不是"模型会不会写漏洞",而是"它写出来的代码有没有同时过功能和安全两道关"——一个函数跑通但存不住的数据,在账上是不算的。同样的方法可迁移到登录接口的越权校验、退款接口的重复提交防护、权限变更的二次确认、上传接口的类型过滤。
摘要
阿里在 11 月 17 日的 Qwen4-Max 发布里顺手给了一组代码安全的数:Last Secure Code Bench 上,函数级"既通过功能检查又通过安全检查"的比例从 22.0% 到 31.8%。这组数最有意思的不是涨幅,而是它只有一个判定口径——两个条件必须同时满足。本文拆开这个口径,看它和我们平时说的"测试通过""扫描无高危"差在哪,以及为什么三成这个数放在工程里其实不算低。
一个函数能让测试通过,和三行之后它会不会出事,是两件不同的事。
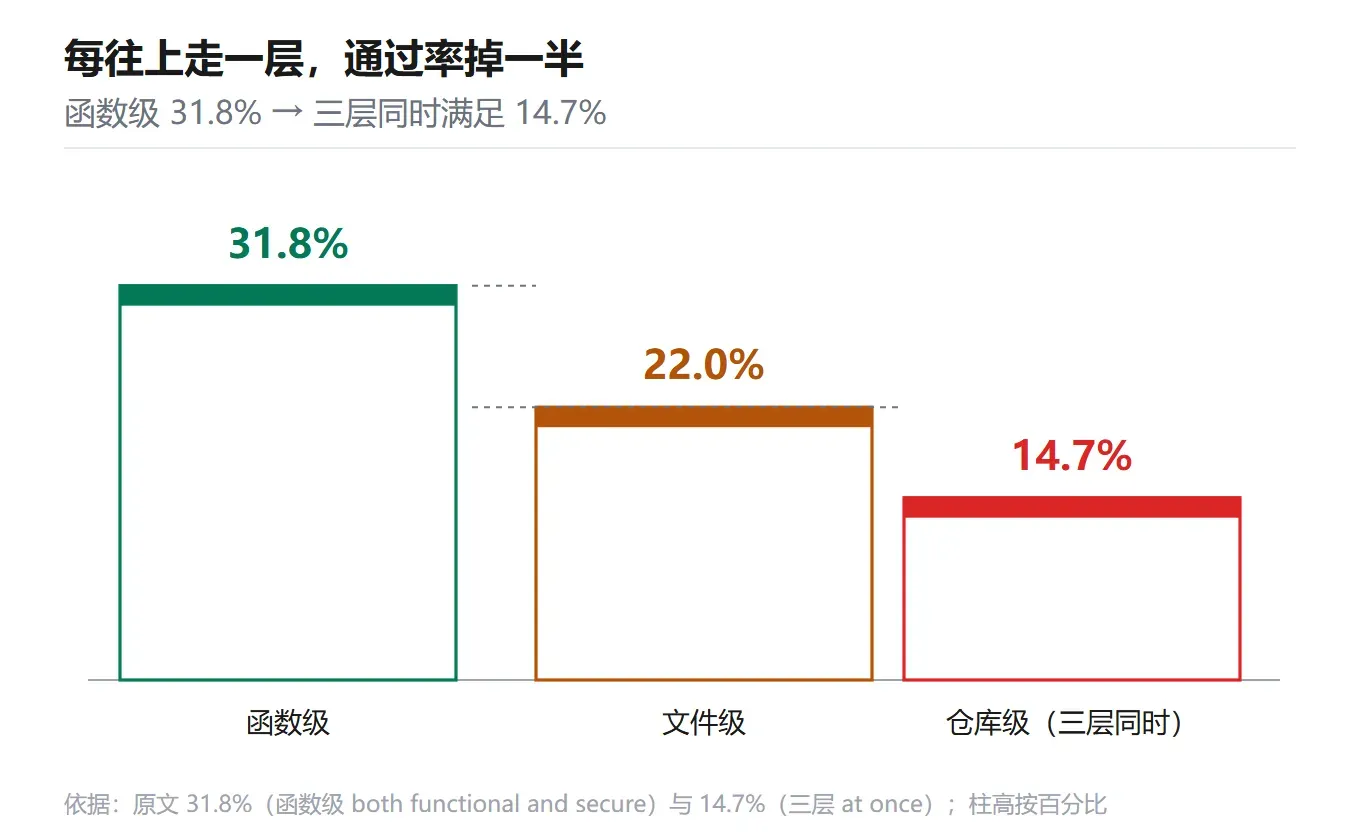
阿里在 11 月 17 日的企业版发布稿里给了一组很干的数:在 Last Secure Code Bench 上,函数级的"既能工作又安全"的代码比率,从上一代 Qwen3.8-Max 的 22.0% 升到 Qwen4-Max 的 31.8%;同时满足函数、文件、仓库三个层级的安全代码占比,从 8% 升到 14.7%。
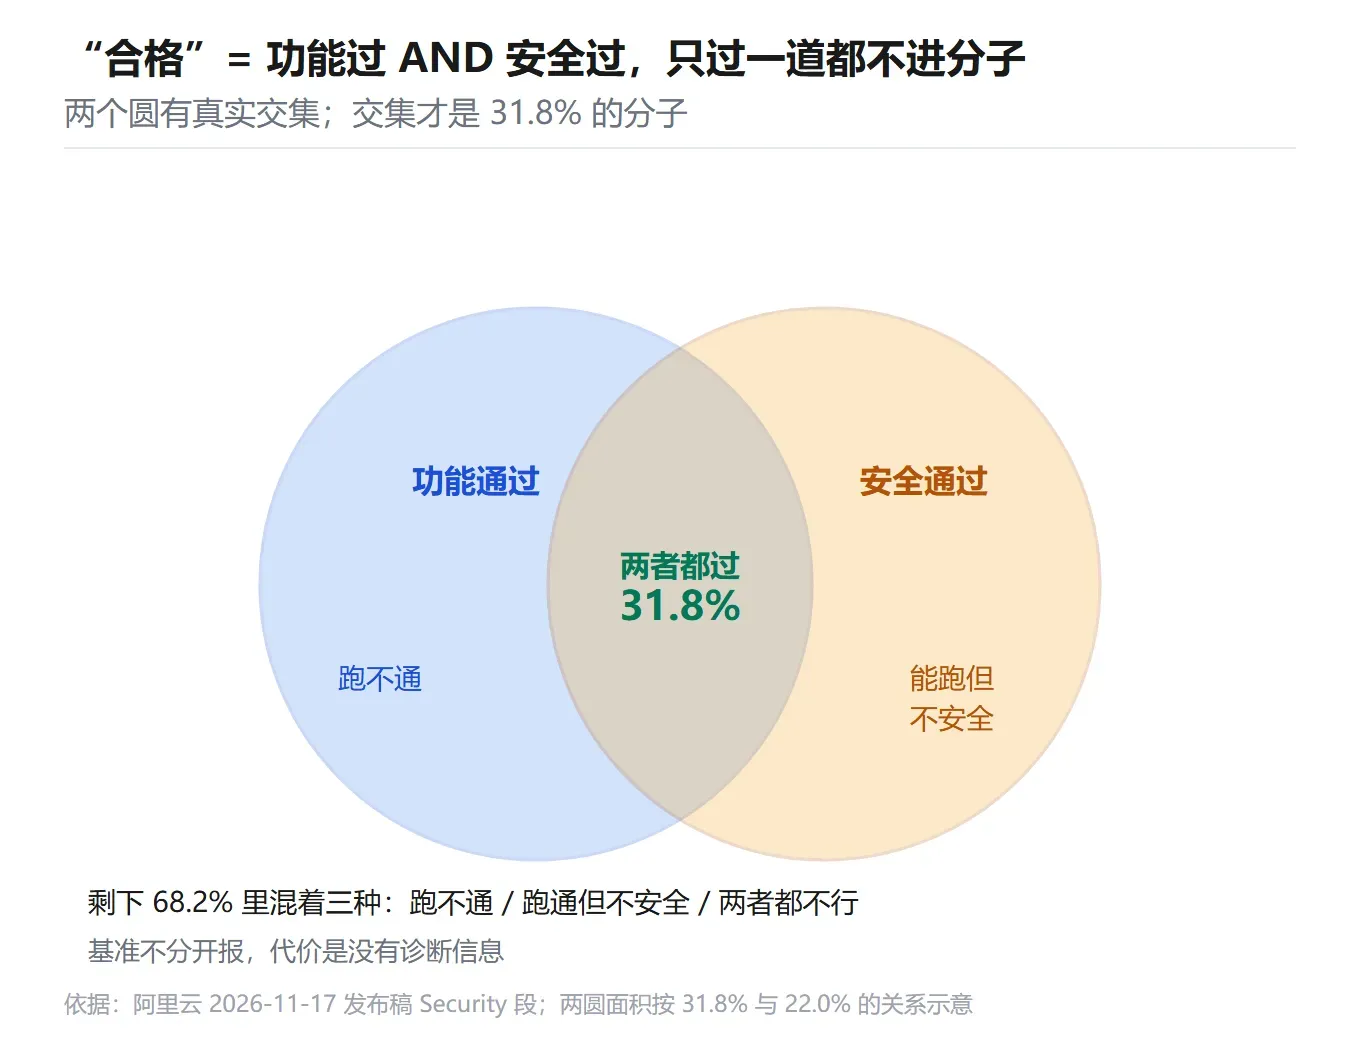
两组数放在一起,第一件事是算减法:31.8% 之外那 68.2% 是什么?
它不是"不安全",是"不合格"
这个基准只有一个通过条件:功能检查和安全检查同时过。原文的措辞是 "the function-level rate of code that is both functional and secure",关键词是 both。
所以剩下那 68.2% 里,混着三种完全不同的东西:跑不通的、跑通了但不安全的、以及两个都不行的。基准没有把它们分开报。
这不是缺陷,是设计。如果一份评测只报"漏洞率",写一堆跑不起来的空函数反而能把漏洞率做低——空函数不会 SQL 注入。把两个条件绑在一起,是为了堵这个口子。代价是你会失去诊断信息:分数涨了,你不知道是更能跑通了,还是更安全了。
三层级的数掉下来,说明什么
这里还有一组更关键的数:函数级 14.7%、而且是同时满足函数、文件、仓库三层。
原文的表述是 "the share of secure code generated at function, file and repository level at once rose from 8% to 14.7%"。从 31.8% 掉到 14.7%,掉了一半多。
这个落差是所有"单点安全"系统都会遇到的事。一个函数可以对输入做校验、可以用参数化查询,单看它没问题;但到了文件级,同一份配置在另一个函数里被绕过;到了仓库级,两个模块各自安全,拼起来的调用链把权限判断跳过去了。
测试的人也熟悉这个落差:单接口的用例都能过,串成业务流程就出错。区别在于代码安全还要多一层——单点是"这段代码本身有没有缺陷",仓库级是"这些代码放在一起还能不能守住边界"。
"安全塞进训练"是什么意思
原文给的原因是:软件工程训练里加入了代码安全检查。同时还有一条更狠的处理——按任务意图筛选训练数据,保留用于漏洞检测与修复的防御性材料,删除攻击性内容。
前半句是评测口径的因,后半句是数据来源的因。
前者意味着,模型不是先写代码再被扫描,而是训练时就把"安全检查"当成和功能测试一样的验收条件。这跟团队里把静态扫描挂在 CI 上是同一件事,只不过位置往前挪到了训练环节。
后者值得单独说一句,因为它涉及一个边界:模型要能识别漏洞,就得见过漏洞长什么样;但见过攻击性的成品代码,也就可能被用来生成它。阿里选的做法是保留"防御视角"的数据、去掉"攻击视角"的数据。这是一个取舍,不是无代价的——它可能同时削掉了模型对复杂攻击链的理解。
三成,是高还是低
31.8% 这个数,第一眼会觉得低。
但要看它测的是什么:函数级的代码,必须同时过得住功能测试和安全检查。放在日常工程里,一个普通业务函数同时满足这两条的比率也不会高——大部分现有代码库从来没被要求"每个函数都安全"。
- 比"高低"更有参考价值的是同篇发布稿里的另一组数:在 IPO 尽调场景里,Qwen4-Max 把 198 个散乱文件归到 14 个目录,交叉核对公开记录,交付一份 86 页的报告,覆盖 12 个模块、14 个法律问题,每条结论都能指回来源文件。这类"每条结论都能溯源"的要求,本质上和"每段代码都要过两道关"是同一类约束——不是做不到,是成本高。原文对此的限定词是"in the case shown",即来自某一次发布演示,不承诺在你自己的任务上复现。
所以看到 31.8% 的正确反应不是"太低",而是"这个数测的到底是什么"。一个只报漏洞率的评测,可以轻松报到 90% 以上,因为大量代码根本没被真正跑过。
需要提醒的是,这组数出自厂商自己的发布稿,评测基准与演示案例都由同一方提供,属"厂商自报"口径。它适合用来读口径,不适合用来和别家的模型横向比较——原文的免责声明也写了,这些数字只是与自己的上一代对比。
三条可以搬走的做法
第一,把"通过"的定义写成 AND 条件。功能断言过了就发版,和功能断言过了且安全断言也过了才发版,是两个系统。前者在账面上更好看,也更容易在半年后出事。
第二,测三个层级,别只测一层。函数、文件、仓库各自的通过率要分开报,落差本身就是信息。
第三,把安全断言挪到更早的位置。挂在 CI 上是"写完就查",挪到训练或编码助手环节是"写的时候就避开"。这两种的成本差着一个数量级。
评测口径设计上最容易犯的错,是把两个条件合成一个分数,然后忘了它本来是两个问题。
阿里这组数之所以值得抄,是因为它老老实实只报了一个合成口径,并且把两个原始条件都写在了句子里。看的人可以自己算减法,也可以自己去补诊断信息——但不会误以为它在说"31.8% 的代码没有漏洞"。
一道断言,只回答一个问题。合起来的数,要能拆开说清楚。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。