
在工业巡检、能源计量和设备状态采集等场景中,LED 显示屏、电子仪表和机械表盘的读数识别是一项高频需求。与通用目标检测任务不同,读数识别通常需要先定位"显示区域""边框""表盘"等关键部件,再在其基础上做后续的字符识别或数值解析。本文以 LED 显示屏智能读数检测数据集为例,围绕 YOLO11 目标检测模型,梳理从数据集准备、云上存储与版本管理、训练任务设计,到模型评估与工程化落地的完整流程,供需要在云上组织视觉训练任务的开发者参考。
业务场景
读数识别类任务的核心难点并不在于单一目标,而在于画面中往往同时存在多种视觉元素:数字屏幕、机械指针表盘、设备边框、背景纹理等。检测模型需要先稳定地框出这些区域,才能为下游的读数解析提供可靠输入。因此,一个结构清晰的检测数据集,配合 YOLO11 这类兼顾精度与推理效率的检测模型,是构建此类系统的常见起点。
本文讨论的流程适用于 LED 显示屏读数识别、电子仪表读数采集、设备状态巡检等方向,也可以迁移到其他需要"先检测部件、再做解析"的视觉任务中。文中涉及的存储、训练和服务组织方式属于工程建议,具体实现可结合团队现有的云上资源进行适配。
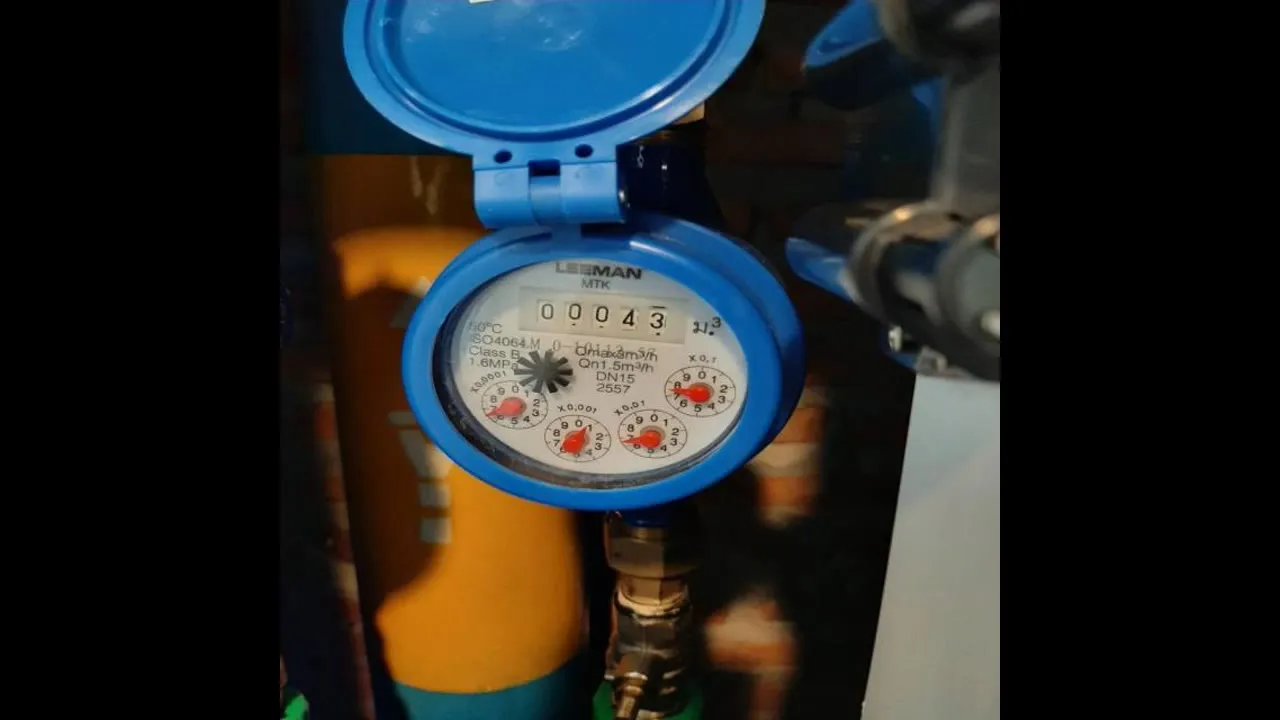
数据集说明(来源:数据集说明表)
根据数据集说明表的客观信息,该数据集名为 LED 显示屏智能读数检测数据集,项目标识为 ledxspzndsjcsjj,面向 LED 智能设备读数识别相关的研究与应用设计。数据集整体规模为 3400 多张 LED 智能设备读数图像,所有图像均已完成 YOLO 格式标注,并附带 TXT 标注文件与 YAML 配置文件,可直接用于目标检测训练。
从本次整理与标注的批次看,当前批次(2026-07-10)包含 100 张图片,对应 100 个 Label Studio 标注任务,标注类别为 display、frame、gauge 三类,分别对应显示区域、边框和表盘等部件。批次内还提供了一段由这些图片合成的视频素材,可用于数据集预览或项目展示。
需要说明的是,数据集说明表中的规模描述(3400 多张)与当前批次的 100 张图片属于不同层面的信息:前者描述数据集整体,后者描述本次导入标注的抽样批次。在实际训练中,建议以完整数据集为主体,抽样批次用于快速验证流程和标注规范。
数据集准备与标注组织
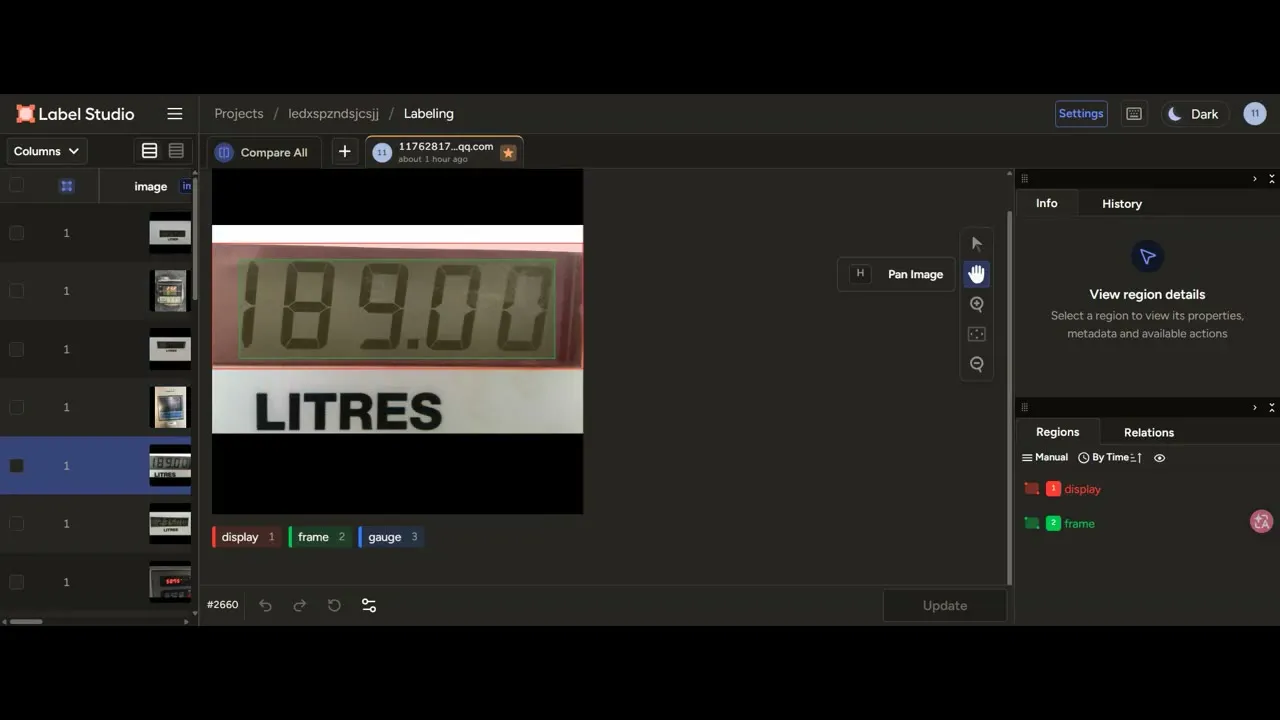
数据准备阶段建议把"采集—筛选—标注—导出"拆成可复现的步骤。以本数据集为例,图片从视频抽帧或原始采集中筛选后,导入 Label Studio 进行标注,标注配置通过 label_config.xml 定义,类别体系固定为 display、frame、gauge。标注完成后导出为 Label Studio JSON,再转换为 YOLO 所需的 TXT 标签和 YAML 数据配置。
标注规范上有几点值得提前约定:一是边框类目标(frame)与显示区域(display)容易重叠,需要明确谁包含谁、是否允许部分遮挡;二是表盘(gauge)在机械仪表和电子屏幕中形态差异较大,建议在标注指引中给出正负样本示例;三是对于读数区域被反光、遮挡或角度倾斜的样本,应保留而不是直接剔除,因为这正是模型鲁棒性需要覆盖的情况。
云上存储与版本管理建议
将数据集迁移到云上时,建议把原始素材、标注文件、导出结果和训练产物分层存放,避免混在同一目录中。一种常见组织方式如下:
- 原始素材层:按批次或采集日期存放原始图片与视频,只读保存,便于追溯;
- 标注层:保存 Label Studio 导出 JSON、标注配置和转换脚本,与原始素材通过文件名或 ID 关联;
- 数据集层:保存转换后的
images/、labels/和data.yaml,按版本号命名,例如led_det_v1、led_det_v2; - 训练产物层:保存权重、日志、评估结果和导出的推理模型,与数据集版本一一对应。
版本管理上,建议为每次数据变更记录"数据集版本 + 标注配置版本 + 转换脚本版本"三元组,这样当模型指标出现波动时,可以快速判断是数据变化还是训练配置变化导致的。对象存储在云上通常支持版本控制和生命周期策略,可以结合使用,对历史批次做归档、对活跃批次保留快速读取能力。
训练任务设计
训练阶段使用 YOLO11 目标检测模型。数据配置文件可参考如下结构,类别顺序需与标注转换时保持一致:
# data.yaml
path: /data/led_det_v1
train: images/train
val: images/val
names:
  0: display
  1: frame
  2: gauge
训练命令示例(参数仅为起点,需按实际数据规模调整):
yolo detect train \
  model=yolo11n.pt \
  data=/data/led_det_v1/data.yaml \
  epochs=100 \
  imgsz=640 \
  batch=16 \
  device=0 \
  project=/output/led_det \
  name=yolo11_baseline
在云上组织训练任务时,建议关注以下几点:
- 数据与计算分离:数据集放在对象存储或共享存储,训练容器按需挂载,避免每次训练重复上传数据;
- 镜像与依赖固定:将 Ultralytics 版本、CUDA 版本和依赖锁定在镜像中,保证不同任务之间可复现;
- 小批量先行:先用抽样批次跑通全流程,确认标注转换、路径映射和评估脚本无误,再提交全量训练;
- 资源按需选择:YOLO11 提供不同规模的模型变体,可先用较小模型验证流程,再根据精度需求调整模型规模与输入分辨率。
模型评估与复核
训练完成后,评估不应只看单一指标。对于读数识别场景,建议同时关注:
- 各类别 AP:
display、frame、gauge三类目标的检测质量可能差异明显,需分别查看; - 混淆情况:边框与显示区域在视觉上接近,需检查是否存在类别混淆;
- 小目标与遮挡样本:远距离拍摄或部分遮挡的仪表,是实际部署中最容易漏检的情况;
- 可视化复核:抽取验证集样本,人工查看检测框位置、类别标签和置信度,判断是否存在系统性偏差。
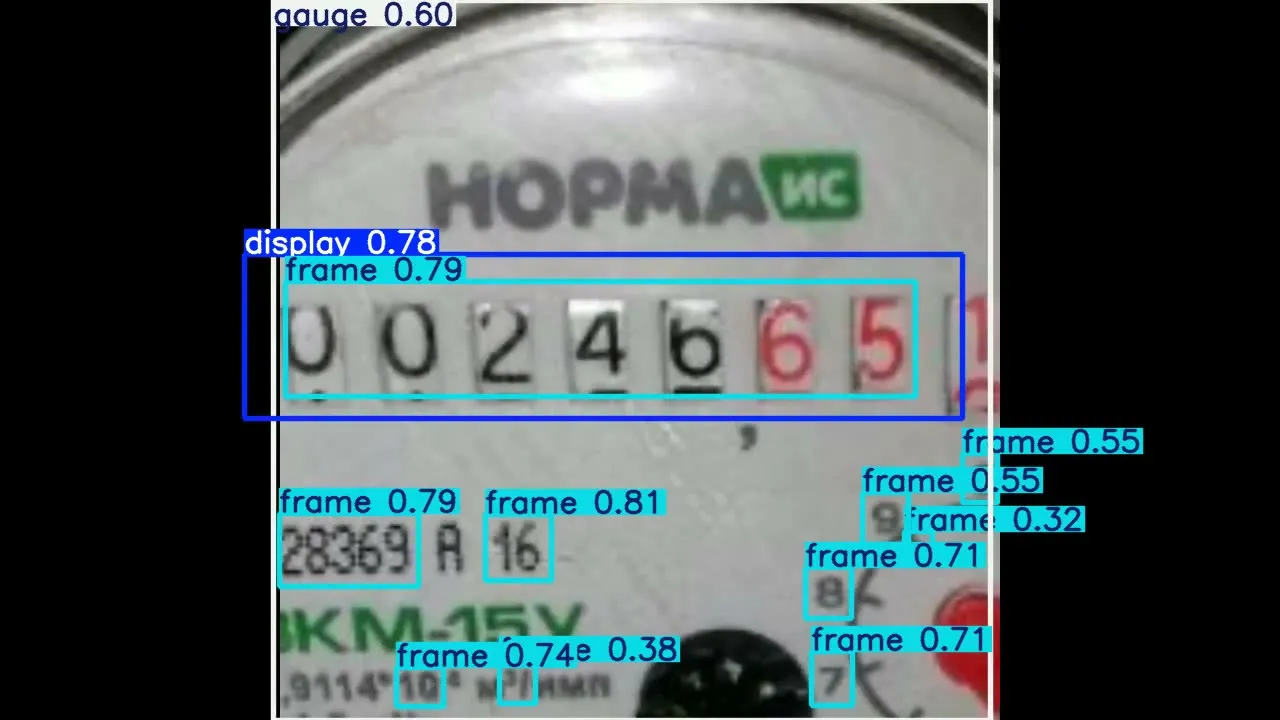
复核阶段建议把误检、漏检样本单独归档,形成"难例集",作为下一轮数据补充和模型迭代的输入。这一环节在工程上往往比调参更能带来稳定收益。
工程化落地注意点
从训练走向服务,还有几处容易被忽略的工程细节:
- 推理服务与训练解耦:训练产物导出为推理格式后,通过独立的推理服务加载,避免训练环境与线上环境相互影响;
- 输入预处理一致:线上推理的缩放、归一化方式必须与训练时一致,否则精度会明显下降;
- 阈值可配置:置信度和 NMS 阈值应作为服务配置项,便于按场景调整;
- 结果后处理:检测框只是中间结果,读数解析需要结合业务规则,例如按
display区域裁剪后再做字符识别; - 监控与回流:记录线上推理的输入分布和低置信度样本,定期回流到数据集中,形成闭环。
这些做法不依赖特定平台,可以迁移到多数云上 AI 工程流程中。具体采用哪些存储、计算和调度组件,应结合团队现有技术栈和成本约束决定。
总结
围绕 YOLO11 构建 LED 显示屏智能读数检测系统,关键不在于单次训练的调参,而在于把数据集组织、标注规范、云上存储分层、训练任务可复现和评估复核串成一条稳定的工程链路。本文以 LED 显示屏智能读数检测数据集为例,给出了数据准备、存储版本管理、训练配置、评估复核和落地注意点的实践建议。读者可结合自身数据规模和云上资源,将上述流程迁移到类似的部件检测与读数识别任务中,并在迭代中持续补充难例、固定版本、监控线上表现。
附:配套数据资源
本文为工程实践记录,用于说明数据集组织、标注与训练流程,不涉及商业推广。下列入口仅用于复现文中实验。
- 资源入口(百度网盘,纯文本):https://pan.baidu.com/netdisk/share?surl=CGt8AgzebODcS0BlISfMNA&pwd=uvms
- 提取码:uvms
请按数据集说明合理使用。

