本文是“系统学习推荐算法的第五期”,首发于我的博客
一个智能推荐系统,本质上是一台巨大的配对机器,左手牵着亿万视频,右手牵着亿万用户,数据要转换成特征才能送入模型计算处理
因为在你看来,短短一分钟的视频计算机眼中却是一场数字灾难。我们来算一笔账,一段60秒的短视频,每秒30帧,每一帧如果是1080P高清画质,就是1920乘1080个像素点,每个像素点又由红绿蓝三通道数值组成,计算一下,抖音每天新增上亿条视频。如果原封不动的塞给算法模型,等待你的不会是精准推荐,而是服务器机房的集体冒烟。
所以为了让模型跑得动、算得动,我们不对所有数据进行全量计算,而是把原始的视频数据取其精华,去其糟粕,提炼出区分不同人和不同内容的关键信息。输入模型用于分析预测,不同于人类基于逻辑情感价值来理解内容,模型是通过特征代表的观点结构化信息进行统计、关联匹配。这就是我们今天要聊的主角特征工程。
在推荐系统的数学世界里,万事万物皆可被归纳为三本档案。
- 第一本是内容特征,负责把画面、音频和文字接轨,它回答的是平台上有什么。
- 第二本是用户特征,它通过你每一次点击、停留和转发,为你勾勒出一份数字画像,它回答的是你是谁?你想要什么。
- 第三本是上下文特征,它记录你当下的状态,是深夜被窝里的解压,还是地铁通勤时的打发时间。它回答的是你现在处于什么环境下。
这三者并非孤立存在,特征工程的目标就是把这三份档案转化成模型能瞬间处理的特征向量。
特征向量通常可以用串数字来表示,比如这是一段猫跳舞的视频,我们假设有三维特征,分别代表萌宠度 0.9、幽默感 0.8、节奏感 0.6,这一串数字就是这个视频的特征向量。向量在数学上不仅仅是一个坐标点,它是一根从原点出发指向终箭头。
在工程实践中,一个向量往往拥有128维甚至512维。在这个由数字构成的高维空间里,你视频上下文都变成了从原点指向某个特定方向的箭头,模型要做的就是在零点几秒内结合上下文,从数亿个视频向量中找出那些跟你指向最一致的箭头。
这些代表视频、代表用户的向量是从哪里来的?
内容特征
以短视频平台为例
一个视频在推荐系统眼中从来不是一个单一的东西,而是画面、声音、文字等多模态信息的集合体。
为了画出一幅精准的内容画像,系统把它分解成三条信息流
一条是视频流,系统提取关键帧,把帧裁剪缩放到相同大小,并将像素值从0到255缩放到0,1之间,使后续计算更稳定。
然后两套模型开始工作,一个是预训练好的视觉模型,扫描每一帧提取外观特征,包括物理颜色、纹理、场景等。另一个模型提取视频动态特征,在长宽之外增加时间轴捕捉动作特征。视频特征回答的是画面有什么,怎么动。
第二条是音频流。原始的音频只是一条随时间波动的曲线,也就是波形图,这在模型眼里只是噪音。我们要动用第一键工具复列变化,你可以把它想象成一部成分拆解机,把杂乱的波形拆解成不同频率的叠加。为了让模型更像人,我们需要给它换上一把不公平的尺子,这就是梅尔标度。这把尺子会过滤掉那些人耳听不到的细节,放大那些对情感和语义至关重要的部分。把这些处理完的数据拼在一起,就得到了一张梅尔频谱图。最后利用深度学习模型,像处理图像一样扫描频谱图,提炼具有语义信息的特征向量。音频特征回答的是声音在说什么,传递什么情绪。
第三条是文本流,标题、话题、标签、视频描述,从画面里识别的文字,从语音里转录的内容,这些都是文本。文本处理的第一步是分词,把句子切成最小的语义单元,然后用 Word2Vec 每个词映射为一个固定向量,利用transformer的编码器生成一个代表段化含义的全局特征向量,文本特征回答的是最直接的问题,这个视频在讲什么
特征融合
现在画面、语音、文字都变成了三串特征向量推荐系统,该如何阅读这三份截然不同的说明书?
早期的做法很粗暴,叫特征拼接,把图像、音频、文本的向量直接首尾相连,凑成一个维度超长的向量,但在数学模型看来,这种拼接只是单纯增加了维数,并没有建立逻辑,语义上依然是各说各话。
现在推荐系统的灵魂在于多模态语义对齐,核心是对齐和融合。我们不再做简单的加法,而是把不同来源的箭头投射到同一个语义浅空间对齐阶段。业界常采用对比学习,给这些箭头施加一种数学引力,让同一个视频的视觉向量和文本向量在多维度空间里尽量靠近,让不同视频的向量相互远离
对齐只是第一步,让不同模态的信息产生真正的化学反应,需要用到 transformer 以及它的核心部件注意力机制。
注意力机制这种选择性聚焦被拆解成三个数学角色:Query key value
假设你是一名记者,想采访水果这个话题,你来到一个报告厅,里面坐着一群专家,他们胸前别着名牌,有的写着苹果专家,有锤子专家,还有香蕉专家,你会迅速扫视名牌。在数学上,这就是点击运算,如果两个向量方向一致,点击就越大。你发现苹果专家和香蕉专家跟水果的匹配度最高,锤子专家基本不沾边,你会根据匹配得分通过一个soft max函数把注意力转化成百分比。比如给苹果专家和香蕉专家分别50%、40%的关注,给锤子专家10%,你开始记录专家的发言,把他们的发言汇总到一篇关于水果的新闻稿,这就是注意力的输出。那些无关紧要的锤子信息,在这个公式里就被彻底抑制了。只有一个记者视角难免偏激。transformer 聪明的地方在于,他采用了多头注意力,是一家财大气粗的新闻社。他同时派出八个甚至12个带着不同偏见的记者,每个头都有独立的权重矩阵,他们把Q K V映射到不同的空间,每个头独立计算注意力,得到的结果就是新闻稿。最后,所有记者把新闻稿拼起来,再通过一个线性层进行压缩和融合,生成一篇全方位、无死角的深度报道。
理解了注意力机制,跨模态注意力就好说了。此时的文本画面和音频已经全部变成了浅空间里的高维向量,生成了一个包含全局语义的终极内容。
一般物品的其他特征
- 物品 ID
- 发布时间、GeoHash、所在城市
- 标题、类目、关键词、品牌……
- 字数、图片数、视频清晰度、标签数
- 内容信息量、图片美学(用特定训练过的模型打分)
用户特征
用户特征要回答三个问题,**你是谁?你做过什么?你和谁相似?**这其实就是推荐系统为你做的用户画像。
静态特征
当你刚下载注册软件的时候,通过签署用户协议,平台会收集到你的性别、年龄、所在位置、新/老用户、活跃度 等基础信息。这类特征在工程上叫静态特征,稳定且区分度高。
动态特征
比起你是谁,推荐系统更在乎你做了什么最直接的显性行为——点赞、收藏、关注、转发、不感兴趣,就像一个人直接告诉你,我喜欢这个,我不喜欢那个。
但更有价值的是那些你察觉不到的隐性反馈,浏览时长、停留时间、滑动速度、是否看完视频等
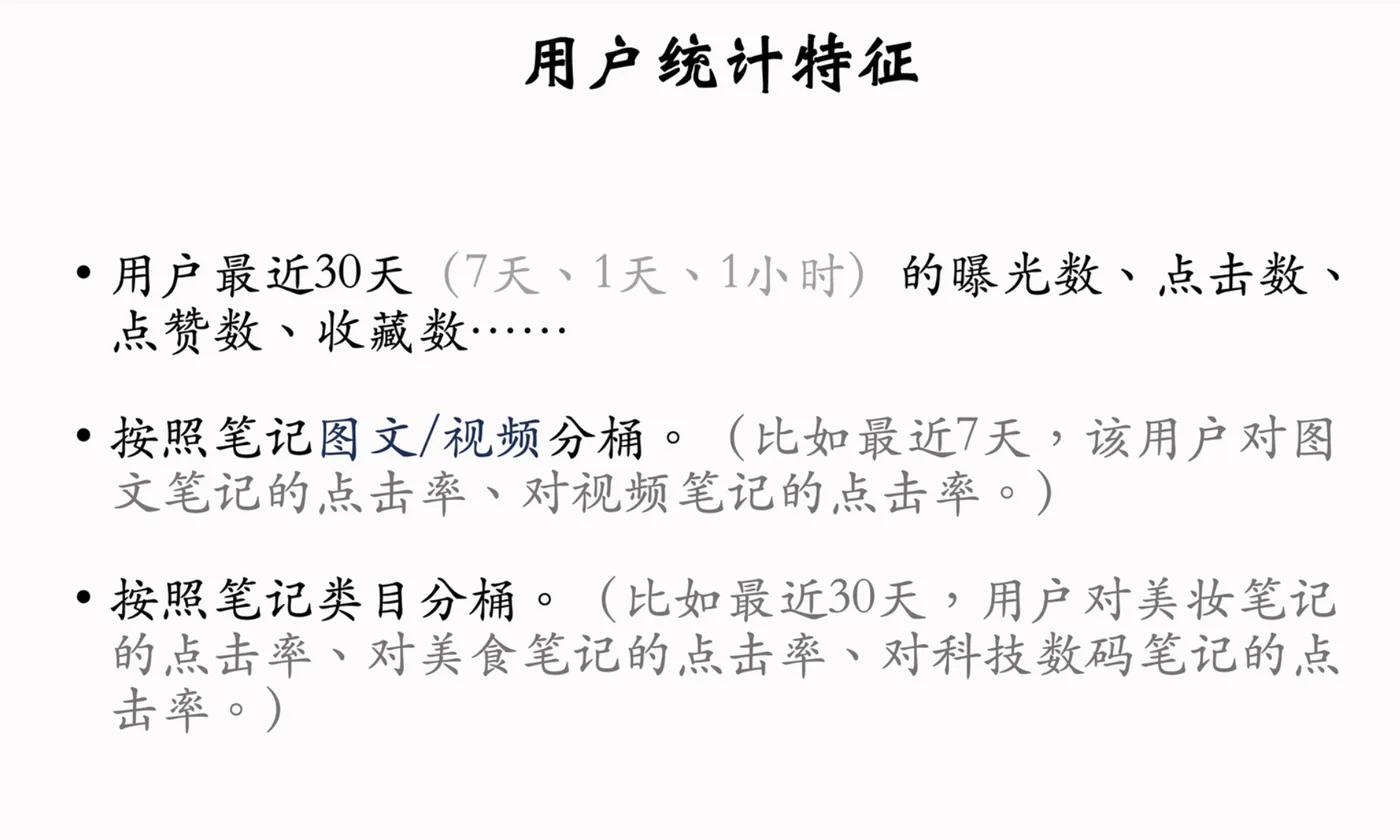
这些信号能够帮模型捕捉到你兴趣的细微变化,你的好友,你关注的人,你和他们私信互动,这些人喜欢什么,大概率你也会喜欢。还有一些人是弱关,他们跟你点赞过同一条视频,收藏过同一件商品,转发过同一篇文章,混同一个社区,借助志同道合的人来发现你可能喜欢但还没遇到的内容,这就是推荐系统里常说的协同过滤
这些特征具体如何处理?
收集到这些碎片信息后,必须把它们变成模型需要的数字矩阵。有些特征天生就是数字,比如年龄、播放时长、历史、点击率,它们可以直接成为特征向量中的一个维度。但更多的特征不是数字,像性别、城市、兴趣爱好这类数据只就像散列的点一样,非此即彼,不存在中间状态,这叫离散型特征。常用的处理方法是独热编码(One-hot 编码),把每个类别称成一个开关,比如性别,男就是10,女就是 01。如果一个特征可以选多个选项,比如兴趣领域可以用独热编码,在符合的位置上都拨到1。但面对城市或视频ID这种动辄成千上万的分类,独热编码就失灵了。它会产生一个几万维却只有一位是一的矩形向量,在工程上这叫数据极其稀疏。
于是工业界引入降维打击:向量化映射(即嵌入,Embedding)。他强行把几千个孤立的城市压缩到一个低为稠密的连续空间里,像年龄、播放时长这种连续特征也需要处理。以观看时长为例,用户在某个视频上停了23秒,这个23能直接给模型吗?不行,因为30秒短视频看23秒叫意犹未尽,2小时电影看23秒叫光速劝退。因此需要归一化,将观看时长除以视频总时长变成0到1之间的进度条,或者采用离散化分筒,把连续的播放进度切分为几个特定的开关,让模型更好消化。
离散特征处理的具体方法
参考:
https://github.com/wangshusen/RecommenderSystem/blob/main/Slides/02_Retrieval_04.pdf
https://github.com/wangshusen/RecommenderSystem/blob/main/Slides/02_Retrieval_05.pdf
上下文特征
人类的喜好是极其情绪化且依赖环境的。在推荐系统中,用户与内容的匹配并不是孤立发生的,它总是嵌套在某个具体的场景里。周一早高峰通勤,你可能需要快节奏的新闻简报。周五深夜,你更容易沉浸在emo的音乐或长篇悬疑小说中。
上下文特征的引入,就是为了尽可能保留推荐行为发生时的环境信息,让系统理解用户当下真正需要什么。时间、地点、天气、空气质量、社会事件,这些因素都会影响用户此刻的需求,推荐系统得把这些考虑进去。
上下文特征一般包括:
- 用户定位 GeoHash、城市
因为用户可能对自己附近发生的事感兴趣 - 当前时刻
一个人在同一天不同时刻的兴趣可能有所区别,在上班路上,在办公室或者晚上睡觉前,用户想看的东西可能不一样 - 是否是周末、是否是节假日
周末和节假日的时候,用户可能对特定的话题感兴趣 - 手机品牌、手机型号、操作系统
在特征工程的最后阶段,系统会让内容的多模态embedding 结合这个视频的 ID embedding 代表它的受众协同信号以及统计表现向受欢迎度的方向进行微调修正
从一条搞笑视频到百亿像素的拆解,从 transformer 跨模态的精密计算到刻画你前世今生的赛博画像。当你点下那个赞的零点几秒内,推荐系统已经在高维度的数学空间里为你完成了一场数十亿次计算的浪漫奔赴。
特征处理
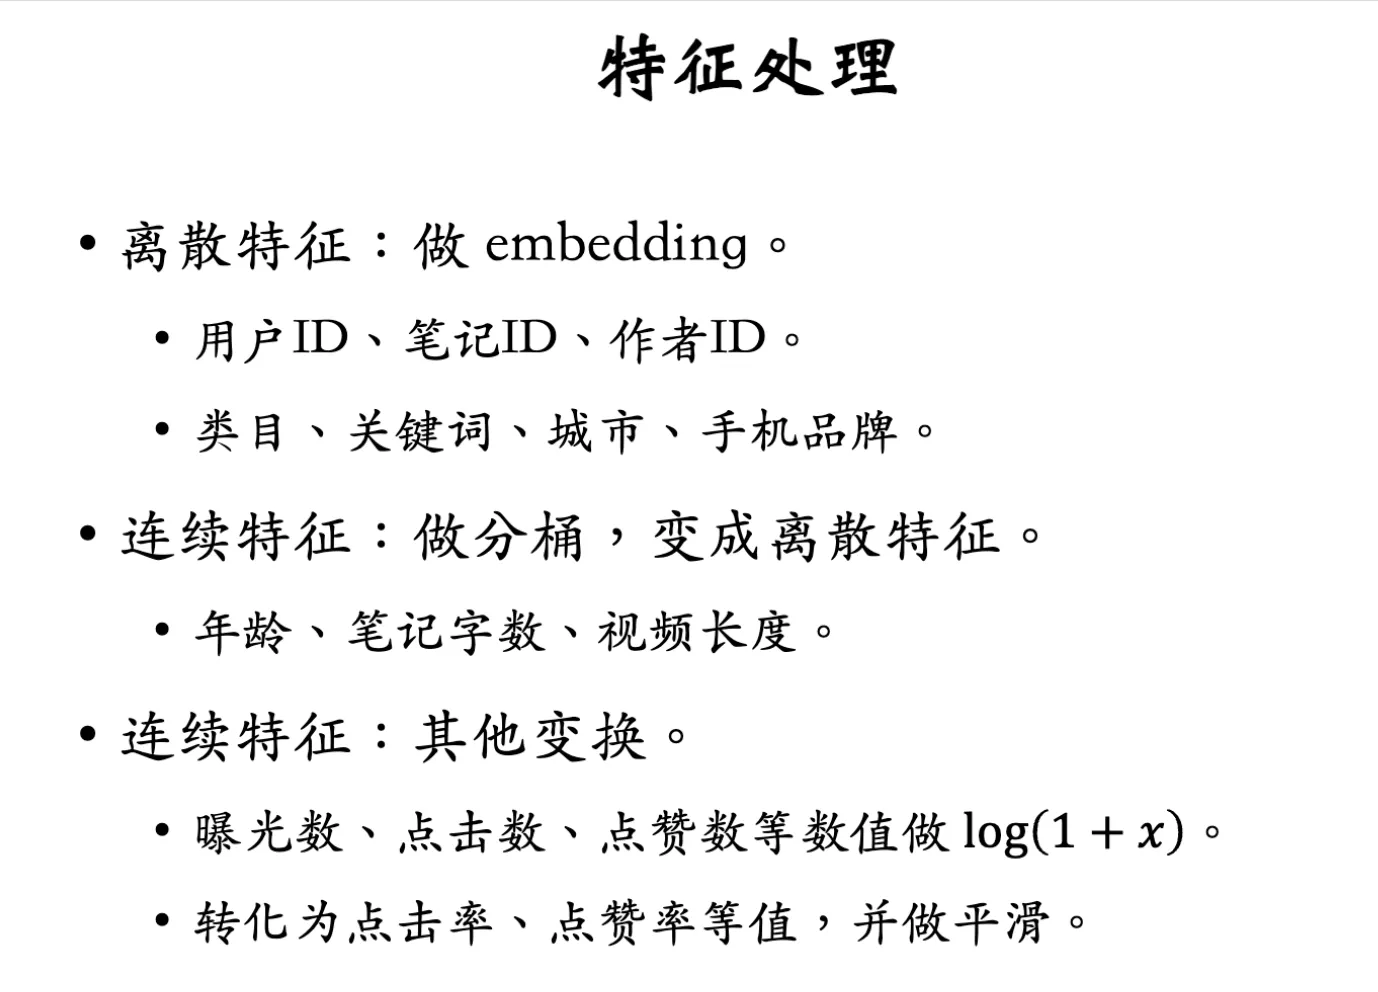
离散特征的处理很简单,就是做 embedding。
- 常见的离散特征
- 用户ID、笔记ID、作者ID
数量都非常巨大,都是几千万几亿的级别,消耗内存很大 - 类目、关键词,城市,手机,品牌,
数量级较小,处理容易。比方说笔记的类目也就几百个,关键词也就几百万个,做 embedding 比较容易,消耗内存不多
- 用户ID、笔记ID、作者ID
连续特征的处理
连续特征有不同的处理方法
- 分桶,把连续特征变成离散特征。像年龄、笔记字数、视频长度之类的连续特征都可以这么处理,比方说把连续的年龄变成10个年龄段。做 one-hot 编码或者做 embedding。
- 做 $log(1+x)$
曝光数、点击数、点赞数这些指标都是长尾分布。
以曝光数为例,大多数笔记只有几百次曝光而已,而极少数的笔记能有上百万次曝光。假如直接把曝光数作为特征输入模型,一旦出现几十万几百万正特别大的数值。计算会出现异常,比如训练的时候梯度会很离谱,做推理的时候预估值会很奇怪。对这样的连续特征通常是做 $log(1+x)$ 变换,这样会解决异常值的问题,除此之外。 - 转化为点击率、点赞率等值,并做平滑
还可以把曝光数、点击数、点赞数的指标,变成点击率点赞率,这里还需要做一下平滑,去掉偶然性造成的波动。
小节一下前面的内容,排序需要用到这几类特征,用户画像特征、笔记画像特征、用户统计特征、笔记统计特征,还有场景特征。前面我逐一解释了为什么这些特征有用,在做特征工程的时候需要关注一下特征覆盖率。在理想的情况下,每个特征都能覆盖100%的样本,也就是说不存在特征缺失的问题。但实际上大多数特征都有缺失,覆盖率达不到100%,比如很多用户注册的时候不填写年龄,所以用户年龄特征的覆盖率缘小于100%。再比如很多用户设置了隐私权限,使得App不能获得用户的地理定位,因此场景特征有缺失。