
用中文分词接口实现搜索关键词抽取:一次生产级接入与调试链路
本文基于公开接口文档与开放资料整理,未对接口发起真实请求实测。文中返回示例为结构示意,字段名与类型以官方文档为准;正式集成前请自行验证。
一、技术简介:中文文本为什么必须先切词
英文单词之间天然有空格,中文没有。对于检索、标签、聚类这类下游任务来说,先把一段连续的中文切成"词"是绕不开的第一步——倒排索引的 term 从哪来、商品标题的标签从哪来、评论聚类的特征从哪来,都取决于切词结果。
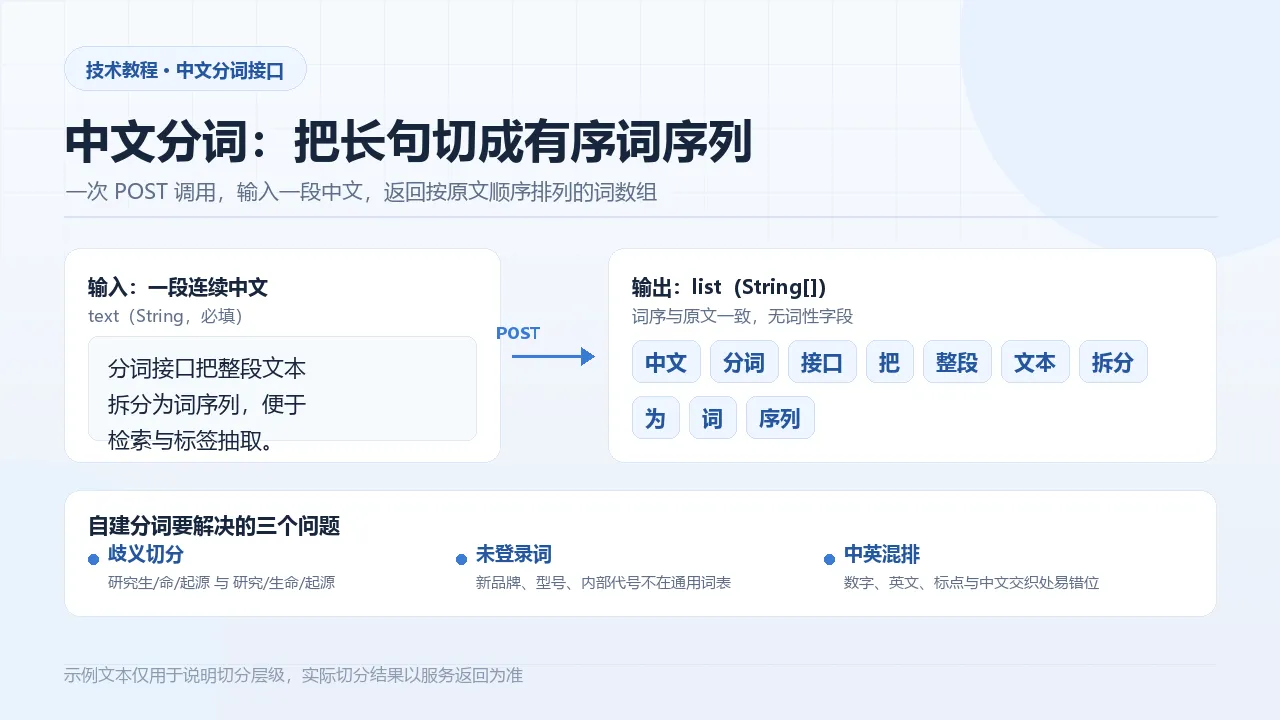
自建分词会遇到三个具体问题:
- 歧义切分。"研究生命起源"可以切成"研究生/命/起源",也可以切成"研究/生命/起源",不同粒度对检索召回的影响完全不同。
- 未登录词。新品牌、人名、地名、缩写(如"纳豆激酶""冷链前置仓")不在通用词表里,容易被切成碎片。
- 中英混排与标点。"SKU 编码 A1024,下单后 48h 发货"这类文本里,数字、英文、标点与中文交织,切分边界容易出错。
中文分词接口把这件事抽象成一次 HTTP 调用:提交一段文本,返回一个词序列。它不负责后续的词性、实体、情感分析,只负责"切",因此适合作为流水线里一个稳定的前置环节。
二、能力概览
表 1 列出接口的基本调用信息(具体域名以商品页"接口信息"中给出的调用地址为准,路径为 /sepWord):
| 项 | 内容 |
|---|---|
| 接口用途 | 中文文本切词,句子拆分与词组划分 |
| 调用方式 | POST |
| 请求地址 | https://{API网关域名}/sepWord |
| 请求格式 | 表单或 JSON Body,字段 text |
| 返回格式 | JSON(UTF-8) |
| 鉴权方式 | Header Authorization: APPCODE <appcode> |
| 必填参数 | text(String,要切词的整段中文) |
| 业务返回 | showapi_res_body.list(字符串数组)、showapi_res_body.ret_code |
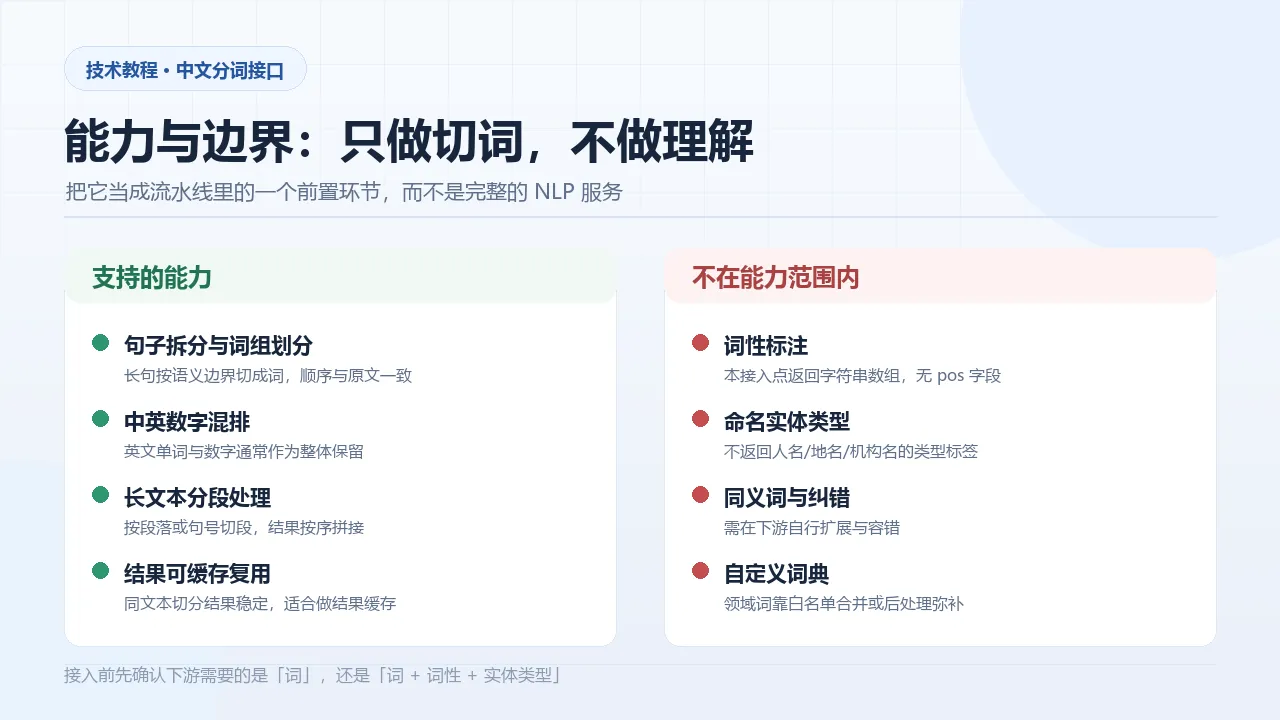
表 2 说明它能做什么、不做什么,避免把它当成"万能 NLP 服务":
| 能力项 | 是否支持 | 说明 |
|---|---|---|
| 句子拆分 / 词组划分 | 支持 | 长句按语义边界切成词序列,顺序与原文一致 |
| 中英数字混排 | 支持 | 英文单词、数字通常作为整体保留 |
| 词性标注 | 不支持 | 本接入点返回纯字符串数组,无词性字段 |
| 命名实体类型 | 不支持 | 不返回人名/地名/机构名的类型标签 |
| 同义词扩展、纠错 | 不支持 | 需在下游自行处理 |
| 自定义词典 | 不支持 | 领域词需通过后处理或替换策略弥补 |
三、适用场景
分词本身不产出业务价值,价值出现在它下游。下表是几类常见落点,以及每类场景对切词粒度的隐性要求:
| 场景 | 输入 | 切词结果的用途 | 粒度倾向 |
|---|---|---|---|
| 站内搜索建索引 | 商品标题、文章正文 | 生成 term 建倒排索引 | 偏细,保证召回 |
| 内容标签体系 | 标题、简介、评论 | 抽取高频词做标签候选 | 偏粗,避免标签碎片化 |
| 评论与舆情分析 | 用户评论、反馈文本 | 词频统计、主题聚类前置 | 偏细,保留情绪词 |
| 智能问答意图识别 | 用户提问 | 关键词匹配、意图特征 | 偏细,保留疑问词 |
| 内容安全审核 | 待发布文本 | 切词后与敏感词表比对 | 偏细,减少漏匹配 |
| 日志与会话聚类 | 运维日志、会话记录 | 抽取维度词做归类 | 偏粗,降噪优先 |
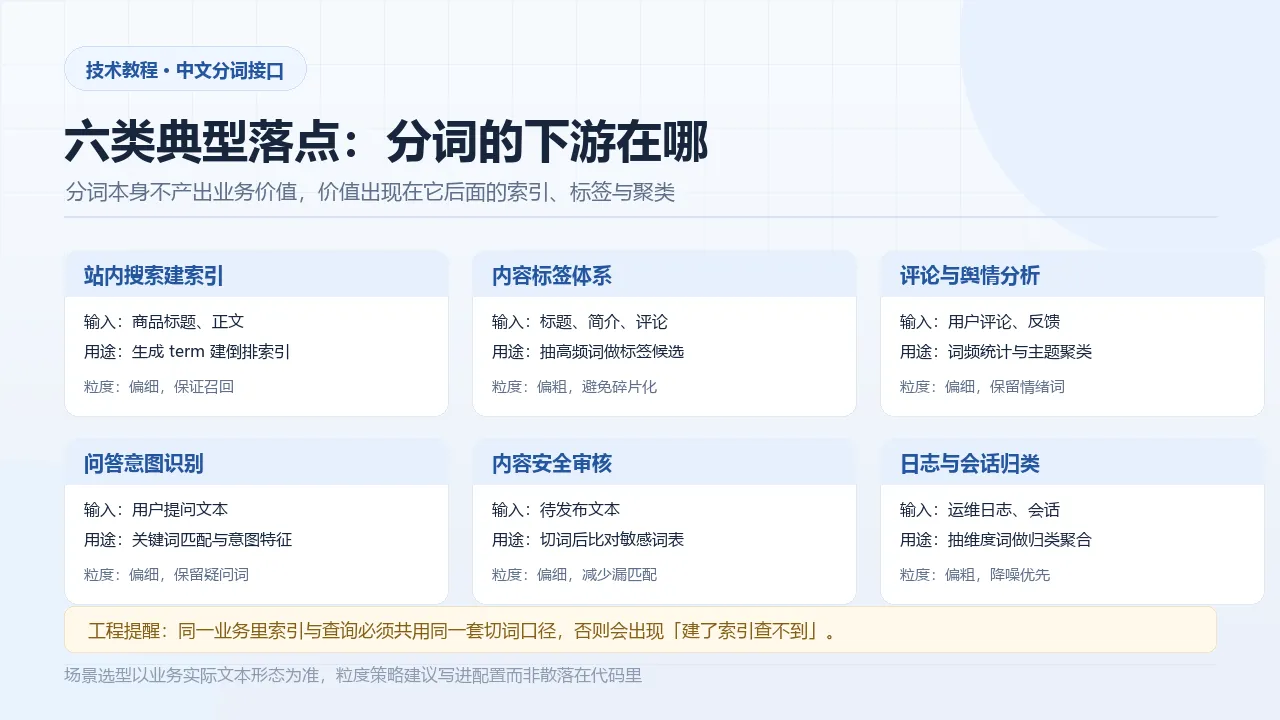
工程上有一个容易忽略的点:同一个业务里不要混用不同粒度。索引阶段按细粒度切词、查询阶段却按粗粒度匹配,会造成"建了索引查不到"。建议把粒度策略写进配置,索引与查询共用同一套切词调用参数。
四、接入流程
从零到第一次成功返回,通常只需要五步:
- 开通服务。在 API 服务商的控制台完成订购,拿到该接口的调用权限。
- 获取凭据。在应用详情里取得 AppCode;若使用签名方式,则同时取得 AppKey 与 AppSecret。AppCode 直接放在 Header 里,比签名方式少一次摘要计算,适合服务端直连场景。
- 拼装请求。固定
POST+Authorization: APPCODE <appcode>+ Body 里的text,其余交给网关。 - 连通性验证。先跑一段短文本,确认 HTTP 200 且
showapi_res_code == 0,再确认showapi_res_body.ret_code == 0。 - 参数与编码规范。全链路 UTF-8;表单提交时对中文做 URL 编码;长文本按标点或段落切段后再拼接结果。
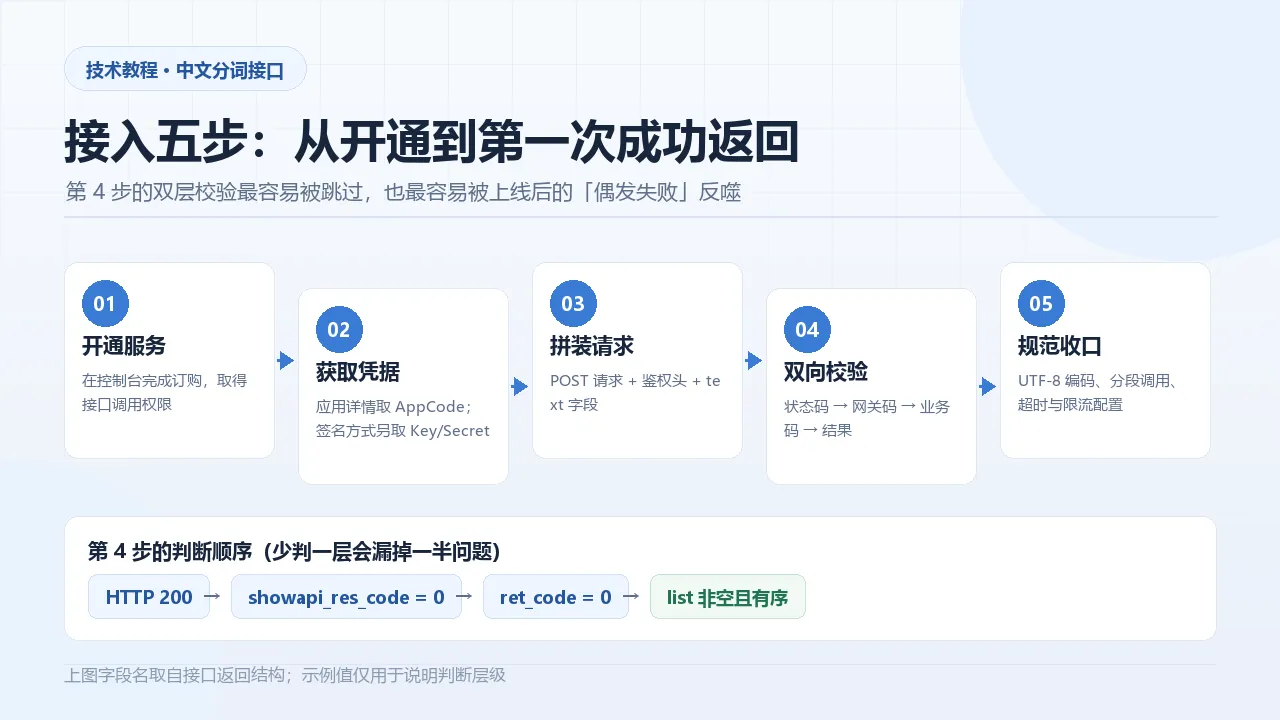
其中第 4 步是最容易被跳过、也最容易在上线后反噬的一步。很多"偶发失败"其实来自一开始就没分清两层错误:网关层(凭据、配额、欠费)和业务层(参数不合法、文本为空)。这两层的判断逻辑在第五节给出。
五、调用示例与返回结构
5.1 cURL
curl -X POST "https://${API_HOST}/sepWord" \
  -H "Authorization: APPCODE ${APPCODE}" \
  -H "Content-Type: application/x-www-form-urlencoded; charset=UTF-8" \
  --data-urlencode "text=中文分词接口把整段文本拆分为词序列,便于检索与标签抽取。"
5.2 Python
import os
import requests

API_HOST = os.environ["API_HOST"]        # API 网关域名,取自商品页接口信息
APPCODE = os.environ["APPCODE"]          # 控制台应用详情中的 AppCode

def segment(text: str, timeout: float = 5.0) -> list:
    resp = requests.post(
        f"https://{API_HOST}/sepWord",
        headers={

            "Authorization": f"APPCODE {APPCODE}",
            "Content-Type": "application/x-www-form-urlencoded; charset=UTF-8",
        },
        data={
   "text": text},
        timeout=timeout,
    )
    resp.raise_for_status()
    payload = resp.json()

    # 第一层:网关是否受理
    if payload.get("showapi_res_code") != 0:
        raise RuntimeError(f"gateway error: {payload.get('showapi_res_error')}")

    body = payload.get("showapi_res_body") or {
   }
    # 第二层:业务是否成功
    if body.get("ret_code") != 0:
        raise RuntimeError(f"business error: ret_code={body.get('ret_code')}")

    return body.get("list", [])

if __name__ == "__main__":
    words = segment("中文分词接口把整段文本拆分为词序列,便于检索与标签抽取。")
    print(f"词数={len(words)}")
    print(" / ".join(words))
5.3 Java(JDK 11 HttpClient)
import java.net.URI;
import java.net.URLEncoder;
import java.net.http.*;
import java.nio.charset.StandardCharsets;

HttpClient client = HttpClient.newBuilder()
        .connectTimeout(java.time.Duration.ofSeconds(3))
        .build();

String host = System.getenv("API_HOST");
String appcode = System.getenv("APPCODE");
String body = "text=" + URLEncoder.encode(
        "中文分词接口把整段文本拆分为词序列", StandardCharsets.UTF_8);

HttpRequest request = HttpRequest.newBuilder()
        .uri(URI.create("https://" + host + "/sepWord"))
        .header("Authorization", "APPCODE " + appcode)
        .header("Content-Type", "application/x-www-form-urlencoded; charset=UTF-8")
        .timeout(java.time.Duration.ofSeconds(5))
        .POST(HttpRequest.BodyPublishers.ofString(body))
        .build();

HttpResponse<String> response = client.send(
        request, HttpResponse.BodyHandlers.ofString());
// 后续用 JSON 库解析 showapi_res_code 与 showapi_res_body.ret_code
5.4 Node.js(原生 fetch)
const API_HOST = process.env.API_HOST;
const APPCODE = process.env.APPCODE;

async function segment(text) {

  const res = await fetch(`https://${
     API_HOST}/sepWord`, {

    method: "POST",
    headers: {

      "Authorization": `APPCODE ${
     APPCODE}`,
      "Content-Type": "application/x-www-form-urlencoded; charset=UTF-8",
    },
    body: new URLSearchParams({
    text }),
    signal: AbortSignal.timeout(5000),
  });
  if (!res.ok) throw new Error(`HTTP ${
     res.status}`);
  const payload = await res.json();
  if (payload.showapi_res_code !== 0) throw new Error(payload.showapi_res_error);
  const body = payload.showapi_res_body || {
   };
  if (body.ret_code !== 0) throw new Error(`ret_code=${
     body.ret_code}`);
  return body.list || [];
}
5.5 返回结构(示例)
{

  "showapi_res_code": 0,
  "showapi_res_error": "",
  "showapi_res_id": "示例请求标识",
  "showapi_fee_num": 1,
  "showapi_res_body": {

    "ret_code": 0,
    "list": ["中文", "分词", "接口", "把", "整段", "文本", "拆分", "为", "词", "序列"]
  }
}
以上为示例返回,仅用于说明层级关系,字段与类型以官方文档为准。
| 字段 | 层级 | 类型 | 说明 |
|---|---|---|---|
showapi_res_code |
网关层 | Integer | 0 表示网关受理成功 |
showapi_res_error |
网关层 | String | 网关层错误描述,成功时为空串 |
showapi_res_id |
网关层 | String | 本次请求唯一标识,排查时保留 |
showapi_fee_num |
网关层 | Integer | 本次调用的计数标记 |
showapi_res_body |
业务层 | Object | 业务数据容器 |
showapi_res_body.ret_code |
业务层 | Number | 0 表示业务成功 |
showapi_res_body.list |
业务层 | String[] | 切词结果,按原文词序排列 |
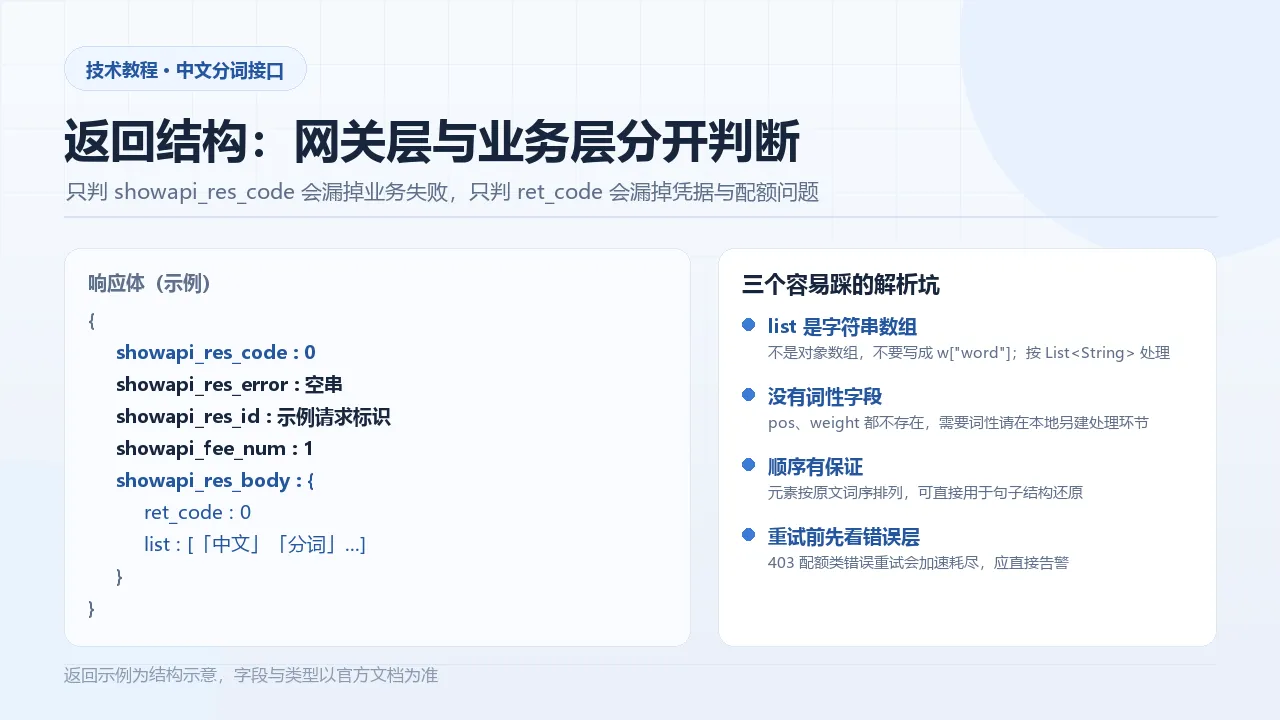
解析上只有一个坑值得提前说:list 是纯字符串数组,不是对象数组。不要写成 w["word"] 去取值,也不要期待 pos 字段存在。把它当成 List<String> 处理即可。
六、调试方法与示例返回
在商品页的调试面板里填参数、看返回,比直接上代码更快定位问题。建议按下面的顺序走:
- 填参。
text填一段 20~50 字的中文,先不测超长文本。 - 看状态码。HTTP 200 是第一关;403/400 基本都是凭据或参数问题,不必往后看。
- 看两层返回码。
showapi_res_code为 0 且showapi_res_body.ret_code为 0,才算真正成功。 - 看
list内容。确认数组非空、元素是字符串、顺序与原文一致。
调试时建议固定跑下面几组边界用例,把观察结果记进接入文档,后续换环境能快速比对:
| 用例 | 输入特征 | 观察点 |
|---|---|---|
| 短句 | 10 字以内中文 | 词数是否合理,是否出现单字碎片 |
| 长句 | 200 字以上,含多个逗号句号 | 是否按句子边界切分,末段有无丢失 |
| 中英混排 | "SKU 编码 A1024,48h 发货" | 英文与数字是否整体保留 |
| 标点密集 | 连续顿号、括号、引号 | 标点是否被丢弃,词边界是否错位 |
| 空参数 | text 为空串 |
返回是业务失败还是 200 空数组 |
| 特殊字符 | emoji、换行、制表符 | 是否触发编码错误或截断 |
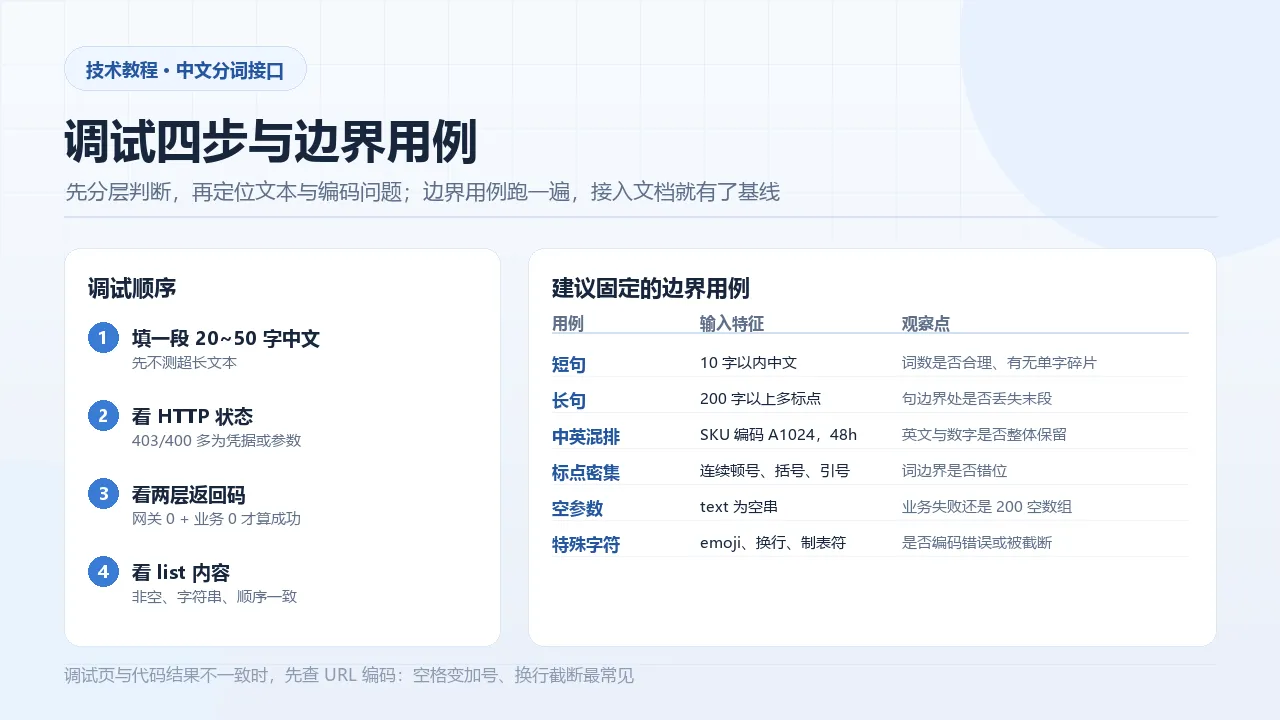
如果某类文本切分结果不符合预期,先判断是"模型粒度问题"还是"参数问题":同一句话在调试页和代码里结果不一致,通常就是编码或换行处理出了偏差(比如代码里用了 + 拼接而没有做 URL 编码,空格变加号导致词边界错位)。
七、调用限制与规范
| 项目 | 规范建议 | 说明 |
|---|---|---|
| 文本长度 | 单次控制在数百字以内,超长按段落切段 | 具体上限以官方文档为准 |
| 字符编码 | 全链路 UTF-8 | 表单提交需 URL 编码 |
| 调用配额 | 按订购的配额规划,留 20% 余量 | 配额耗尽会直接返回 403 |
| 并发控制 | 服务端做信号量或令牌桶限流 | 避免瞬时打满配额 |
| 超时设置 | 连接 3s,读 5s | 超时后进入降级分支,不阻塞主链路 |
| 重试策略 | 仅对 5xx 与超时重试,指数退避 + 抖动 | 该接口无副作用,可安全重试 |
| 幂等与缓存 | 相同文本结果可缓存 5~30 分钟 | 命中缓存的文本不要含个人信息 |
| 请求标识 | 记录 showapi_res_id 与时间戳 |
便于按单次请求回溯问题 |
几个容易踩的实践细节:
- 重试不要无脑放大。网关返回 403(配额类)时重试只会更快耗尽配额,应直接告警。
- 批量场景不要串行循环。一次请求一段文本、几百段串行调用,延迟会叠加;用有限并发 + 结果缓存更划算。
- 不要把分词放在请求同步链路的最前面。它是可异步化的环节,能异步就不阻塞用户响应。
八、能力边界与免责
- 词表覆盖有限。通用词表对垂直领域新词覆盖不足,品牌名、型号、内部代号常被切碎。工程做法:维护一份领域词白名单,在切词结果上做合并校正。
- 结果是概率性输出。同类文本在不同版本模型下可能得到不同切分,不要把"某个词的切分方式"写成断言型单测,改为断言"关键实体是否完整出现"。
- 不做语义理解。接口只返回词序列,词性、实体、情感都需要下游自行处理,不要把它当成完整的 NLP 流水线。
- 合规要求。文本可能含个人信息,处理时遵循最小必要原则:只传业务必需的片段,传输全程 HTTPS,日志中对原文做脱敏或只保留哈希,不长期留存原始文本,并在用户协议中说明文本会经第三方接口处理。
九、错误码排查
| HTTP 状态 | 错误标识 | 含义 | 排查方向 |
|---|---|---|---|
| 400 | A400AC |
AppCode 模式鉴权时未找到 AppCode | 检查 Header 是否写成 APPCODE <appcode>,中间是否多空格 |
| 400 | A400K |
签名模式未找到 AppKey | 确认请求走的是签名模式而非 AppCode 模式 |
| 400 | Invalid AppKey |
AppKey 无效或不存在 | 核对 AppKey 是否复制完整,前后有无空白字符 |
| 400 | Invalid AppSecret |
AppSecret 错误 | 核对密钥,注意换行与空格 |
| 403 | B403MQ |
订购的接口配额已耗尽 | 扩容配额或降低调用量,同时检查是否有异常重试放大 |
| 403 | B403ME |
订购关系已过期 | 续订后复测 |
| 403 | Quota Exhausted |
调用次数已用完 | 与 B403MQ 同类,按配额规划处理 |
| 403 | Quota Expired |
已购次数过期 | 检查资源包有效期 |
| 403 | User Arrears |
账户欠费 | 结清后恢复 |
| 403 | Unauthorized |
应用未被授权调用该接口 | 检查应用与接口的绑定关系 |
| 450 | 无错误标识 | 接口调用成功但业务失败,返回业务错误信息,不扣减次数 | 读 showapi_res_body 内的业务提示,多为参数问题 |
排查顺序建议固定为:HTTP 状态 → 网关层 showapi_res_code → 业务层 ret_code → 文本与编码。先分层再定位,比逐字段猜要快得多。
十、技术 FAQ
Q1:这个接口和自建分词模型的差别在哪?
A:自建模型可控性高但需要标注语料、训练和运维;接口方式把一个 HTTP 调用当作切词能力,优点是接入快、无需运维,代价是粒度与词表由服务方决定,垂直领域需要自己做后处理。
Q2:返回的 list 是对象数组还是字符串数组?
A:是字符串数组。每个元素就是一个词,没有词性、没有权重,直接按 List<String> 处理。
Q3:showapi_res_code 和 ret_code 有什么区别?
A:前者是网关层状态(凭据、配额、欠费),后者是业务层状态(参数是否合法、文本是否可处理)。两者都为 0 才算成功,只判一层会漏掉一半问题。
Q4:一段文本能有多长?
A:具体上限以官方文档为准。工程上建议单次控制在数百字,超长文本按段落或句号切段后调用,再按顺序拼接词序列。
Q5:切词粒度可以调吗?
A:本接入点不暴露粒度参数。需要粗粒度时在结果上做停用词过滤与相邻词合并,需要更细时在本地再切一次单字。
Q6:能识别新词和品牌名吗?
A:通用词表对新词的覆盖有限。常见做法是维护领域白名单,在切词结果上做合并,例如把被拆开的"前置仓"重新合成一个词。
Q7:中英混排会被切成单字母吗?
A:英文单词与数字通常作为整体保留,但带连字符或大小写混排的型号(如 A1024-B)可能被拆开,建议对型号类字段做正则兜底。
Q8:调用失败可以重试吗?
A:可以,接口无副作用,重试安全。但只对超时和 5xx 重试,配额类 403 重试会加速消耗,应直接告警。
Q9:结果需要缓存吗?
A:相同文本短时间内重复调用没有意义,建议按文本哈希缓存 5~30 分钟。含个人信息的文本不要落缓存。
Q10:为什么调试页结果和代码里不一致?
A:多数是编码问题。代码里若用字符串拼接而没有 URL 编码,空格会变成 +、换行会截断,导致文本变形。统一用 --data-urlencode 或语言自带的表单编码。
Q11:可以在前端直接调用吗?
A:不建议。AppCode 放在前端等于公开密钥,且跨域与配额控制都不好做。应由服务端统一转发,前端只调用自己的接口。
Q12:适合放在同步链路里吗?
A:取决于文本长度与配额余量。用户请求强依赖切词结果时可以同步调用并设 5s 超时;否则异步化,避免第三方波动影响主链路可用性。
十一、内容小结
中文分词接口把"切词"这件基础工作变成一次 POST 调用,接入成本低,适合作为检索、标签、聚类、审核等场景的前置环节。落地时把握三点就够了:
- 两层返回码都要判。网关层与业务层分开看,问题定位速度差一个量级。
- 粒度策略要统一。索引与查询用同一套切词口径,避免建了索引查不到。
- 边界与配额要提前设计。超时、重试、缓存、限流四件事在上线前定好,比事后补更省事。
需要验证具体行为时,建议先在调试面板跑一遍本文第六节的边界用例表,把结果记进接入文档,再进生产环境联调。

