
在通义千问Qwen3.8系列里,Max负责能力天花板,Plus负责均衡,而Flash负责另一件事:把单次调用的成本和延迟压到足够低,让"每个请求都调大模型"这件事在业务上跑得起来。很多项目失败不是因为模型不够聪明,而是因为单价太高、响应太慢——一个日均百万次调用的客服系统,用旗舰模型跑,账单和延迟都会失控。Qwen3.8-Flash就是为这类场景准备的档位。下面从模型定位、核心特征、能力边界、典型场景、订阅与计费五个层面完整介绍。
一、模型定位:高性价比的主力工作马
Qwen3.8-Flash在Qwen3.8系列中属于"轻量快速"档,定位是高频、低延迟、成本敏感型任务的主力模型。它与Max的分工不是"能不能做",而是"值不值得用贵的做"。详情👉访问阿里云百炼大模型服务平台页面 了解。
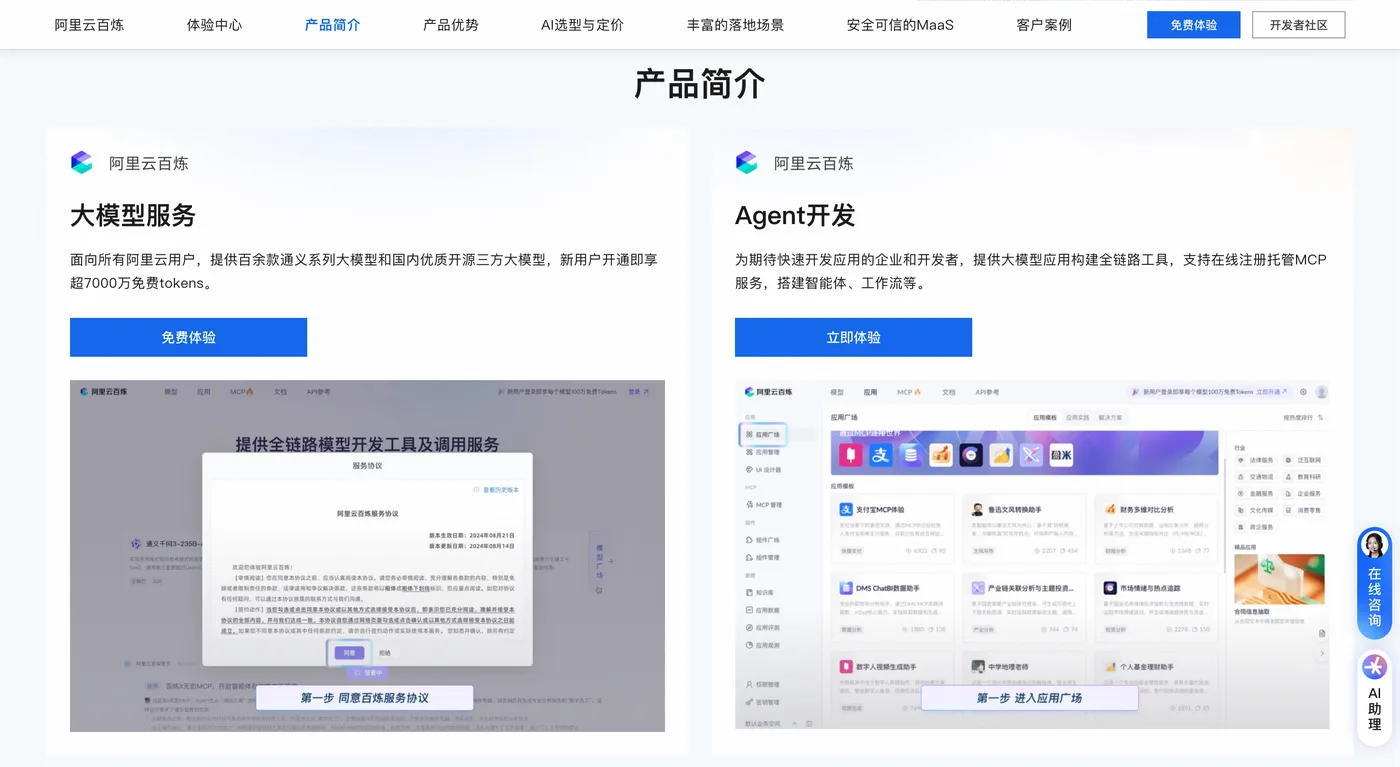
具体来说,它的设计取向有三个:第一,单次推理的算力开销低,同等预算下能跑更多请求;第二,首 Token 延迟和整体响应时间更短,适合交互式场景;第三,能力覆盖足够广,日常任务不必频繁降级到更小模型或升级到旗舰模型。模型 ID 为 qwen3.8-flash,通过百炼平台调用,兼容 OpenAI 与 Anthropic 风格接口,已有工程只需替换 Base URL 与模型名即可迁移。
需要强调的是,Flash 并不是"缩水版"。它的知识面、指令遵循、结构化输出能力足以覆盖绝大多数生产任务,真正被削减的是极端复杂推理、超长链路 Agent 编排这类高消耗场景的上限。判断标准很简单:任务是"一次成型"还是"需要反复推演"。前者用 Flash,后者用 Max。
二、核心特征
第一,低延迟与高并发。 Flash 的推理路径更短,单位时间可承载的并发请求数明显高于旗舰档。对需要实时反馈的业务(在线客服、输入联想、实时翻译、语音助手后端),这个差异直接决定用户体验。并发能力还受订阅档位的 Agent 并发数限制,选套餐时要一并考虑。详情👉访问阿里云百炼大模型服务平台页面 了解。
第二,单位成本低。 在 Token Plan 的 Credits 计量体系下,同一次调用,Flash 消耗的 Credits 显著低于 Max 与 Plus,具体倍率写在模型页的计量说明里。这意味着同样的月度额度,Flash 能跑的任务量是旗舰档的数倍。对于以"量"取胜的业务——批量文案、批量摘要、批量分类、批量抽取——成本差距会直接体现在毛利上。
第三,结构化输出稳定。 支持 JSON Object 与 JSON Schema 严格模式,适合把非结构化文本转成固定字段。做数据清洗、工单分类、发票信息抽取、简历解析这类任务时,结构化输出比"提示词要求它输出 JSON"可靠得多,能显著减少下游解析失败。
第四,工具调用与检索增强。 支持 Function Calling、联网搜索、网页抓取、代码解释器等工具能力,可以承担 RAG 问答中的"最后一公里":检索由外部向量库完成,Flash 负责把召回片段组织成准确、简洁的回答。这类任务的难点在忠实于检索结果,而非自由发挥,Flash 的取向恰好合适。
第五,多模态输入。 支持文本与图像输入,用于截图理解、表单识别、图文混排文档解析。能力上限低于旗舰档的复杂视觉推理(工程图纸、长视频),但日常的票据、截图、商品图识别足够。
第六,深度思考可开关。 支持按需开启推理模式,简单任务关掉以获得最低延迟,复杂任务再打开换取准确率。这个开关是 Flash 实用性的关键——它让同一个模型既能跑毫秒级分类,也能处理需要几步推导的问题。
三、能力拆解:能做好什么,做不好什么
做得好:
- 批量内容生产:商品标题、详情文案、SEO 描述、社媒短文案的批量生成与改写,量大且质量要求中等的场景。
- 客服与问答机器人:基于知识库的标准问答、意图识别、多轮澄清、工单自动归类,要求响应快、答案稳。
- 信息抽取与清洗:合同要素抽取、发票字段识别、日志结构化、评论情感打标,配合 JSON Schema 输出。
- 翻译、摘要、润色:长文摘要、多语翻译、语气改写,属于典型的一次成型任务。
- 代码辅助:单文件补全、函数级重构、注释生成、报错解释、单元测试草稿。跨仓库改造、架构级重构则应交给 Max。
- RAG 问答:召回片段重排、答案组织、引用标注、拒答判断。
做不好或不必用它的:
- 需要几十步工具串联的自主 Agent 长任务;
- 超长文档的跨章节逻辑校验、整套代码库级重构;
- 高难度数学推导、复杂金融建模;
- 工程图纸、长视频这类高精度视觉理解。
这些场景不是完全不能跑,而是失败率和返工成本会上升,综合成本反而高于直接用旗舰档。详情👉访问阿里云百炼大模型服务平台页面 了解。
四、适用场景与选型建议
| 场景 | 建议档位 | 理由 |
|---|---|---|
| 电商批量文案、商品标题 | Flash | 量大、质量要求中等,成本敏感 |
| 在线客服、知识库问答 | Flash | 低延迟、并发高、答案需忠实检索 |
| 工单分类、信息抽取 | Flash+JSON Schema | 结构化输出稳定,出错可校验 |
| 日志分析、评论打标 | Flash | 单条任务简单,靠量取胜 |
| 代码补全、单文件重构 | Flash | 上下文短、任务边界清晰 |
| 全栈项目开发、跨库重构 | Max | 需要长链路规划与自校验 |
| 长合同比对、财报建模 | Max 或 Plus | 精度要求高,幻觉代价大 |
| 高并发混合业务 | Flash 主力+Max 兜底 | 按任务难度路由,兼顾成本与质量 |
一条实用原则是分层路由:请求进来先由 Flash 处理,遇到置信度低、需要多步推理、或用户明确要求深度的请求,再升级到 Plus 或 Max。这套做法在客服、编程助手、内容平台里已经被普遍采用,能把平均成本压到"全用旗舰"的几分之一,同时保住关键请求的质量。
五、订阅与价格解析
Qwen3.8-Flash有两种调用方式,规则独立,密钥不通用。详情👉访问阿里云百炼大模型服务平台页面 了解。
方式一,按量计费。 按实际消耗的输入、输出 Token 计费,适合调用量不稳定、偶尔试用的场景。Flash 的单价档位低于 Max 与 Plus,具体费率以百炼模型页的计价表为准。特点是灵活、无月费门槛,缺点是账单随用量波动,量大时不如订阅可控。
方式二,Token Plan 订阅。 以 Credits 统一计量,一份月度额度可覆盖计划内多个模型与内置工具,Flash 的单次消耗低于旗舰档,因此同样的额度能跑更多任务。个人版四档(价格与额度以订阅页为准):
| 档位 | 月费 | 每月 Credits | Agent 并发 | 适合谁 |
|---|---|---|---|---|
| Lite | 39元 | 20,000 | 1–2 | 个人试用、轻量开发 |
| Essential | 79元 | 45,000 | 2–3 | 日常开发、小型项目 |
| Standard | 139元 | 80,000 | 3–4 | 独立开发者、多任务并行,含 Harness |
| Pro | 312元 | 200,000 | 6–8 | 高频批量任务、重度研发,含 Harness |
新用户首购有5折限时价,Lite 折后19.5元/月、Essential 折后39.5元/月,仅限从未购买过个人版的账号。额度按月重置、不结转;用完可购买用量包补充(100元/个,含20,000 Credits,最多同时持有5个,有效期1个月,不退款)。Standard 及以上赠送 Harness,联网搜索、网页解析、代码解释器这类工具调用不占 Credits,把检索与执行交给 Harness,Credits 全留给模型,是压成本的有效手段。
另有一项常被忽略的省钱点:夜间时段(约22:00至次日8:00)调用有额外折扣,批量摘要、批量打标、离线数据清洗这类不要求实时性的任务,排到夜间跑能再降一档成本。
接入示例:
from openai import OpenAI

client = OpenAI(
    api_key="sk-xxxxxxxx",
    base_url="[https://dashscope.aliyuncs.com/compatible-mode/v1](https://dashscope.aliyuncs.com/compatible-mode/v1)",
)
resp = client.chat.completions.create(
    model="qwen3.8-flash",
    messages=[{
   "role": "user", "content": "把这条商品评论归类为:好评/中评/差评,只输出标签"}],
    temperature=0.1,
    max_tokens=64,
)
print(resp.choices[0].message.content)
结构化抽取场景建议直接约束 Schema:
resp = client.chat.completions.create(
    model="qwen3.8-flash",
    messages=[{
   "role": "user", "content": "从下面的工单文本抽取字段,按 JSON 输出"}],
    response_format={
   "type": "json_object"},
)
六、使用注意事项
第一,别用 Flash 硬扛复杂任务。省下的单价会被返工、复核、重试吃掉,还可能拉低整体交付质量。任务难度判断比价格比较更重要。详情👉访问阿里云百炼大模型服务平台页面 了解。
第二,注意输出预算参数。开启推理模式后,思考内容与最终回答共享同一 Token 预算,沿用只为回答预留上限的旧写法会被截断。
第三,额度与并发要一起看。Credits 决定"能跑多少",并发数决定"同时能跑几个"。批量任务密集但允许排队,Lite 也够;多用户实时并发,则要看 3–4 或 6–8 的档位。
第四,高风险内容必须人工复核。法律、医疗、金融结论不能直接采用模型输出,Flash 的定位是提效工具,不是责任主体。
第五,模型能力范围以官方模型页为准。是否支持某类视觉输入、最大上下文长度等硬指标,随版本更新会调整,选型前查一次当前页面,比记旧数据可靠。
结语
Qwen3.8-Flash的价值不在于跑分,而在于让"高频调用"这件事在经济上成立。它把延迟和单价压到业务可承受的区间,同时保留结构化输出、工具调用、多模态这些生产必需的能力。真正的用法是分工:Flash 承担量大、边界清晰的任务,Max 承担少量高难度任务,用路由把两者串起来。按这个思路配置,多数团队能在不明显牺牲质量的前提下,把 AI 调用成本降到原来的三分之一甚至更低。所有费率、额度、折扣规则以百炼订阅页与模型页实时信息为准。
