standard 模式跑到 executor 刚完成,准备进 grader-report,主会话超时断了。33 个用例的 transcript 全在磁盘上,但没有任何机制能让流程从"executor 已完成、grader 未开始"这个位置继续。
结果是从头重跑,重新消耗 33 次 executor 调用。
这不是加个临时文件能解决的问题。它暴露的是长流程测试执行器的可靠性缺陷:你把执行权交给一个会断的编排器,却假设它能一口气跑到底。
一、先认清楚是谁会断
断的不是被测系统,是测试执行器本身。
standard/full 模式要跑 30 到 50 分钟。这段时间里,主编排器是一个 LLM session,它的中断源有四类:yield 等待 subagent 时超过平台限制、网络连接断开、用户关掉终端、平台容器重新部署。
这四类原因没有共同点,只有一个共同结果——编排器不再回来推进流程。subagent 可能已经干完了活,产物躺在磁盘上,但没人验收、没人推进下一步。
早期行为叫静默断裂。用户下次触发测评,从头开始,之前的全废。
本质上,这是把一个不可靠执行器放在了长流程的关键路径上。测试开发遇到这种情况,第一反应不该是"让它别断",而是"断了之后怎么接上"。前者你控制不了,后者是设计问题。
二、正确恢复由四条约束定义
断点恢复不是"能从中间某处继续"这么含糊。它有一组可判定的标准。
约束 含义 违反后果
已完成不能丢 成功步骤的产物和结论保留 重复消耗调用,token 白烧
未完成不能假装完成 没跑完的步骤不能标成通过 结论失真,带病放行
恢复后不能跳步 从断点续接,不是从任意位置起 依赖关系断掉,后续步骤缺输入
重复执行不能失真 幂等,重跑不改变最终结论 同一测评两次结果不同
核心在于这四条把"恢复"从感觉变成了可验收的行为。checkpoint 文件只是这些约束的落地载体,真正要守住的是这四条。
测试人对此应该敏感——这四条就是状态机的幂等性和一致性要求,和分布式系统里的执行语义是同一套问题,只不过执行器换成了 LLM session。
三、checkpoint 记录的是交接点,不是进度
active-pipeline.json 的字段里,最关键的是三个。
current_step 和 next_step 成对出现,标明断在哪一步、下一步该往哪走。pending_subagents 记录还在运行的 subagent ID——主会话断了之后,watchdog 得知道哪些子任务在飞,才不会重复派发或者漏等。
另外几个字段,started_at 和 timeout_minutes 用来判超时,workspace_dir 指向产物目录,skill 和 mode 标明被测对象和配置。文件通常小于 500 字节,一次测评最多写 4 到 6 次,只在派发长任务时写。
为什么需要一个独立文件,而不是全靠 session.json。因为两者职责不同。
文件 角色 生命周期
session.json 持久状态记录:last_step、verdict、cost 整个测评期间
active-pipeline.json 临时断点保护:当前步骤、pending subagents 仅 spawn 到验收窗口期
session.json 在验收通过后更新,active-pipeline.json 在验收通过后删除。一个长期存在,一个只在断裂窗口期起作用。两者写入时机不同,所以不会冲突。
实际上这里有个容易被忽略的设计点:checkpoint 是临时的。正常执行时它存在时间很短,spawn 后写入,恢复验收通过就删。它只在"主会话意外断裂"这个窗口里有价值。把临时状态和持久状态分开,是这套设计能成立的前提。
四、铁律是 spawn 到 write 到 yield
持久化机制里最重要的不是文件格式,是写入顺序。
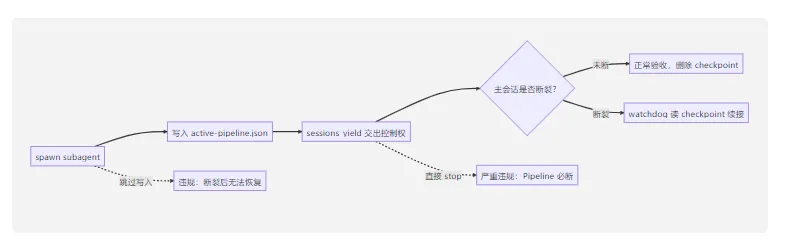
顺序不能反。spawn 之后不写 checkpoint 就 yield,断裂后 watchdog 没有依据判断当前步骤;spawn 之后不 yield 直接 stop,流程必断。
后果不是"恢复慢一点",是 watchdog 只能从 pipeline 起点重新推断状态。推断就可能出错——已经完成的步骤被重复执行,或者跳过某些步骤直接进入后续流程。后者更糟,因为跳步会产生一个看起来完整、实际缺环节的结论。
本质上这跟数据库先写日志再提交是一个道理:先把"我要做什么"持久化,再交出控制权。执行可以中断,意图不能丢。
五、恢复第一步是验收产物,不是展示进度
watchdog 每 10 分钟发一次心跳事件。收到后检查 checkpoint 是否存在,不存在就跳过,存在就查 pending subagents 状态:全部完成则从 next_step 继续,仍在运行且未超时则正常等待,超时则告警。
这里有个关键判断:resume 的第一步不是向用户展示"我从这里恢复了",而是验证当前 checkpoint 对应的产物是否完整。
缺失率不超过 20%,视为完整,继续推进。超过 20%,触发 L2 降级重试,而不是直接跳过。
为什么是验收优先。因为"文件存在"不等于"步骤完成"。磁盘上有 33 个 transcript,不代表这 33 个都可用。测试开发的基本直觉在这里适用:完成态必须有证据,不能靠状态位自证。跳过产物不完整的步骤,等于把未验证的结果当成已通过,后面所有结论都建在沙子上。
验收通过后,主编排器读 session.json 确认上下文,验收上一步产物,从 next_step 推进。Step 0、1、2 不重跑。
六、跳过执行不等于跳过展示
用户手动输入"继续"时,恢复逻辑走的是另一条路:读 session.json 的 last_step 加 pipeline 数组,从 last_step 的下一个开始,跳过前置步骤。
执行上跳过是对的,展示上跳过是错的。
Resume 时必须按顺序逐步输出已完成步骤的摘要,每步一条独立消息。static 步输出 L1 到 L5 的评级和 TP/TN,cases 步输出用例总数和各类分布,executor 步输出三次运行的通过数,然后才是当前步骤。
为什么这么做。用户看到"5/12"但不知道前 4 步是什么结果,就是黑箱,黑箱就是不信任。Resume 的目的是减少执行时间,不是减少展示时间。
这一点值得单独拎出来。执行和证明是两件事——跳过了执行,不等于跳过了举证责任。测试报告的价值从来不在"跑完了",在"能说清楚每一步为什么算通过"。
七、边界情况都是状态不一致
几个边界场景,本质是同一类问题:两个状态源对不上。
场景 根因 处理
checkpoint 在但 session 已标记完成 验收通过、状态更新后,删除前崩了 检测到 last_step 不小于 current_step,直接删 checkpoint
出现多个 checkpoint 设计上不该发生,可能是残留 取 started_at 最新的那个
产物缺失率超过 20% subagent 异常退出或写坏 触发 L2 降级重试,不跳过
SKILL.md 在 resume 前被改 被测对象变了 检测 hash 不一致,提示重测并让用户选
SKILL.md hash 那条最值得看。被测对象变了,之前所有产物都是针对旧版本的证据,继续恢复没有意义。这是测试里的硬规则——证据必须绑定被测对象身份,版本对不上,结论就不成立。
CLI 模式没有 cron 心跳,主会话断开后无法自动恢复,只能手动重启进入同一目录说"继续"。如果 checkpoint 在崩溃前没写成,只能从头跑。这是已知限制,原文把它明确写出来了——把限制写清楚,比假装不存在更能建立信任。
八、效果差异落在四个场景
场景 早期行为 当前行为
主会话断裂 静默丢失,下次从头来 10 分钟内自动恢复
用户说继续 无法恢复,报错 断点续接,附前置摘要
subagent 超时 主会话一直等 超时告警加降级机制
重复触发 从头开始,浪费 token 检测幂等条件,提示复用
四条对应的都是可靠性指标,不是性能指标。系统没有变快,但断了之后不会退回原点。
结尾
长流程测试的价值不在跑得多顺,在断了之后能不能接回正确位置。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。
对照你现在的自动化流程:跑到一半崩了,是能从前一步继续,还是只能从头再来?如果答案是重跑,你为"断点"留过证据吗?