
上一篇说,传统部署时代把资源、部署单元、故障域、运维对象四样东西绑死在一台机器上。虚拟化做的第一件事,就是把这台机器切成很多台。
2013 年前后很多团队做过同一个项目:把 40 台跑着单个应用的物理机,收编到 6 台物理机上,切成几十个虚拟机。硬件采购单一下子少了,机房用电也降了,项目复盘写得很漂亮。
两年后,VM 数量涨到 200 多个,运维反而更累了——补丁要打 200 遍,监控 agent 要装 200 遍,没人能说清哪台 VM 里到底跑了什么。
这个反差,就是今天要讲的全部内容。
一、官方怎么定义这一代
Kubernetes 官方文档对虚拟化部署时代的描述很完整,原文大意是:
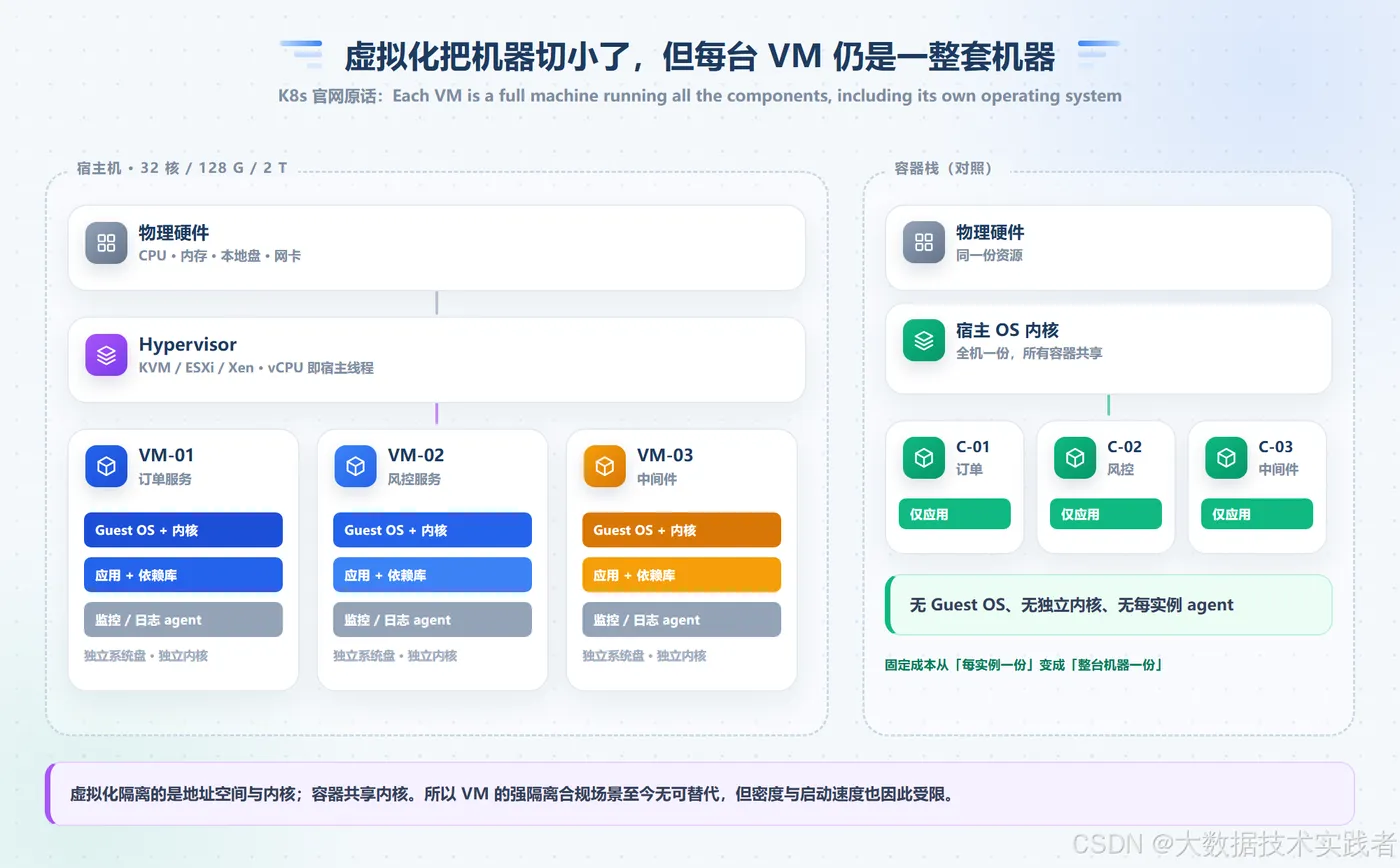
虚拟化允许在单台物理服务器的 CPU 上运行多个虚拟机;应用之间彼此隔离,一个应用的信息不能被另一个自由访问,因而提供一定程度的安全性。它提高了物理服务器的资源利用率,应用可以更方便地添加或更新,降低了硬件成本。你可以把一组物理资源呈现为一个由可丢弃的虚拟机组成的集群。每台 VM 都是一台完整的机器,在虚拟硬件之上运行包括自己操作系统在内的所有组件。
最后半句是重点,也是后面所有缺点的源头:VM 是"一台更便宜、更容易制造的机器",不是一个应用。
顺着这个判断,可以给出本文的核心结论:
虚拟化解决的是硬件层的切分与隔离,没有解决应用层的生命周期管理。 它把"机器"变成了可批量生产、可丢弃的资源单位,但平台认识的仍然是机器,不是里面那个 Java 进程。
二、四个优点:每一个都对应上篇的一个痛点
把优点讲成"机制 + 解决了什么",比列一堆形容词有用。
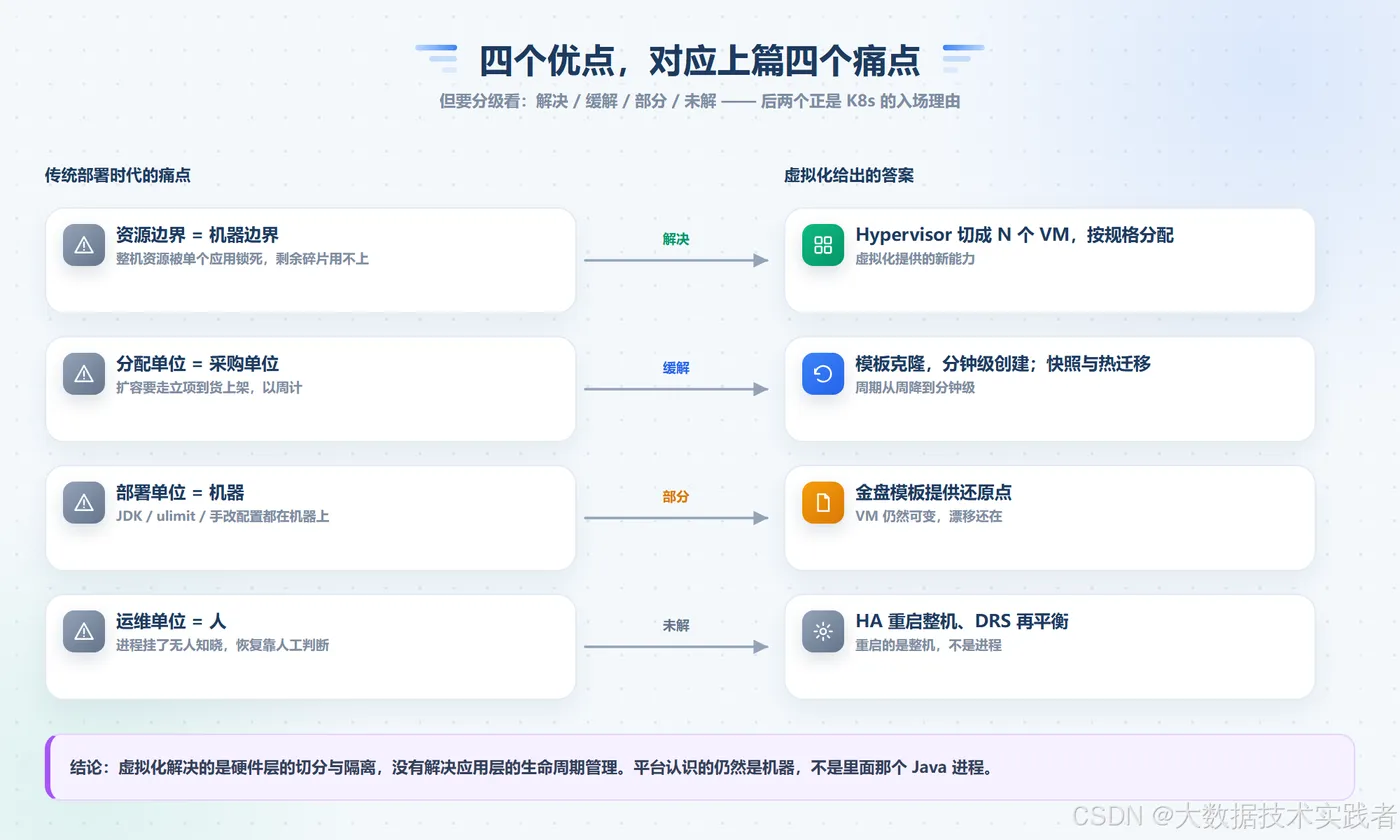
优点一:硬件资源从整块变成可切分
Hypervisor(Type-1 如 ESXi、把 Linux 内核变成 Hypervisor 的 KVM、Xen;Type-2 如 VirtualBox)拦在硬件与 Guest OS 之间,把 CPU 时间片、物理内存页、磁盘块、网卡队列抽象成虚拟硬件。
于是上篇那个"8 核 32G 的机器剩下 1 核 10G 谁也用不上"的问题有了新解法:一台 32 核 128G 的物理机可以切成 8 个 4 核 16G 的 VM,租给 8 个应用。资源不再被一台机器独占,而是可以按规格分配、按 VM 计量、按 VM 回收。
这一步还顺带解决了上篇的"采购周期":扩容从"买一台机器"变成"从模板克隆一台 VM",周期从周降到分钟级。容量不必再提前几个月按峰值买死。
顺带把机制看穿一层。 以 KVM 为例,它不是一个独立进程,而是把 Linux 内核变成 Hypervisor 的一个内核模块;每个 vCPU 在宿主机上就是一个普通线程,通过 /dev/kvm 进入 VMX 的 non-root 模式执行 Guest 代码,遇到特权指令再陷回内核处理。内存靠 EPT / NPT 做两级地址转换(Guest 虚拟地址 → Guest 物理地址 → 宿主物理地址),磁盘与网卡靠 virtio 的前端驱动加 virtqueue 做半虚拟化,或者用 SR-IOV、PCIe 直通绕开模拟。
这个视角能解释后面几乎全部的性能问题:vCPU 是线程,就得跟宿主线程一起排 CFS 队列,超卖比一高,ready time 自然就来了;EPT 只解决地址映射,解决不了 LLC 和内存带宽的争抢;virtio 再快,多个 VM 的 I/O 最后还是落进同一块磁盘的同一个队列。虚拟化隔离的是地址空间,从来不是竞争路径。
优点二:故障域与安全域都缩小了
每个 VM 有自己的内核,特权指令由 Hypervisor 拦截。一个 Guest 内核 panic 不会带倒邻居;一个应用被入侵,也拿不到另一个 VM 的内存。
这一点容器做不到——容器共享宿主内核,namespace 只改变"能看见什么",cgroup 只限制"能用多少",内核漏洞是可以穿透的。所以在多租户、等保合规、不同安全等级共置这类场景里,VM 的强隔离至今仍是硬需求,不是"落后"。
优点三:机器有了完整的生命周期操作
模板、克隆、快照、挂起/恢复、热迁移(vMotion / live migration)——这些能力在物理机时代要么没有,要么要靠停机窗口。
尤其是热迁移:物理机要换内存、换 RAID 卡、做固件升级,可以把上面的 VM 漂到别的宿主上,业务不中断。快照则让"发布前先存一个还原点"变成常规动作。
"可丢弃的虚拟机"(disposable virtual machines)是官方原话,它精准概括了这一代最大的观念变化:机器不再是资产,是消耗品。
优点四:遗留应用零改造,异构 OS 共存
应用运行在 Guest OS 里,完全不需要知道自己被虚拟化了。一台物理机上可以同时跑 CentOS 7 跑 Java 8、Ubuntu 跑 Python、Windows Server 跑 .NET——不同内核版本、不同发行版、不同系统库互不干扰。
这个" lifts-and-shifts 不需要改代码"的特性,是虚拟化能在存量系统里铺开十几年、至今仍大量存在的根本原因。容器化要改构建、改配置、改运维习惯,阻力完全不同。
三、四笔欠账:VM 没有跨过去的那条线
欠账一:每 VM 一套 OS,也就是"OS 税"
官方那句 "Each VM is a full machine running all the components, including its own operating system" 落到账本上是这样的。假设一台 32 核 128 G 的物理机,切 8 个 4 vCPU / 16 G 的 VM,每个 Guest 里常驻:内核、systemd、sshd、监控 agent、日志 agent、备份客户端。保守按 1 G 内存 + 12 G 系统盘 + 0.1 核常驻 CPU 算:
| 项目 | 单个 VM | 8 个 VM | 占物理机比例 |
|---|---|---|---|
| Guest OS 内存 | 1 G | 8 G | 6.25% |
| Guest OS 系统盘 | 12 G | 96 G | 约 5%(按 2 T 本地盘) |
| 常驻 CPU | 0.1 核 | 0.8 核 | 2.5% |
单看这台机器不算多。但真正的规律在下面这张账里——OS 税是固定值,VM 规格越小,占比越高:
| VM 内存规格 | Guest OS 固定开销 | OS 税占比 | 应用实际可用 |
|---|---|---|---|
| 16 G | 1 G | 6.25% | 15 G |
| 8 G | 1 G | 12.5% | 7 G |
| 4 G | 1 G | 25% | 3 G |
| 2 G | 1 G | 50% | 1 G |
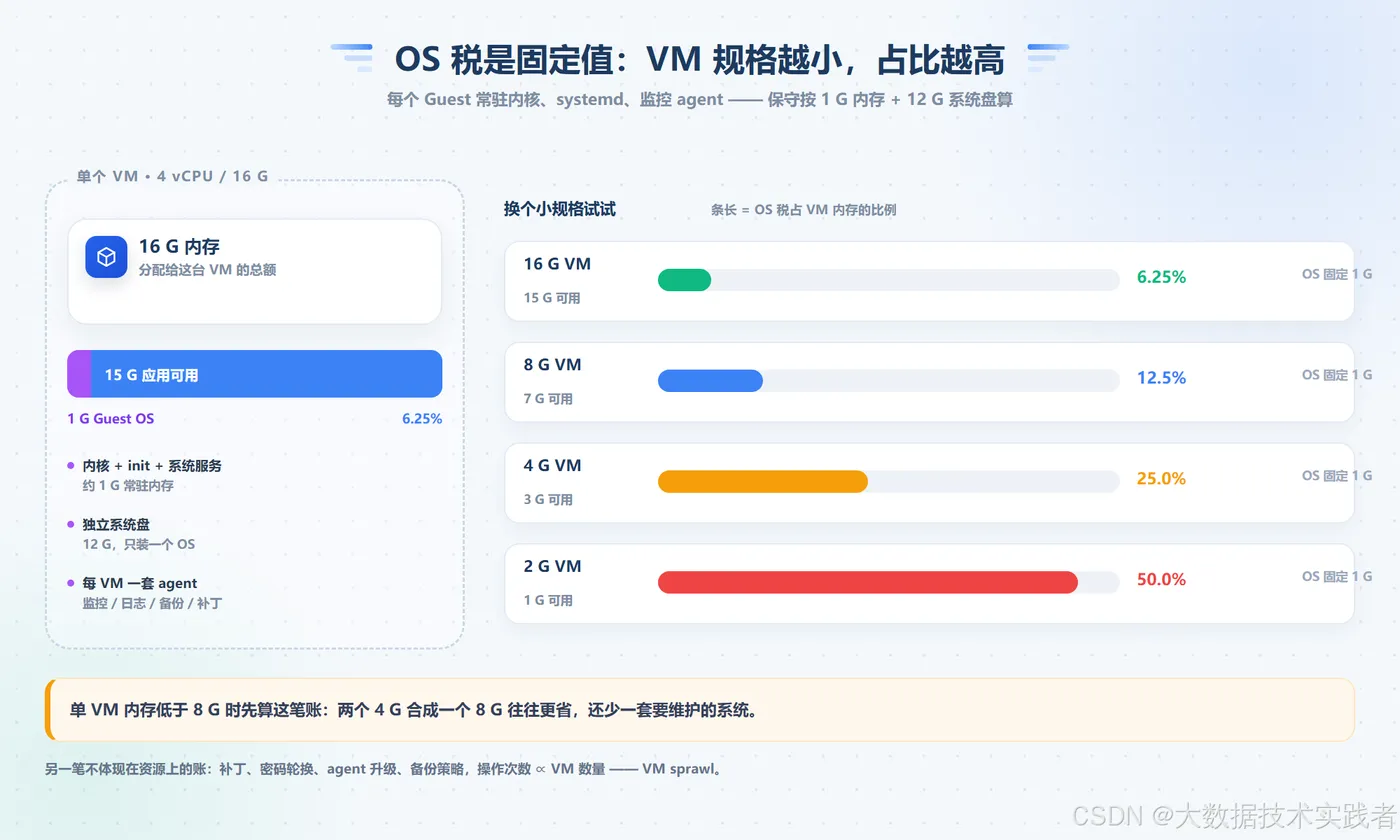
这就解释了为什么虚拟机不适合微服务级别的细粒度切分:把应用拆得越细、每个实例给的规格越小,交给操作系统的那部分就越大。容器的开销接近 0,正是因为它把这份固定成本从"每实例一份"变成了"整台机器一份"。
也由此得到一条很实用的选型经验:单 VM 内存低于 8 G 时,先算一遍 OS 税再决定要不要切。很多时候把两个 4 G 的 VM 合成一个 8 G 的,反而更省,而且少一套要维护的系统。
还有一笔账不体现在资源上:运维操作次数正比于 VM 数量。补丁、密码轮换、agent 升级、备份策略、安全基线,都要按 VM 做一遍。200 个 VM 就是 200 遍——这就是常说的 VM sprawl(虚拟机蔓延),也是开头那个项目两年后更累的原因。
欠账二:启动慢、镜像大,弹性仍不成立
VM 启动要走完整的引导流程:虚拟 BIOS/UEFI → 内核加载 → init → 系统服务 → 应用。分钟级。镜像是完整系统盘,GB 量级,跨宿主分发还要走存储网络。
于是"扩容"虽然从周降到了分钟,但对突发流量仍然不够:等你把 VM 克隆出来、启动完、注册进负载均衡,流量峰值可能已经过去了。自动扩缩容在 VM 时代很少做,不是不想做,是反馈周期太长。
欠账三:隔离不等于性能隔离(noisy neighbor)
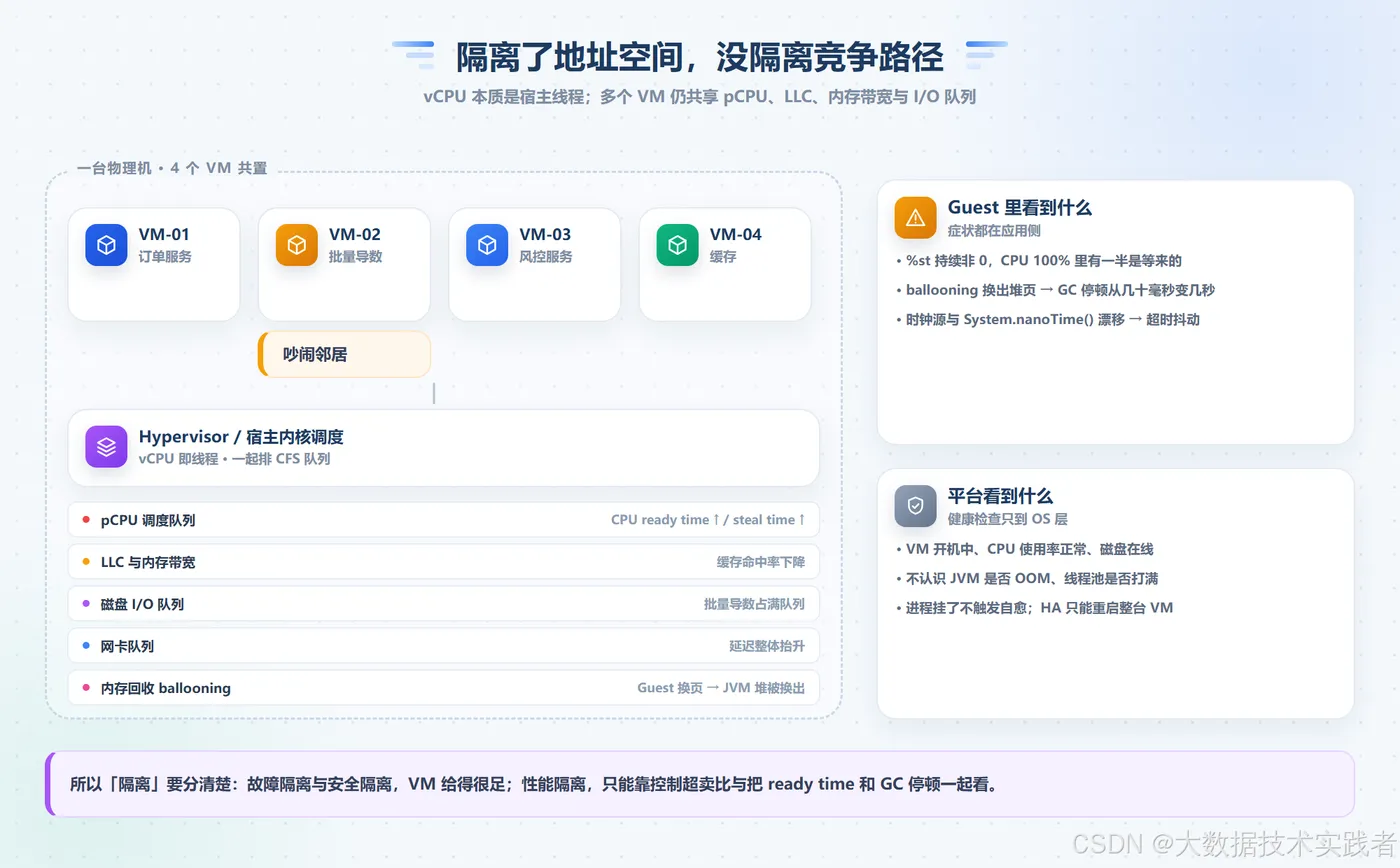
这是最容易被误解的一点。Hypervisor 隔离的是地址空间和内核,不是物理资源的竞争路径。多个 VM 仍然共享:
- pCPU 与调度队列:vCPU 就绪却等不到物理核,就是 CPU ready time;Guest 里看到的是 steal time。
- LLC(末级缓存)与内存带宽:一个 VM 跑大规模扫描,邻居的缓存命中率直接掉。
- 磁盘 I/O 队列与网卡队列:一个 VM 做批量导数,同宿主的延迟全部抬升。
- 内存回收路径:物理内存吃紧时,Hypervisor 通过 balloon driver 在 Guest 内"充气",迫使 Guest 把页面换出去。
对 Java 应用来说,第三条和第四条最要命:ballooning 抽走的是 Guest 的物理页,JVM 堆被换出后,一次本该几十毫秒的 GC 会变成几秒;而 CPU steal 会让所有基于 System.nanoTime() 的超时判断失真。
# 先看 Guest 自己被抢占了多少(steal time,持续非 0 就该查超卖比)
top -bn1 | head -3
mpstat -P ALL 1 3 | tail -5

# 时钟源:VM 迁移后 TSC 不同步是经典的超时抖动来源
cat /sys/devices/system/clocksource/clocksource0/current_clocksource

# 虚拟化平台侧看 CPU ready / balloon(ESXi 用 esxtop 的 %RDY、%MLMTD)
# Linux 宿主可用 virsh domstats 或 perf kvm stat 辅助定位
工程上常见的 vCPU:pCPU 超卖比是 2:1 到 4:1,跑批类负载可以更高,跑低延迟服务就要往下压。这个数字没有普适最优解,唯一可靠的办法是把 ready time 和 GC 停顿一起看,而不是只看 Guest 里的 CPU 使用率——Guest 里看到的"CPU 100%",有可能一半是等来的。
欠账四:平台不认识应用,也不认识"状态"
虚拟化平台的对象是 VM:它知道 VM 开没开机、CPU 用了多少、磁盘在不在。但里面那个 JVM 是否 OOM、线程池是否打满、接口是否还在正常返回,平台一概不知。
后果有三层:
- 没有应用级自愈。 进程挂了,VM 还开着,平台认为一切正常。HA 能做的是"宿主挂了在别的宿主上重启整台 VM",分钟级,而且重启的是机器不是进程。
- 没有期望状态。 调度是"放置"(placement):创建时挑一台宿主放下去,负载高了用 DRS 再平衡。它不会持续比对"我要 3 个健康的副本"和"现在到底有几个活着"。
- 镜像是可变的。 VM 建好之后还能 SSH 上去改配置、装包、打补丁。于是模板与实际运行状态逐渐偏离,金盘(golden image)腐化,"这台能跑那台不能跑"从上篇的机器漂移,变成了 VM 漂移。
# 可变基础设施的典型动作:快照 + 手工改配置
virsh snapshot-create-as vm-order-01 pre-release --disk-only
ssh root@vm-order-01 "sed -i 's/timeout=3s/timeout=8s/' /etc/app/app.conf"

# 三个月后没人记得这台改过,模板里也没有 —— 漂移就是这么攒出来的
注意这和容器镜像的本质区别:容器镜像是不可变的,构建产物就是运行产物,回滚只是换一个 tag;VM 快照是某一时刻的磁盘状态,里面混着配置、数据、临时文件和人工操作,没法作为可复现的发布物。
四、Java / Flink 工程师要额外盯的三件事
堆怎么算。 VM 时代习惯 -Xmx 按 VM 内存硬编码:16 G 的 VM 给 -Xmx12g。这既没给 Guest OS 和 agent 留够,也没法应对 ballooning。容器时代改成按 cgroup 限额的比例(-XX:MaxRAMPercentage=70),JDK 10 起默认开启容器感知:
# VM 时代:按机器规格写死
java -Xms12g -Xmx12g -jar app.jar

# 容器时代:按限额比例,留 30% 给元空间、线程栈、直接内存
java -XX:MaxRAMPercentage=70 -XX:InitialRAMPercentage=70 -jar app.jar
Flink 的总内存怎么算。 Flink 2.3 官网对 taskmanager.memory.process.size 的说明是:包含 Total Flink Memory + JVM Metaspace + JVM Overhead,并明确写着 "On containerized setups, this should be set to the container memory"。反过来说,在 VM 上跑就没有容器 limit 这个天然上界,得自己把 Guest OS、监控 agent、page cache 的那部分减掉,否则 TM 进程和 OS 一起把 16 G 吃满,表现就是周期性被 OOM killer 干掉。
状态后端的盘。 Flink 用 RocksDB 或做 checkpoint 落盘时,虚拟磁盘的 IOPS 和云盘的突发 credits 是隐性瓶颈。虚拟机上"CPU 和内存都够但反压消不掉",十次里有几次要往这查。
# config.yaml —— VM / YARN 环境里必须自己算清总内存边界
taskmanager.memory.process.size: 12288m   # 16G 的 VM 留 4G 给 OS 与其他进程
taskmanager.numberOfTaskSlots: 4

# YARN 下 container 的 vcore 数默认等于 slot 数(-1),
# 且需要集群开启 CPU scheduling 才真正生效
yarn.containers.vcores: -1
五、Flink 的三种部署形态,正好是这三代
这段历史在 Flink 里能一一对应上,而且官网写得很直白。
Standalone = 物理机/VM 时代。 Flink 2.3 官网原文:这是最 barebone 的部署方式,服务只是作为操作系统上的进程启动;"与使用 Kubernetes 或 YARN 这类 resource provider 不同,你必须自己负责重启失败的进程,以及运行期间资源的分配与回收"。这句话几乎就是上篇"运维单位 = 人"的官方版本。
YARN = 虚拟化时代。 资源交给平台的 ResourceManager,由 NodeManager 生成 container,Flink 把 JobManager / TaskManager 放进去,并且能按 slot 需求动态申请和释放。但调度单位仍是较粗的 container——官网配置页里 yarn.containers.vcores 默认 -1,含义是"等于该 TM 的 slot 数",而且需要集群启用 CPU scheduling 才会被真正使用。也就是说,默认按内存调度,CPU 只是个数字。
Kubernetes = 期望状态时代。 execution.target 在 2.3 里只剩六个值:remote、local、yarn-application、yarn-session、kubernetes-application、kubernetes-session。两条 YARN、两条 K8s,加上本地与远程——三代技术的边界,被压缩进一个配置项的枚举里。
| 代际 | 资源单位 | 谁负责重启进程 | 谁负责资源分配 | Flink 对应 |
|---|---|---|---|---|
| 物理机 | 整机 | 人(systemd) | 人(采购) | Standalone |
| 虚拟机 / YARN | VM / container | 人 + 平台 HA | 平台放置 | yarn-application |
| 容器 / K8s | Pod | 控制器 | 控制器持续 reconcile | kubernetes-application |
六、什么时候仍然该选虚拟机
虚拟化没有被淘汰,它只是回到了自己擅长的那格。下面这些场景,VM 依然是更合理的选择:
- 强隔离与合规:多租户、等保、不同安全域共置,需要独立内核边界。
- 异构 OS / 遗留系统:Windows 应用、特定内核版本、无法改构建的老系统。
- GPU 直通与特殊硬件:PCIe passthrough、需要独占设备的场景。
- 有状态中间件:部分数据库、Kafka broker 这类吃本地盘与稳定网络身份的负载,VM 的热迁移和固定 IP 更好操作。
- 需要热迁移的维护窗口:硬件升级不能停机的场景,这是容器编排要额外做很多工作才能逼近的能力。
反过来,无状态服务、需要秒级弹性、要求构建物可复现、副本数多到人力管不过来——那就该往容器走了。
判断标准仍然可以沿用上篇那条线:平台认不认识你的应用。认识,就能做应用级自愈和声明式扩缩;不认识,再强的隔离也只是把机器做小了。
写在最后
虚拟化是一次很成功的"降本":它把物理机切成可批量生产、可丢弃、可迁移的资源单位,让硬件不再被单个应用锁死。上篇的四个痛点,它实打实解决了两个半——资源切分、故障与采购周期;环境一致性靠模板缓解了一部分,运维对象却反而变多了。
它没跨过去的那条线是:平台的对象仍然是机器,不是应用。 只要对象还是机器,健康检查就只能到 OS 层,自愈就只能重启整机,发布物就还是会被人手工改掉。
