在日常测试工作中,造数几乎是绕不开的一个环节。
也有不少测试同学会选择直接写 SQL 插入数据,或者手动组装接口请求来完成造数。但这些方式都会存在一些问题:
- 手动操作效率低: 需要反复在页面执行相同的操作,尤其是涉及多个业务模块时,步骤比较繁琐。
- SQL 造数维护成本高: 需要了解数据库表结构、字段约束以及表之间的关联关系,业务逻辑复杂时更容易出错。
- 接口造数重复性高: 需要手动准备请求参数、处理接口依赖关系等。
有没有一种更轻量的方式,可以减少这些重复工作?
我实践了一种基于 Skill 的自动化造数方案。它可以根据接口文档、HAR 文件、CURL 命令或者 SQL 表结构,自动分析业务关系,并生成 Postman 请求、SQL 脚本或 Python 造数脚本,帮助测试人员更快地完成测试数据准备。
下面结合几个实际场景,看看具体怎么使用。
先了解一下这个造数 Skill
这个 Skill 的核心思路是:将已有的接口信息或数据库结构作为输入,让 AI 理解业务和数据之间的关系,再根据造数需求生成对应的执行文件。
目前支持四种输入方式:
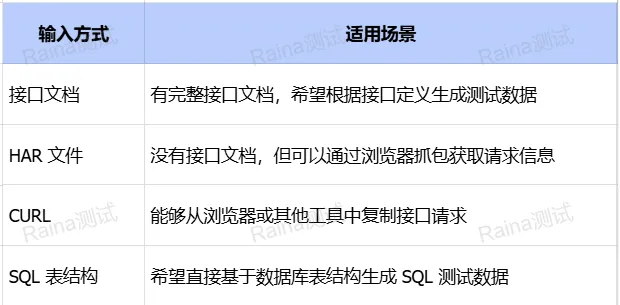
使用方式
一、基于接口文档生成测试数据
1. 执行 Skill
首先准备好需要使用的接口文档,然后在对话框中输入:
/seed-test-data @接口文档
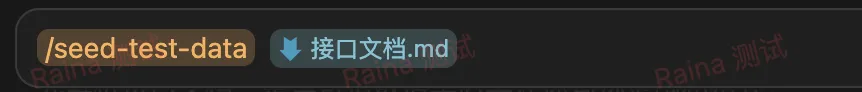
Skill 会读取接口文档,分析接口定义、请求参数以及接口之间可能存在的业务依赖关系。
2. 根据实际需求回答造数问题
完成接口分析后,Skill 会进一步询问造数需求,主要涉及四个方面:
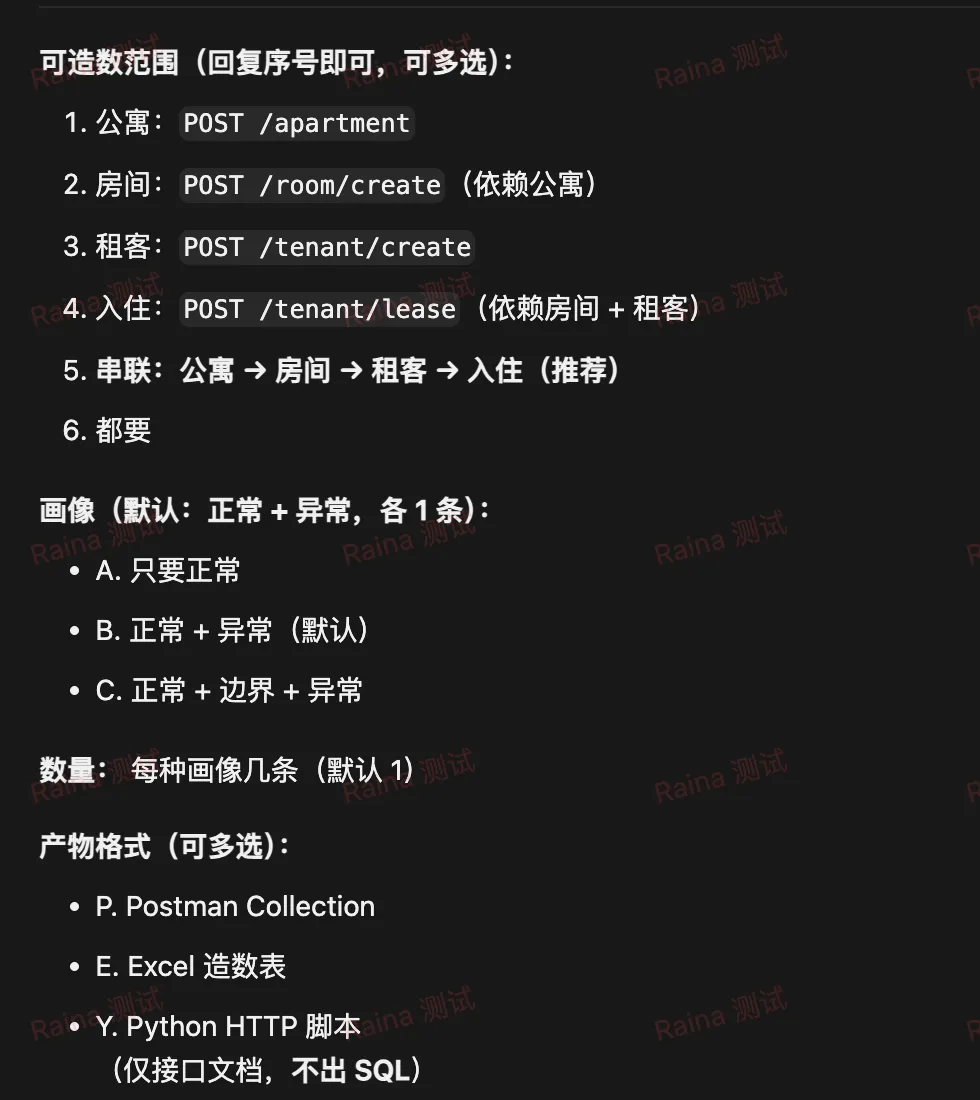
① 造数范围
通常有两种选择:
- 单接口造数:针对某一个接口独立生成测试数据。
- 接口串联造数:按照业务流程依次调用多个接口,生成一套完整的关联数据。

② 数据画像
主要用于指定希望生成哪一类测试数据:
- 正常数据:满足业务规则和字段约束的数据。
- 边界数据:针对最大值、最小值、长度限制等边界条件生成数据。
- 异常数据:构造缺失字段、非法格式、无效参数等异常场景。
不同的数据画像可以对应不同的测试目的,可以根据当前测试任务选择。
③ 生成数量
根据实际测试需求指定数据量,例如 5 条、10 条或者更多。
④ 产物格式
目前支持三种主要产物:
1. Postman Collection
生成可以导入 Postman 或 ApiPost 的请求集合,适合单接口造数,可以直接调整参数并手动执行。
- Excel 数据表
将生成的数据整理成 Excel 文件,不同业务数据可以放在不同 Sheet 中,比较适合手工测试使用,也可以作为性能测试的数据准备来源。
- Python 脚本
生成可执行的 Python 造数脚本,支持按照预设业务顺序调用接口,并处理接口之间的数据依赖。对于需要批量生成关联数据的场景,这种方式更加方便。
3. 查看生成结果
完成上述配置后,Skill 就会根据需求生成对应文件。
本次主要生成了 Excel 数据表和 Python 造数脚本。
Excel 数据表
打开生成的 Excel,可以看到不同业务对象分别放在独立的 Sheet 中。

Python 造数脚本
除了 Excel,还会生成一份 Python 脚本。
脚本中包含接口调用逻辑、参数组装以及随机数据生成逻辑,可以根据预设的业务顺序完成数据构造。
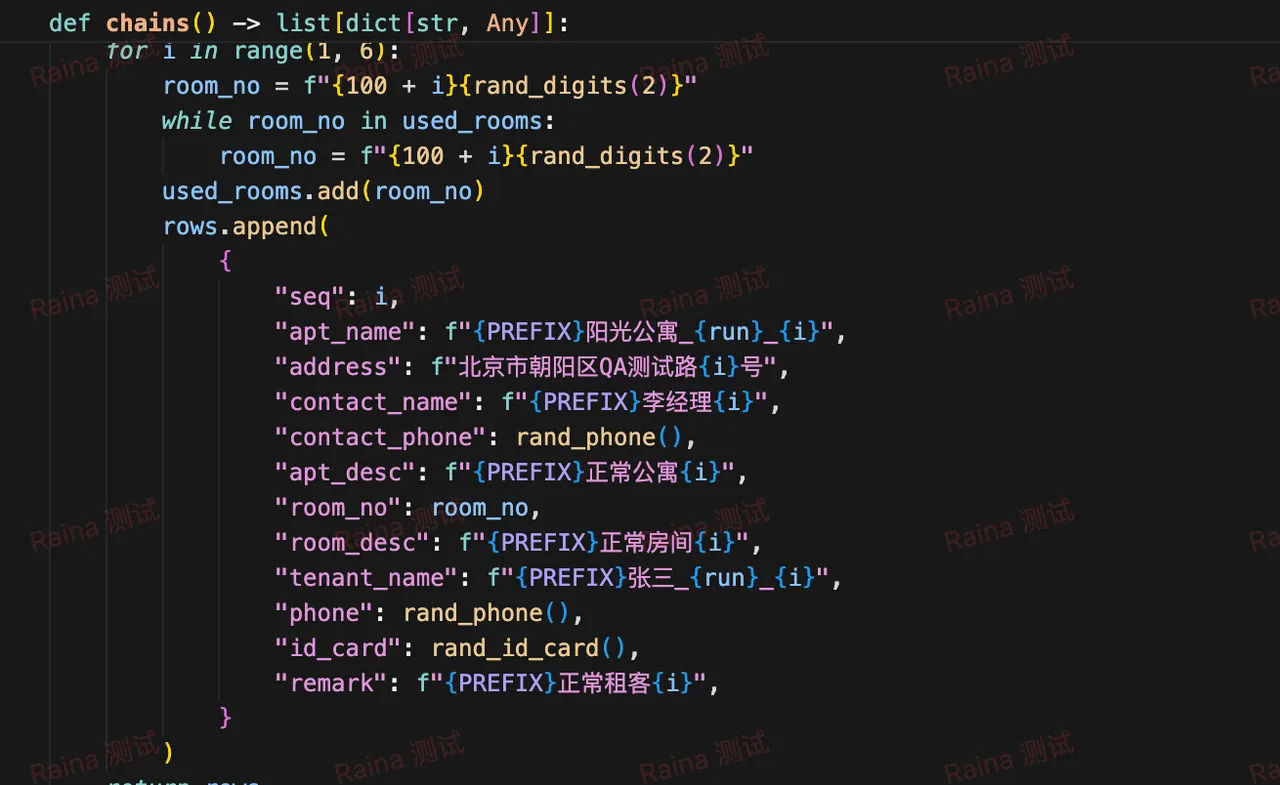
如果有个性化的造数需求,也可以直接查看源码,了解具体的参数生成和接口调用逻辑,再根据项目实际情况修改。
另外,接口调用通常需要配置鉴权信息,例如 Cookie、Token,以及不同环境下的接口地址。
因此,Skill 还会配套生成 .env 文件,用于统一管理这些环境变量。
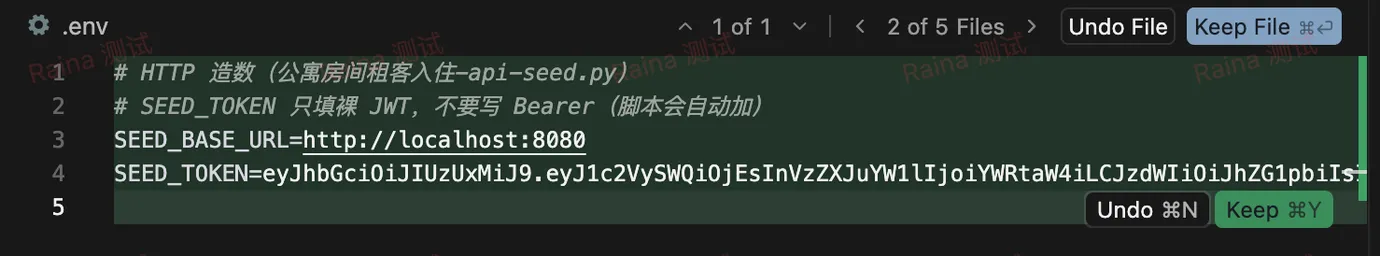
将实际使用的接口地址和鉴权参数填入对应配置项,就可以为脚本执行做好准备。
4. 执行造数与数据回滚
文件准备完成后,就可以执行 Python 脚本了。
这里提供了两个主要命令:
seed:执行造数任务,按照预设流程调用接口并创建测试数据。
rollback:执行数据回滚,清理本次造数创建的数据。
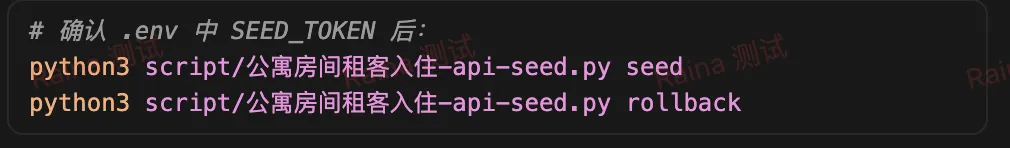
需要注意,回滚功能依赖接口文档中是否提供了对应的删除接口。如果没有可用的删除接口,就无法自动生成完整的接口回滚逻辑,需要根据实际情况补充数据清理方案。
执行造数命令后,可以看到脚本按照预设流程依次调用接口。
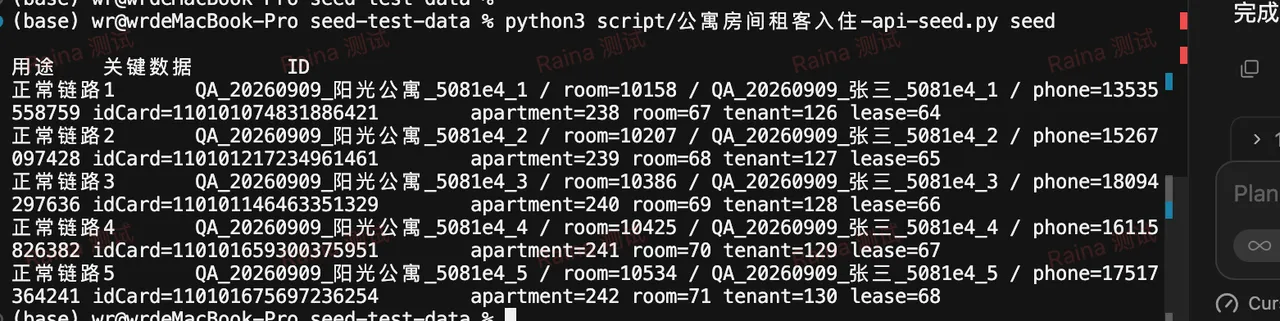
再到业务系统中检查一下,可以看到对应的公寓、房间、租客等数据已经成功创建。
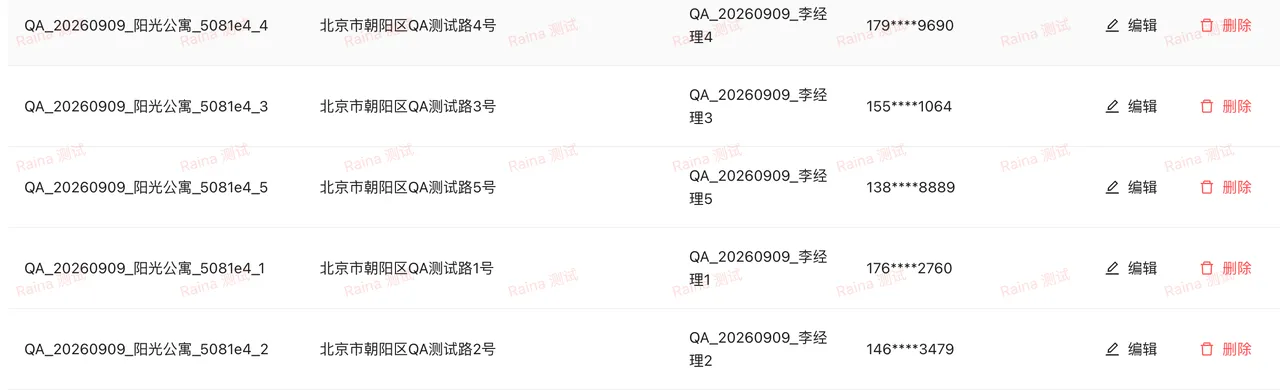
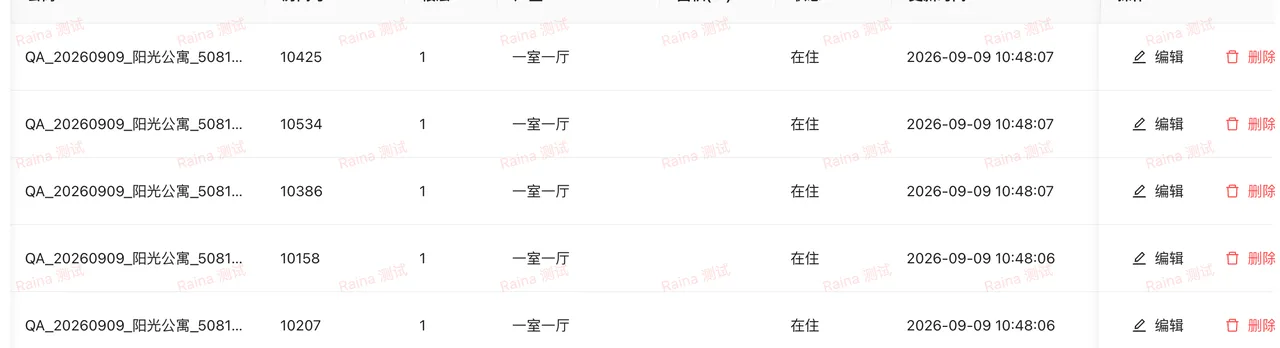
测试完成后,如果需要清理本次创建的数据,再执行对应的 rollback 命令即可。

这样,一套完整的测试数据就完成了从生成、创建到清理的过程。
二、没有接口文档如何造数?
实际项目中,并不是所有接口都有完整的接口文档。
有时候,测试人员只能通过浏览器操作业务功能,再借助抓包工具获取接口请求信息。
针对这种情况,也可以使用 CURL或HAR 文件作为输入源。
方式1:通过 CURL 命令快速生成造数脚本
如果只需要使用某几个接口,也可以直接通过 CURL 命令作为输入
1、获取 CURL 命令
打开浏览器开发者工具,进入 Network 面板。
操作需要造数的业务功能,找到对应的接口请求,右键选择:
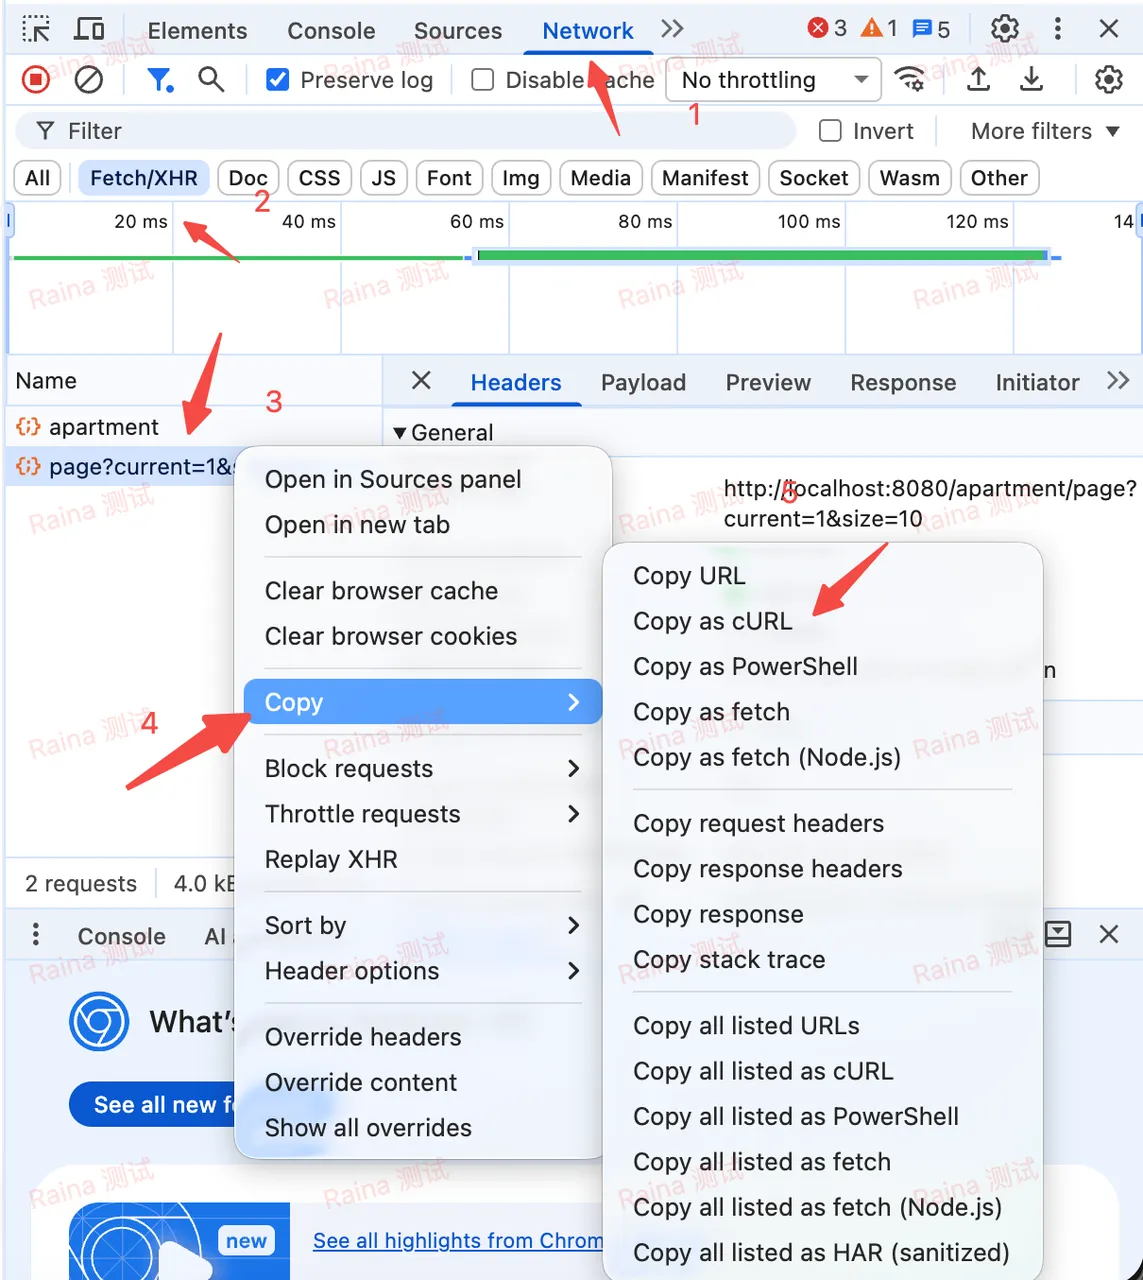
这样就可以获取完整的 CURL 请求信息,通常包含请求 URL、请求方法、请求头和请求参数等内容。
2、执行 Skill
将复制的 CURL 命令提供给 Skill:
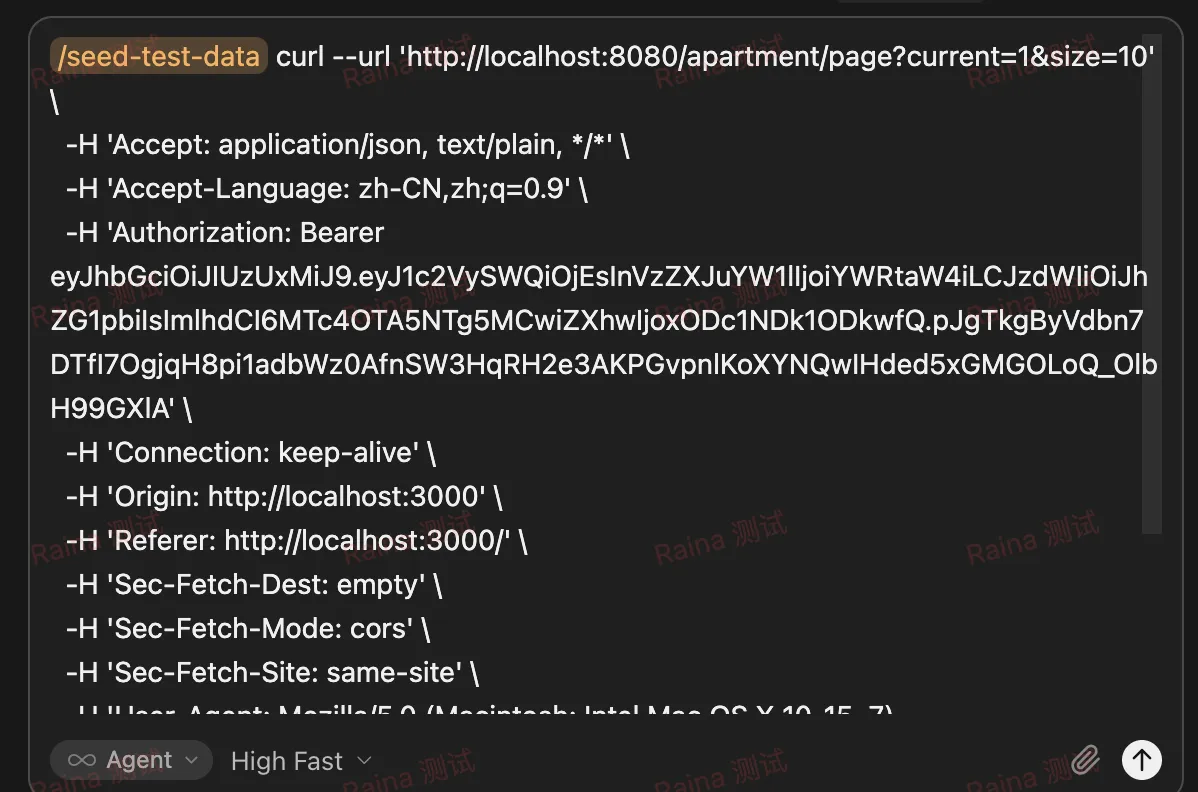
Skill 会根据请求信息分析接口参数,并进一步询问造数范围、数据画像、生成数量和产物格式等需求。
完成配置后,就可以生成对应的造数脚本。
方式2:使用 HAR 文件造数
HAR(HTTP Archive)是一种记录 HTTP 请求和响应信息的文件格式,通常可以从浏览器开发者工具中导出,里面包含请求地址、请求方法、请求头、请求参数等信息。
1、准备 HAR 文件
打开浏览器开发者工具,在 Network 面板中操作需要造数的业务功能,记录相关接口请求,然后将请求数据导出为 HAR 文件。
2、执行 Skill 并生成脚本
准备好 HAR 文件后,直接将文件作为输入提供给 Skill。
后续流程与接口文档造数基本一致:
- 分析 HAR 文件中的接口请求。
- 确认造数范围和业务数据画像。
- 设置需要生成的数据数量。
- 选择最终产物格式。
完成问题答复后,Skill 就会根据抓包信息生成对应的造数文件。
这种方式的好处是,不需要提前整理完整的接口文档,只要能够获取到相关请求信息,就可以尝试构建造数流程。
三、基于 SQL 表结构直接生成造数 SQL
前面介绍的三种方式,本质上都是通过接口完成测试数据构造。
如果某些测试场景不需要调用业务接口,而是希望直接向数据库中插入测试数据,也可以使用 SQL 表结构作为输入。
1、准备数据库表结构
首先准备需要造数的数据库表结构 SQL 文件。
建议除了提供建表语句,还要补充表与表之间的关联关系,以及必要的字段约束和业务规则。
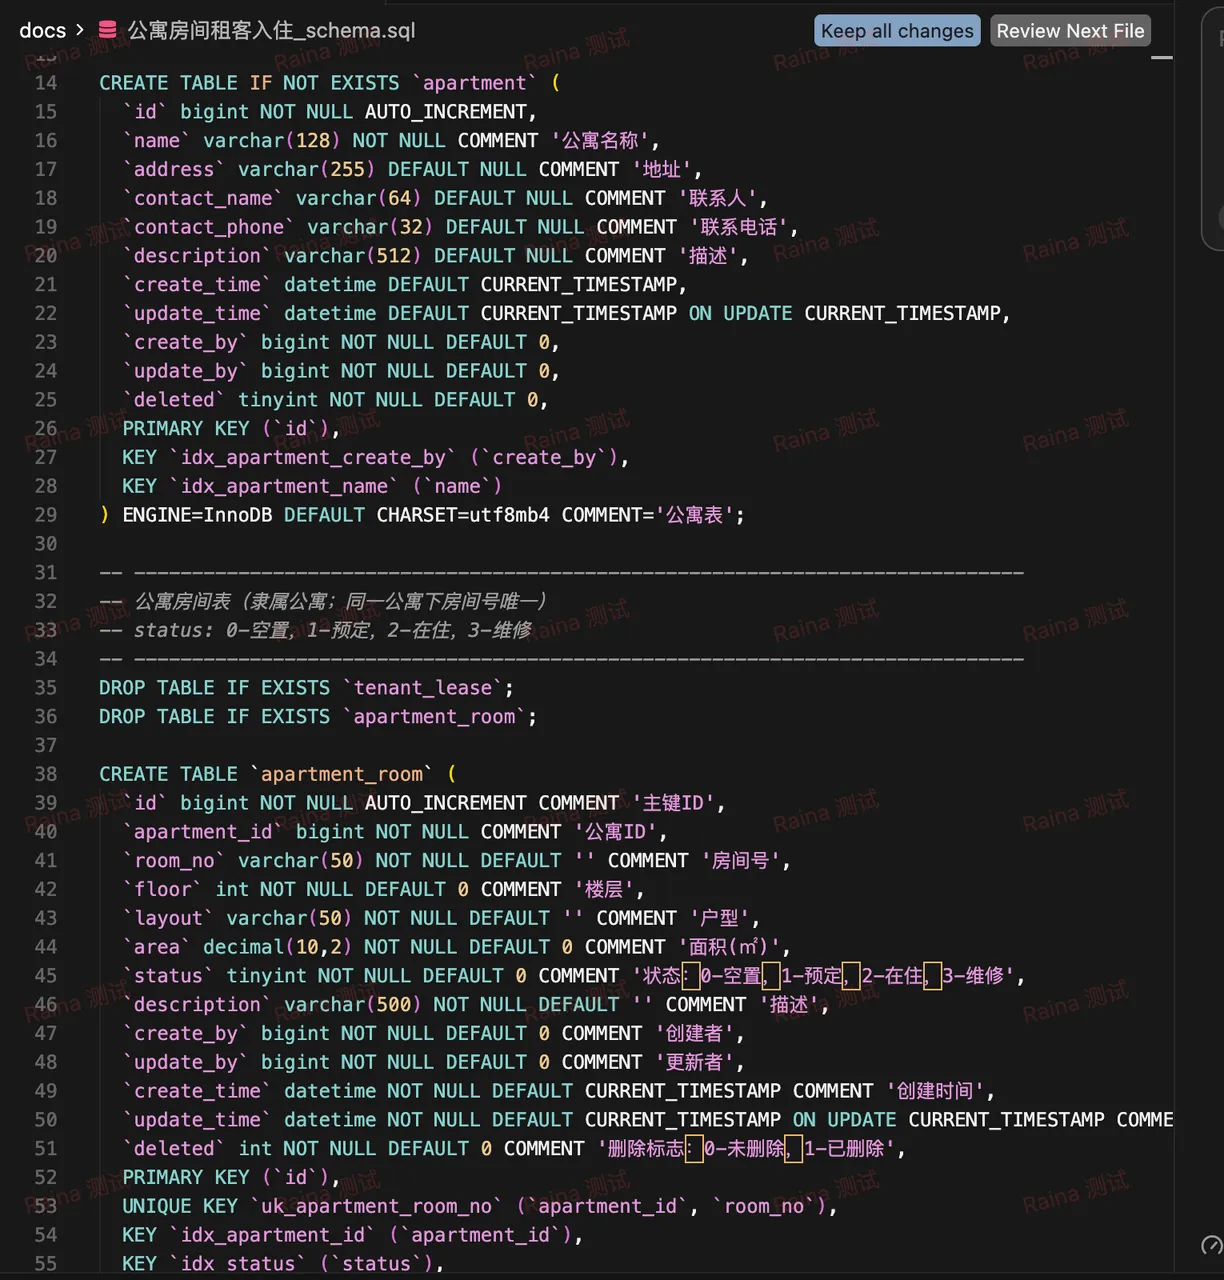
这些信息越完整,生成的数据就越容易满足实际业务要求。
2、执行 Skill
准备好 SQL 文件后,输入:
3、配置造数需求
与前面的案例类似,Skill 会依次询问造数需求。
4、查看生成结果
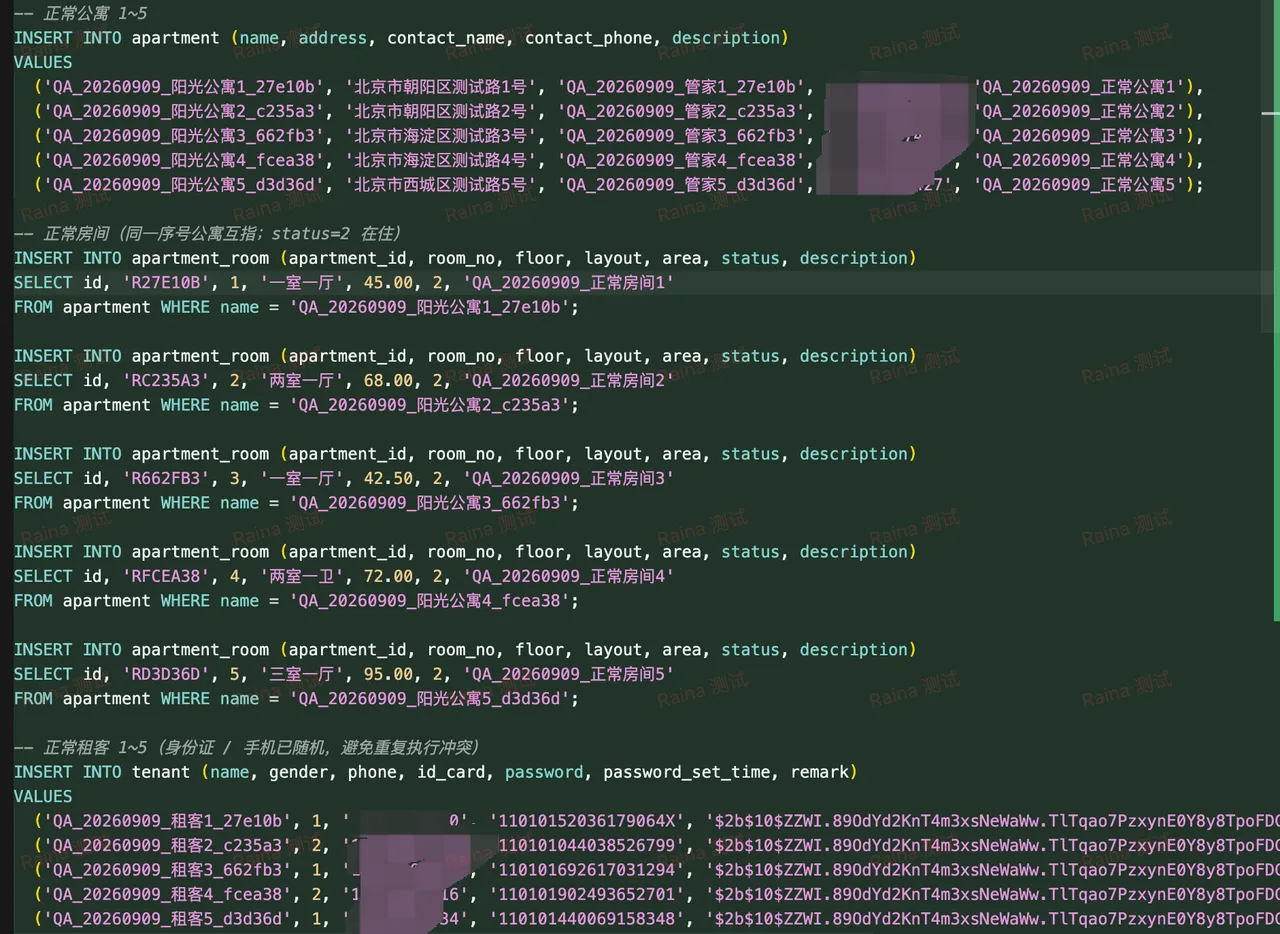
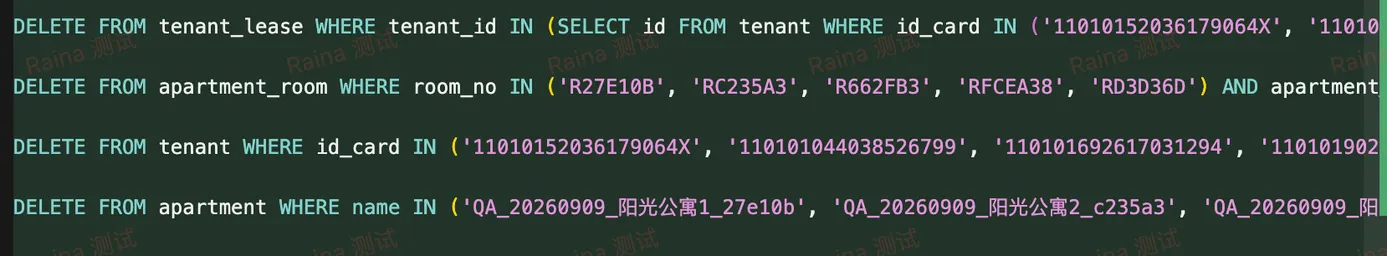
完成配置后,Skill 会生成两个 SQL 文件:
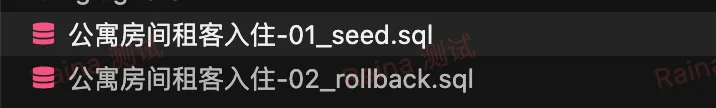
造数 SQL
用于向数据库中插入测试数据,包含对应的字段和值。
回滚 SQL
用于删除本次生成的测试数据,方便测试完成后进行数据清理。
这里需要特别注意:SQL 造数虽然比较直接,但一定要确认数据表的外键约束、唯一性约束、必填字段以及关联关系,避免因为数据不完整导致执行失败,或者影响已有业务数据。
另外,执行回滚 SQL 前也应确认删除范围,避免误删其他测试数据。