写 Agent 的人几乎都会在同一个问题上栽跟头。用户身份该放哪里,数据库连接该放哪里,跨轮要记住的偏好又该放哪里。LangChain 给了两个长得很像的容器,state 和 context,文档各讲各的,真到动手装数据时,一半人放错。这一篇把两者的区别一次讲透,标准是五个维度,落点是三个典型症状和一条决策口诀。
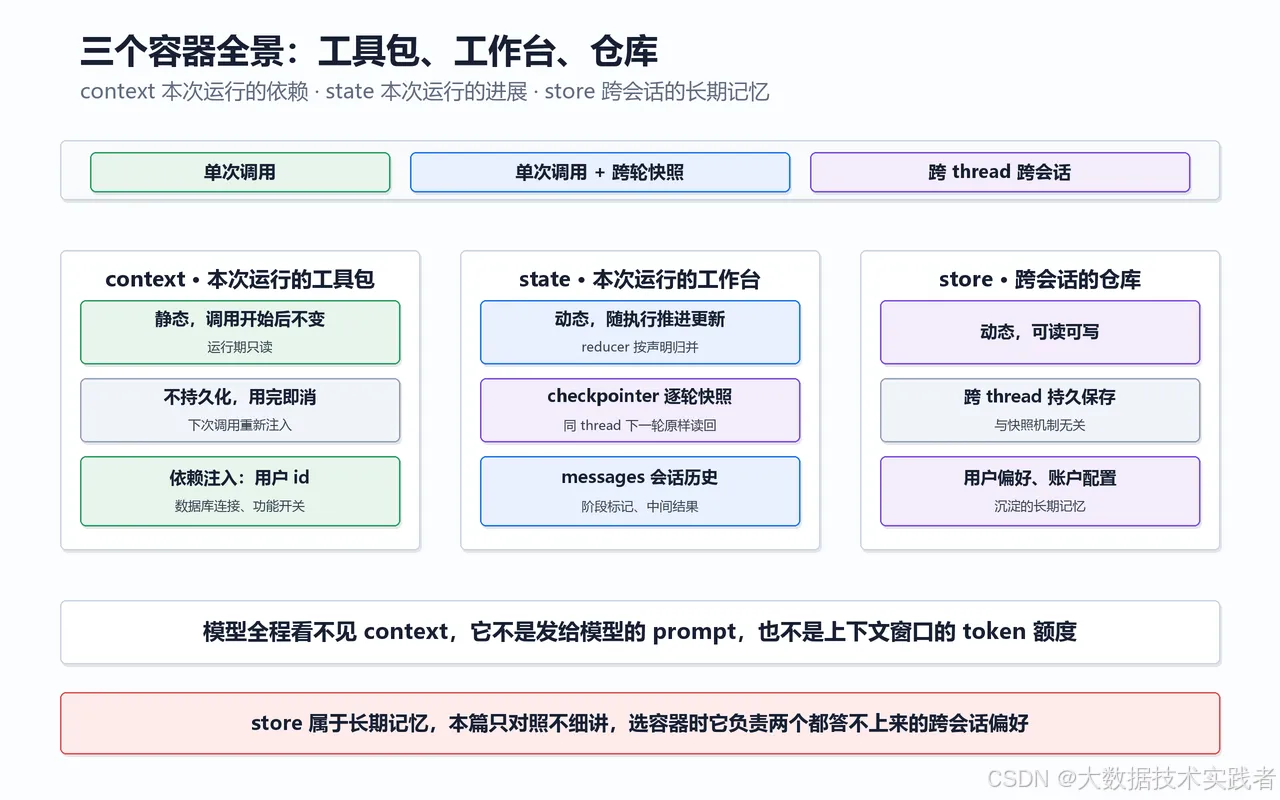
先澄清一个名字的误会。本文说的 context 是 runtime context,运行时上下文。它不是发给模型的 prompt,也不是上下文窗口的 token 额度,更不是模型看到的东西。它是你的代码在运行时需要的依赖和数据,模型全程看不见它。
一、三个容器,先看全景
官方把运行期数据分成三类,state 和 context 只是其中两个。
| 容器 | 定位 | 可变性 | 生命周期 |
|---|---|---|---|
| context | 本次运行的依赖 | 静态,调用开始后不变 | 单次调用 |
| state | 本次运行的进展 | 动态,随执行推进更新 | 单次运行,可随快照跨轮 |
| store | 跨会话的长期记忆 | 动态 | 跨 thread 跨会话 |
一句话记住分工。context 是本次运行的工具包,state 是本次运行的工作台,store 是跨会话的仓库。store 属于长期记忆,前面系列还没展开,本篇只对照它,不细讲。
二、state,会呼吸的运行状态
state 是 Agent 的短期记忆本体。它动态,模型每答一轮、工具每执行一次,state 都可能被更新。它承载 messages 会话历史,也承载你自己加的业务字段,第二十篇讲过的订单号、检索文档都住在这里。
两个关键性质。
第一,state 随 checkpointer 持久化。挂上 checkpointer 之后,每一轮结束都落一份快照,下一轮同 thread_id 进来,state 原样读回。这是多轮对话能记住 Bob 名字的机制基础。
第二,state 有归并规则。字段上可以声明 reducer,工具和中间件的更新按声明归并,不做简单覆盖。这套机制决定了 state 适合承载会演进的数据,执行到哪一步了,查到了哪些中间结果。
声明上有一个硬约束,state_schema 必须是 TypedDict,Pydantic 和 dataclass 都不行。
from typing import Annotated
from langchain.agents import AgentState


class CustomState(AgentState):          # 必须 TypedDict
    refund_stage: str                   # 默认覆盖
    verified_ids: Annotated[list[str], operator.add]   # 追加
三、context,本次运行的工具包
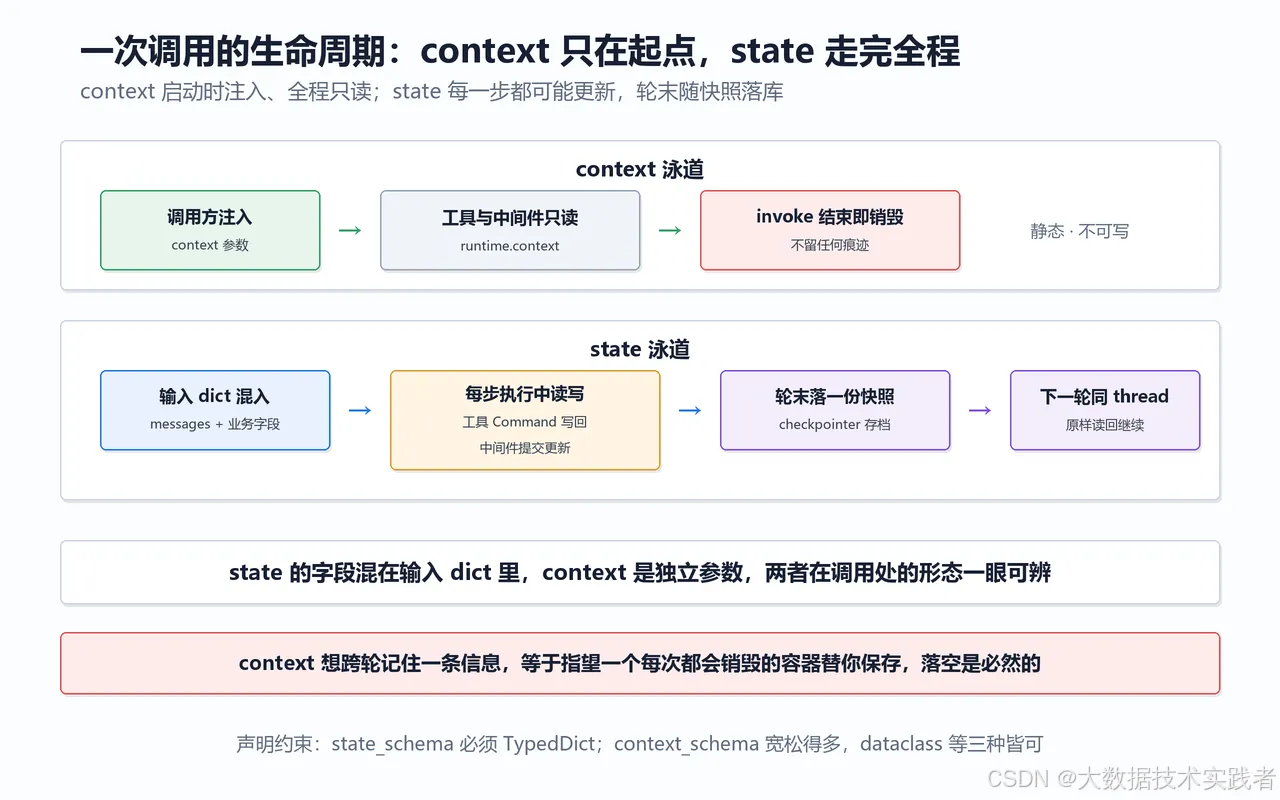
context 走的是另一条路。它静态,调用开始时由你显式传入,整次运行期间不变,工具和中间件对它只读。它也不持久化,invoke 结束就消失,下一次调用要什么就得再传什么。
这套设计的名字叫依赖注入。数据库连接、当前用户 id、租户 id、功能开关,这些运行依赖不写死在工具代码里,而是每次调用时从外面注入。工具不关心用户是谁,只管从 runtime.context 里取。好处直接,Agent 变成无状态的纯逻辑,换一个用户传一份新 context 就行,测试时注入 mock 对象也顺手。
声明比 state 宽松,dataclass、TypedDict、Pydantic 都支持。
from dataclasses import dataclass
from langchain.agents import create_agent


@dataclass
class ContextSchema:
    user_id: str
    tenant: str
    db_conn: object


agent = create_agent(
    model="openai:gpt-5.5",
    tools=[get_order],
    context_schema=ContextSchema,
)
调用时通过 context 参数传入,输入 dict 和 schema 实例都收。
result = agent.invoke(
    {
   "messages": [{
   "role": "user", "content": "查一下我的订单"}]},
    context=ContextSchema(
        user_id="u_123",
        tenant="east",
        db_conn=pool.connect(),
    ),
)
注意对比。state 的字段是混在输入 dict 里的,messages 和业务字段同一个包。context 是独立参数,和 state 分得干干净净。
四、代码里怎么访问
工具里两者都从 runtime 取,泛型注解把类型写全,context 走属性访问,state 走键访问。
from langchain.tools import tool, ToolRuntime


@tool
def get_order(runtime: ToolRuntime[ContextSchema, CustomState]) -> str:
    """查询当前用户订单。"""
    user_id = runtime.context.user_id        # 依赖,只读
    stage = runtime.state["refund_stage"]    # 进展,可读可写
    return query(runtime.context.db_conn, user_id, stage)
中间件里,dynamic_prompt 的入参 ModelRequest 两条路都通,这也是两者最容易被混用的一处。
@dynamic_prompt
def personalized_prompt(request: ModelRequest) -> str:
    name = request.runtime.context.user_id       # 本次身份
    stage = request.state.get("refund_stage")    # 运行进展
    return f"你是售后助手,当前阶段 {stage},服务用户 {name}"
语义差别要分清。context 里的身份每次调用都要重新传,不传就没有。state 里的进展跨轮留存,这一轮工具写进去,下一轮同 thread 还在。同样一行代码取值,取的是两种命运的数据。
五、放错地方的三个症状
容器选错,bug 的长相是固定的。
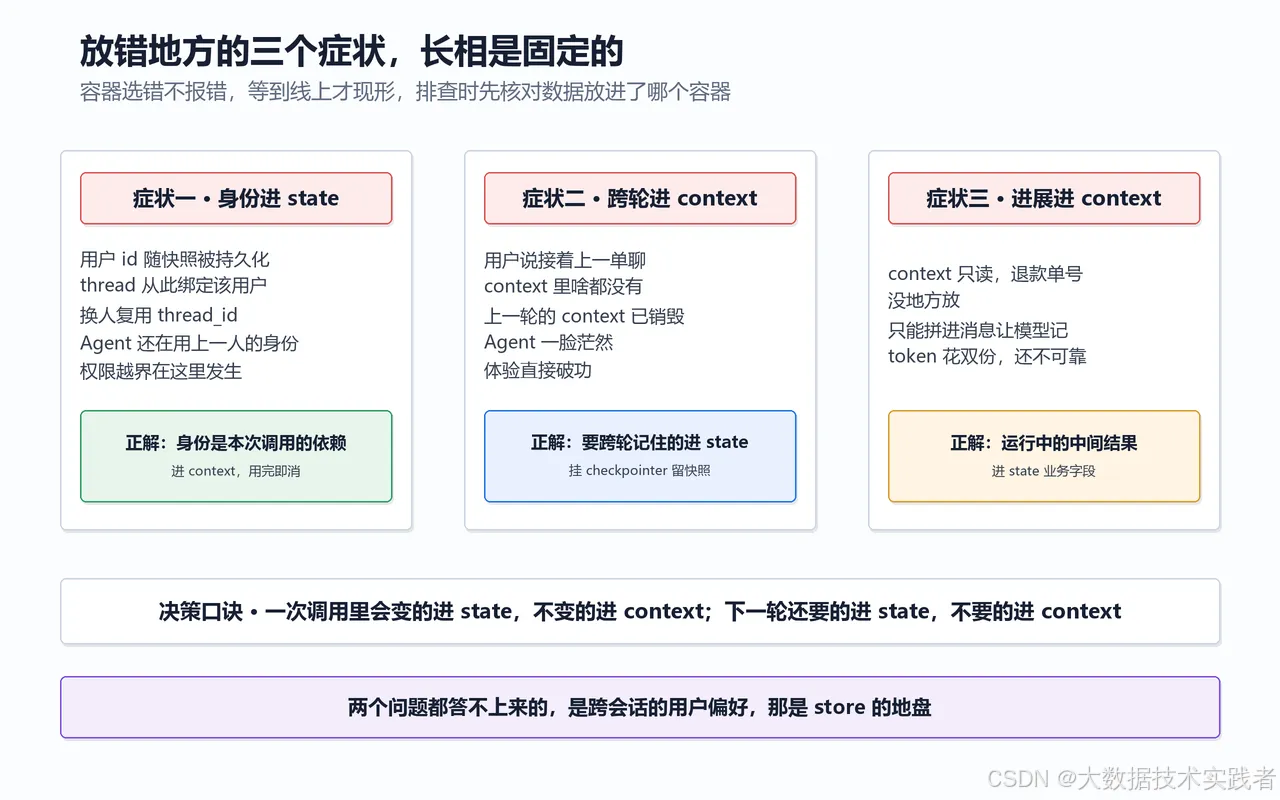
症状一,身份放进 state。用户 id 随快照被持久化,这个 thread 从此绑定了这个用户。换人接着用同一个 thread_id,Agent 还在用上一个用户的身份查数据,权限越界就在这里发生。隐私数据落库多了,合规审计也多一摊事。身份是本次调用的依赖,进 context,用完即消。
症状二,跨轮信息放进 context。用户第二轮说接着上一单聊,context 里啥都没有,因为上一轮的 context 已经销毁了。Agent 一脸茫然,体验直接破功。要跨轮记住的东西,进 state 挂 checkpointer。
症状三,中间进展放进 context。context 只读,工具查到退款单号没地方放,只能拼进消息里让模型记,token 花了双份,还不可靠。运行中产生的中间结果,state 里的业务字段才是它的家。
六、五个维度对比速查表
| 维度 | state | context |
|---|---|---|
| 定位 | 本次运行的进展 | 本次运行的依赖 |
| 可变性 | 动态,随执行更新 | 静态,运行期不变 |
| 持久化 | checkpointer 逐轮快照 | 不持久化,用完即消 |
| 声明约束 | 必须 TypedDict | dataclass 等三种皆可 |
| 传入方式 | 混在输入 dict | 独立 context 参数 |
| 工具访问 | runtime.state 键访问 | runtime.context 属性访问 |
| 典型内容 | messages、阶段标记、中间结果 | 用户 id、数据库连接、功能开关 |
| 写入方 | 工具与中间件提交更新 | 只有调用方注入 |
七、一条口诀收尾
选容器的时候问自己两个问题。这条信息在一次调用里会不会变,会变的进 state,不变的进 context。这条信息下一轮还要不要,要的进 state 让快照留住,不要的进 context 用完即消。
两个都答不上来的,大概率是跨会话的用户偏好,那是 store 的地盘。把这条口诀贴在工位上,state 和 context 从此不再放错。