
很多企业做数据治理时,都会碰到三个特别容易混淆的概念:数据目录、数据血缘、数据地图。 有的企业把数据库、表、字段全部登记下来,就说自己建了数据地图;有的平台把几十张表之间的上下游关系画出来,也叫数据地图;还有人认为数据目录和数据资产目录是一回事,血缘只不过是“表A指向表B”。
但真正放到企业数据治理里,这三者解决的其实是三个完全不同的问题:数据目录回答“企业到底有什么数据”;数据血缘回答“这些数据从哪里来、经过什么加工、最终去了哪里”;数据地图回答“人怎样找到、理解并使用这些数据”。
如果把企业的数据体系想象成一座城市:数据目录像地址簿,告诉你城市里有哪些地点;数据血缘像道路网,告诉你这些地点之间怎么连接;数据地图,则把地点、道路、区域、搜索和导航真正组织到了一起。
理解这个区别非常重要。因为很多数据治理项目后期不好用,并不是功能不够,而是从一开始就把三个不同层次的问题混在了一起。
一、数据目录:不是“表清单”,而是企业的数据资产索引
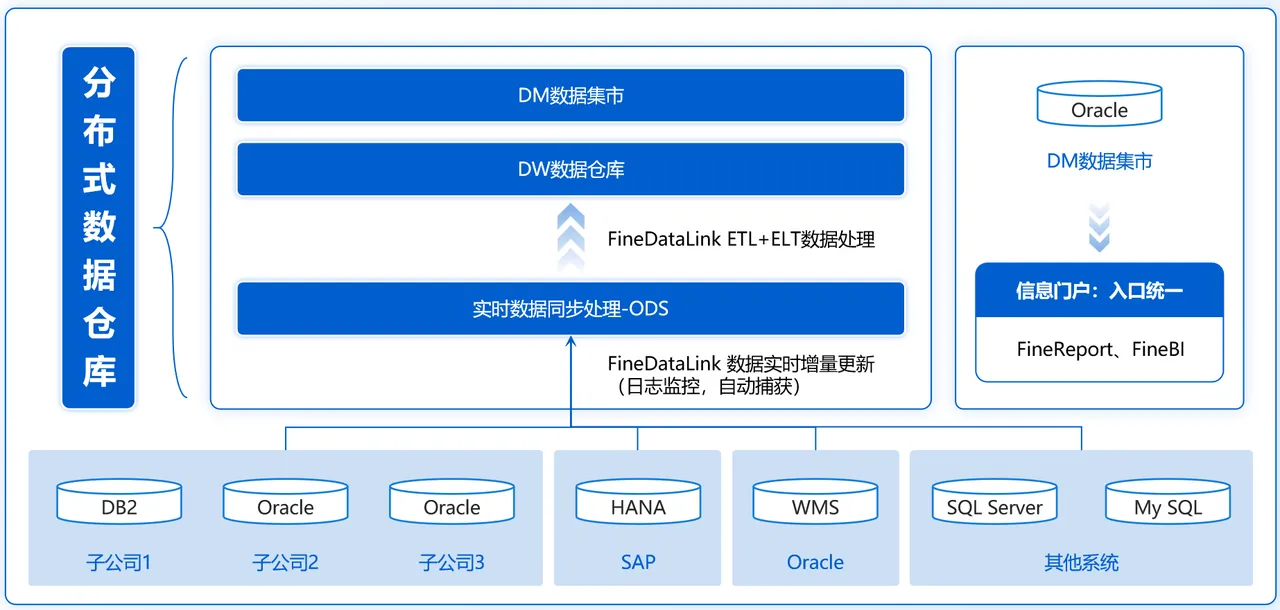
企业数据治理最先遇到的问题,很多时候不是数据质量差,也不是血缘不清,而是:根本不知道自己到底有哪些数据。 一家运行十几年的集团,可能同时存在ERP、CRM、MES、WMS、财务、供应链、OA以及各种自建系统。
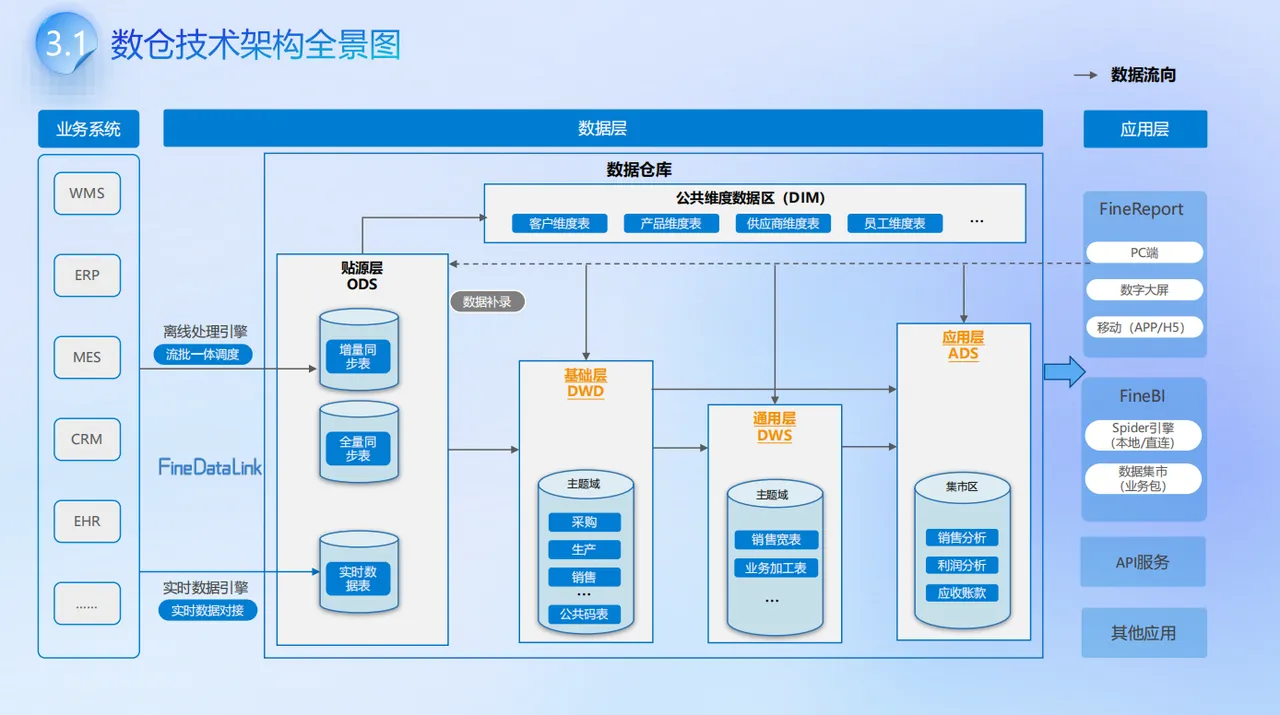
数仓里又有ODS、DWD、DWS、ADS几层模型。最后就会出现一种非常典型的状态:同一个客户,可能存在十几张表;同一个销售额,可能有多个字段、多个口径;一张表到底还用不用、谁负责、多久更新一次,也没人说得清。
所以数据目录最基础的作用就是:把数据资产先盘清楚。 但真正的数据目录,绝不只是列出:数据库A有100张表,数据库B有200张表。 一套可用的数据目录,至少要同时管理三类信息。
技术元数据
包括:数据库、Schema、表、字段、字段类型、存储位置、数据量、更新时间。 它解决的是:数据在技术上是什么。
业务元数据
包括:业务名称、业务定义、指标口径、主题分类、业务标签、使用说明。 例如字段叫:t_cust_lv,技术人员知道这是一个客户等级字段,但业务真正关心的是:什么叫A级客户?评级规则是什么?多久更新一次? 所以业务元数据,本质上是在把技术语言翻译成业务语言。
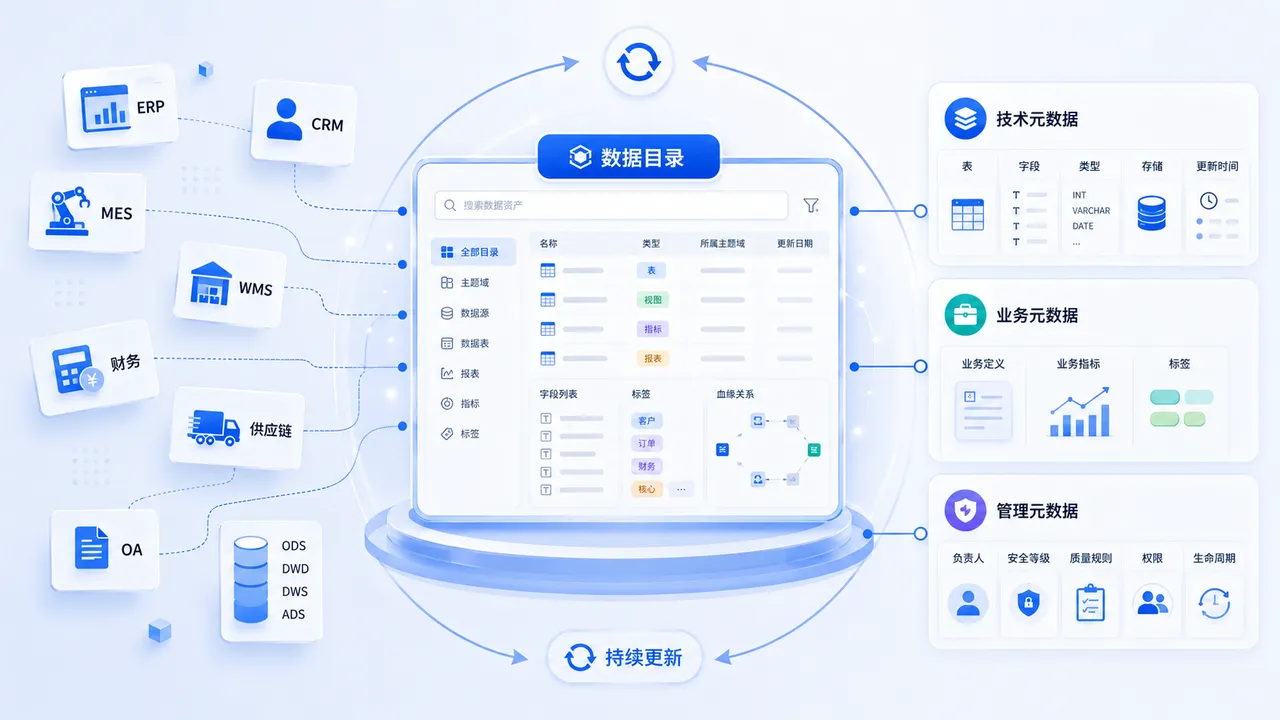
管理元数据
包括:负责人、所属部门、敏感等级、质量状态、权限要求、生命周期。 它回答的是:谁对这份数据负责,这份数据能不能用,谁可以用。
所以数据目录真正的价值,不是“把数据库重新抄一遍”,而是:把散落在各个系统里的技术对象,逐渐变成企业可以理解和管理的数据资产。
但目录建设还有一个很现实的问题:第一次盘点容易,持续更新很难。 今天新建20张表,明天改5个任务,下个月再更换一批数据源。如果每次变化都靠治理人员重新登记,半年以后目录很容易变成一份“历史档案”。真正做过资产盘点的人会发现,目录最怕的不是第一次整理不完整,而是整理完以后没人持续更新。
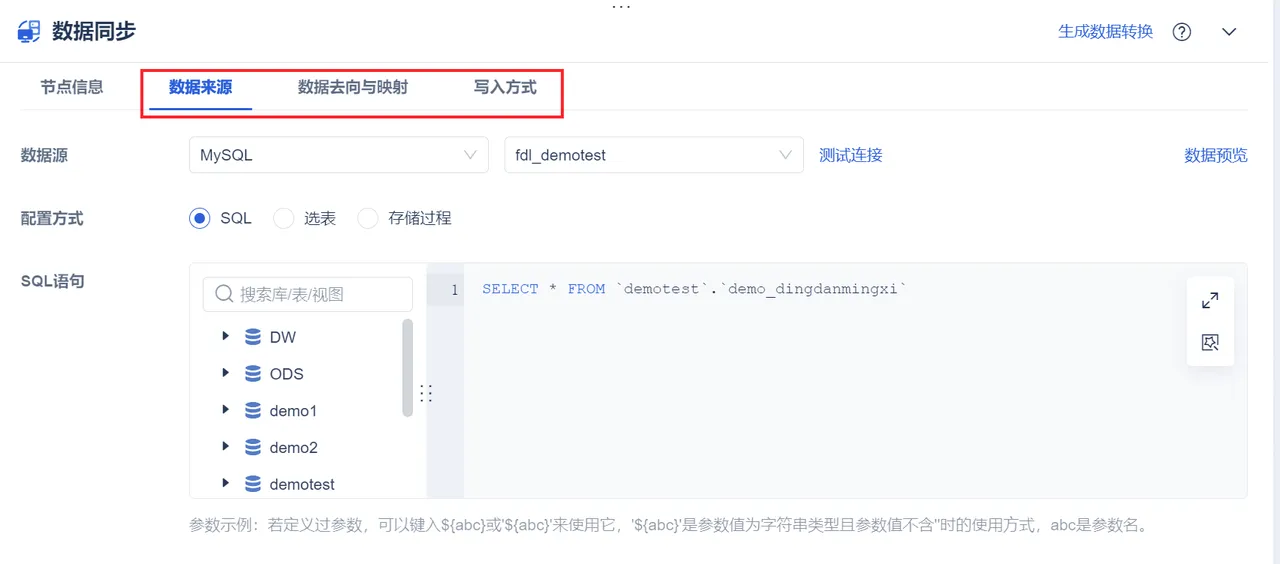
当企业的数据同步、加工和实时链路本身已经在FineDataLink 5.0中运行时,数据库连接、表结构、定时任务、实时管道这些信息,其实每天都在随着开发过程发生变化。治理侧与其隔一段时间重新发起一轮人工盘点,不如尽量复用这些真实运行过程中产生的元数据和任务关系。目录只有跟着数据环境一起变化,才可能从一次性的资产清单,变成真正可持续的数据索引。
二、数据血缘:真正要回答的是“这个数字为什么会变成现在这样”
如果说数据目录管理的是一个个“点”,那么数据血缘管理的就是点和点之间的关系。最简单的血缘可能只是:A表 → B表 → C表。
但真实企业里的数据链路远没有这么简单。假设管理层在经营看板中看到一个指标:华东区域本月毛利率18.6%。
有人突然问:这个18.6%到底是怎么算出来的? 真正追下去,可能会发现:
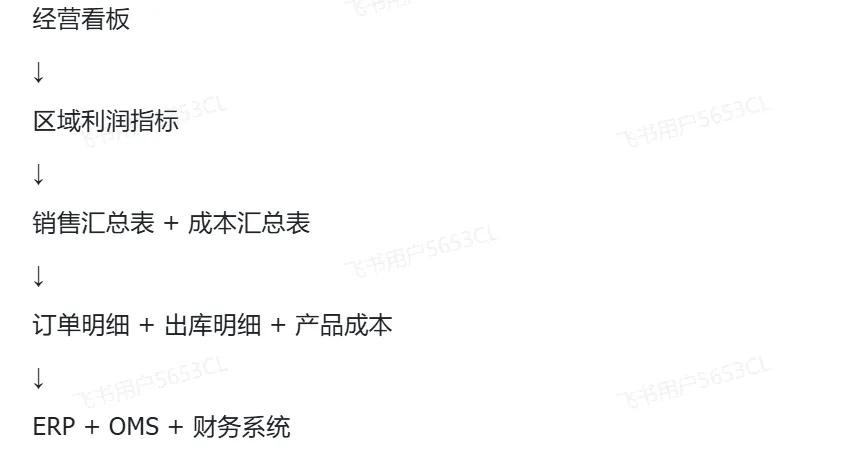
而且“毛利率”这个数字本身还经历了:过滤、关联、去重、汇总、成本分摊、币种转换、指标计算。
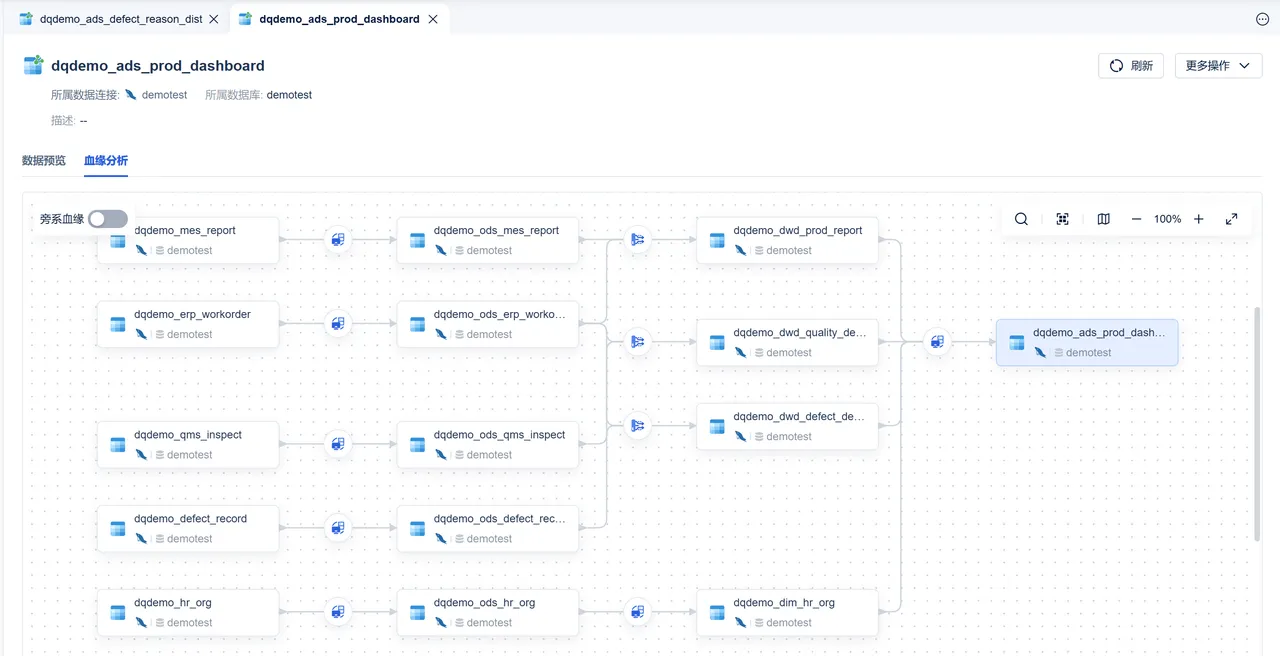
所以血缘真正要回答的,不只是:数据从哪张表来。 而是:它经历了什么加工,为什么最后会变成现在这个结果。 从颗粒度看,企业常见的血缘至少有三层。
第一层:表级血缘
例如:ods_order → dwd_order → dws_sales_day → ads_sales,它适合快速判断:这张表上游来自哪里,下游又被谁使用。
第二层:字段级血缘
最终报表中的“实收金额”,可能来自:ads_sales.pay_amount,继续向上追到dwd_order.actual_amount
最终对应业务系统里的:erp_order.received_money,字段级血缘才能真正回答:最终这个数字对应源系统里的哪个字段。
第三层:任务级血缘
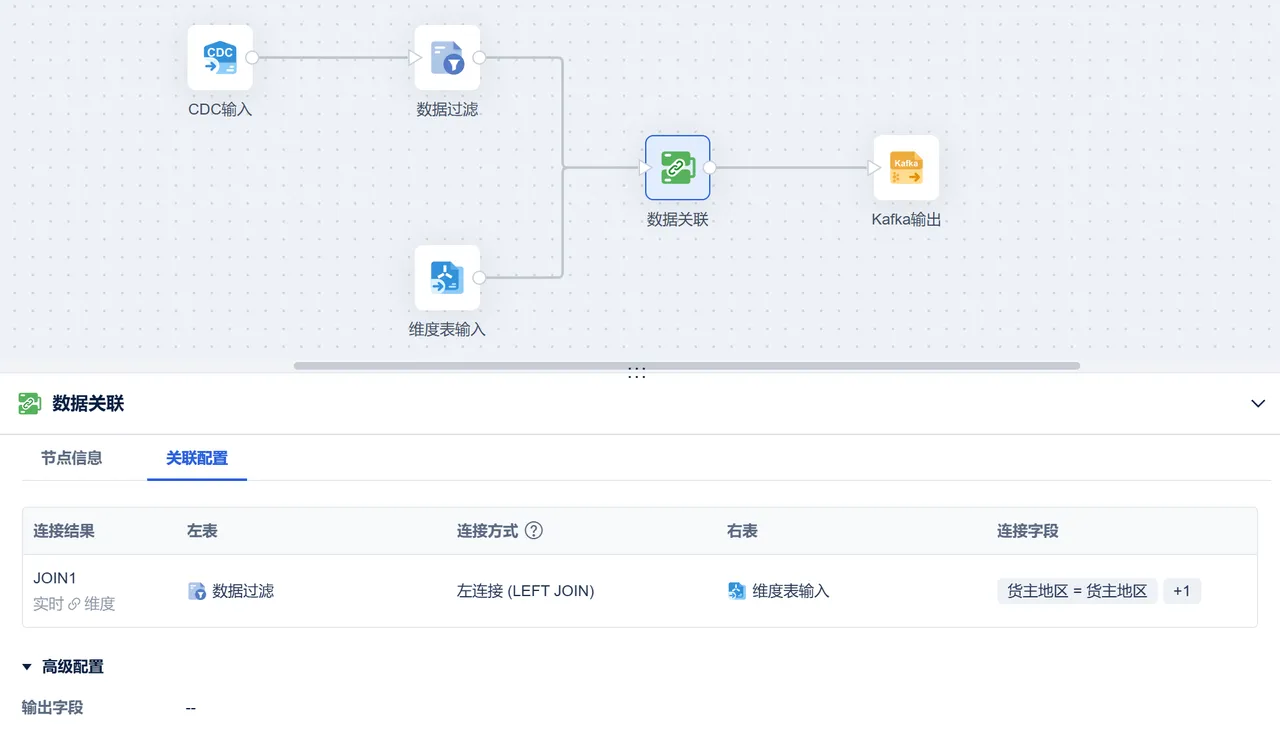
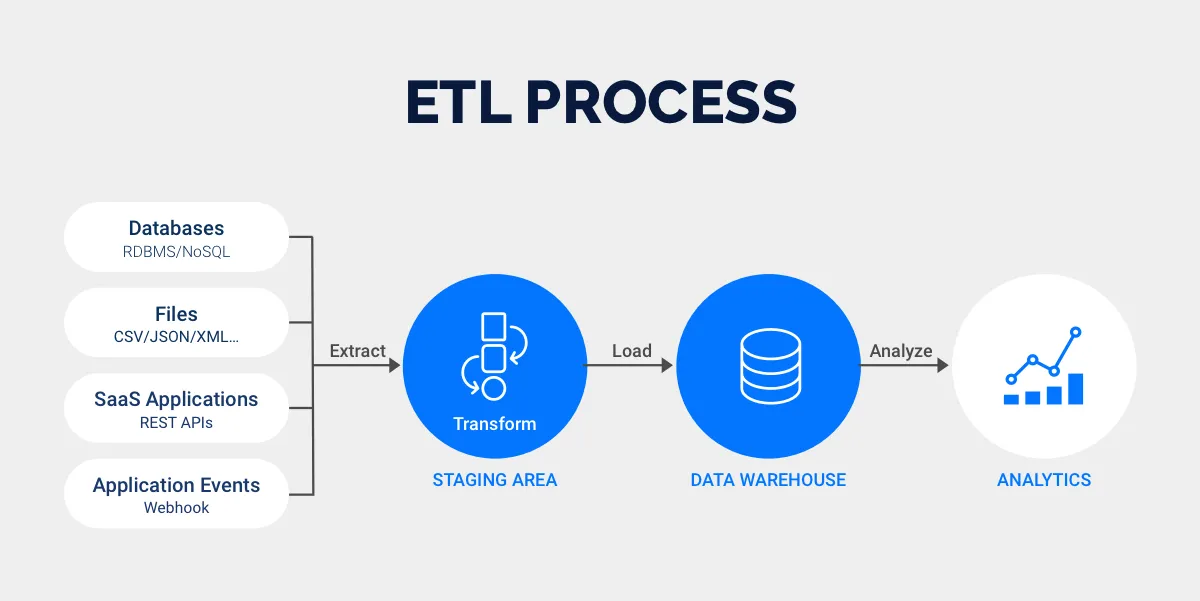
真实的数据不会自己从A表跑到B表。中间通常还存在:SQL、ETL任务、调度任务、实时管道、API、数据服务。 所以更完整的血缘应该逐渐形成:源系统 → 数据表 → 加工任务 → 中间表 → 数据服务 → 指标/报表
血缘真正进入生产以后,最有价值的其实是两个场景:追根溯源和影响分析。 数字错了,向上追;准备改一张表,向下看。前者解决“问题从哪里来”,后者解决“改动会影响谁”。这才是企业真正需要血缘的原因。
三、数据地图:不是把所有血缘塞进一张大图
数据地图,是三个概念里最容易被误解的一个。不少企业理解的数据地图就是:把全部数据库、表和血缘关系画到一张巨大画布上。
结果几千张表、几万条线全部展开,最后形成一张极其复杂的“蜘蛛网”。问题是:没人知道应该从哪里看起。 因为血缘和地图解决的问题并不一样。血缘强调:关系。 地图强调:探索。 假设一个销售分析人员想找:客户复购相关数据。
他真正期待的过程不应该是:先找到MySQL生产库,再进入某个Schema,然后从3000张表里猜哪张是客户表。 更合理的方式应该是:销售域 → 客户主题 → 客户交易 → 复购分析
进入某项资产以后,再继续看到:业务含义、指标口径、负责人、更新时间、质量状态、上下游关系、相关报表。 这时候,数据地图才真正开始发挥作用。
所以数据地图可以理解成:以数据目录为资产基础,以数据血缘为关系网络,再叠加业务分类、搜索、标签、质量、权限和使用信息形成的数据探索入口。
但这里还有一个特别容易被忽略的问题:地图展示的关系,到底是不是现在真实运行的关系? 一张地图页面完全可以做得很漂亮,但如果底层任务已经调整、表已经替换、接口已经变化,上层关系却没有同步更新,那么用户看到的其实是一张“历史地图”。
这时候,底层开发链路的重要性就体现出来了。FineDataLink 5.0中原本就存在的数据表、定时任务、实时管道和数据服务关系,可以继续向上支撑血缘分析。地图不再完全依赖人工重新画关系,而是尽量从真实的数据流转过程中获得依据。地图是否可信,本质上取决于它离真实生产链路有多远。
四、目录、血缘、地图,到底是什么关系?
把三者放在一起,就会清楚很多。
| 对比维度 | 数据目录 | 数据血缘 | 数据地图 |
|---|---|---|---|
| 核心问题 | 有什么数据 | 数据怎样产生和流转 | 怎样找到并理解数据 |
| 核心对象 | 数据资产 | 数据依赖关系 | 资产+关系+业务信息 |
| 主要形态 | 分类、清单、搜索 | 上下游关系网络 | 可探索的数据导航体系 |
| 典型用户 | 治理、开发 | 开发、运维、治理 | 业务、分析、治理 |
| 典型用途 | 资产盘点 | 溯源、影响分析 | 找数、懂数、用数 |
如果一定要用一句话概括:目录管理“点”,血缘连接“线”,地图把点和线组织成一张可以探索的“网”。 而且三者之间存在非常明确的依赖关系。
没有目录,血缘里的节点可能只是:t_order_01 → dwd_ord_dt → dws_sale,技术人员能看懂,业务人员很难理解。
没有血缘,目录里的资产又是彼此孤立的。你知道有一张“销售汇总表”,却不知道它从哪里来,也不知道改动以后会影响哪些指而没有前两者,所谓数据地图最终只能依靠人工重新整理。
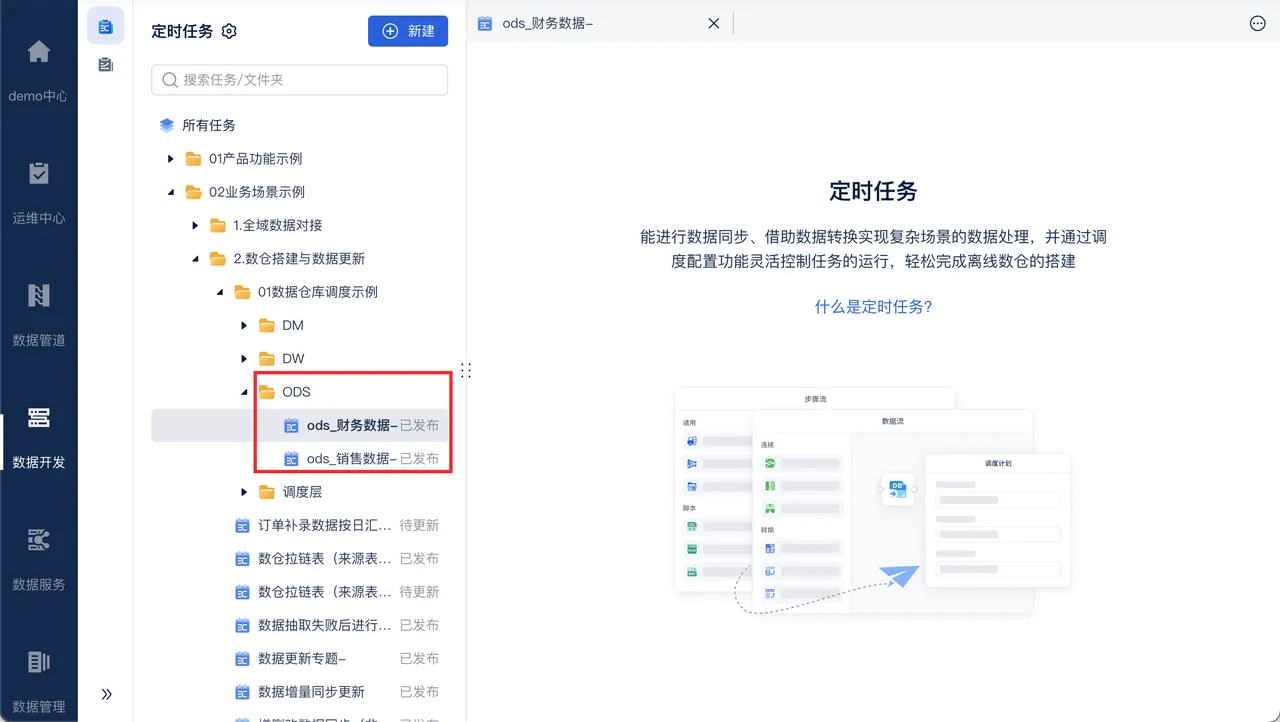
实际的数据流转也能很好地解释三者之间的关系。一条订单数据从业务数据库进入数仓,在FineDataLink 5.0中经过同步和加工任务形成订单明细、销售主题数据,之后再通过数据服务提供给下游应用。
站在开发视角,这里面首先看到的是:表、任务、管道和服务之间的依赖关系。 站在治理视角,还需要继续给这些节点补充:业务名称、数据定义、负责人、质量状态、敏感等级和指标口径。
前者逐渐构成血缘,后者逐渐丰富目录;再把资产、关系和业务语义组织成可搜索、可导航的入口,才真正接近数据地图。所以三者并不是三套彼此独立的系统,而是:同一批数据从技术关系走向业务可理解的不同层次。
五、企业真正落地时,应该先做哪个?
很多企业一上来就问:我们是不是应该先建一个数据地图? 其实顺序往往反了。真正合理的建设路径,通常是从底层往上走。
第一步:先统一数据对象
先盘清:有哪些系统、数据库、表、字段、指标、API和报表。 这一阶段不一定一上来就追求100%覆盖。更现实的方式,是先从核心业务域开始:客户、订单、商品、供应商、财务。 先把高价值、高频使用的数据盘清。
第二步:补业务语义
技术元数据只能告诉你:字段叫什么。 业务元数据才能告诉你:它是什么意思。 所以需要逐渐补充:业务定义、指标口径、主题分类、责任部门、负责人。 这一阶段决定了数据目录究竟是“开发人员的资产清单”,还是“业务也能看懂的数据语言”。
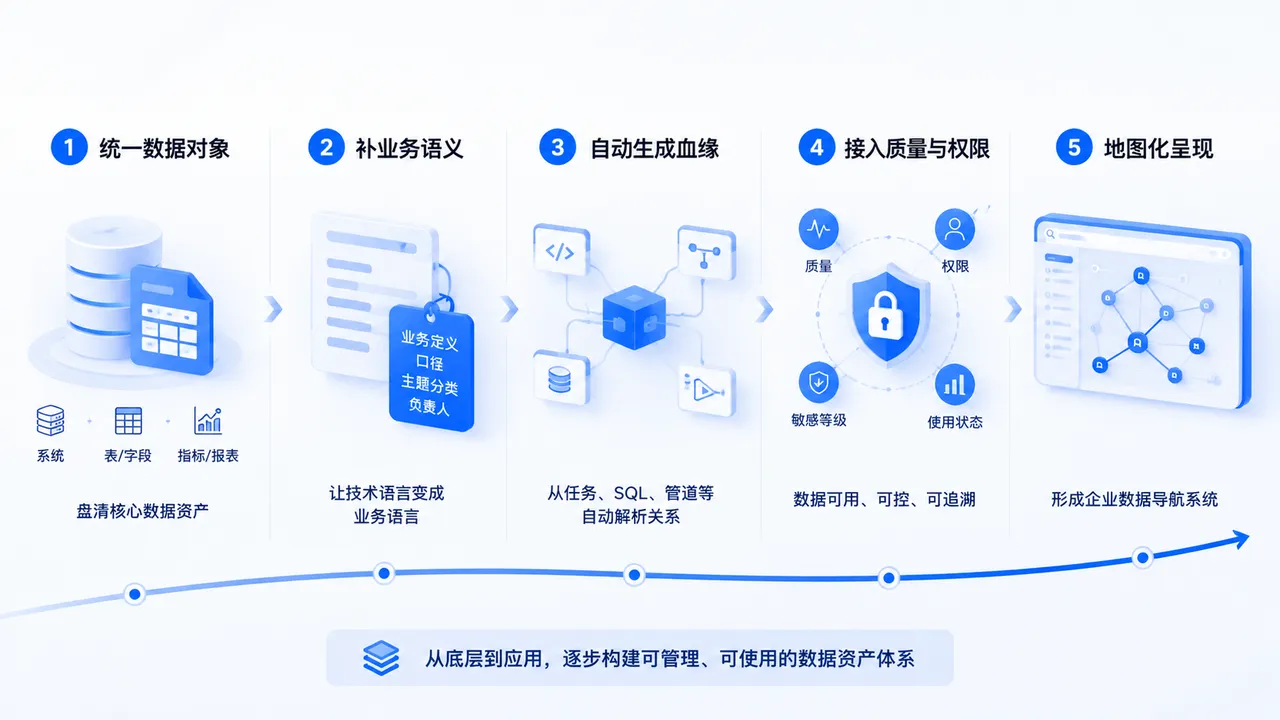
第三步:让血缘尽量自动产生
血缘最怕人工维护。SQL改了、任务改了、数据源换了,只要有人忘记登记,血缘就会失真。所以核心关系应该尽量从:SQL解析、ETL配置、调度关系、实时管道、API依赖中获得。
到这一阶段,还有一个很实际的原则:能从系统里自动获得的关系,就尽量不要再让人填一遍。 SQL、ETL任务、调度依赖、实时管道和API关系每天都在变化,如果血缘维护依赖开发人员主动登记,长期来看几乎一定会漏。
对已经使用FineDataLink 5.0承载同步、加工、管道和数据服务的企业来说,开发人员原本就在配置这些链路。治理工作更值得做的,是把已有的任务、表和服务关系继续转化为可追溯的血缘,再补充自动解析覆盖不到的业务语义。
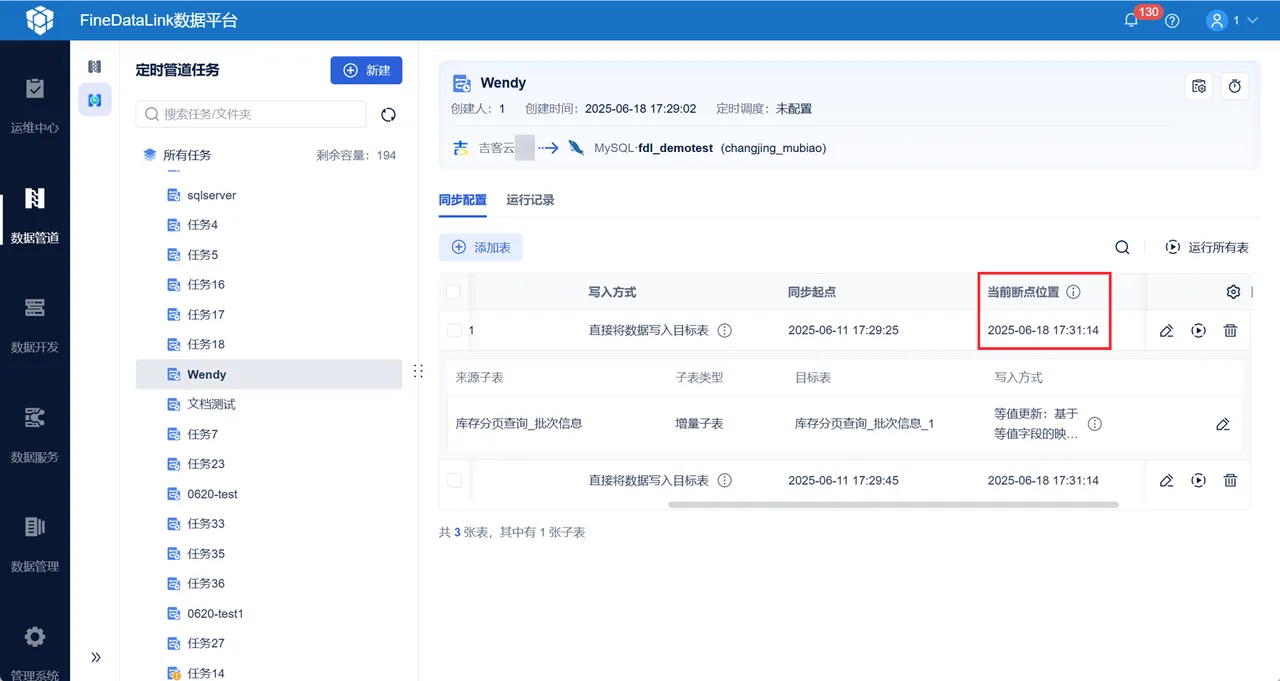
这样一来:数据开发是在生产数据,治理体系也在同步积累数据关系,而不是开发做完以后,再启动另一套人工治理流程。
第四步:加入质量、权限和使用状态
数据能找到,不代表数据能用。真正的数据使用者还会关心:最近有没有更新?质量有没有异常?是否涉及敏感信息?自己有没有权限?这张表现在还有没有人在使用?所以真正成熟的数据目录和地图,还需要进一步接入:数据质量、权限、敏感等级、访问热度、更新状态。
第五步:最后才是地图化
当目录、血缘、业务语义、质量和权限逐渐完整以后,再通过搜索、导航、标签和关系图把这些信息组织起来。这时候的数据地图才不是一个漂亮页面,而真正变成:企业的数据导航系统。
六、为什么很多企业的数据目录和地图最后没人用?
不少数据治理项目上线时非常热闹。一年以后,业务还是:找数靠问人,确认口径靠微信群,排查问题靠开发翻SQL。 通常不是因为页面不好看,而是掉进了几个非常典型的坑。
只有技术元数据,没有业务语言
满屏都是:ODS、DWD、varchar、table_id。 对业务来说,这些信息几乎没有直接价值。
目录和真实数据环境脱节
表已经删除,目录里还在;SQL已经修改,血缘没更新;指标已经换了口径,说明还是旧版本。一旦用户发现几次错误,整个系统的可信度就会快速下降。
找到了数据,却不知道敢不敢用
真正的数据消费不是:我找到了一张表。而是:我找到了一张表,并且知道它是什么意思、谁负责、从哪里来、多久更新一次、质量有没有问题。
如果这些信息缺失,目录最终只解决了“看见”,却没有解决“信任”。所以企业衡量治理效果时,不应该只看:登记了多少张表、解析了多少条血缘、建设了多少个主题。
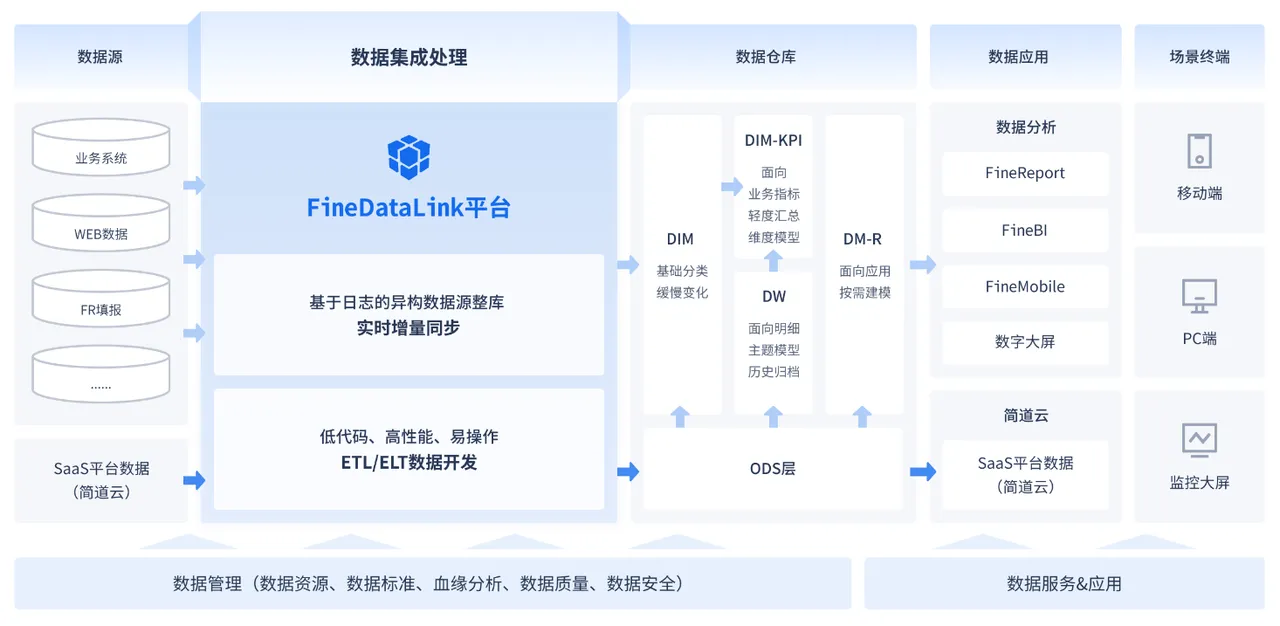
更值得关注的是:一个不熟悉底层系统的人,能不能在较短时间内找到正确的数据,并判断它是否可信、是否适合自己的分析场景。 这才是数据目录、血缘和地图最终共同要解决的问题。
写在最后
现在再回头看,数据目录、数据血缘和数据地图,其实三者边界非常清楚。数据目录解决资产可见。 让企业知道:我到底有什么数据。 数据血缘解决关系可追。 让企业知道:数据从哪里来,经过什么加工,又会影响哪里。 数据地图解决数据可找、可懂、可用。
让真正使用数据的人,可以从业务问题出发,找到需要的数据资产。三者不是三选一,而是一条逐层递进的链路:先有资产,再有关系,最后形成探索能力。
真正成熟的数据治理,也应该形成这样的循环:数据产生 → 元数据采集 → 资产目录 → 血缘解析 → 业务语义 → 质量与权限 → 搜索使用 → 持续更新。
所以企业真正要建设的,从来不只是一份“数据目录”,也不是一张看起来复杂的数据血缘图。最终目标其实只有一个:让散落在各个系统里的数据,不只是“存在那里”,而是真正变成能够被找到、理解、追溯、信任和使用的企业资产。
