很多企业做数据治理,第一件事是建标准、梳指标、做数据资产目录。但真正到了业务端,大家最常问的还是一句:“这个数到底准不准?”
报表上的销售额和财务系统对不上;身份证号少一位、手机号重复、订单日期跑到了未来;昨天的数据今天中午还没同步过来……
这些问题单独看都不大,可一旦数据量上来,最后就会变成一个非常现实的问题:企业明明有很多数据,但没人敢直接用。 所以,数据质量管理真正要解决的,并不是“把数据洗干净”这么简单,而是建立一套可以持续发现问题、定位问题、解决问题、验证结果的机制。
很多企业做数据质量,都是出了问题再排查:报表错了查报表,指标异常查指标,业务反馈了再一路追溯源头。但真正成熟的数据质量治理,应该把规则前移到源头、覆盖到全链路,在问题产生之前就把风险拦住。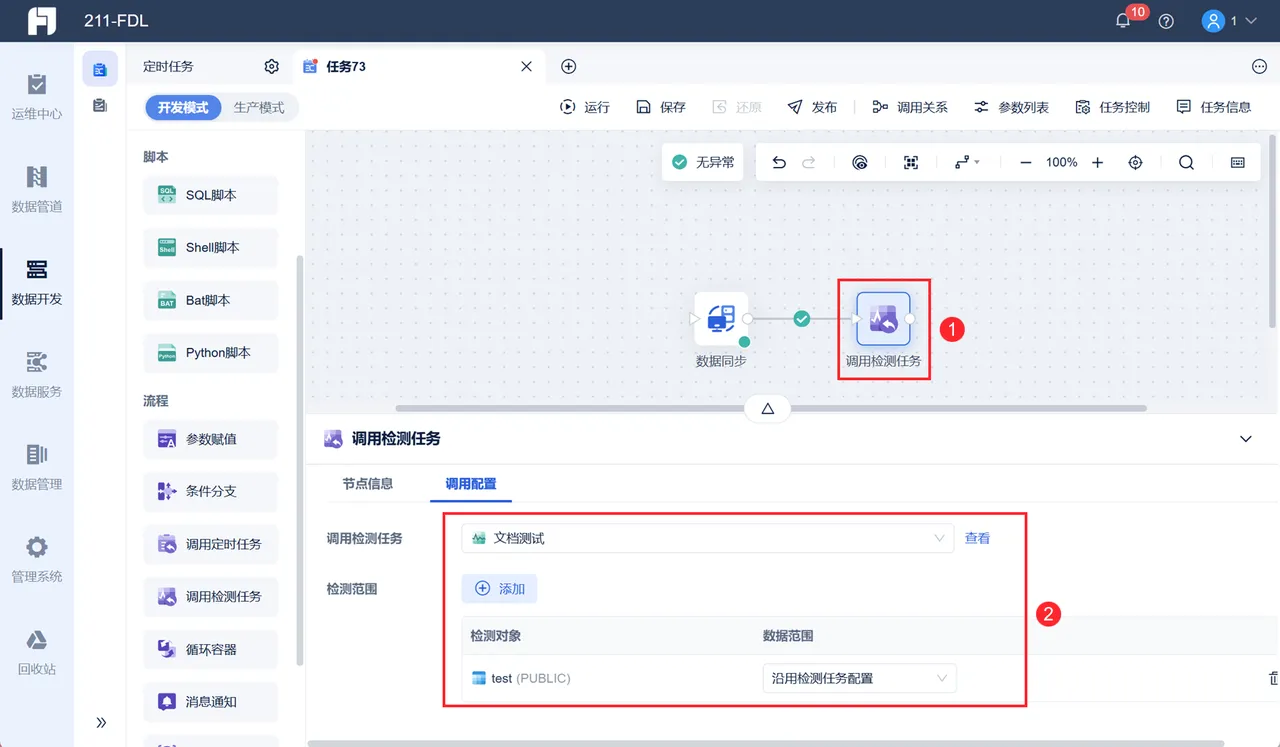
一、完整性:该有的数据,到底有没有?
完整性最好理解。它关注的是:应该有的数据,有没有缺。 比如一张客户表规定必须包含:客户名称;客户编码;联系方式;所属区域;客户类型。结果导入10万条数据,其中5000条没有所属区域,3000条没有客户类型。这就是典型的完整性问题。
再比如订单表中:订单编号有了,客户有了,金额也有了,但是下单日期为空。从数据库角度看,这条记录依然存在。但从业务角度看,它已经很难继续参与订单周期、销售趋势、客户分析。所以完整性通常要检查三类问题。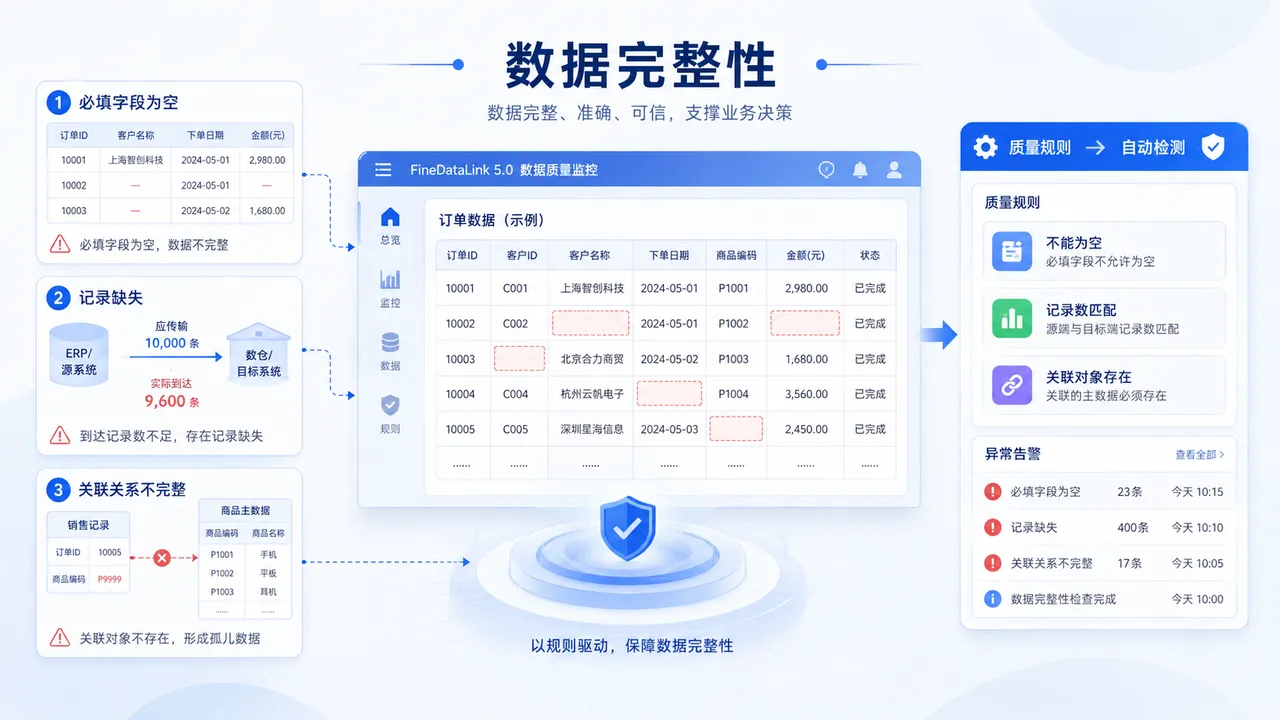
必填字段是否为空
比如:客户名称不能为空;订单编号不能为空;产品编码不能为空;发生日期不能为空。
业务记录是否缺失
有时候字段不为空,但整条数据没过来。比如 ERP 今天实际产生10000条订单,下游数仓只同步了9600条。字段看起来都没问题,但少了400条订单。这同样属于完整性问题。
关联关系是否完整
比如销售明细中出现产品编码 A10086,但产品主数据表根本没有这个产品。这条销售记录虽然存在,但已经成为“孤儿数据”。所以完整性不仅是: 字段有没有填。 还包括:这个业务对象应该关联的数据有没有完整出现。
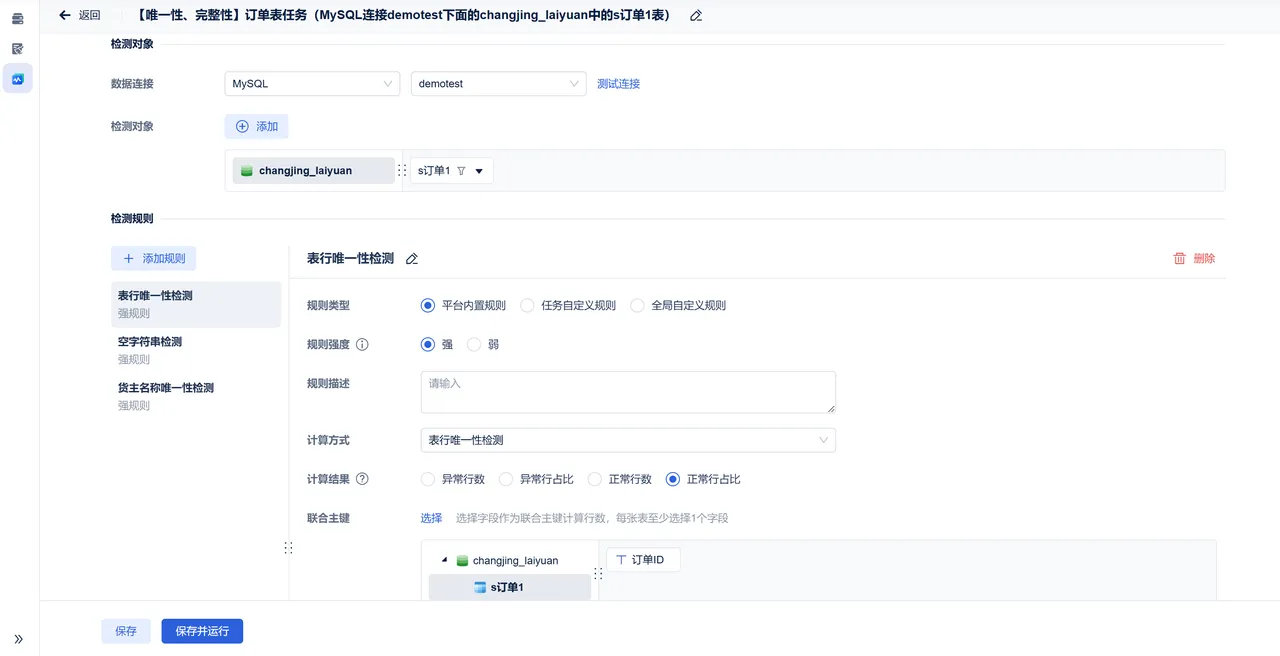
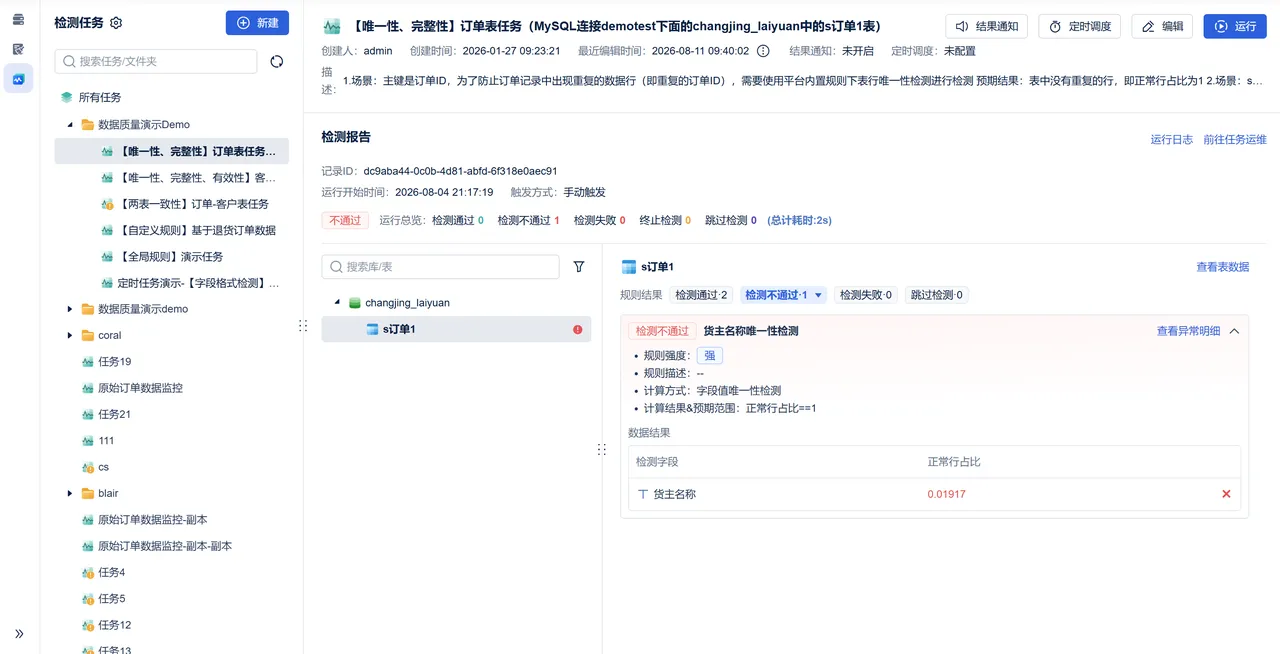
当数据规模变大以后,这类问题显然不能靠人工一条条检查。更合理的方式,是把“不能为空”“记录数必须匹配”“关联对象必须存在”等要求配置成质量规则,让系统持续自动检测。
二、一致性:同一个东西,为什么到不同系统就变了?
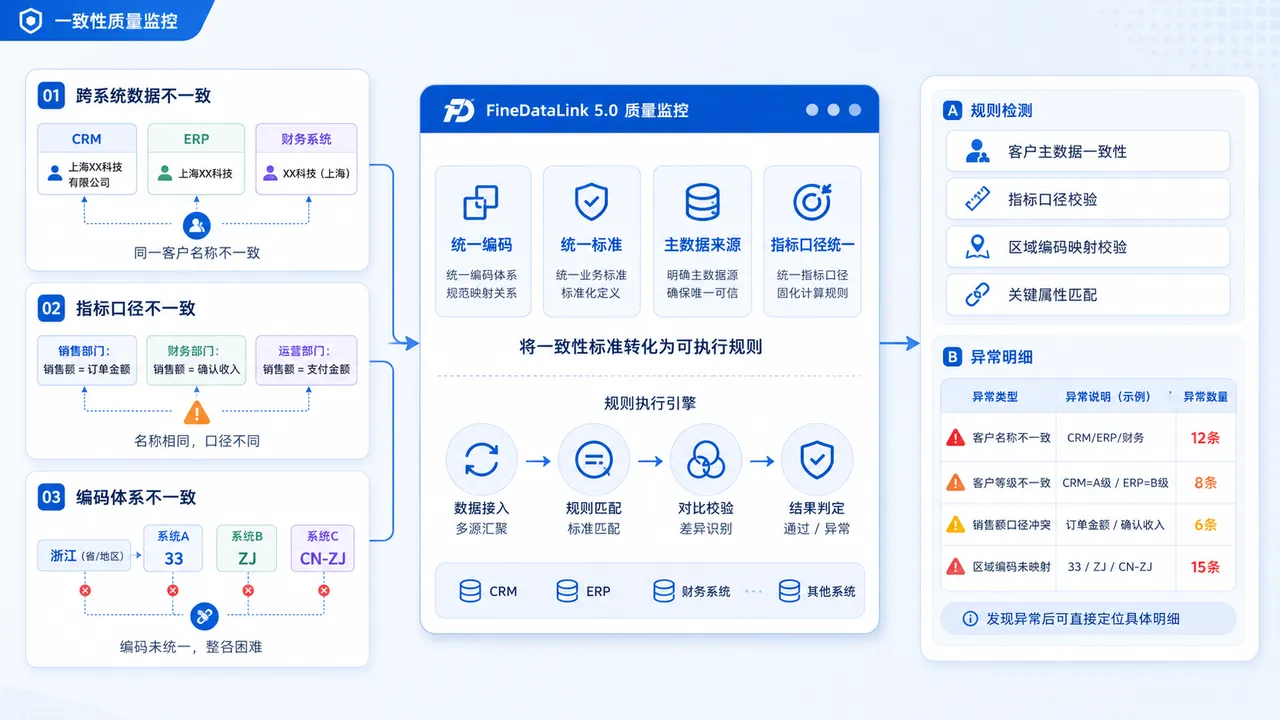
如果说完整性解决的是“有没有”,那么一致性解决的是:同一件事情,在不同地方是不是同一个说法。 这是集团型企业最头疼的问题之一。举个很常见的例子。同一个客户:CRM:上海XX科技有限公司;ERP:上海XX科技;财务系统:XX科技(上海)
三个系统里都是同一个客户,但名字不同。如果直接做数据汇总,很可能就被识别成三个客户。这就是一致性问题。企业里最常见的一致性问题主要有几种:
跨系统数据不一致
例如:CRM客户等级是A级;ERP客户等级却是B级。那管理层到底应该信哪个?这时候就必须定义:哪个系统是主数据来源,哪个系统只是消费方。
指标口径不一致
这个比字段问题更麻烦。销售部门的“销售额”可能是订单金额;财务部门的“销售额”可能是确认收入;运营部门可能又使用支付金额。
大家都叫“销售额”,但其实不是一个指标。结果就是:每次经营会上,各部门都拿着自己的数字,而且每个人都能证明自己没算错。
编码体系不一致
例如:一个系统里“浙江”编码为33;另一个系统里是 ZJ;第三个系统里是 CN-ZJ。数据如果没有统一映射,后续整合会非常痛苦。所以一致性管理的关键通常不是简单“改字段”,而是建立:统一编码、统一标准、统一主数据、统一指标口径。
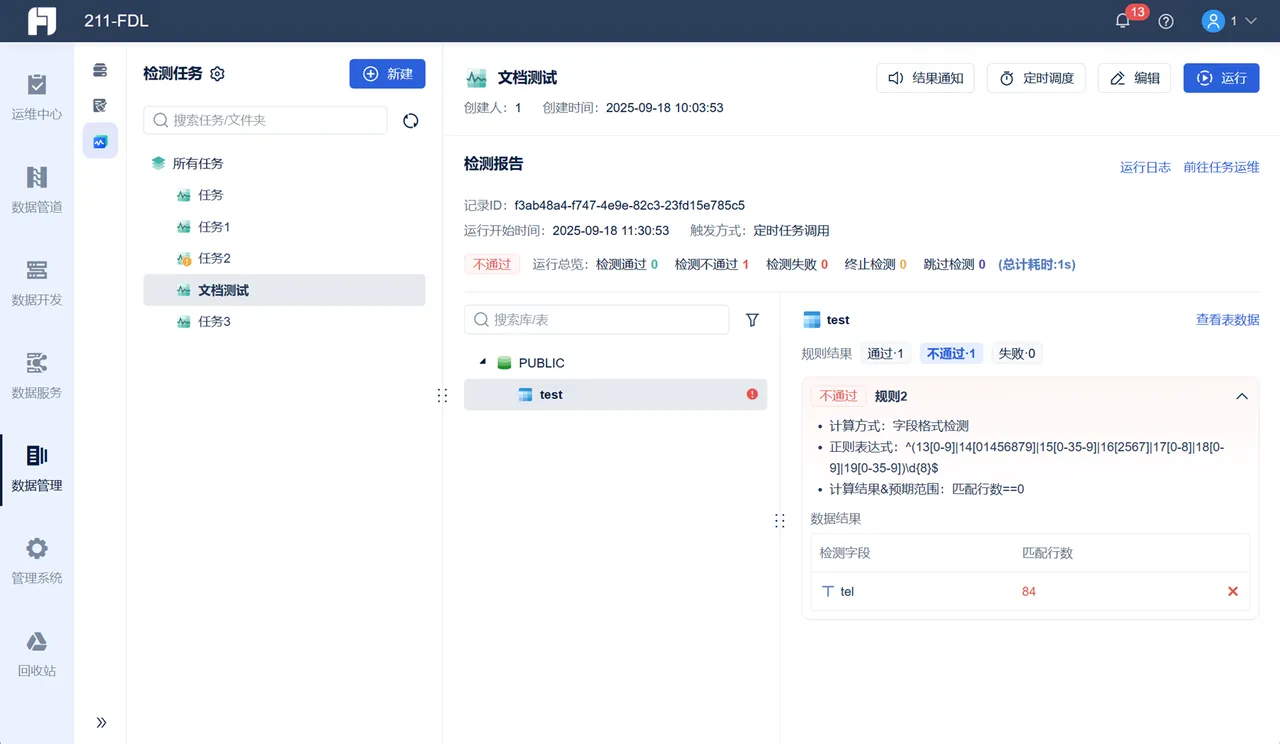
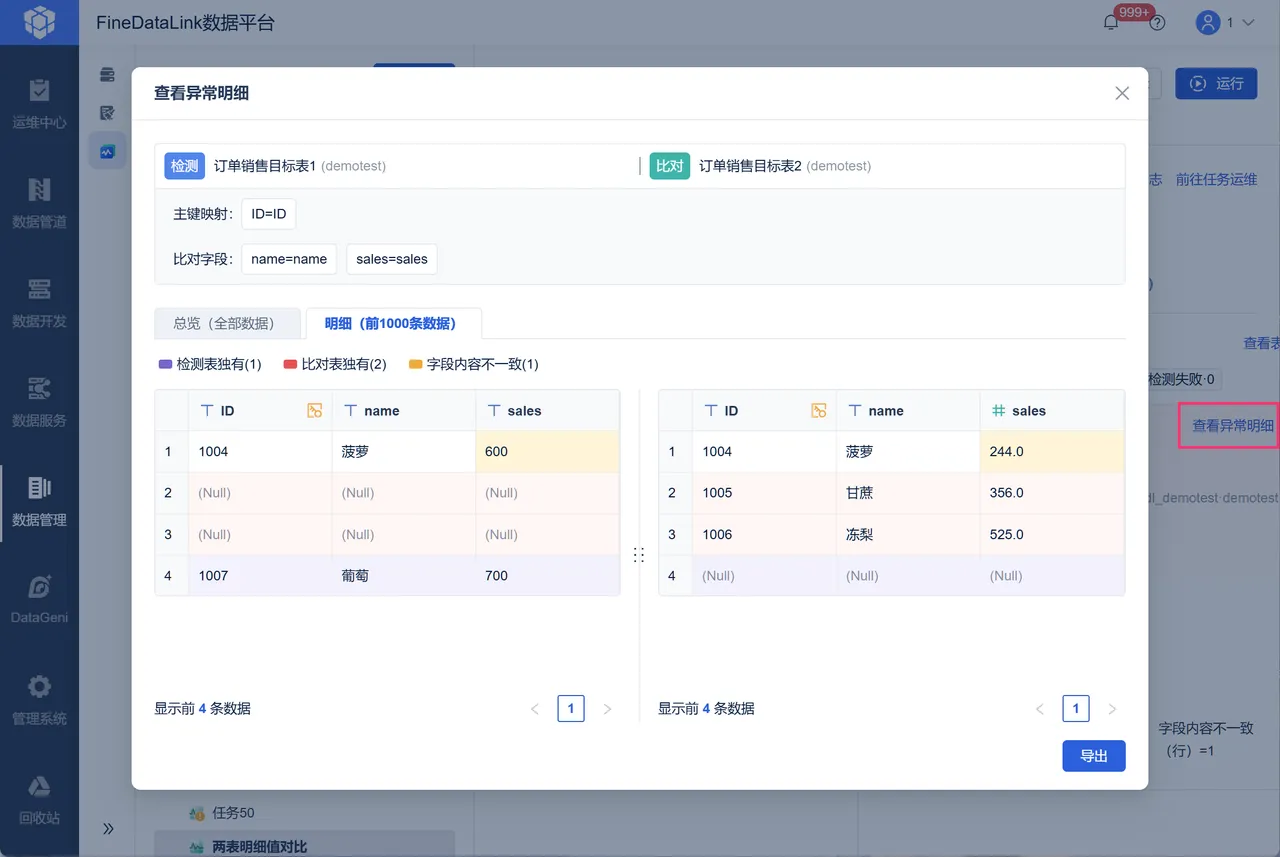
而到了数据质量检测阶段,还需要把这些标准进一步转成可执行规则。比如跨表字段是否一致、同一业务对象在不同数据源中的关键属性是否匹配。
三、准确性:数据有了,也一致,但它是真的吗?
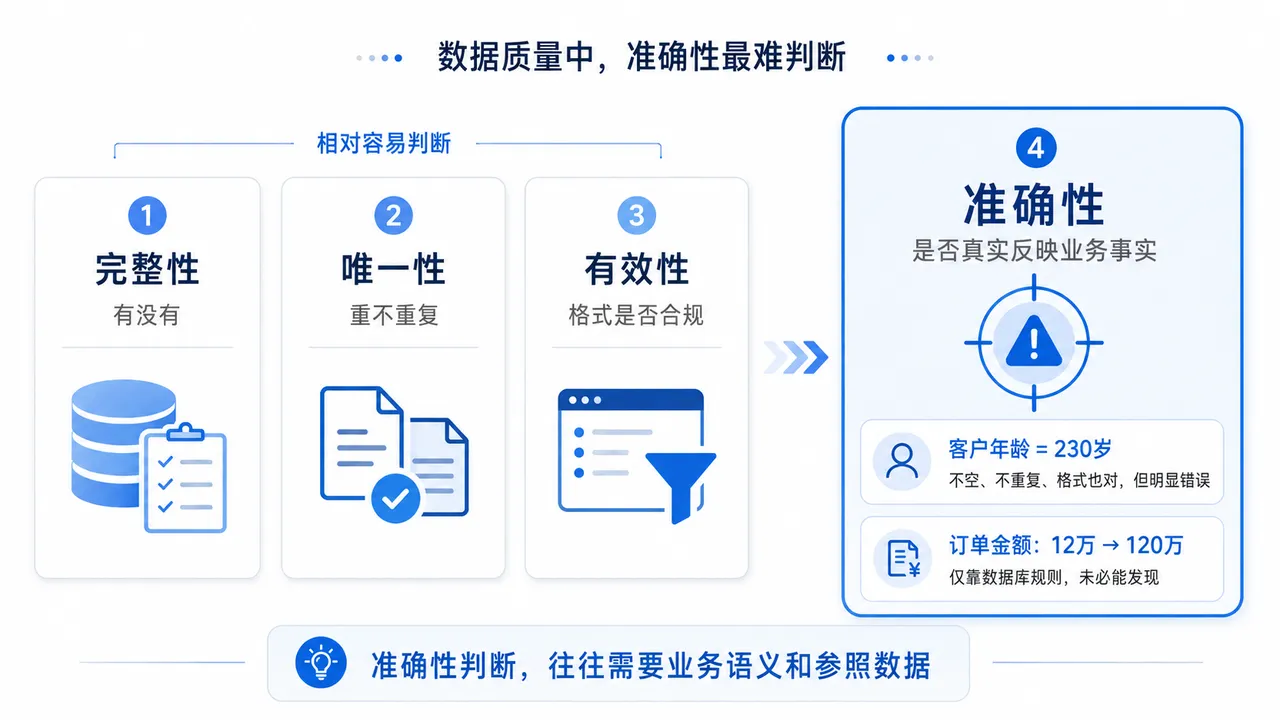
这是数据质量里面最难的一项。因为完整性可以判断有没有;唯一性可以判断重不重复;有效性可以通过规则判断格式;但准确性要回答的是:这个数据是不是真实反映了业务事实?
例如:系统里记录某个客户年龄是230岁。它不为空、格式也是数字、甚至没有重复,但明显是错的。
又比如一张订单实际金额是12万元,系统录成了120万元。如果没有其他参照数据,仅靠数据库自身规则,很难发现。所以准确性通常需要通过几个办法判断。
第一种:与权威数据源核对
比如:财务收入与财务总账核对;客户信息与主数据平台核对;库存数量与仓储系统核对。核心原则就是:找出可信度最高的数据来源作为基准。
第二种:业务规则校验
例如:商品售价不应该小于0;折扣率不能超过100%;员工入职时间不能早于出生时间;订单完成时间不能早于创建时间。这些虽然不能证明数据100%准确,但至少可以发现明显错误。
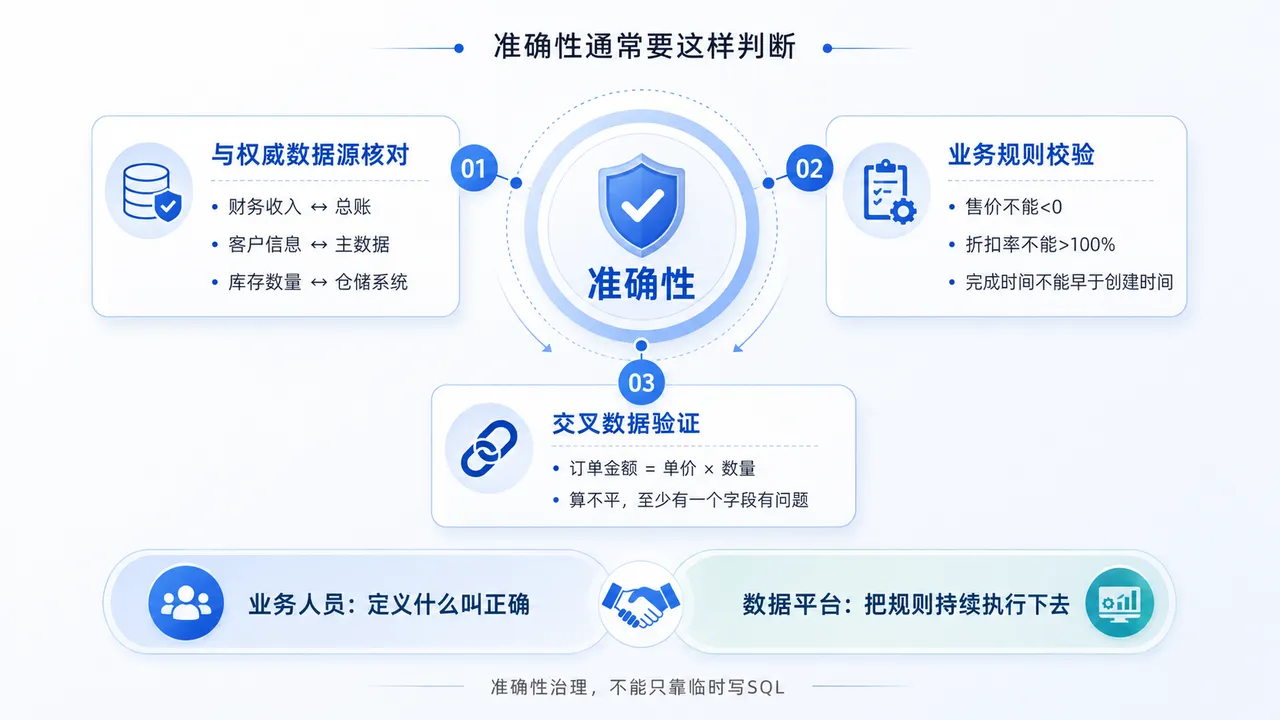
第三种:交叉数据验证
例如:订单金额 = 单价 × 数量。如果三个字段之间算不平,那么至少有一个数据存在问题。准确性管理的难点就在这里:它经常需要理解业务逻辑,而不是只懂数据库。
所以数据质量工作做到后面,一定不能只是数据部门自己做。业务人员负责定义什么叫“正确”,数据平台负责把这些标准长期执行下去。 这也是为什么数据质量规则不能只靠技术人员临时写 SQL,而要逐渐沉淀成可以持续复用的治理规则。
四、唯一性:一条数据为什么会出现三遍?
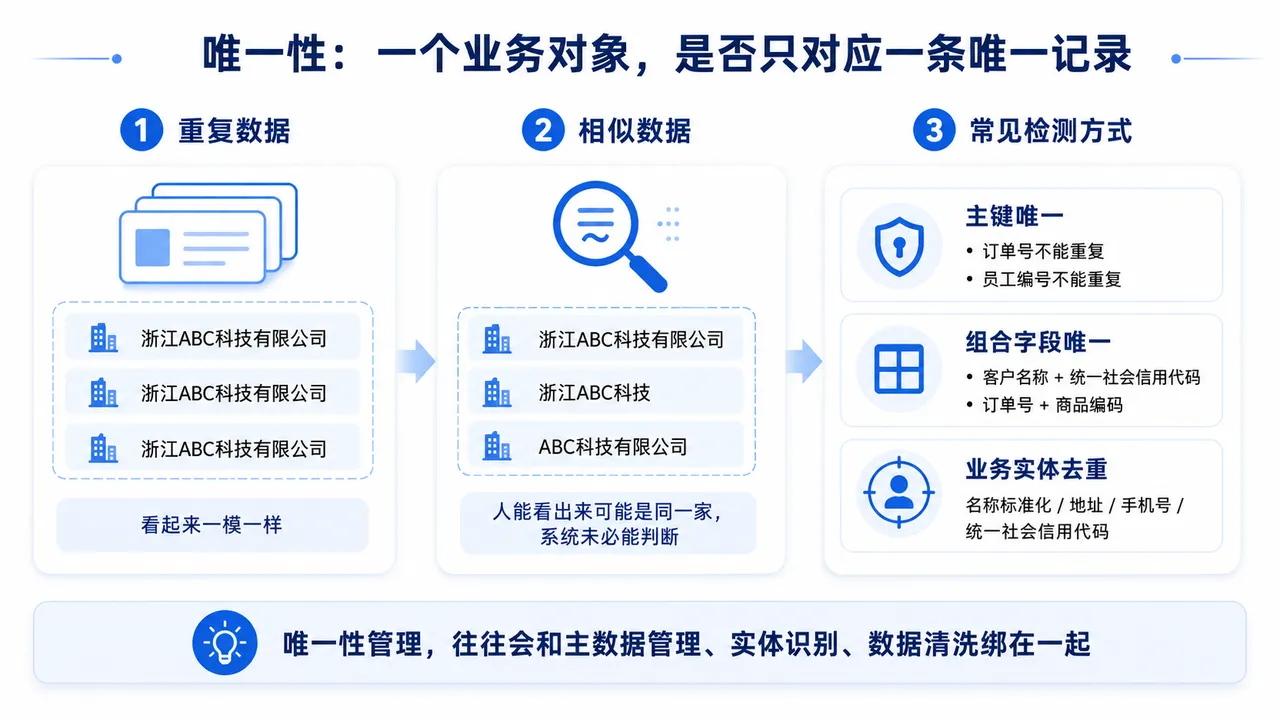
重复数据,是另一个非常常见的数据质量问题。例如客户表里出现:浙江ABC科技有限公司 、浙江ABC科技有限公司 、浙江ABC科技有限公司。 三条记录看起来一模一样。
更麻烦的情况是:浙江ABC科技有限公司 、浙江ABC科技 、ABC科技有限公司 ,人一眼能看出来可能是同一家企业,但系统未必能判断。
唯一性关注的就是:一个业务对象,是否只对应一条唯一记录。 常见检测方式包括:
主键唯一
例如:订单号不能重复;员工编号不能重复;商品SKU不能重复。
组合字段唯一
有些业务没有天然唯一ID,就需要组合判断。比如:客户名称 + 统一社会信用代码。又或者:订单号 + 商品编码。
业务实体去重
这是难度更高的一类。例如判断:“上海XX科技有限公司”和“上海XX科技”,是不是同一个客户。这种情况通常需要结合名称标准化、地址、手机号、统一社会信用代码等字段综合判断。所以唯一性管理最终往往会和:主数据管理、实体识别、数据清洗 绑在一起。
五、时效性:数据没错,但来晚了还有意义吗?
这是很多企业最容易忽略的数据质量维度。一份数据可以:完整;准确;没有重复;格式也完全正确。
但是如果今天上午10点的销售数据,第二天下午才进入分析系统,它还有多大价值?这就是时效性。时效性关注的是:数据是否在业务需要的时间范围内产生、同步和更新。
比如:财务月报允许 T+1;经营日报可能要求每天9点前完成更新;电商销售监控可能要求分钟级;生产设备数据甚至要求秒级。所以时效性没有一个统一标准。
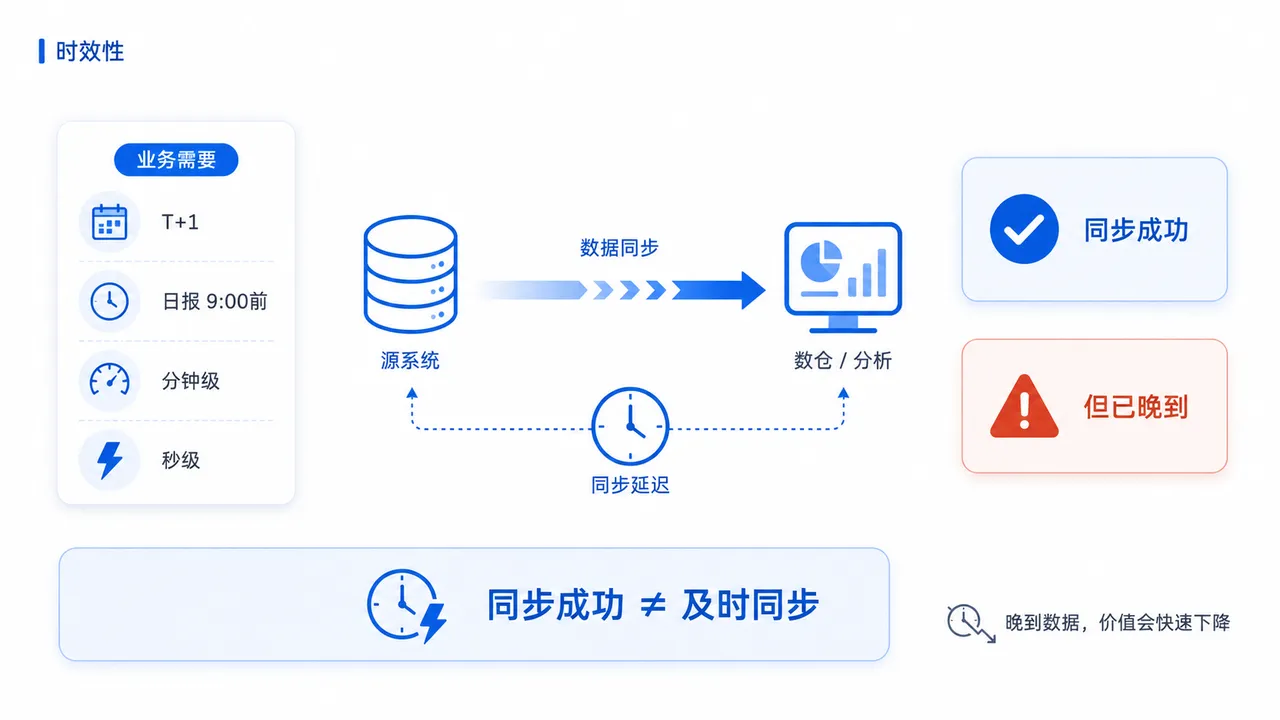
关键在于:业务需要多快,数据就必须多快。 常见规则可以包括:数据更新时间不得超过30分钟;每日数据必须在8:00前完成同步;订单产生后5分钟内进入数仓;设备数据延迟不得超过10秒。
这里特别容易出现一个误区:企业觉得“数据已经同步成功”,就认为质量没问题。但实际上:同步成功,不等于及时同步。 对于实时经营、风险预警、生产监控来说,晚到的数据有时候和错误数据没有太大区别。
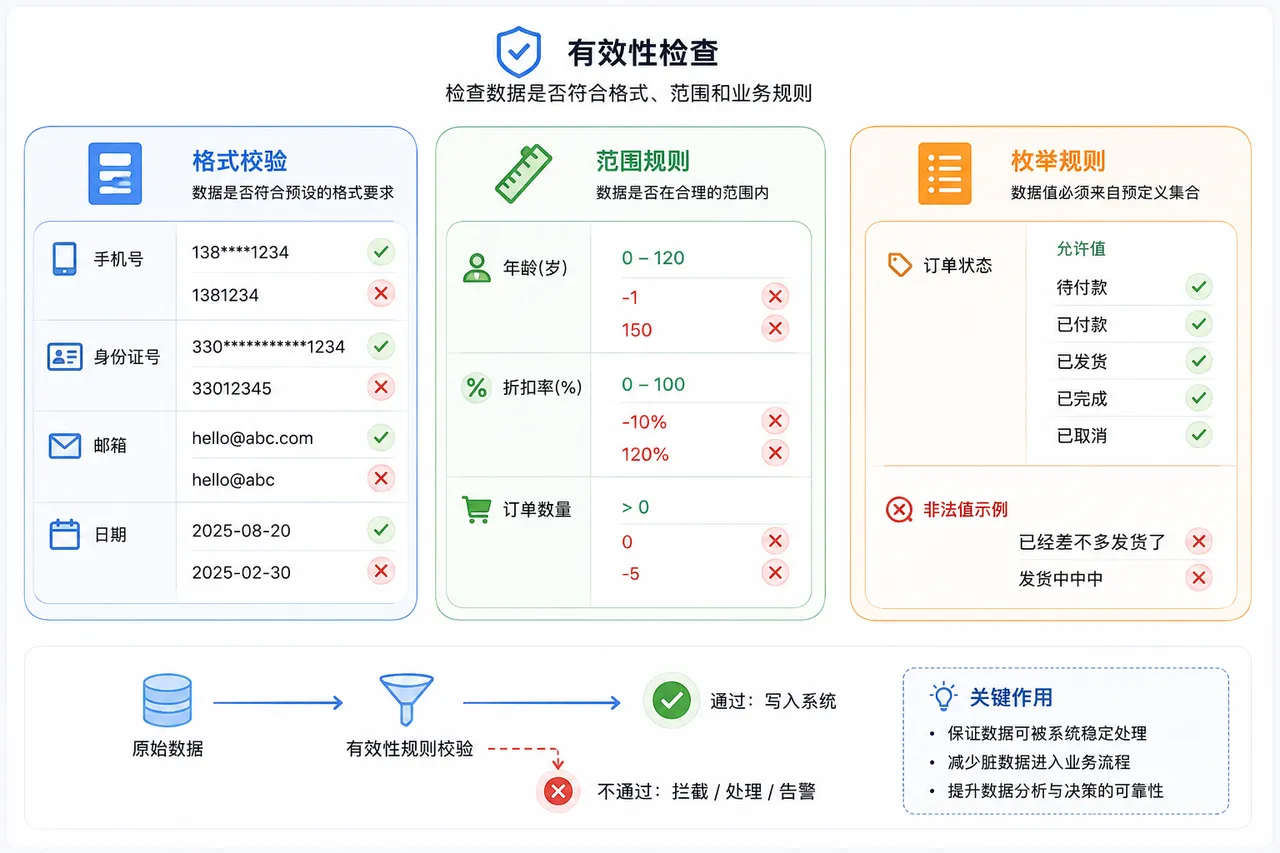
六、有效性:这个数据符合规则吗?
有效性主要检查:数据是否符合预设的格式、范围和业务规则。 最典型的就是格式校验。
比如手机号:应该是合法号码格式。身份证号:长度、字符和校验规则需要正确。邮箱:必须符合邮箱格式。日期:必须能够解析为正常日期。
除此之外,还有范围规则。例如:年龄必须在0—120之间;折扣率必须在0—100%之间;订单数量必须大于0。以及枚举规则:订单状态只能来自:待付款、已付款、已发货、已完成、已取消。
如果数据库里突然出现一个:“已经差不多发货了”,从人类角度可能看得懂,但系统没法稳定处理。所以有效性本质上是在告诉数据:什么值可以出现,什么值不应该出现。
数据质量六性,不是六套独立规则
很多企业刚开始做数据质量时,会犯一个错误:按照六个维度分别配几十条规则,然后觉得数据质量体系已经建好了。其实远远不够。因为一个真实的数据问题往往同时涉及多个维度。
比如某条订单:客户编号为空——完整性问题;订单号重复——唯一性问题;金额为负数——有效性问题;金额和财务系统不一致——一致性问题;真实金额录错——准确性问题;第二天才同步——时效性问题。
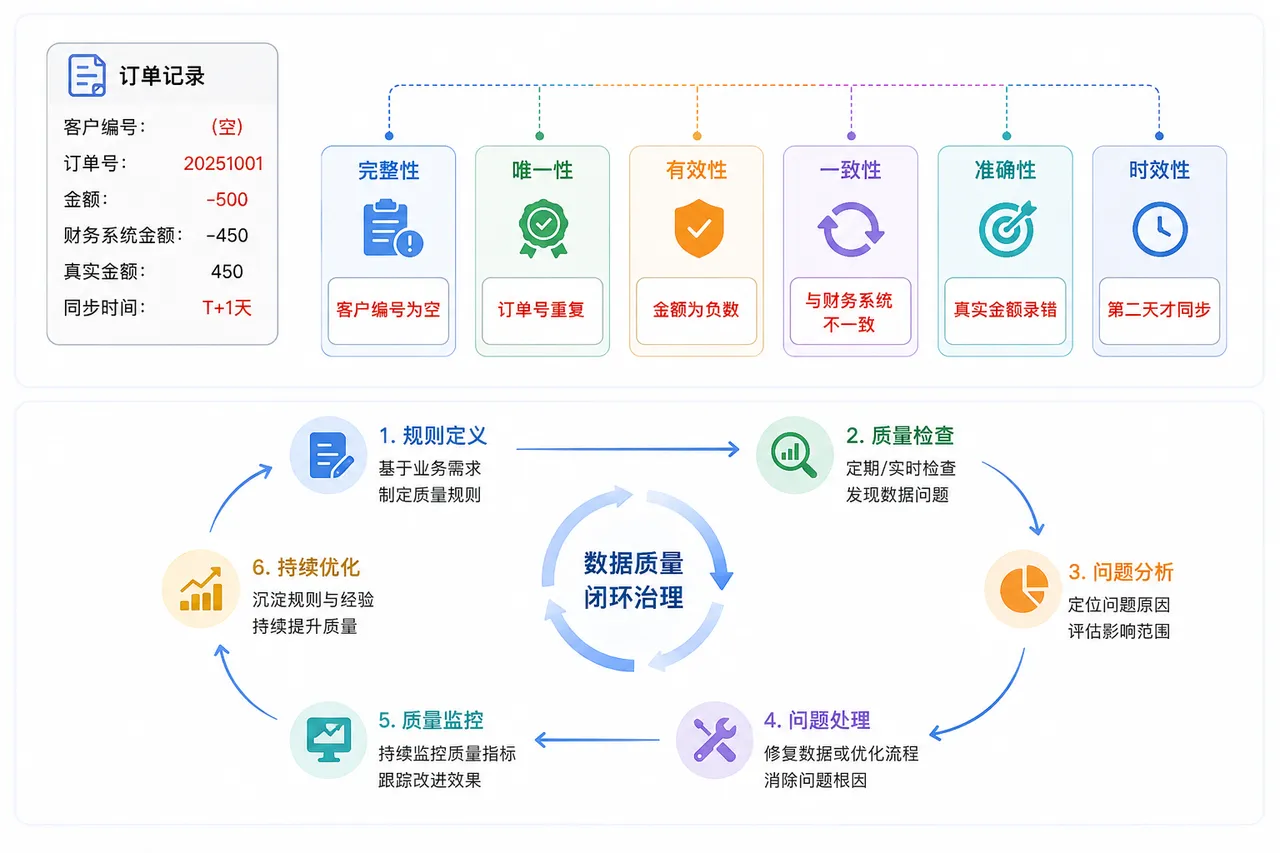
所以六性更像是:六个观察数据质量的角度。 真正的数据质量治理,必须建立一套持续运行的闭环。
真正的数据质量治理,应该走完这5步
第一步:先定义哪些数据最重要
不是所有字段都值得投入同样的治理成本。企业应该优先识别:核心主数据;核心经营指标;财务数据;客户数据;订单数据;生产数据。先管真正影响经营和决策的数据。否则几万个字段全部配置规则,最后很容易变成“规则很多,但没人看”。
第二步:建立质量规则
针对不同对象建立:完整性规则;一致性规则;准确性规则;唯一性规则;时效性规则;有效性规则。并设置不同的重要程度。
比如:核心订单金额错误属于严重问题;客户备注为空可能只是一般问题。不能所有异常都一个等级。
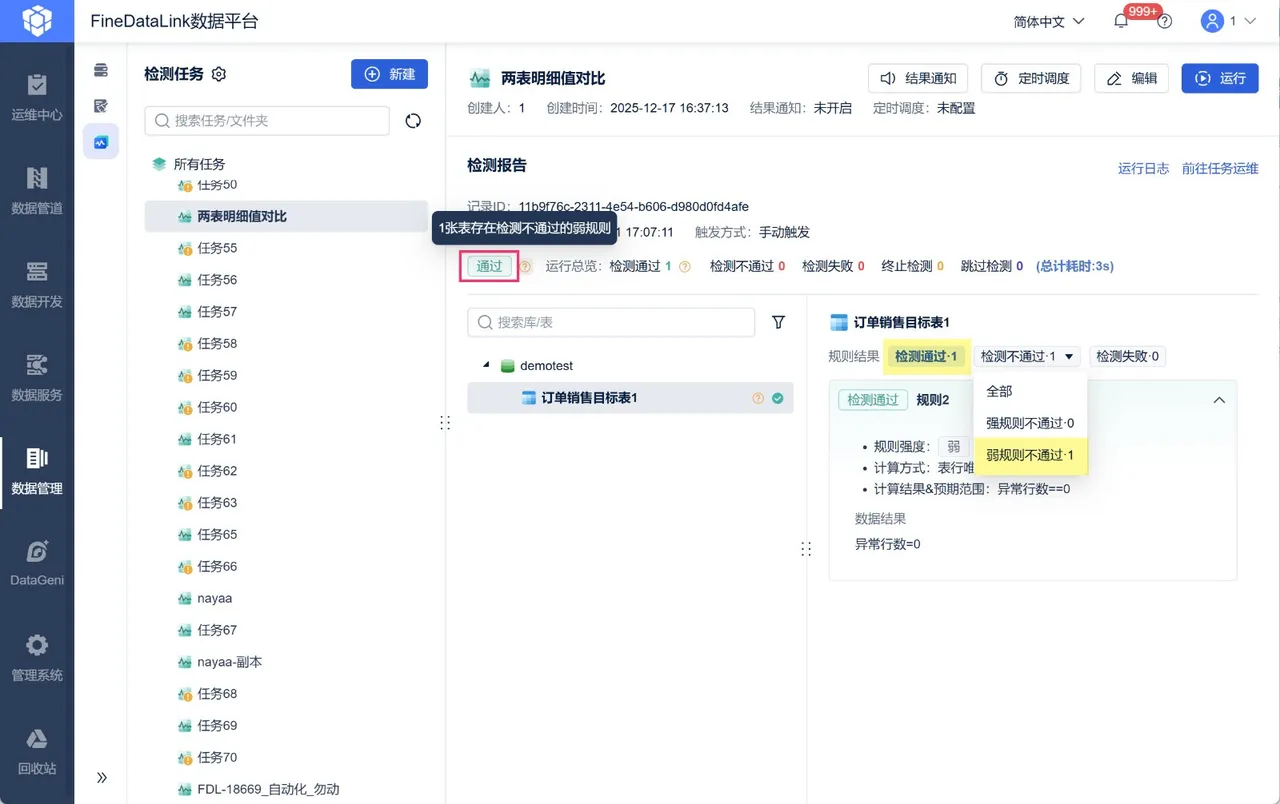
第三步:自动监控和发现异常
数据质量不能靠每个月人工抽查。更合理的方式是:规则自动执行,一旦出现异常数据,就自动识别并通知负责人。
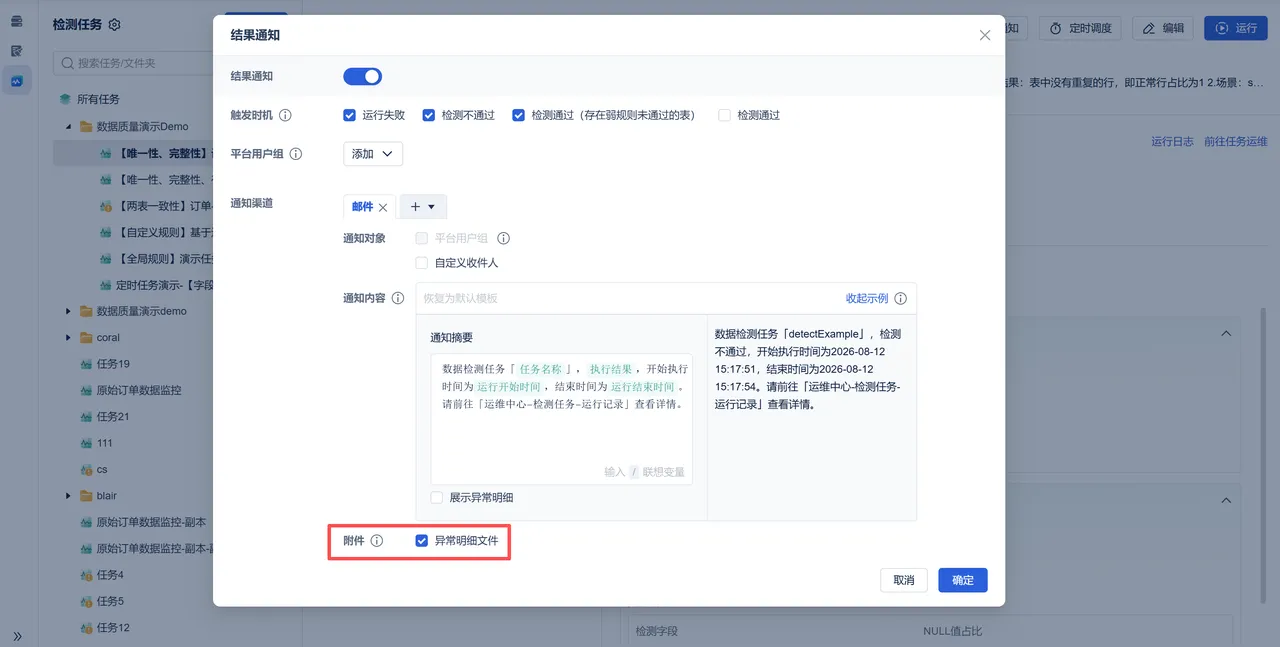
比如:订单号重复自动发现;关键字段为空自动发现;更新时间超过阈值自动告警;跨表数据不一致自动识别。
这样数据质量就从:“业务发现报表不对,再找数据团队排查” 变成:“问题一出现,系统先把它抓出来”。
第四步:顺着血缘定位问题来源
发现数据错了之后,真正让数据团队头疼的是:到底哪里错了? 假设经营看板上的销售额突然少了20%。
可能是:源系统少数据;同步任务失败;中间表加工错误;字段映射改了;指标计算逻辑变了。如果没有数据血缘,只能一张表、一段SQL慢慢往上查。
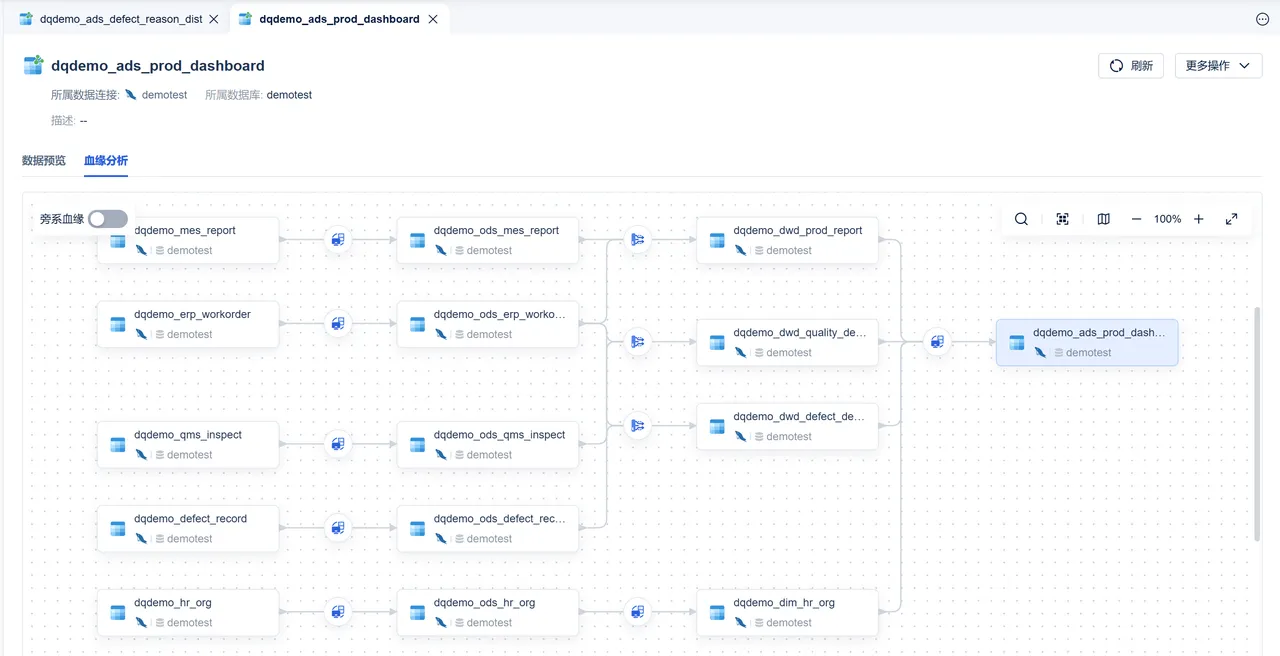
整个排查过程就可以从:异常数据 → 当前表 → 加工任务 → 上游数据表 → 源系统,逐层向上追。这时候数据质量管理才从:数据错了。 进一步变成:哪些数据错了,以及问题大概率出在哪一层。
第五步:形成问题闭环
最后还有最关键的一步:不是发现问题,而是保证问题真的被解决。 一个完整的问题流程至少应该包括:发现 → 分派 → 定位 → 修复 → 验证 → 关闭。
例如:发现客户编码重复;系统生成质量问题;分派给客户数据负责人;负责人完成处理;质量规则重新检测;检测通过;问题关闭。
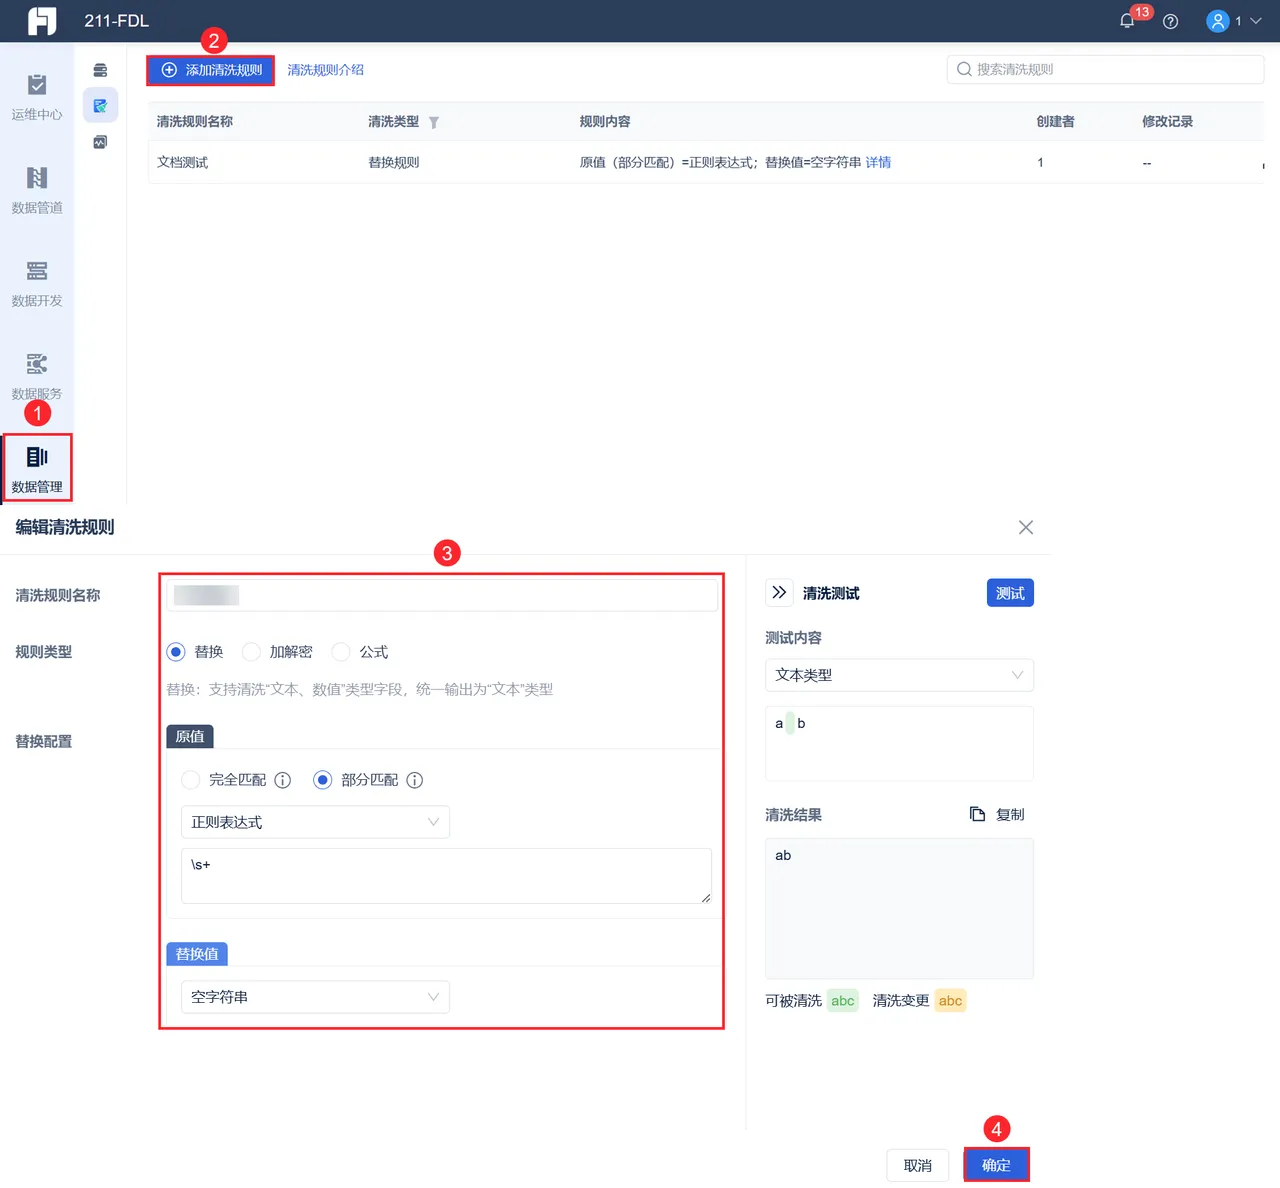
通过问题清单承接质量异常,让一条检测结果真正进入后续的问题处理流程。对于已经明确的脏数据,还可以继续通过数据清洗处理。
目前支持的方式包括:替换、加解密、公式三类清洗规则。比如:客户名称不统一,可以使用替换规则做标准化;敏感字段需要处理,可以进行加解密;
字段需要转换、计算或者重新标准化,可以通过公式处理。也就是说,整条数据质量治理链路可以继续往下走:发现异常 → 找到问题 → 清洗处理 → 再次验证。
如果只是做一个质量大屏,显示:今天发现3521条异常数据。 但没人处理。那这个大屏最多只是一个“问题展示墙”。真正成熟的数据质量体系,最终必须做到:每一个问题有人负责,每一次整改可以追踪,每一类问题能够复盘。
数据质量怎么衡量?别只看“问题数量”
做完规则以后,很多企业还会问:数据质量到底变好了没有?可以关注几个核心指标:规则通过率:通过检测的数据量 ÷ 总检测数据量。问题数量:一定周期内发现多少条质量问题。问题闭环率:已经解决的问题 ÷ 已发现问题。
平均处理时长:从问题发现到关闭平均用了多久。重复问题率:已经解决的问题,是否反复出现。核心数据质量评分:对核心数据对象按照完整性、准确性、一致性等维度综合评分。
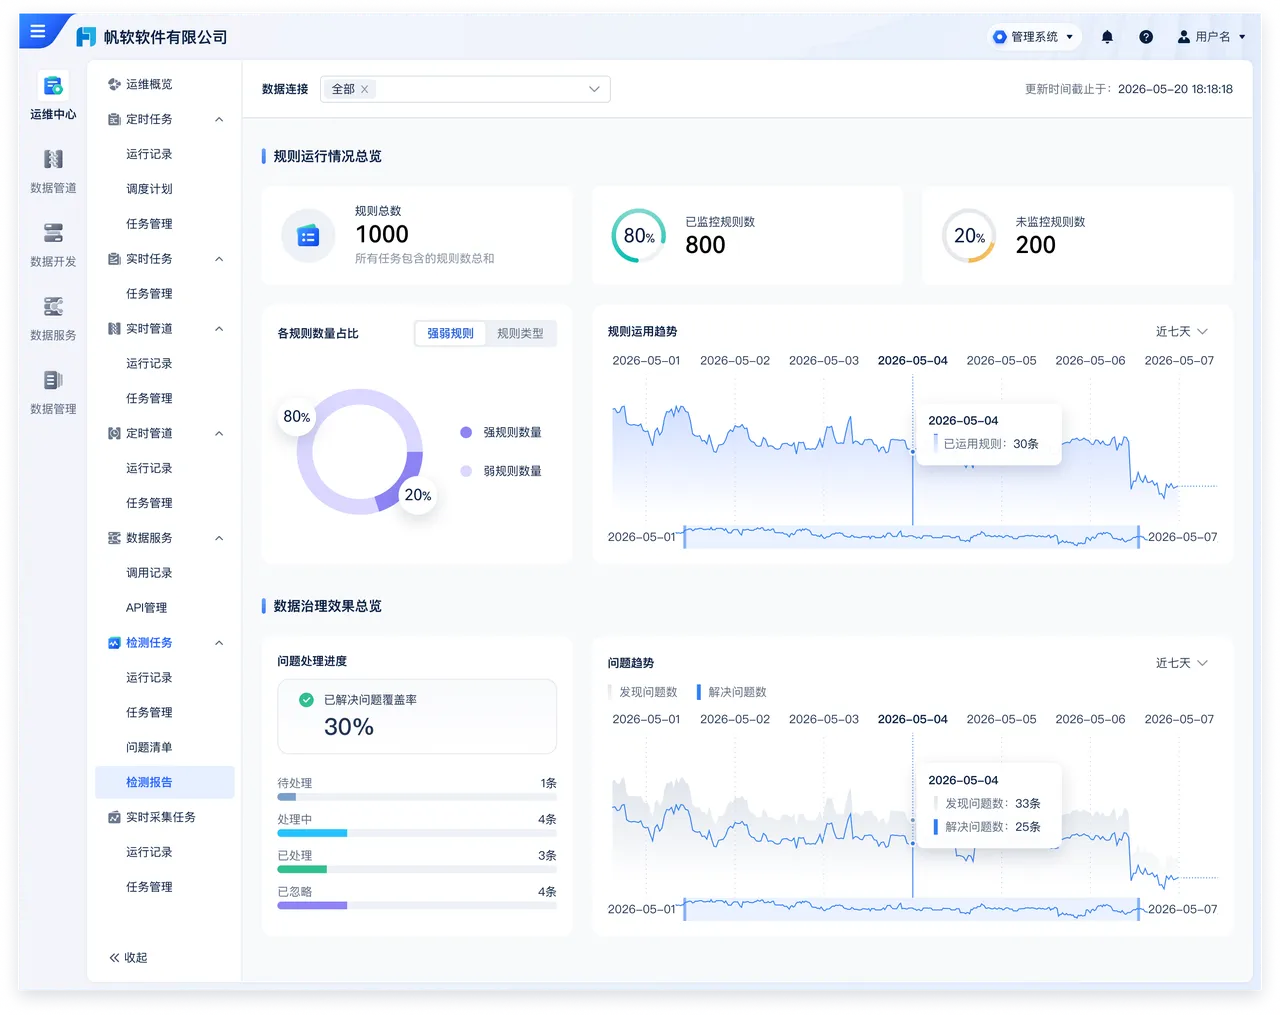
对于管理者来说,他其实并不需要天天看某个字段为空了多少条。真正应该关注的是:哪些数据对象质量最差;哪个业务域问题最多;哪些异常长期没有解决;
整体数据质量是在改善,还是恶化。这样管理层看到的就不再是一堆技术规则,而是一张真正反映企业数据健康程度的质量报告。
最后
数据质量管理,说复杂很复杂,说简单其实就三件事:先知道什么样的数据才算对; 再及时发现哪里不对; 最后保证问题有人解决,而且以后尽量别再犯。 完整性、一致性、准确性、唯一性、时效性、有效性这六个维度,解决的是“怎么看数据质量”。
但真正让数据质量体系产生价值的,是后面的管理闭环:规则检测 → 异常发现 → 明细定位 → 血缘排查 → 问题分派 → 数据清洗 → 结果复核 → 质量监控。 很多企业不是没有数据质量规则,而是停在了“发现问题”这一步。
真正成熟的数据质量治理,应该让每一条异常都能找到来源、找到负责人、得到修复,并持续被监控和复盘。只有这样,数据才能从“能用”,真正走向“敢用”。