2.0 增加了一条校验:文档体里不允许出现元字段(metadata fields)作为字段名。这条改动来自 PR 14003,合并提交的标题就是
Mappings: Enforce metadata fields are not passed in documents。此前这类字段会被当成普通字段处理,产生各种诡异行为。
说明
来源和边界先交代:本文的依据出自 v2.4.6 标签下的官方文件(2.0.0.asciidoc、DocumentParser.java、SimpleAllMapperTests.java),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
2.0 增加了一条校验:文档体里不允许出现元字段(metadata fields)作为字段名。这条改动来自 PR 14003,合并提交的标题是
Mappings: Enforce metadata fields are not passed in documents。此前这类字段会被当成普通字段处理。本文对照 v2.4.6 的源码核对了它的触发条件,有几处和直觉不一样。
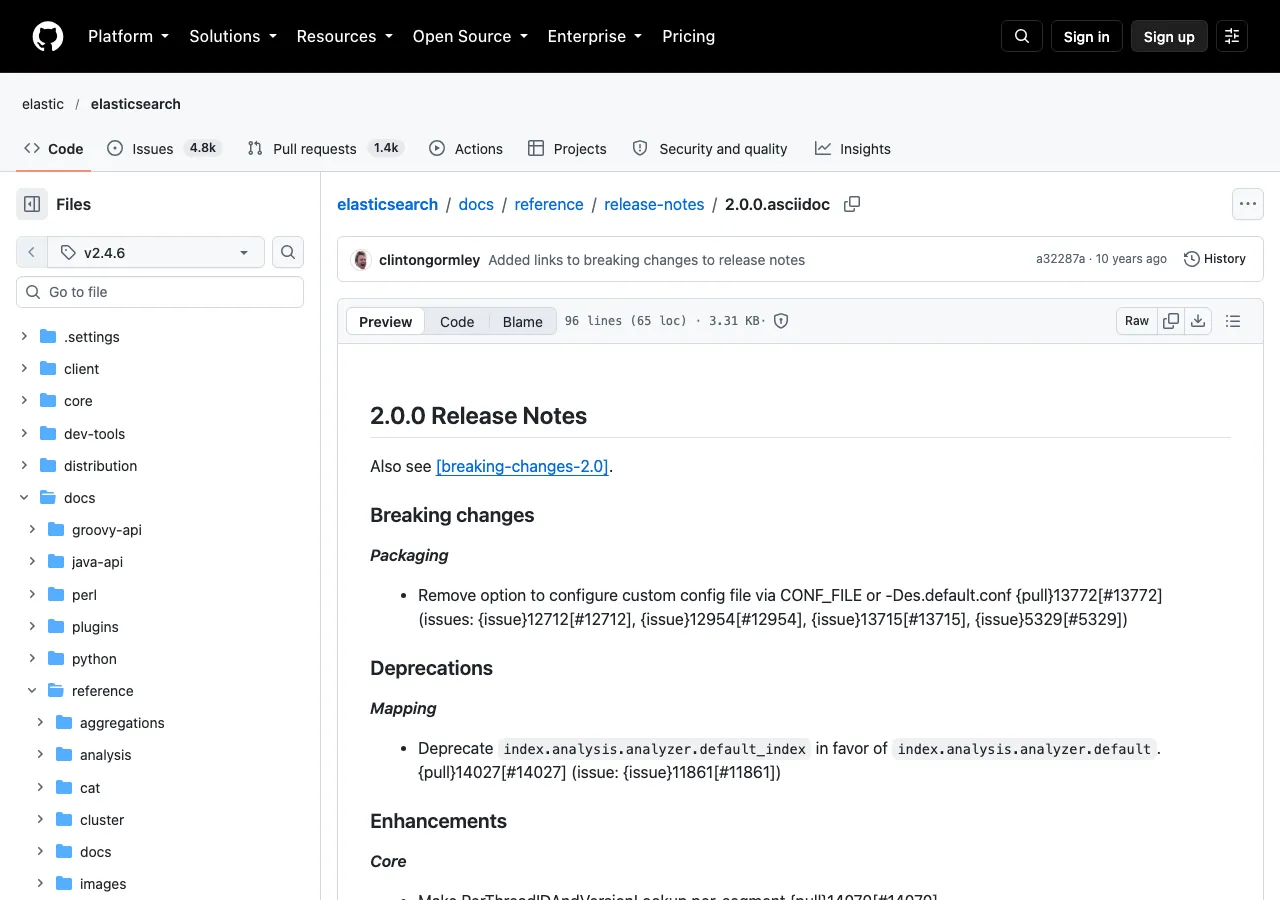
图 1:官方文件 2.0.0.asciidoc(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 2.0.0.asciidoc
条目与提交
2.0.0 release notes 的 Bug fixes 里,Mapping 分类下有这一条(release-notes/2.0.0.asciidoc 第 67 行):
Mappings: Enforce metadata fields are not passed in documents {pull}14003[#14003] (issues: {issue}11074[#11074], {issue}13740[#13740], {issue}3517[#3517])
合并提交的标题(commit ab31ea6813c1):
Merge pull request #14003 from rjernst/fix/13740
Mappings: Enforce metadata fields are not passed in documents
它同时关联了三个 issue(11074、13740、3517),说明这个问题在社区里被提过不止一次。
图 2:官方文件 SimpleAllMapperTests.java(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 SimpleAllMapperTests.java
它被放在 Bug fixes 里,但升级时要当 breaking 看
这条改动在 release notes 里归类是 Bug fixes,不是 Breaking changes。从 ES 的角度看没错,它修的是"文档里混进元字段会产生异常行为"这个 bug。从使用者角度看,它会让以前能写入的文档写入失败。
扫 release notes 的人通常只看 Breaking changes,这条放在 Bug fixes 里,容易漏。升级 2.0 之前,我建议把它单独排查一遍,不要只扫 Breaking changes。
下面几节是读 v2.4.6 源码得到的触发条件。它们决定了"升级后到底哪些写入会失败",比 release notes 那一行字具体得多。
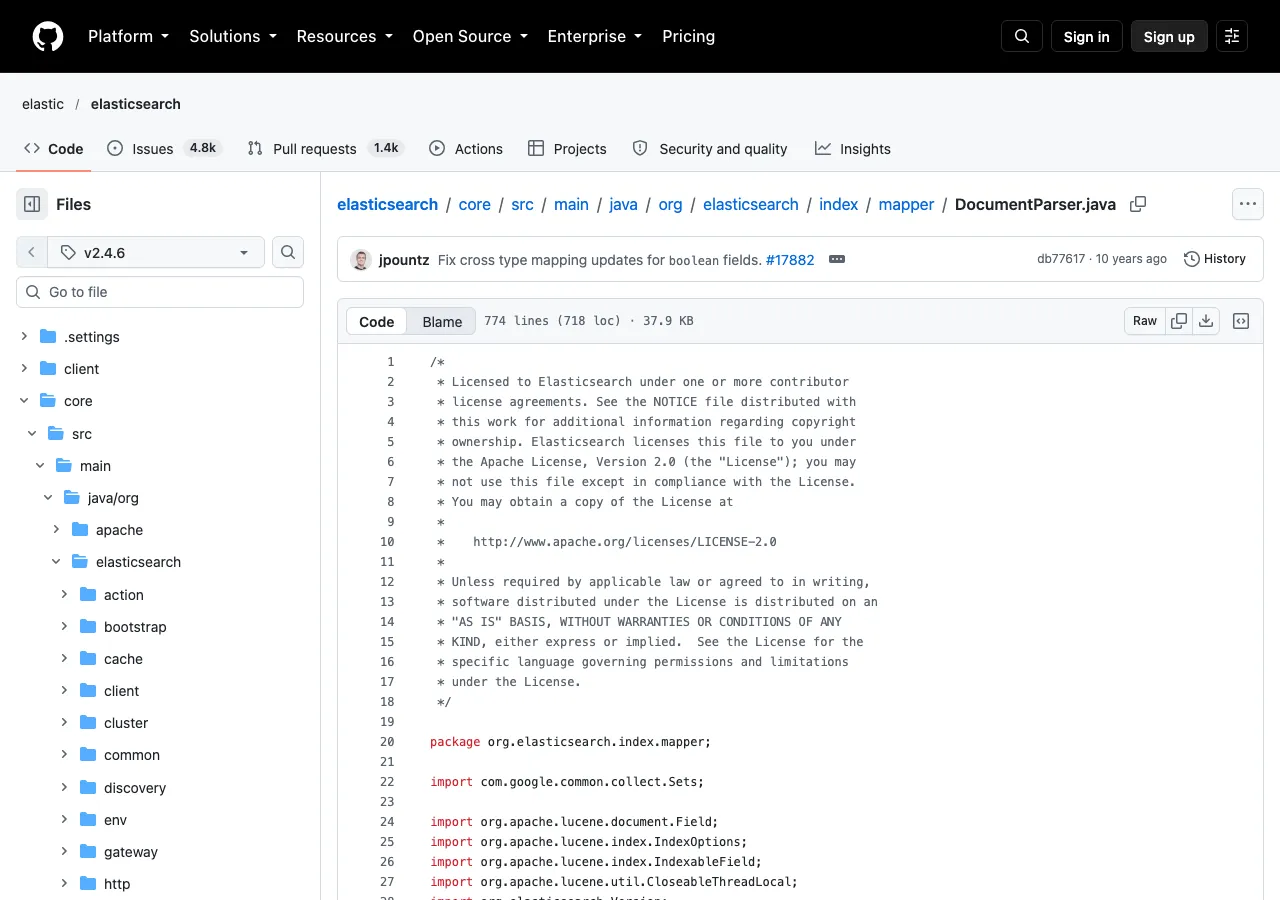
图 3:官方文件 DocumentParser.java(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 DocumentParser.java
源码里的触发条件
检查在 DocumentParser 第 204–207 行:
if (atRoot && MapperService.isMetadataField(currentFieldName) &&
    Version.indexCreated(context.indexSettings()).onOrAfter(Version.V_2_0_0_beta1)) {

    throw new MapperParsingException("Field [" + currentFieldName + "] is a metadata field and cannot be added inside a document. Use the index API request parameters.");
}
从这几行能读出三件事。
第一,错误消息是固定的:Field [xxx] is a metadata field and cannot be added inside a document. Use the index API request parameters. 抛出的是 MapperParsingException。消息最后一句也给了去向:这些值要通过索引 API 的请求参数传,不要写进文档体。
第二,检查按"索引的创建版本"生效。条件里的 Version.indexCreated(...).onOrAfter(Version.V_2_0_0_beta1) 表示只有 2.0.0-beta1 及之后创建的索引才会抛错。2.0 之前创建的老索引,即使集群升到 2.x,这个检查也不触发。单元测试里能看到老索引的行为:SimpleAllMapperTests 第 470 行附近的注释写的是"the backcompat behavior is actually ignoring directly specifying _all",即对老索引,文档里直接写 _all 是被忽略的。
这一点改变了升级时的风险判断。由此推断:升级当天,写老索引的任务不会因为这条校验失败;任务开始报错的时间点,是按日、按月滚动生成的新索引在 2.x 下创建之后,以及把老索引 reindex 到新索引的时候。这是从条件推出来的,未在真实集群上验证。
第三,被拦的字段名是一个固定集合,见 MapperService 第 106–109 行:
_uid, _id, _type, _all, _parent, _routing, _index, _size, _timestamp, _ttl
共 10 个。常见的 _source、_version、_field_names 不在这个集合里,所以这条校验不会因为它们报错。读一些二手资料会看到"所有下划线开头的字段都被拒绝",从源码看不是这样,我的判断是只有上面这 10 个。
检查的位置有一个没验证的疑点
检查用的是 parser.currentName(),调用点是 第 124 行的 parseObject(context, mapping.root, true)。再看它前面的 第 102–111 行:解析器先要求文档以对象开头,再要求下一个 token 是 FIELD_NAME,然后才进入 parseObject。所以进入检查时,currentName() 读到的应该是文档的第一个字段名。
随后在对象内部的循环里(第 251–258 行),遇到 FIELD_NAME 只是更新 currentFieldName,没有再调用同一个检查。在 v2.4.6 里搜 isMetadataField,在文档解析这条路径上只有第 204 行这一处。
对照单元测试,IdMappingTests 第 128 行和 TimestampMappingTests 第 810 行的用例,文档里都只有那一个元字段,它恰好是第一个字段。
综合起来,从代码读到的一种可能是:元字段只有出现在文档第一个字段时才会触发这个检查。这只是读代码的推断。可能还有别的路径(例如动态映射阶段)会拒绝或处理后面的元字段,未找到,也未跑过。所以后面的文字不写"哪怕只混进一个元字段,整条文档就被拒"这类断言,需要你在 2.x 上实测,方法见后文"复现一次"一节。
问题是什么
元字段是 ES 自己维护、以下划线开头的字段。文档体本质上是一个 JSON 对象,用户可以写:
PUT my_index/my_type/1
{

  "_id": "some-other-id",
  "title": "hello",
  "_timestamp": 1234567890,
  "_routing": "abc"
}
2.0 之前,这类字段对新建的索引按普通字段处理,对应的元字段语义和用户字段重名,行为取决于具体字段。release notes 只给了一句"enforce",没有列出每个字段在 2.0 之前的具体表现,本文也没有逐个验证,所以不展开猜测。
可以确认的只有两点:官方认为这是个需要修的 bug;2.0 之后对新建索引改成直接抛错。
新建索引直接拒绝
2.0 起,对 2.0.0-beta1 及之后创建的索引,在文档解析阶段命中元字段名就抛 MapperParsingException。老索引不受影响(见上文)。
遇到这个错误怎么处理
- 确认这些字段是不是本来就想当普通数据用。如果是(比如业务里确实有个叫
_timestamp的数据列),改个名字:用不带下划线的名字,或者在写入前做字段重命名。ES 把下划线前缀留给自己,用户字段不要用; - 如果是客户端或 ETL 工具自动加的(有些框架会把内部字段带进文档体),在写入前过滤掉;
- 如果确实需要
_routing、_parent这类值,它们有专门的位置,错误消息的最后一句已经说了:用索引 API 的请求参数。比如路由用PUT index/type/id?routing=xxx,不要写进文档体; - 重建索引时尤其容易遇到:从旧索引 scroll 出来的
_source里如果带着这些字段,reindex 到 2.x 新建的索引会失败,需要先清洗。这一条和前面的版本判断是一致的:目标索引是 2.x 创建的,检查就会触发。
下划线前缀的约定
元字段全部以下划线开头,这是一条命名约定:下划线前缀归 ES 自己,用户数据尽量不占用。这样同一个 JSON 里能区分"引擎管理的信息"和"用户的数据"。
这条约定在 2.0 以后也很有用:元字段集合一直在变。_timestamp、_ttl 后来被删除,_all 在 6.0 默认关闭,_type 在 7.x 废弃、8.x 移除(这几个版本的变化本文没有逐个核对,以各版本迁移文档为准)。如果数据里存了同名的用户字段,语义冲突可能在不同版本里反复出现。
日志场景里更容易遇到:采集端或业务框架可能把下划线开头的内部字段带进事件。建议在写入端立一条规矩:字段名不以下划线开头。这比事后清洗成本低。
复现一次,看看实际表现
下面的实验用来回答前面留下的疑点。每一步都建议在 2.x 的测试集群上做,本文没有跑过,预期是按源码推断的。
先用 2.x 新建一个索引(创建版本在 2.0 之后),再依次写三份文档:
# 1) 元字段是文档里唯一的字段(和单元测试一致)
curl -XPUT 'localhost:9200/meta_test/doc/1' -d '{ "_timestamp": 1234567890 }'

# 2) 元字段不在第一位
curl -XPUT 'localhost:9200/meta_test/doc/2' -d '{ "title": "hello", "_timestamp": 1234567890 }'

# 3) 元字段在嵌套对象里
curl -XPUT 'localhost:9200/meta_test/doc/3' -d '{ "meta": { "_timestamp": 1234567890 } }'
按源码,第 1 条应该抛 MapperParsingException,消息是 Field [_timestamp] is a metadata field and cannot be added inside a document. Use the index API request parameters.。第 3 条里的 _timestamp 不在根部,atRoot 为 false(见 第 308 行的调用),所以按这个检查不会拒绝。第 2 条是上面那个疑点,结果以实测为准:如果没有被拒,说明这条校验只覆盖第一个字段,你在清洗存量数据时就不能只靠"报错"来发现问题。
再用同样的三份文档写到一个 1.x 时代创建的老索引,对照一下"老索引不触发"这个判断。
如果通过 _bulk 写入,某一条带元字段的文档是整批失败,还是只有那一条失败,本文没有验证。读 _bulk 响应时,不要只看 HTTP 状态码,要遍历 items 看有没有 error,这是 _bulk 一贯的用法,和这条校验无关。
存量数据怎么清洗
如果旧索引的 _source 里已经混进了这类字段,reindex 到 2.x 新建的索引会失败。有三条路,按偏好排序:
一,reindex 时用脚本剔除。2.4.6 的 reindex 文档标注这个 API 是 experimental,脚本字段用的是 inline(不是后来版本的 source):
POST _reindex
{

  "source": {
    "index": "old_index" },
  "dest": {
    "index": "new_index" },
  "script": {

    "inline": "ctx._source.remove('_timestamp'); ctx._source.remove('_ttl')"
  }
}
脚本语言取决于集群的默认脚本语言,2.x 默认是 Groovy,上面的写法按 Groovy 语法。2.4.6 的 script.inline 默认是 sandbox,Groovy 不在沙箱语言里,默认配置下这段 inline 脚本可能被拒,需要先把 script.inline 设为 true,或者改用放在 config/scripts 下的 file 脚本。目标索引要事先建好,reindex 不会复制源索引的 mapping 和 settings,这是文档开头 IMPORTANT 里写的。
二,写入前在 ETL 或客户端过滤。在写入端把下划线开头的字段统一改名或丢弃(比如加前缀 raw_timestamp),源头干净,后面所有环节都不用再管。
三,改用不带下划线的字段名。如果这些数据本来就是业务数据,从源头改名最直接。
倾向是一加二的组合:先用脚本清洗跑通迁移,再改 ETL 保证不再产生新数据。只做其中一件,过一段时间脏数据还会出现。
升级前怎么自查
先扫一遍现有索引里有没有这类字段。只有前文列出的 10 个名字会触发校验,所以扫描的时候对着这个集合查:
# 看 mapping 里有没有这 10 个名字作为用户字段(注意区分真正的元字段配置,如 _all、_ttl 的 mapping 定义)
curl -s 'localhost:9200/*/_mapping' | grep -o '"_\(uid\|id\|type\|all\|parent\|routing\|index\|size\|timestamp\|ttl\)"' | sort | uniq -c
mapping 里的命中不一定是问题,因为 _all、_ttl、_timestamp 等本来就可以出现在 mapping 的元字段配置里,要区分它们是在 properties 下面还是在类型根部。再抽查 _source 里有没有:
curl -s 'localhost:9200/my_index/_search?size=100' | grep -o '"_\(uid\|id\|type\|all\|parent\|routing\|index\|size\|timestamp\|ttl\)":' | sort | uniq -c
_search 的响应里每条 hit 本身也带 _id、_type、_index,直接 grep 会全部命中,所以上面这条命令的结果要把 hit 层级的字段排除掉,更可靠的做法是只对 _source 里的内容跑,例如先用 ?filter_path=hits.hits._source 过滤再 grep。命中了就按上一节的三条路处理。
这个扫描应该在升级前做,不要等升级后任务开始失败再回头。
和后续版本的关系
这条规则在后面的版本中一直保留,元字段集合本身在收缩。每少一个元字段,这类冲突就少一处。下划线前缀留给引擎这个约定,仍然适用。
写在最后
这条改动藏在 Bug fixes 里,升级时要当 breaking 排查。源码里它有三个具体条件:只对 2.0.0-beta1 及之后创建的索引生效,被拦的是 10 个固定名字,检查位置在根对象的入口。
三个结论按可信度排序:错误消息和 10 个名字是读源码得到的,可信;"老索引不触发"来自条件判断加单元测试里的注释,可信度中等;"只检查第一个字段"是读代码的推断,需要实测,不要直接当结论用。
升级前先扫一遍 mapping 和 _source,命中就先清洗。写入端保证字段名不以下划线开头,这条规矩一旦立住,后面的版本都不用再为它操心。
参考
本文对照 Elasticsearch
v2.4.6标签的官方文档核对,引文逐字取自原文。撰写时未启动集群、未运行测试。