摘要:如果给"猫"编号 42、"狗"编号 43、"汽车"编号 100,模型会不会以为猫和狗更像?不会。这个看似幼稚的问题,恰恰是理解现代 AI 的入口。今天讲清楚:文本、图像、音频是怎么变成数字的,以及为什么"编号"和"意义"是两件完全不同的事。
一、一个幼稚却致命的问题
假设我们给词编个号:
猫 = 42,狗 = 43,汽车 = 100。
现在问你:模型会不会因此认为,"猫"和"狗"比"猫"和"汽车"更相似?
直觉上好像会——42 和 43 挨得多近啊,和 100 差了十万八千里。
答案是:不会。
因为 42、43、100 只是编号。它们和"你是 3 号员工、我是 7 号员工"没有本质区别——数字大小不携带任何关于"这个人什么样"的信息。你不会因为工号挨着,就判断两个人是同类。
这个看似幼稚的问题,是理解现代 AI 的一道分水岭。
很多人在这一步就糊涂了:既然 AI 是靠"算数字"工作的,那它怎么可能"理解"猫和狗都是动物、都和汽车不一样?
答案不在编号里,在另一组数字里。
今天,我们就从"万物如何变成数字"讲起,一路讲到"意义是从哪冒出来的"。
二、为什么非得变成数字
先说最朴素的起点:计算机不懂文字、不懂图片、不懂声音。它只会做数学运算。
所以不管你喂给模型什么——一段文字、一张照片、一段语音、一段视频——第一步永远是同一件事:
把它变成数字。
然后模型对这些数字做一大堆乘法和加法(想想我们上一讲说的:输入 × 权重 + 偏置),最后吐出一个结果。
所以整个流程其实非常机械:
文本 / 图像 / 音频 / 视频 → 转换成数字(向量、矩阵、张量)→ 模型做数学运算 → 输出结果。
真正有意思的问题,是"怎么变"和"变成什么"。
三、装数字的四种容器
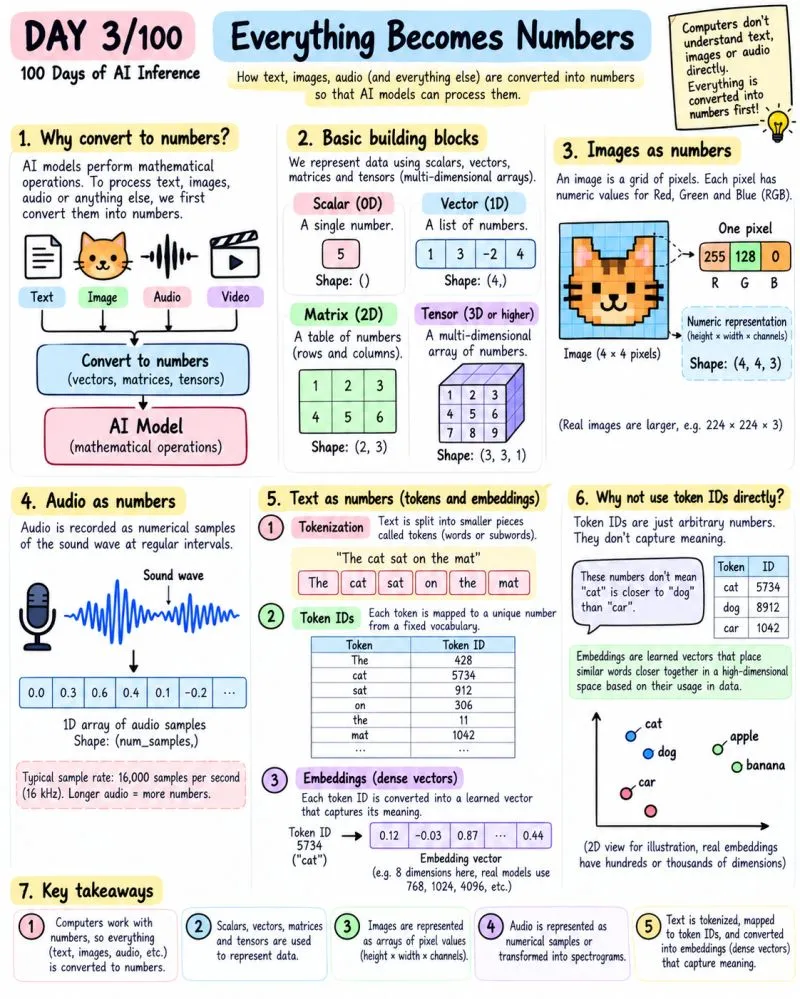
数字不是散着装,而是按"形状"组织起来的。图里给了四种,从简单到复杂:
|
名称
|
维度
|
例子
|
形状(shape)
|
| --- | --- | --- | --- |
|
标量 Scalar
|
0 维
|
5
|
()
|
|
向量 Vector
|
1 维
|
1, 3, −2, 4
|
(4,)
|
|
矩阵 Matrix
|
2 维
|
1 2 3 / 4 5 6
|
(2, 3)
|
|
张量 Tensor
|
3 维及以上
|
一个 3×3×1 的数块
|
(3, 3, 1)
|
用行话说:标量是"一个数",向量是"一串数",矩阵是"一张表",张量是"一摞表"。工程上把它们统称为张量,只是维度不同。
(顺便纠个常见的误读:很多人以为"张量"是个很高深的东西。其实在深度学习里,它就是"多维数组"的另一个名字。一个 RGB 图像,就是个三维张量,没什么神秘的。)
记住"形状"这个概念,后面会反复用到——因为模型能不能处理一份数据,第一件事就是看形状对不对得上。
四、三种东西,三条变数字的路
1. 图像:拆成像素,每个像素三个数
图像本质上是一张网格,每个格子里是个像素。而每个像素,用红、绿、蓝三个数值表示。
图里举了个 4×4 像素的小猫图,其中一个像素是 R=255、G=128、B=0(橙色)。
那这张图的形状就是 (4, 4, 3)——高 4、宽 4、通道 3。
真实图片当然大得多,常见的 (224, 224, 3)。算一下:224 × 224 × 3 = 150,528 个数字。
一张你眼里的"一只猫",在模型眼里是 15 万个数字。
2. 音频:按频率采样,变成一串数
声音是波。所谓数字化,就是每隔极小的一段时间,记录一次波的振幅。
图里给的典型采样率是 16 kHz,也就是每秒 16000 个采样点。所以一段 10 秒的语音,就是大约 16 万个数字。
音频越长,数字越多。另外,工程上还经常把音频转成"语谱图"(spectrogram)——把声音变成一张二维图,然后当图像处理。这也是为什么很多语音模型,骨子里其实是图像模型。
3. 文本:三步走——切词、编号、嵌向量
文本最绕,因为它要过三关。
第一步,分词(Tokenization)。 把句子切成小块,叫 token。可以是整词,也可以是词的一部分(子词)。
"The cat sat on the mat" → The / cat / sat / on / the / mat
第二步,编号(Token ID)。 每个 token 从一张固定的词表里,查到一个唯一编号。
The = 428,cat = 5734,sat = 912,on = 306,the = 11,mat = 1042
第三步,嵌入(Embedding)。 把每个编号,换成一个学出来的稠密向量。
cat (5734) → [0.12, −0.03, 0.87, …, 0.44]
图里示例用了 8 维,真实模型常见 768、1024、4096,甚至更高。
关键就在第三步。 前面两步只是"登记造册",第三步才让数字有了意义。
五、为什么不能直接用编号?这才是重点
回到开头那个问题。
图里第 6 节专门讲了这件事,还给了一个特别妙的细节。
在那张"为什么不能直接用 Token ID"的图里,作者举的例子是:cat = 5734,dog = 8912,car = 1042。
等等——前面那句 "The cat sat on the mat" 里,1042 明明是 mat。怎么这里 1042 又成了 car?
这不是笔误(真实系统里一个编号只能对应一个 token,否则就乱套了)。但这恰恰泄露了一个真相:
编号是随意分配的。数字本身,不携带任何意义。
同一个数字,在这张表里是"垫子",在另一张表里就可能是"汽车"。你必须拿着词表去查,才知道 1042 指的是什么。离开词表,1042 什么都不是。
所以:如果模型只拿到 42、43、100,它根本无法判断猫和狗是不是更像。 数字之间的距离,在这里毫无意义。
那怎么办?
从"编号"到"坐标"
既然一个数字不够,那就用一串数字来表示一个词——把每个词,变成高维空间里的一个坐标点。
这就是 embedding(嵌入/向量表示)。
而这一串数字不是人规定的,是模型从海量语料里学出来的:经常出现在相似上下文里的词,被放到空间中相近的位置。
于是奇迹发生了——
"猫"和"狗"的坐标,在空间里挨得很近(都是宠物、都会叫、都要喂);
"汽车"的坐标,离它们很远。
近到什么程度?工程上用余弦相似度(两个向量夹角的余弦,范围 −1 到 1)来量。语义相关的词,典型值在 0.3 到 0.9 之间。
更著名的例子是 2013 年 Mikolov 团队的 Word2Vec 那句经典演示:
国王 − 男人 + 女人 ≈ 女王
这不是人写进去的规则,是从纯统计里涌现出来的:在训练好的向量空间里,"性别"这个方向,居然是一个可以做加减法的稳定方向。
这就是从"编号"到"意义"的飞跃。
六、两种表示法的根本差别
为了让这个区别更清楚,我们把两种表示摆一起:
| |
编号 / One-hot
|
Embedding(稠密向量)
|
| --- | --- | --- |
|
长什么样
|
一个整数,或一堆 0 里一个 1
|
几百到几千个小数
|
|
谁定的
|
词表的排列顺序(人为/随意)
|
模型从数据中学出来
|
|
有没有"远近"
|
没有。42 和 43 不比 42 和 100 更近
|
有。语义相近 → 空间相近
|
|
能不能做类比
|
不能
|
能(国王−男人+女人≈女王)
|
|
维度代价
|
词表多大就要多少维(可能 5 万+)
|
通常 300 ~ 几千维
|
一句话概括:编号是"给它起个名",嵌入是"给它定位"。
名字不能推理,坐标才能。
(补一句技术沿革:早年的 Word2Vec(2013)、GloVe(2014)、FastText(2016)是"静态嵌入"——一个词永远一个向量,所以"bank"到底是河岸还是银行,分不出来。后来的 ELMo、BERT、GPT 做成了"上下文嵌入":同一个词在不同句子里有不同向量,歧义才真正被解决。这也正是我们前面讲 Transformer 时说的那件事——现代 LLM 的表示,是随上下文动态算出来的。)
七、embedding 不是"额外附件",它本身就是模型最大的参数块之一
这里有个特别漂亮的闭环,值得点出来。
我们上一讲说过:模型 = 一堆从数据学来的参数(权重和偏置)。
那 embedding 是什么?它正是模型参数的一部分。
每个 token 对应一个向量,词表有多大,就有多少个向量;每个向量有多少维,就有多少个数。两者相乘,就是 embedding 这一层的参数量。
拿 GPT-3 举例:词表约 50,257 个 token,每个用 12,288 维表示——乘出来是约 6.17 亿个参数。这还不算 Transformer 各层的注意力矩阵和前馈网络。
所以"把文字变成数字"这一步,不是模型之外的预处理,它就在模型里面,而且是学出来的。
这也解释了为什么"词表大小"和"嵌入维度"是模型设计里的重要决策:词表太小,很多词要拆得七零八落,效率低;维度太低,细微语义差别装不下;维度太高,参数爆炸、显存吃不消。处处是权衡。
八、三次认知升级,给做业务的人
讲到这里,这个技术话题对非技术读者意味着什么?我觉得有三点,值得带走。
第一,数字不等于意义。
猫=42、狗=43,不代表它们更像。这句话放在管理里同样成立:员工的工号、门店的编号、项目的编号,都只是"名字"。你不能因为两个编号挨着,就认为两件事性质相近。
更常见的误区是 KPI:两个业务都拿了 85 分,不代表它们健康程度一样。分数是编号式的度量,不是坐标式的理解。别用数字代替理解。
第二,数字化 ≠ 信息化。
很多公司自豪地说"我们完成了数字化"——把合同、单据、客户资料全录进了系统。
但这往往只做到了"编号"那一层:东西进系统了,可系统并不知道它们之间的关系。你查得到单条记录,却算不出规律。这就像只给了模型 token ID 却没给 embedding——它没法推理。
真正的分水岭在于:你的数据结构,能不能反映真实世界的关系结构? 能不能让"相近的东西在数据里也相近"?
做不到这一点,你有的只是一个更贵的数据库。
第三,表示方式,决定了能力的天花板。
在 one-hot 的年代,没人能做出"国王−男人+女人=女王"这种类比,不是算力不够,是表示方式不允许。表示方法一换,能力才解锁。
这提示我们一件事:很多瓶颈,看起来是"资源不够",其实是"表示不对"。
业务跑不动的时候,先别急着加人加钱。先问问:我们对这件事的"表示"——指标定义、数据结构、流程切分——是不是本身就限制了解法?换一种切法,可能比加十倍资源管用。
九、结语
回到开头那个幼稚的问题:猫=42、狗=43,是不是比汽车更像?
现在你知道答案了。
编号只是名字,数字本身不携带意义。真正让 AI"理解"猫和狗相近的,是另一组从数据里学出来的坐标——在那个高维空间里,猫和狗是邻居,汽车在很远的另一个街区。
所以"万物皆数字"这句话,只对了一半。
更准确的说法是:万物先变成数字,然后数字在训练中长出结构,结构里才涌现出意义。
真正值钱的从来不是"数字化"这个动作,而是让数字之间的关系,忠实映射现实世界的关系。
对个人也一样:记住一个概念的名字(编号),和真正理解它在知识网络中的位置(坐标),是两种完全不同的"懂"。前者让你在饭桌上能提一嘴,后者让你在关键时刻能用上。
免责说明:本文核心框架整理自社交平台上「100 Days of AI Inference」系列 Day 3/100 的《Everything Becomes Numbers》科普速查图及配套英文原文(图中仅标注系列名,未署个人作者,此处不臆造出处);标量/向量/矩阵/张量的示例与形状、图像 (224,224,3)、音频 16 kHz 采样、token ID 与 embedding 示例数值等均以原图为准,属示意性质。文中史实与规格综合自公开资料:Word2Vec(Mikolov et al., 2013,Google,300 维,Google News 约千亿词)、GloVe(Pennington et al., 2014,Stanford)、FastText(Bojanowski et al., 2016);余弦相似度定义与常见取值区间;GPT-3 词表约 50,257、嵌入维度 12,288(embedding 矩阵约 6.17 亿参数)。需说明的是:图中两处独立示例出现了同一编号(1042)分别对应 mat 与 car 的情况,真实系统中 token ID 在词表内必须唯一,文中已就此作教学性说明而非视为错误。本文与本项目第 34 篇(模型=学来的数学函数、参数与显存)、第 32 篇(神经元如何做乘加)、第 29 篇(Transformer 的 Tokens & Embeddings 概念)、第 20 篇(从 BoW 到 BERT 的文本表示演进)相互呼应。本文为技术科普,不构成投资或采购建议。