精调这件事,平台侧的能力已经相当完整:数据集校验、训练、日志、导出、部署都有对应入口,超参大多有默认值。
我用一套宠物用品店的客服数据跑了一遍,把平台能力的边界和成本记下来。
一、能力面
文本精调支持三种训练类型:
| 类型 | 用途 | 数据量级 |
|---|---|---|
| SFT / SFT-LoRA | 教模型一种说法、一套口径 | 千条级 |
| DPO / DPO-LoRA | 教模型偏好,从两个回答里选更好的 | 百条级 |
| CPT | 继续预训练,灌领域知识 | 千万 token 级 |
这次做的是 SFT-LoRA:让模型学会「自称小毛、称客户铲屎官、不说亲」的口吻,以及固定的退货发货政策。
SFT 和 CPT 的区别值得说清:SFT 教「怎么答」,CPT 教「懂什么」。前者适合口径统一,后者适合领域语料灌注。绝大多数客服、售前场景属于前者。
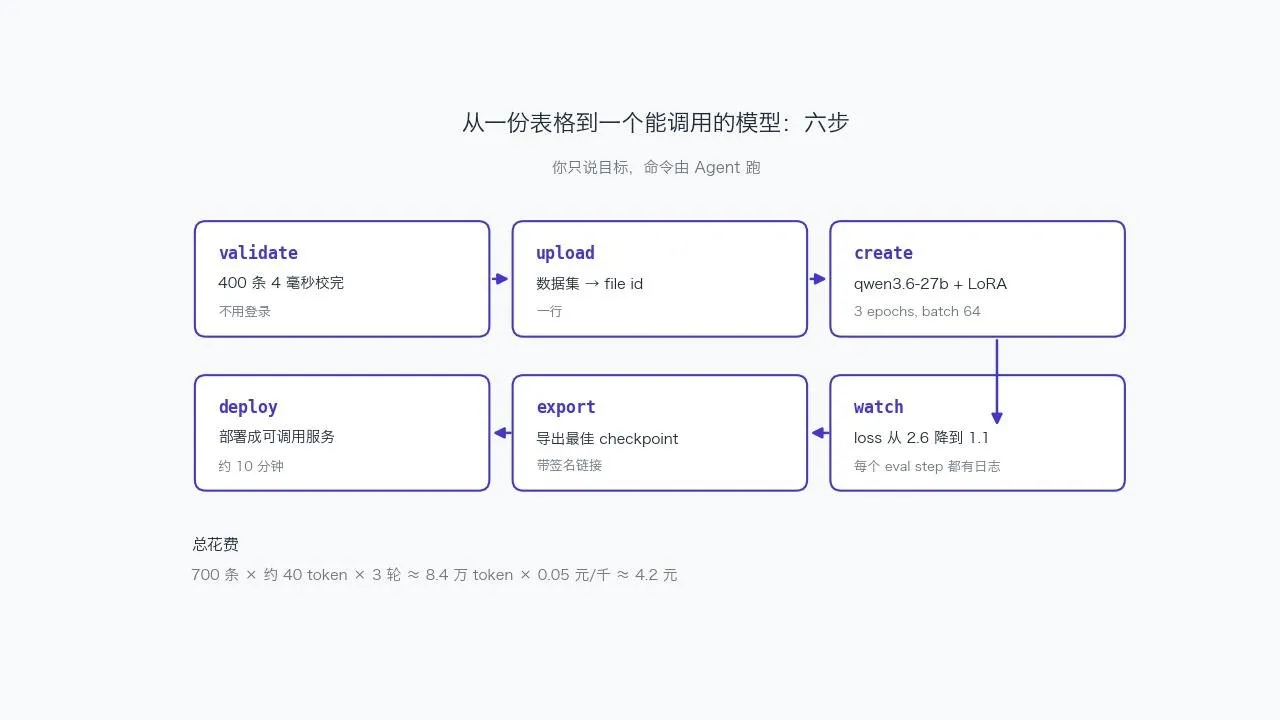
二、四步链路
| 步骤 | 动作 | 是否花钱 |
|---|---|---|
| 校验 | 检查 JSONL 格式与字段 | 不花钱,不需要登录 |
| 训练 | 提交任务,看 loss 与验证集准确率 | 按 token 计费 |
| 导出 | 把某个 checkpoint 发布成可部署模型 | 不花钱 |
| 部署 | 起一个可调用的推理服务 | 按方案计费 |
这四步里,第一步最容易被跳过,但它其实是性价比最高的一步:格式错误、字段缺失、行内有非法字符,都能在几毫秒内定位到行号和字段。
三、数据格式
JSONL,每行一条:
{
   "messages":[{
   "role":"user","content":"买错了能退吗"},{
   "role":"assistant","content":"铲屎官别急,7 天无理由退,运费我们出。小毛跟到底。"}]}
三条经验:
- 字段名必须是
messages,写成 question/answer 会报MISSING_MESSAGES。 - 不要写 system 角色。品牌设定写进每条回答里,模型才会把它当默认反应,而不是「读到 system 才开始扮演」。
- 问答必须同题。这是唯一平台不能替你检查的一环,只能抽检。
四、看训练日志
日志里最有用的是四个字段:
| 字段 | 含义 | 怎么看 |
|---|---|---|
global_step/max_steps |
进度 | 29 步是 700 条 / batch 64 × 3 轮算出来的 |
loss |
训练损失 | 看趋势不看单点 |
eval_loss / eval_acc |
验证集表现 | 判断过拟合 |
grad_norm |
梯度范数 | 突然飙高说明某条数据可能有问题 |
判断标准:eval_acc 涨 + train loss 降 → 训得不够;eval_acc 不涨但 train loss 继续降 → 过拟合;两个都不动 → 回去查数据。
五、实测数据
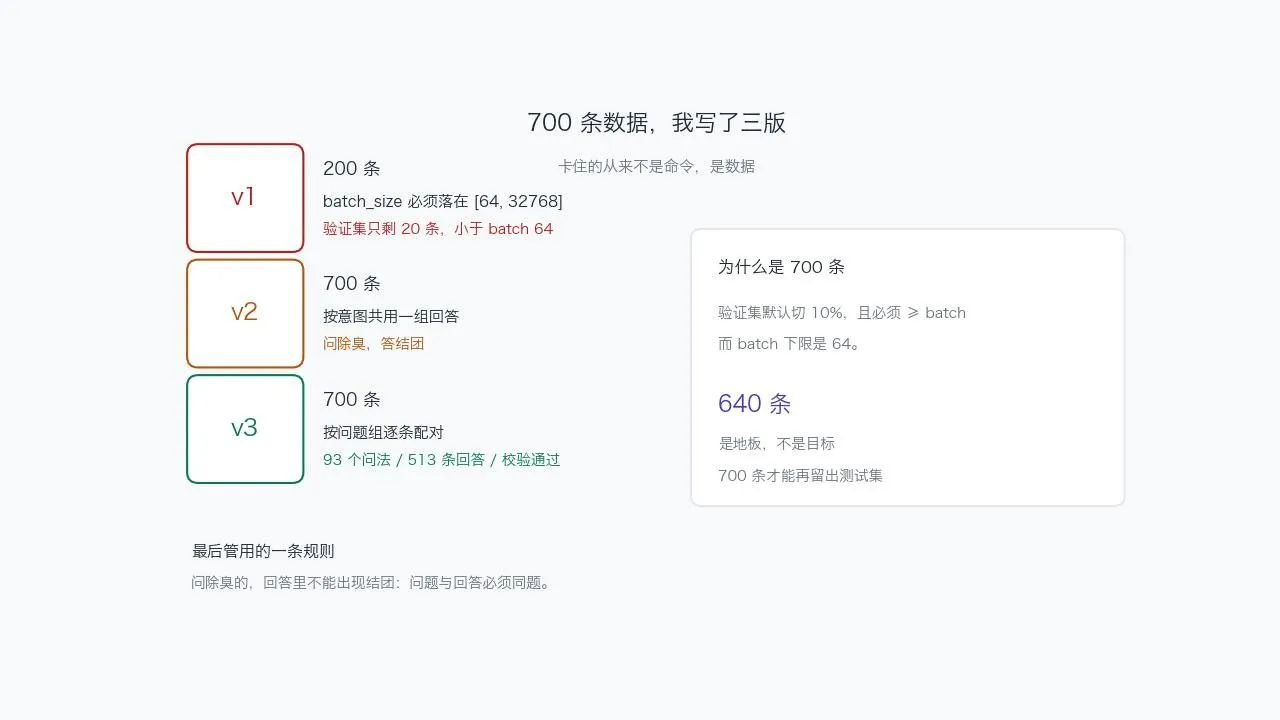
数据规模:700 条对话 / 93 个问法 / 513 条回答 / 平均 27.9 字。
为什么是 700 条:平台默认切 10% 做验证集,而 batch size 下限是 64,验证集不能小于 batch,所以数据量至少 640 条。这是硬地板,不是建议值。
训练参数基本吃默认:
| 项 | 值 |
|---|---|
| 基座 | qwen3.6-27b |
| 训练类型 | sft-lora(服务端 efficient_sft) |
| 轮数 | 3 |
| batch size | 64 |
| LoRA 秩 | 8 |
| 学习率 | 3e-4 |
| 最大长度 | 32768 |
训练过程:
| 步数 | loss | 验证集准确率 |
|---|---|---|
| 9 | 1.1682 | 0.7229 |
| 18 | 0.6559 | 0.8149 |
| 27 | 0.4828 | 0.8459 |
| 29 | 0.474 | 0.8459 |
29 步,58 分钟。第 27 步之后准确率不再涨,说明 3 轮够了。
六、成本
| 项 | 数值 |
|---|---|
| 训练 token | 约 8.4 万(700 × 40 × 3) |
| 单价 | 0.05 元/千 token |
| 训练费 | 约 4.2 元 |
| 部署 | 按方案另计 |
4.2 元。这个数字改变了我的判断:精调的成本瓶颈不在算力,在数据准备。700 条数据我写了两天,改了三版。
时间上也要留余量:任务创建到第一行训练日志隔了 11 分钟(排队与数据预处理),训练 58 分钟,到状态变成 SUCCEEDED 总共约 70 分钟。
部署有两种计费方式,选错了会白花钱:
| 方案 | 计费 | 适合 |
|---|---|---|
| 按 token | 用多少算多少,闲置不计费 | 验证阶段、低频调用 |
| 独占(MU) | 按小时计费,闲置也计费 | 稳定高并发,测试完要及时释放 |
七、能力边界
平台能帮你做的:
- 格式校验,报错定位到行与字段
- 训练监控,每几步输出 loss 与验证集指标
- 自动保存最佳 checkpoint
- 按 token 或独占两种方式部署
平台不能帮你做的:
- 判断数据和问题是否同题(这次第二版就栽在这)
- 判断验证集指标能不能代表线上效果
- 保证有可用的部署资源
最后一条尤其要注意。这次训练成功、导出成功,但部署时遇到:
403 AccessDenied: No access to model ... under plan 'lora'
429 StockLimit: Deployments insufficient resource
前者说明该模型只开放独占部署,后者说明独占规格没有库存。训练成功不等于能上线,这个认知建议在立项时就建立。
最后我用同一份数据重训了一个 4B 模型(qwen3-4b-instruct-2507),它支持按 token 计费部署。225 秒、67,623 token,四分钟后上线:
| 指标 | 27B 基座 | 4B 精调 |
|---|---|---|
| 自称「小毛」 | 0 / 20 | 5 / 20 |
| 政策关键词命中 | 44% | 5% |
| 平均字数 | 276 | 27 |
长度和语气学到了,政策没有:客户要五折它答应,问次日达它说没问题。验证完立即删除部署,按 token 计费,不留闲置成本。
这次对比也说明一件事:验证集指标只能说明「像不像训练数据」,不能说明「规则记不记得住」。小模型会把长尾规则填成最像话术的句子,所以客服类场景要么上大模型,要么把规则放在提示词或检索层。
八、适合谁
| 场景 | 建议 |
|---|---|
| 客服、售前、预约等高频对话 | 适合,口径统一收益明显 |
| 品牌话术、SOP 问答 | 适合,回答长度可控 |
| 价格、库存、活动类问答 | 不适合,用知识库检索 |
| 需要复杂推理的任务 | 不适合,精调不提升推理 |
一个判断标准:如果你的问题是「怎么说」,精调合适;如果是「说什么」,先考虑知识库。