一文读懂阿里云 Qwen3.8-Max:MoE 旗舰模型能力、1M 上下文、收费价格、限流与工具调用教程

简介: Qwen3.8-Max是百炼平台推出的2.4万亿参数MoE旗舰模型,支持图文视频多模态输入与文本输出,具备原生视觉理解、百万级上下文(1M tokens)及长程任务规划能力。华北2/新加坡按量计费:输入12元/百万tokens,输出36元/百万tokens;开通即赠100万免费Tokens(限开源版,商业版不适用)。阿里云百炼AI模型官网:https://t.aliyun.com/U/fPVHqY

Qwen3.8-Max 是百炼平台提供的 2.4 万亿参数 MoE 架构旗舰模型,支持图像、文本、视频多模态输入与文本输出,具备原生视觉理解、超长文档/视频语义解析及长程任务自主规划能力。当前资料未查到该模型的免费 Tokens 额度信息;华北2(北京)地域按量付费原价为输入 12 元/百万 tokens、输出 36 元/百万 tokens;限流在华北2(北京)与新加坡采用动态机制,其他海外地域固定为 RPM 30,000、TPM 5,000,000。详细查看 💰 阿里云百炼AI大模型平台官网指南(费用查询) 如下图:
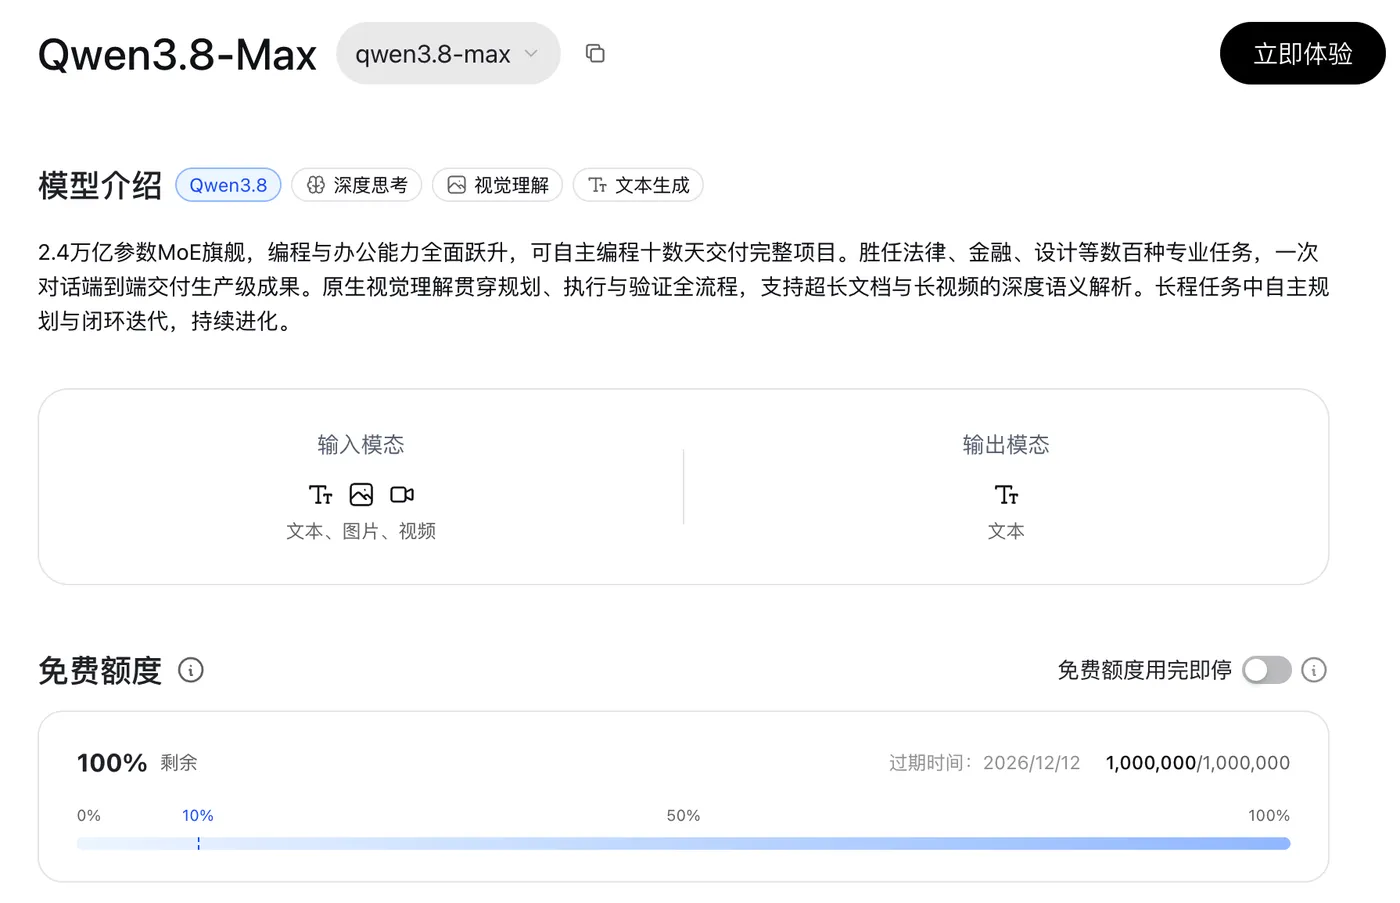
阿里云Qwen3.8-Max模型指南

Qwen3.8-Max模型介绍与能力

  • 模型调用 ID:qwen3.8-max;快照版本 qwen3.8-max-0902(别名 qwen3.8-max-2026-09-02)。
  • 核心能力:编程与办公场景能力提升,适用于法律、金融、设计等专业任务;支持 Function Calling、结构化输出、联网搜索(华北2/新加坡)、前缀续写、上下文缓存、批量推理(仅华北2支持);不支持模型调优。
  • 工具调用:支持 Function Calling,可配合完整工具生态进行多工具调度与端到端交付。

免费 Tokens

开通百炼 👉️ https://www.aliyun.com/product/bailian 免费领取100万Tokens额度,如下图:
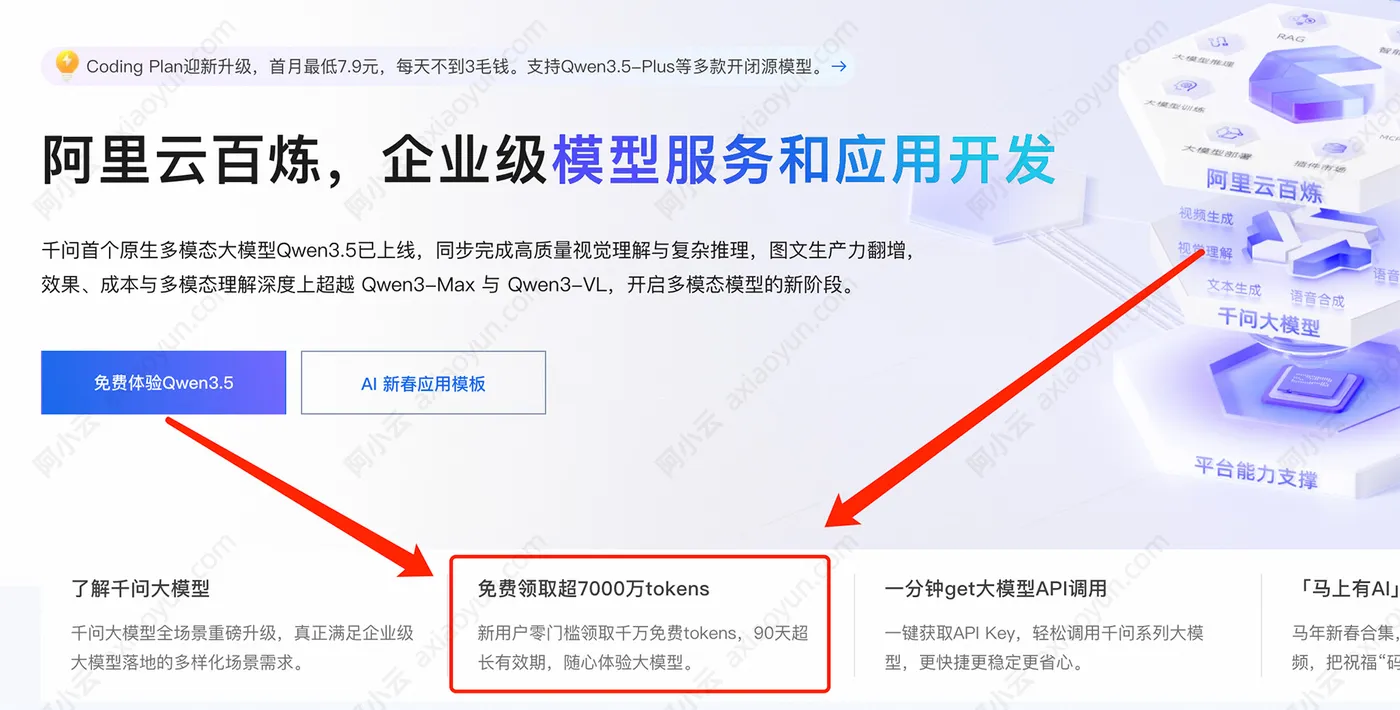
阿里云百炼AI大模型免费领取7000万tokens

同系列开源版 qwen3.8-2.4t-a95b 在华北2(北京)有 100 万 Token 免费额度(有效期 90 天),但该额度不适用于 qwen3.8-max 商业版模型。建议通过百炼控制台或官方定价页确认最新免费政策。

上下文长度

  • 上下文总长度:1,000,000 tokens。
  • 最大输入长度:991,808 tokens(思考模式下 983,616)。
  • 最大输出长度:131,072 tokens。
  • 最大思维链长度:262,144 tokens。
  • 注意:不同 API 输入参数组合下,模型支持的长度可能变化。

费用价格

以下为百炼平台 qwen3.8-max 模型调用原价(不含限时优惠),请以控制台实时显示为准:

地域 计费项 价格(元/百万tokens)
华北2(北京) 输入 12
输出 36
输入(缓存命中) 1.5
输入(Batch File) 6
输出(Batch File) 18
显式缓存创建 15
显式缓存命中 1
新加坡(国际) 输入 14.988
输出 44.965
输入(缓存命中) 1.874
德国/美国(全球)/日本/中国香港 输入 12
输出 36
输入(缓存命中) 1.5

限时优惠活动请前往百炼控制台模型广场查看。

TokenPlan模型订阅计划

也可以选择 👉️ 阿里云百炼TokenPlan模型订阅计划,调用模型更省钱,目前可以选择个人和企业多个版本,如下图:
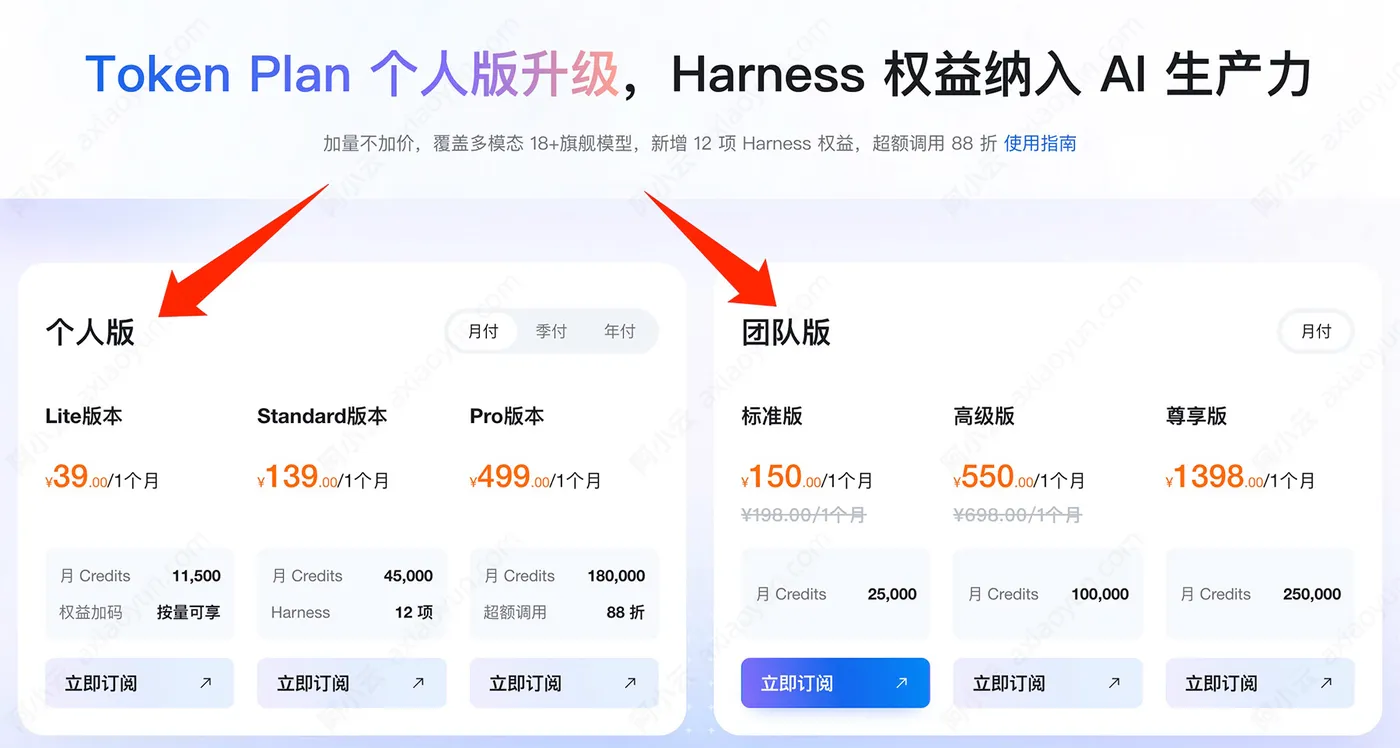
阿里云百炼TokenPlan模型收费价格

模型限流

  • 华北2(北京)与新加坡:采用动态限流机制,TPM 限额根据百炼平台月消费档位调整,RPM 限额较高,正常使用不会触发限流。
  • 德国(法兰克福)、美国(弗吉尼亚)、日本(东京)、中国香港:RPM 30,000,TPM 5,000,000。

相关文章
|
2月前
|
机器学习/深度学习 人工智能 缓存
阿里云百炼产品月报【2026年8月】
阿里云百炼本月重磅升级:Token Plan个人版取消5小时调用限制,新增Qwen3.8-Max/Flash、DeepSeek-V4-Pro等多款大模型;发布Wan3.0-Video全模态视频生成模型;应用广场上新15个行业模板,MCP广场新增42个数据服务;限时组合购68元起,多项后付费享折扣。
809 1
|
2月前
|
缓存 监控 API
最新版阿里云通义千问 Qwen3.8‑Max 功能介绍、计费规则、选型指南及使用教程与常见问题 FAQ
Qwen3.8‑Max作为千问系列新一代旗舰大模型,采用MoE混合专家架构,总参数规模达到2.4万亿,激活参数约950亿,百万级超大上下文窗口,同时具备原生多模态理解、深度思考推理、强工具调用、长周期智能体闭环执行等多项核心能力。该模型不再局限简单问答对话,能够独立完成复杂软件工程、法律文书分析、金融方案推演、长文档深度解析、截图与视频理解等专业任务,支持端到端输出生产级业务成果,是面向复杂业务、智能体开发、高难度科研分析场景的主力基座模型。
911 1
|
4月前
|
人工智能 数据挖掘 API
Qwen3.8-Max-Preview抢先体验:2.4万亿参数、白天1折夜间0.2 折,阿里云百炼TokenPlan个人版39元开通
阿里云千问Qwen3.8-Max-Preview(2.4T参数)正式上线Token Plan,支持代码工程与专业办公场景,内置联网搜索、文搜图等Harness工具。个人版39元/月起,限时白天1折、夜间0.2折,仅限华北2地域交互式调用。在阿里云百炼官网:https://t.aliyun.com/U/fPVHqY 免费领取千万Tokens
561 0
|
3月前
|
缓存 人工智能 Java
刚刚:Qwen3.8-Max发布:概述、功能、定价、速率限制与上下文、内置工具及API 参考指南
Qwen3.8-Max是阿里最新发布的2.4万亿参数MoE大模型,支持图文视频多模态输入,具备编程、法律、金融等数百专业任务能力,原生视觉理解+超长上下文(1M),端到端交付生产级成果。在阿里云百炼官网:https://t.aliyun.com/U/fPVHqY 免费领取千万Tokens
|
2月前
|
人工智能 自然语言处理 API
Qoder Cloud Agents:10分钟,搭建你的专属 Agent
Qoder Cloud Agents 是Qoder推出的全托管Agent平台,支持复杂任务云端执行与实时反馈。其Forward层提供开箱即用的业务集成能力,涵盖身份管理、IM接入、文件存储、技能复用、实时/批量处理及评测观测等,助力开发者10分钟快速搭建专属Agent原型。
509 0
Qoder Cloud Agents:10分钟,搭建你的专属 Agent
|
2月前
|
人工智能 API 开发者
DeepSeek V4.1‑Flash内测实战全手册:API调用、多模态测试、客户端接入与排错完整教程
在大模型快速迭代的节奏下,很多厂商会放出限时中间内测版本,让开发者抢先体验新架构带来的能力提升。DeepSeek V4.1‑Flash就是一款限时开放的中间内测MoE架构模型,采用全新CED因果编码器‑解码器混合专家架构,原生内置图文多模态理解,推理吞吐速度相比V4‑Flash正式版本得到显著提升,同时沿用原有正式版本的计费标准,不需要额外付费。该内测版本不需要重新申请API密钥,基础网关地址保持不变,开发者仅仅修改请求内部model参数即可完成调用。
906 0
|
26天前
|
存储 人工智能 小程序
阿里云2026年双11活动介绍:大模型4.5折起、建站15元/月,视频创作30元起订阅
2026年阿里云双11活动已全面开启。与以往偏重硬件资源的促销不同,本次活动把重心明确放在了AI能力上,以「AI Coding、AI建站、AI创作」三大场景作为主线,把大模型调用、智能编程、网站搭建与视频内容生产这几条用户最真实的使用路径,串成了一套可以按需选配的优惠体系。对个人开发者而言,这是一次低成本上手新模型、试用编程智能体的窗口;对企业团队与内容创作者而言,则是把算力预算与内容产能一次性理顺的采购节点。以下按场景逐条解读。
|
28天前
|
缓存 人工智能 API
阿里云千问模型Qwen3.8-Max:MoE 旗舰模型能力、1M 上下文、收费价格、限流与工具调用教程
Qwen3.8-Max是百炼平台推出的2.4万亿参数MoE旗舰模型,支持图文视频多模态输入与文本输出,具备原生视觉理解、百万级上下文(1M tokens)及长程任务规划能力。华北2/新加坡按量计费:输入12元/百万tokens,输出36元/百万tokens;开通即赠100万免费Tokens(限开源版,商业版不适用)。阿里云百炼AI模型官网:https://t.aliyun.com/U/fPVHqY
|
28天前
|
存储 弹性计算 小程序
阿里云服务器99元一年购买指南:2核2G3M、ECS经济型e实例、续费同价
阿里云99元/年ECS经济型e实例(2核2G、3M独享带宽、40G ESSD系统盘),新老用户同价,支持同价续费至2030年。适合学生练手、个人博客及小型官网等低负载场景,不适用于高并发生产环境。阿里云云服务器ECS官网:https://t.aliyun.com/U/AZBUsA
|
2月前
|
缓存 测试技术 API
Qwen3.8-Flash 来了,Qwen3.8-Flash 功能详解,100万上下文、Agent、Coding 都加强了!
在大模型工程落地的真实场景当中,开发者长期面临一组难以平衡的矛盾:旗舰版本模型推理效果强,但是Token成本高,高并发业务大规模调用时开销压力巨大;轻量化模型成本低廉,但是上下文窗口有限,代码仓库读取、超长文档分析、长链路Agent任务很容易出现信息遗忘,工具调用、代码生成的稳定性不足。很多项目只能被迫采用混合策略,长文档先做文本切片拆分,再交给小模型处理,切片过程会丢失上下文关联信息,增加大量预处理开发工作量。
1065 0