在大模型快速迭代的节奏下,很多厂商会放出限时中间内测版本,让开发者抢先体验新架构带来的能力提升。DeepSeek V4.1‑Flash就是一款限时开放的中间内测MoE架构模型,采用全新CED因果编码器‑解码器混合专家架构,原生内置图文多模态理解,推理吞吐速度相比V4‑Flash正式版本得到显著提升,同时沿用原有正式版本的计费标准,不需要额外付费。该内测版本不需要重新申请API密钥,基础网关地址保持不变,开发者仅仅修改请求内部model参数即可完成调用。
不少开发者在尝鲜的时候遇到各种各样的问题:调用返回404模型不存在、并发请求触发429限流、桌面客户端明明底层API支持图片,界面却提示不支持图片输入、流式输出解析异常,还有部分开发人员直接把带过期标记的临时模型标识符写进生产业务代码,到期之后线上业务大面积报错。本文完整梳理DeepSeek V4.1‑Flash内测模型的全部基础约束,提供curl、Python多套可直接复制运行的调用代码,讲解Harness官方客户端、第三方AI工具的配置步骤,解读计费、并发、生命周期规则,汇总高频报错排查方案,同时给出测试评估最佳实践,提醒开发者区分内测临时版本与正式版本,规避线上业务风险。详情👉访问阿里云百炼大模型服务平台页面 了解。
一、DeepSeek V4.1‑Flash内测模型基础信息与约束规则
模型核心能力
DeepSeek V4.1‑Flash采用全新CED非对称因果编码器‑解码器MoE混合专家架构,上下文窗口上限达到100万Tokens,单次最大输出Token支持128000,原生支持文本+图片多模态输入,不需要额外外挂视觉插件。整体推理吞吐、长文档解析、代码生成速度相比旧版V4‑Flash有明显提升,非常适合用来做长文本问答、代码开发、图文理解场景的效果对比评测。
内测专属模型标识符:deepseek‑v4.1‑flash‑expires‑on‑0910,该ID自带到期标记,是区分临时内测版本和正式版本最重要的标识。
内测阶段硬性约束规则
- 网关地址保持不变:base_url沿用
https://api.deepseek.com,开发者不需要修改网关,继续使用自己已有的API Key,不用重新申请密钥,接入改动极小。 - 并发严格限流:内测环境单账号最大20路并发请求,如果写多线程批量脚本、压测任务,很容易收到429 Too Many Requests报错。该版本只适合小批量本地测试,完全不支持高并发生产业务。正式版V4‑Flash单账号并发上限可达2500,二者差距巨大。
- 计费标准不变:内测期间计费逻辑和deepseek‑v4‑flash正式版本完全一致,区分高峰时段、空闲时段计价,同时支持KV上下文缓存优惠,缓存命中场景输入Token成本会大幅下降,不会因为内测产生额外加价。
- 生命周期为限时有效:
deepseek‑v4.1‑flash‑expires‑on‑0910是临时内测ID,到期之后该标识符直接下线失效。严禁把该字符串硬编码写入生产业务代码、配置文件、容器镜像,到期会造成全部接口调用失败,只能用于本地效果评估。后续官方发布正式稳定版本之后,会提供不带expires过期后缀的正式model ID。 - 客户端与底层API能力不同步:底层模型原生具备图片识图能力,但Harness等桌面客户端内置的模型元数据库没有同步这条临时内测模型的属性,会出现UI弹窗提示“当前模型不支持图片”,这仅仅是客户端配置缺陷,并不是模型本身不支持多模态能力。想要完整测试识图,优先直接调用原始API,或者在第三方AI工具手动编辑模型元信息,手动勾选图片输入类型。
重要业务提示:内测版本定位是给开发者做效果评测、版本对比,不能用于线上业务。正式业务上线,必须等待官方发布不带过期标记的稳定正式模型。
阿里云部署AI Agent:OpenClaw/Hermes Agent全网最简单,只需两步,详情👉访问阿里云OpenClaw/Hermes一键部署专题页面了解。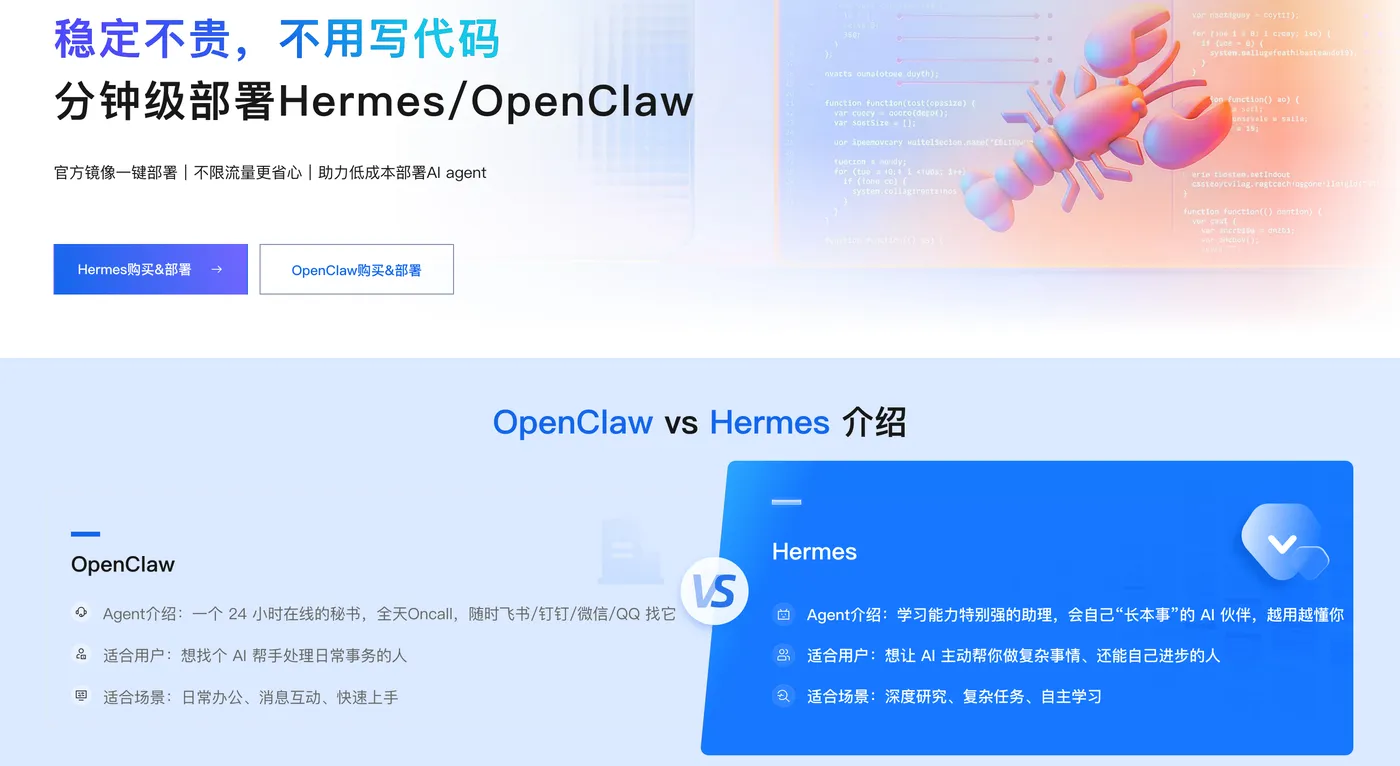
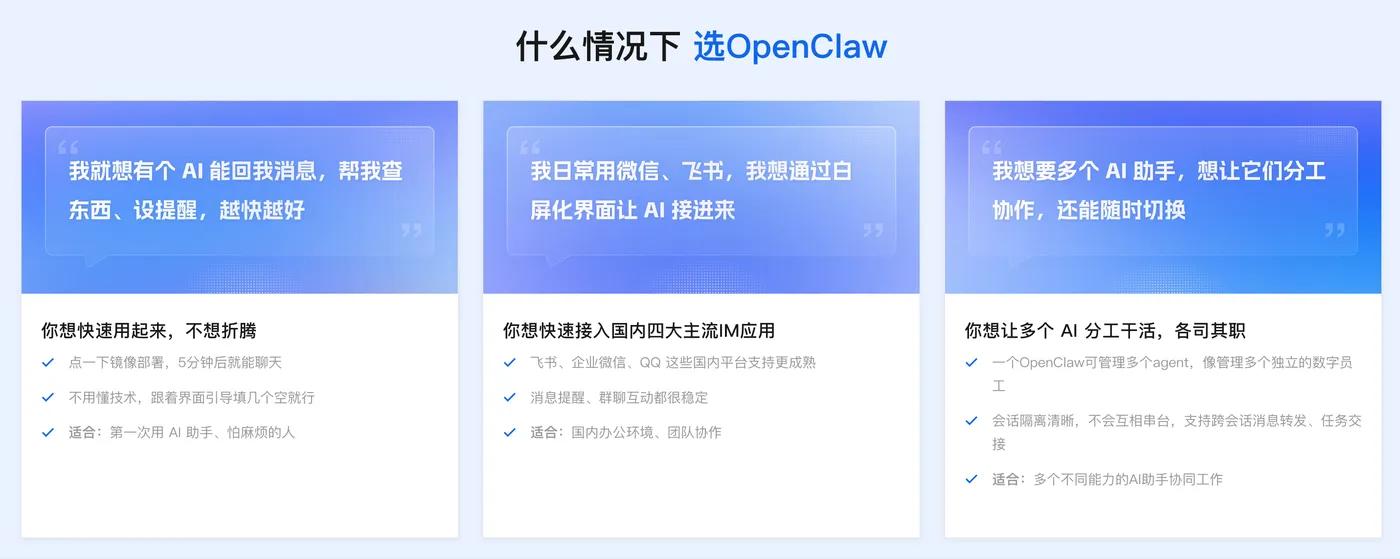
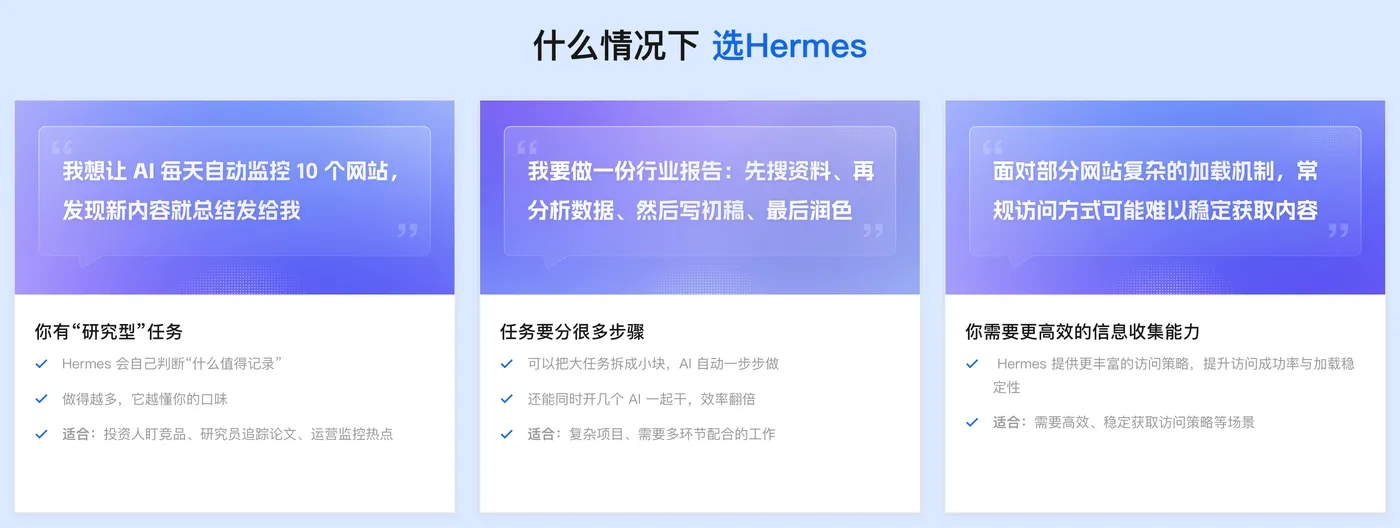
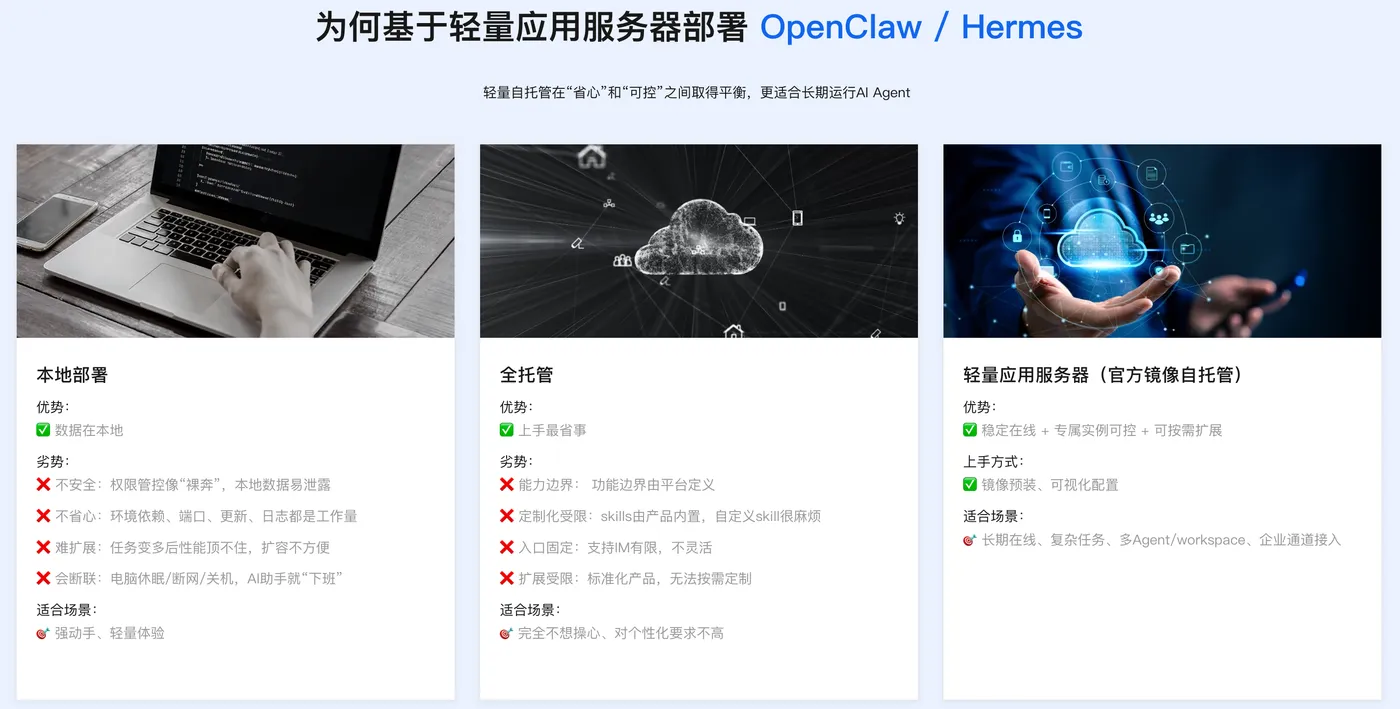
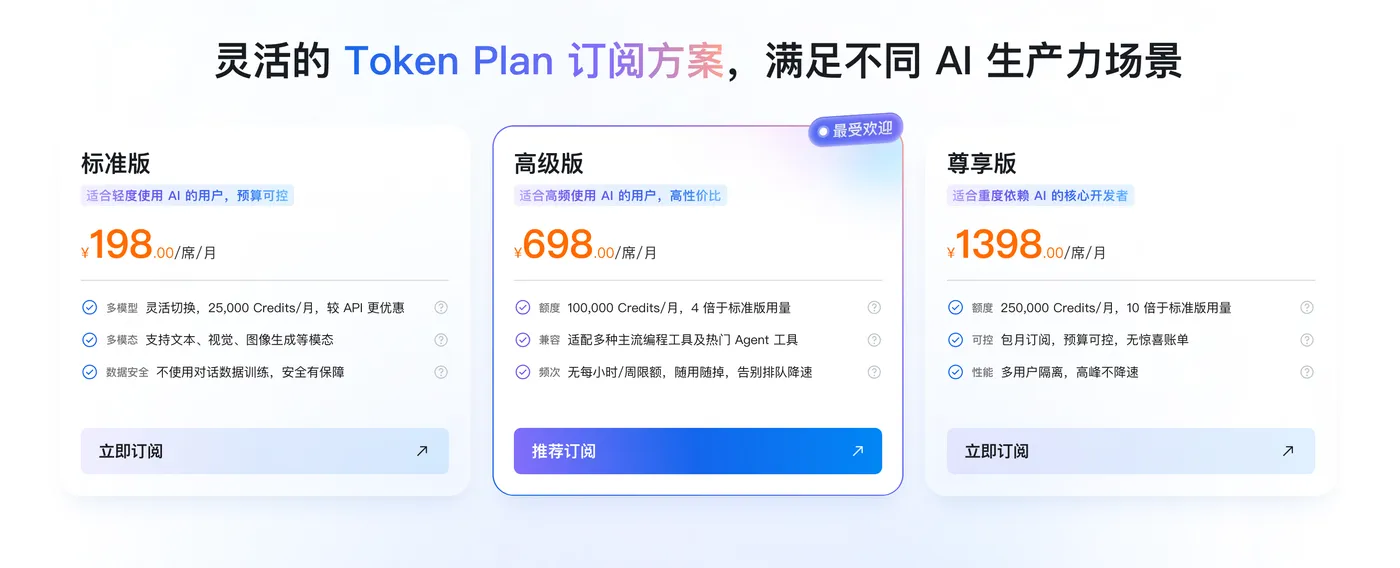
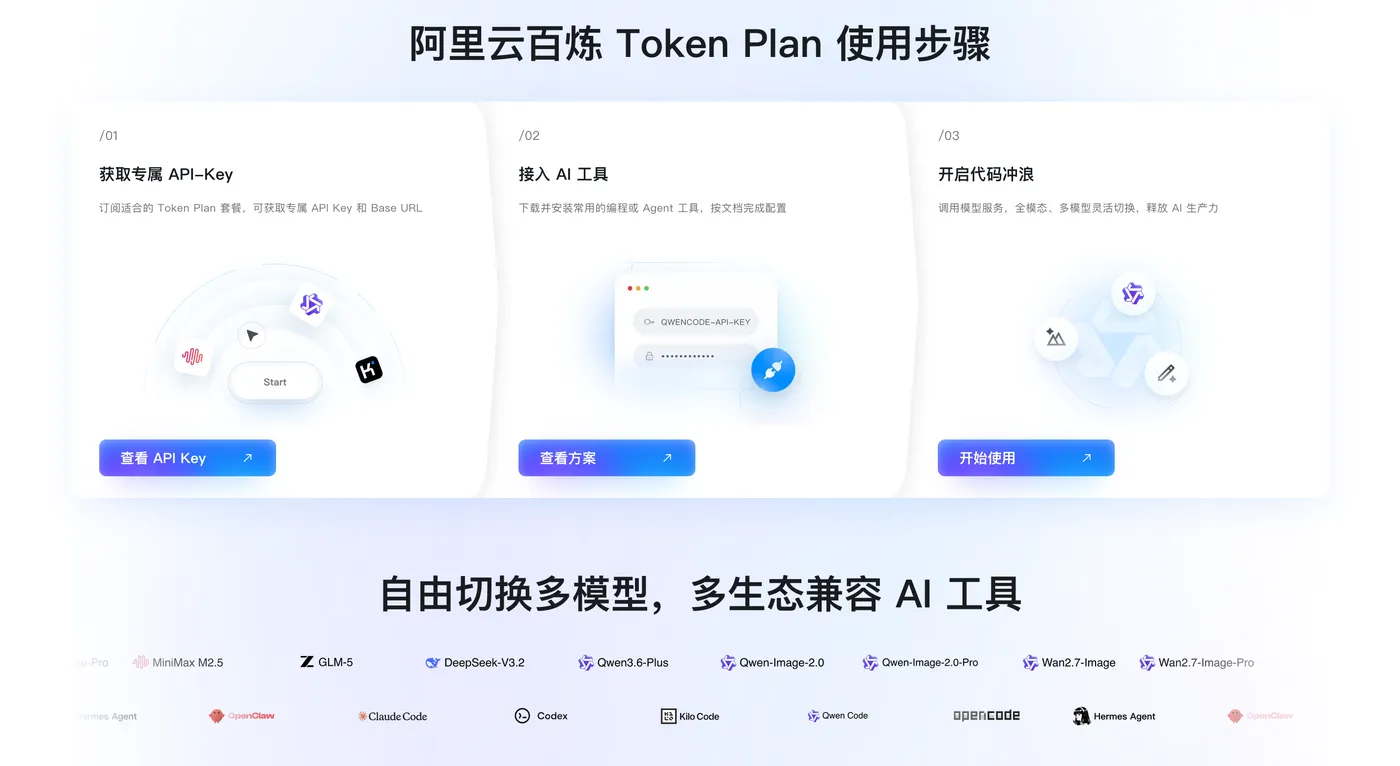
Token Plan Token 最便宜/支持多模型切换:👉访问订阅阿里云百炼Token Plan AI大模型服务 。支持多模型切换,用于多模态模型灵活调用,实现多模型、多工具、多场景下的额度共享与统一管理,兼顾灵活性、稳定性与安全性,大幅降低企业使用大模型的门槛与成本。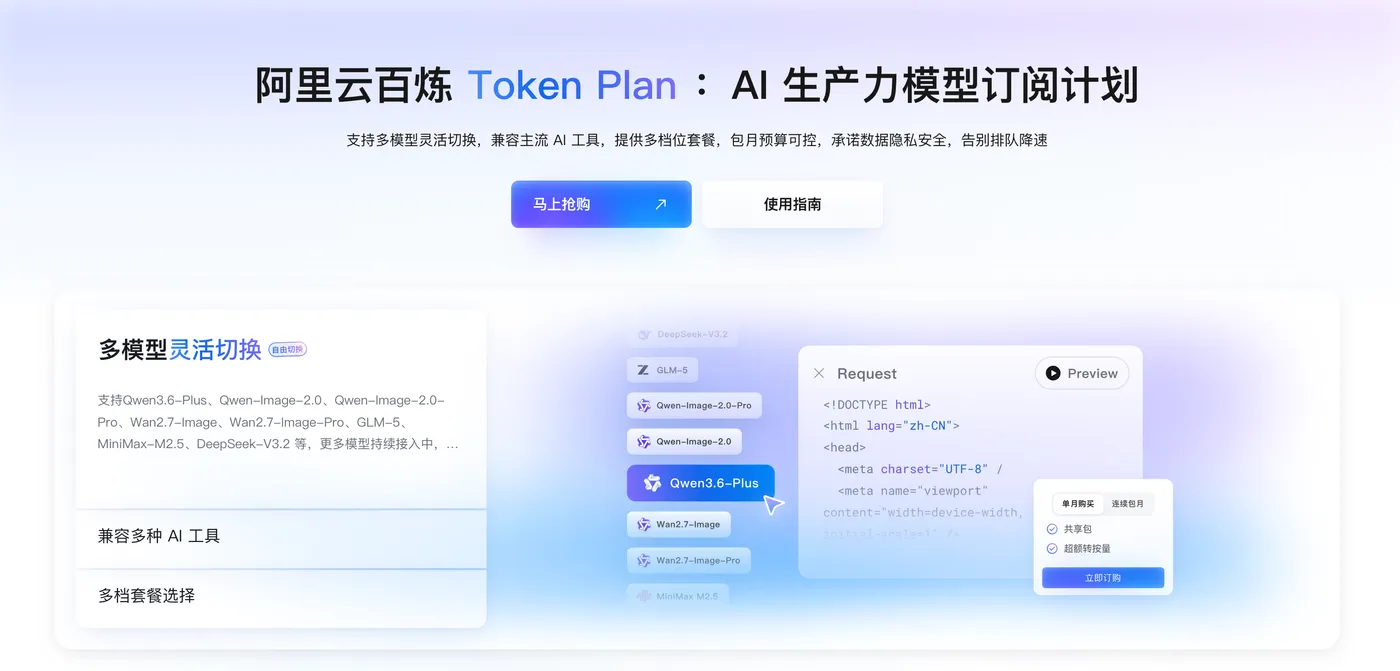
二、API接口调用实操,curl、Python全套可运行代码示例
接口完全兼容OpenAI Chat Completions协议,请求体格式和V4‑Flash正式版几乎完全一致,只需要替换model字段。同时该模型优先使用HTTP2协议,curl调用建议带上--http2参数,低版本OpenSSL环境会出现SSL协商报错。
1、curl命令行文本调用示例
export DEEPSEEK_API_KEY="sk‑xxxxxxxxxxxxxxxxxxxxxxxxxxxxxx"

curl --http2 -X POST https://api.deepseek.com/v1/chat/completions \
-H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
-H "Content‑Type: application/json" \
-d '{
"model":"deepseek‑v4.1‑flash‑expires‑on‑0910",
"messages":[
{"role":"user","content":"请输出你当前的完整模型版本名称,确认是否命中内测版本"}
],
"temperature":0.7,
"max_tokens":2048
}'
调用成功之后,模型会自报版本名称,可以用来校验请求是否真正命中V4.1‑Flash内测实例,避免网关代理自动映射到其他模型。
2、Python基础对话调用示例
先安装依赖包
pip install openai python‑dotenv
完整代码,使用dotenv从本地.env文件读取密钥,避免硬编码密钥。
import os
from openai import OpenAI
from dotenv import load_dotenv

# 加载本地.env环境变量文件
load_dotenv()

client = OpenAI(
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url="https://api.deepseek.com"
)

# 内测临时模型ID
MODEL_TEST = "deepseek‑v4.1‑flash‑expires‑on‑0910"

def simple_chat(prompt: str):
    resp = client.chat.completions.create(
        model=MODEL_TEST,
        messages=[
            {
   "role":"system","content":"你是技术测试助手,回答尽量简洁。"},
            {
   "role":"user","content":prompt}
        ],
        max_tokens=2048,
        temperature=0.6
    )
    content = resp.choices[0].message.content
    usage_info = resp.usage
    return content, usage_info

if __name__ == "__main__":
    res, usage = simple_chat("告诉我你正在运行的完整模型名称")
    print(f"模型返回内容:{res}")
    print(f"Token消耗统计:{usage}")
3、Python多模态识图调用示例,验证原生图片理解能力
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url="https://api.deepseek.com"
)
MODEL_TEST = "deepseek‑v4.1‑flash‑expires‑on‑0910"

def vision_test(image_url: str, question: str):
    response = client.chat.completions.create(
        model=MODEL_TEST,
        messages=[
            {

                "role":"user",
                "content":[
                    {
   "type":"text","text":question},
                    {
   "type":"image_url","image_url":{
   "url":image_url}}
                ]
            }
        ],
        max_tokens=4096
    )
    return response.choices[0].message.content

if __name__ == "__main__":
    # 替换为公开可访问图片链接
    result = vision_test("https://example.com/demo.jpg","详细描述这张图片包含哪些内容")
    print(result)
4、Shell批量评测脚本,用于批量跑测试Prompt集
在本地创建test_prompt.txt,每行写入一条测试问题,脚本循环读取文件进行批量对比测试,适合和旧版本V4‑Flash做效果对比。
#!/bin/bash
export DEEPSEEK_API_KEY="sk‑xxxxxxxxxxxxxxxxxxxxxxxxxxxxxx"
MODEL_NAME="deepseek‑v4.1‑flash‑expires‑on‑0910"

while IFS= read -r line
do
  echo "====测试Prompt:${line}===="
  curl --http2 -X POST https://api.deepseek.com/v1/chat/completions \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -H "Content‑Type: application/json" \
  -d "{
  \"model\":\"${MODEL_NAME}\",
  \"messages\":[{\"role\":\"user\",\"content\":\"${line}\"}],
  \"max_tokens\":1024
  }"
  echo -e "\n\n"
  sleep 2
done < test_prompt.txt
5、流式输出调用片段,适配网页对话场景
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(api_key=os.getenv("DEEPSEEK_API_KEY"),base_url="https://api.deepseek.com")
model_id = "deepseek‑v4.1‑flash‑expires‑on‑0910"

def stream_chat(prompt):
    stream = client.chat.completions.create(
        model=model_id,
        messages=[{
   "role":"user","content":prompt}],
        stream=True,
        max_tokens=1024
    )
    for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            print(chunk.choices[0].delta.content,end="")

if __name__ == "__main__":
    stream_chat("简单说明MoE混合专家模型的工作原理")
三、桌面AI客户端接入配置实操
很多开发者习惯使用客户端工具来调试模型,但是临时内测模型没有同步进入客户端内置模型元数据库,会出现各种异常表现。
方式一:DeepSeek Harness官方客户端接入
- 打开Harness客户端,左下角打开设置,切换至【模型】栏目;
- 在DeepSeek供应商配置板块,点击添加模型;
- 完整粘贴模型ID:
deepseek‑v4.1‑flash‑expires‑on‑0910,保存配置; - 新建会话选中该模型,文本对话可以正常使用,发送提问,让模型输出自身版本,验证调用成功。
已知缺陷:Harness客户端元信息没有标记该临时模型支持图片输入,UI会提示“当前模型不支持图片,请切换支持图片的模型”。底层API原生支持识图,该提示仅客户端层面限制,如果需要测试图片能力,不要使用Harness,改用其他第三方自定义AI工具。
方式二:第三方自定义AI工具接入(例如ZCode、Chatbox等)
- 进入模型设置页面,点击【添加供应商】;
- 供应商名称填写DeepSeek,base_url填写
https://api.deepseek.com,填入自己的API Key,协议选择OpenAI兼容; - 点击【添加模型】,完整复制粘贴内测模型ID;
- 参数配置:上下文窗口填写
1000000,最大输出Token填写128000; - 输入类型必须手动勾选【文本、图片】,这是关键步骤,不勾选会直接屏蔽上传图片按钮;
- 保存配置,新建会话,就可以上传图片完成多模态测试。
核心要点总结:能不能上传图片是由客户端模型元配置决定,不是模型底层能力本身缺失。遇到客户端提示不支持图片,优先直接调用API验证真实能力。
四、计费、限流、生命周期完整解读
- 计费规则:内测版本完全沿用deepseek‑v4‑flash正式版计费规则,区分空闲、高峰两个时段,KV缓存命中可以大幅降低输入Token开销。新版本生成速度更快,同等时间输出更多Token,实际消耗额度速度会变快,测试过程务必监控账号用量余额,避免额度短时间耗尽。
- 并发约束:内测账号单账号最大仅允许20路并发。批量脚本测试必须添加sleep休眠间隔,业务代码需要增加指数退避重试逻辑,严禁拿来做多线程高并发压测,否则会持续收到429限流报错。正式版本V4‑Flash并发上限为2500,二者差异巨大。
- 生命周期管理:
deepseek‑v4.1‑flash‑expires‑on‑0910属于限时临时ID,到期直接失效。禁止写死在生产配置,建议在代码中将model名称抽离成独立配置变量,后续正式版本发布,仅修改配置即可切换,不需要改动业务逻辑。 - 能力评估建议:内测版本适合用来做横向对比,对比旧版本在代码生成、长文档处理、图文解析任务上的效果差异,统计缓存命中率、Token消耗速度,评估是否符合业务预期。
五、高频报错排查与避坑清单
问题1:接口返回404,提示模型不存在
排查:模型ID必须完整复制全部字符串,不能简写,完整字符串deepseek‑v4.1‑flash‑expires‑on‑0910,少任意字符、丢失expires后缀,都会返回404;确认base_url是https://api.deepseek.com。
问题2:返回429 Too Many Requests限流错误
原因:内测账号限制最大20并发。解决方案:降低脚本并发数量,请求之间增加sleep延时,实现指数退避重试逻辑,不要做压测。
问题3:API调用文本正常,桌面客户端无法上传图片
底层模型原生支持图片,问题来自客户端元数据配置。处理方案:自定义添加模型的时候手动勾选图片输入类型;Harness客户端不适合做图片能力验证,更换其他第三方AI工具或者直接调用API。
问题4:调用成功,但是返回结果并不是V4.1‑Flash版本
核对model参数字符串是否完整;确认请求直接访问官方原始网关,不要经过第三方中转代理。可以让模型自报版本名称来确认命中内测实例。
问题5:curl调用出现SSL_ERROR_SSL报错
该模型优先HTTP2协议,curl增加--http2参数;服务器OpenSSL版本过低会导致协商失败,建议升级OpenSSL版本>=3.0.7。
重点避坑清单
- 带expires到期标记的临时内测模型ID,绝对不能接入线上生产环境,只允许本地评测。
- 客户端UI提示不支持图片不等于模型底层没有识图能力,核心能力验证优先使用原始API,不要完全依赖客户端界面提示。
- 内测并发上限很低,不要编写高并发压测脚本,极易触发429限流。
- 新版本推理速度更快,Token消耗速度上升,测试过程持续监控账号余额,防止额度快速耗尽。
- 开发时,模型标识符抽离为独立配置变量,不要硬编码写死业务逻辑,后续切换正式版本只修改配置。
- 不要依赖Harness客户端验证图片能力,图文测试使用API或者第三方自定义AI工具。
- 遇到输出异常、识图缺陷,可以通过官方反馈问卷提交问题,帮助研发团队迭代优化模型。
六、分层测试评估最佳实践
想要完整评测DeepSeek V4.1‑Flash的综合表现,建议采用分层测试流程:
- 优先使用curl或者Python原生API,验证文本对话、图片多模态能力,让模型自报版本,确认确实命中内测实例。
- 准备一套业务测试Prompt集合,通过shell批量脚本跑测试集,和V4‑Flash正式版本做输出质量、生成速度横向对比。
- 统计Token消耗速度、KV缓存命中率,评估新版本在成本和性能之间的收益。
- 桌面AI客户端仅作为辅助体验,所有核心能力评估以原始API返回结果为准。
- 记录模型存在的缺陷与问题,提交官方反馈问卷,等待正式稳定版本发布之后,再评估接入业务系统。
总结
DeepSeek V4.1‑Flash作为限时中间内测版本,依托全新CED MoE架构,带来更高推理吞吐速度,同时原生具备图文多模态理解能力。接入改动非常小:网关base_url保持不变,复用原有API Key,仅仅替换model参数为带expires到期标记的临时ID。
开发者可以通过curl、Python SDK直接完成文本、图片解析测试;但是桌面客户端会存在元数据配置不同步的坑,Harness官方客户端UI层面会提示不支持图片,并非底层模型缺失能力,更换第三方自定义工具,手动勾选图片输入类型,就可以体验识图能力。
该内测版本并发上限只有20,并且模型ID会到期直接失效,只适合本地效果评测,严禁直接接入线上生产业务。开发者在做代码开发的时候,应当把模型标识符抽离配置项,为后续切换正式版本做好准备。通过批量脚本完成多版本对比,监控Token消耗,就可以完整评估新版本在代码生成、长文档、图文任务上的综合表现,为后续正式业务选型提供参考依据。