
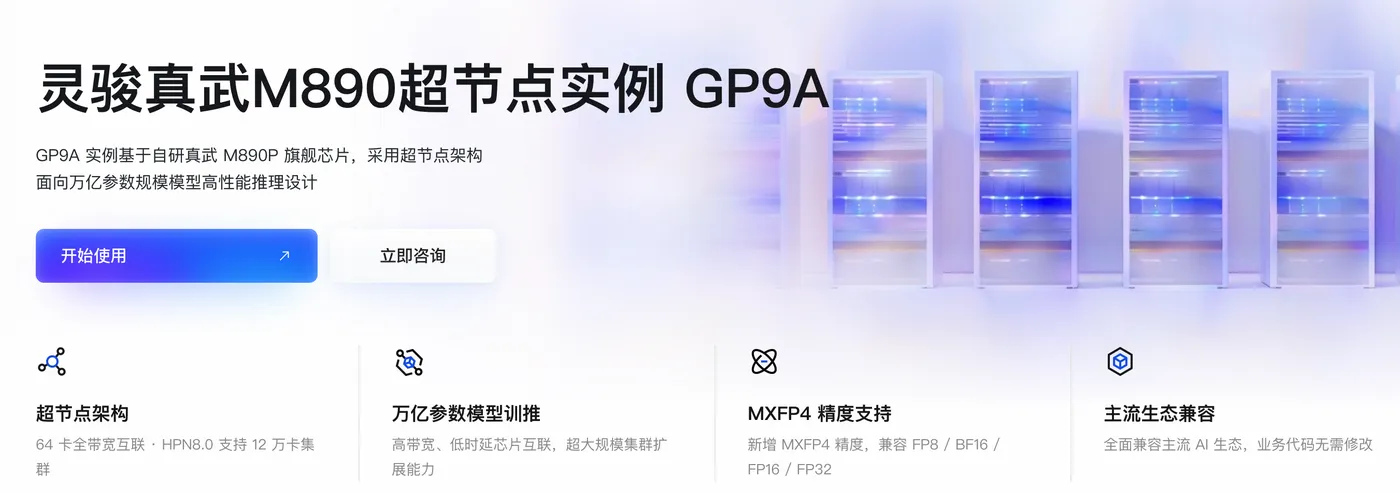
efg3.GP9A 是阿里云灵骏真武 M890P 超节点实例,基于自研真武 M890P(PPU 1.5)芯片,面向万亿参数规模模型的高性能训练与推理场景,详细查看 👉️ 阿里云灵骏真武M890超节点实例GP9A官方指南 如下图:
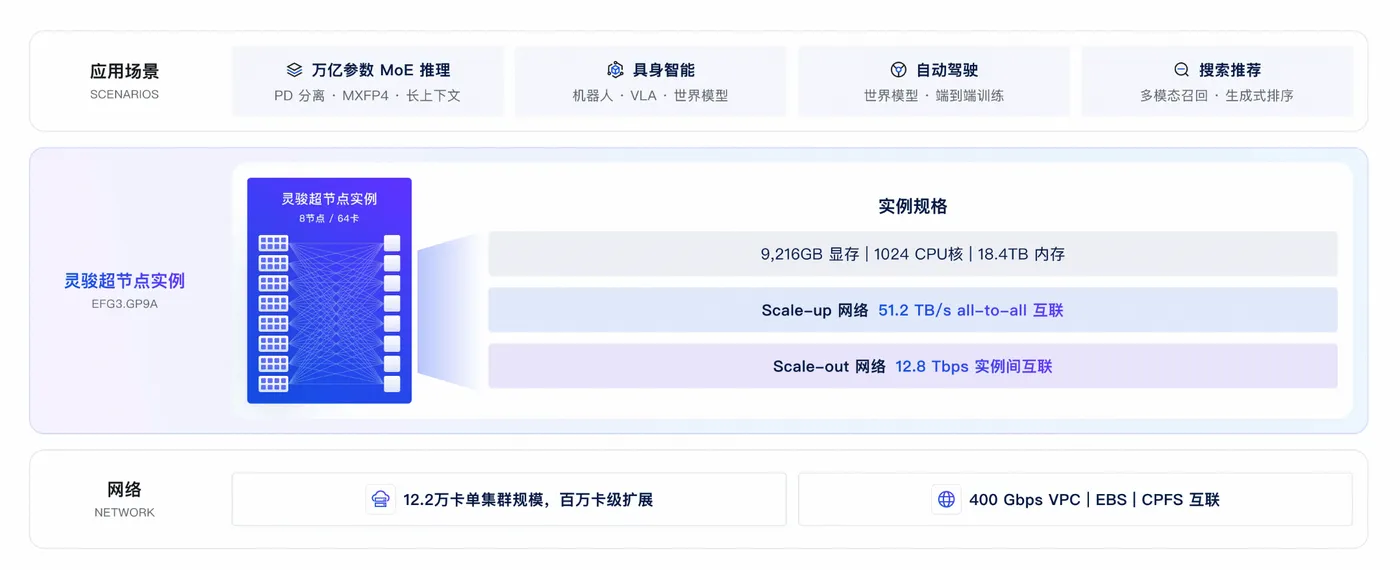
efg3.GP9A实例核心规格参数
efg3.GP9A实例核心规格参数显存、网络:
| 指标 | efg3.GP9A 参数 |
|---|---|
| 芯片代际 | 真武 M890P(PPU 1.5) |
| 每实例 GPU | 64 卡 |
| 显存容量 | 9216 GB(每卡 144 GB) |
| 支持精度 | FP32 / FP16 / BF16 / FP8 / MXFP4 |
| CPU | 1024 核 |
| 内存 | 18.4 TB |
| 本地存储 | 122.88 TB NVMe |
| Scale-up 卡间互联 | 51.2 TB/s |
| Scale-out 实例间互联 | 12.8 Tbps |
| 前端网络 | 3.2 Tbps |
| 最小售卖单元 | 超节点(64 卡 / 8 节点) |
| 开服地域 | 乌兰察布(可用区 D),中卫(规划中) |
架构与特性
- 超节点架构:采用 ICN64 超节点架构,64 卡全带宽互联,通过 HPN 8.0 网络支持最高 12 万卡集群扩展。
- 故障自愈:面向 ICN64 超节点架构支持故障自愈能力,可实现 2^n 卡持续可用。
- MXFP4 精度:新增 MXFP4 精度,相比 BF16 可提供数倍吞吐提升,适用于 LLM 推理、推荐系统等极致吞吐场景。
- 生态兼容:通过 T-Head SAIL™ 软件栈兼容主流 AI 生态,PyTorch、vLLM、SGLang、Megatron-LM、DeepSpeed 等框架开箱即用,业务迁移无需修改代码。
适用场景
- 万亿参数 MoE 模型训推:9216 GB 显存池可承载万亿参数级模型。
- 高性能推理:原生支持 vLLM、SGLang 推理引擎及自研 HolmesLLM 加速,支持 PD 分离推理架构。
- 自动驾驶:已验证兼容 50+ 自动驾驶模型(感知、预测、端到端)。
- 搜推广与多模态:支持推荐系统、搜索排序、广告模型及视觉-语言模型、图像生成、视频理解等任务。
如需了解购买方式或具体计费信息,请查看 💰 阿里云灵骏真武M890超节点实例GP9A官方指南

