
同一个大模型,为什么接入不同的工具、提示词和记忆系统后,执行任务的表现可能相差很大?
做过 AI Agent 开发的人,大概率遇到过类似问题:模型本身不算弱,但执行复杂任务时,总会重复犯错。有时是工具调用不对,有时是上下文管理混乱,还有些问题明明已经修复,换个任务又出现了。
过去,工程师需要分析执行日志,再手动修改提示词、工具说明或任务编排逻辑。
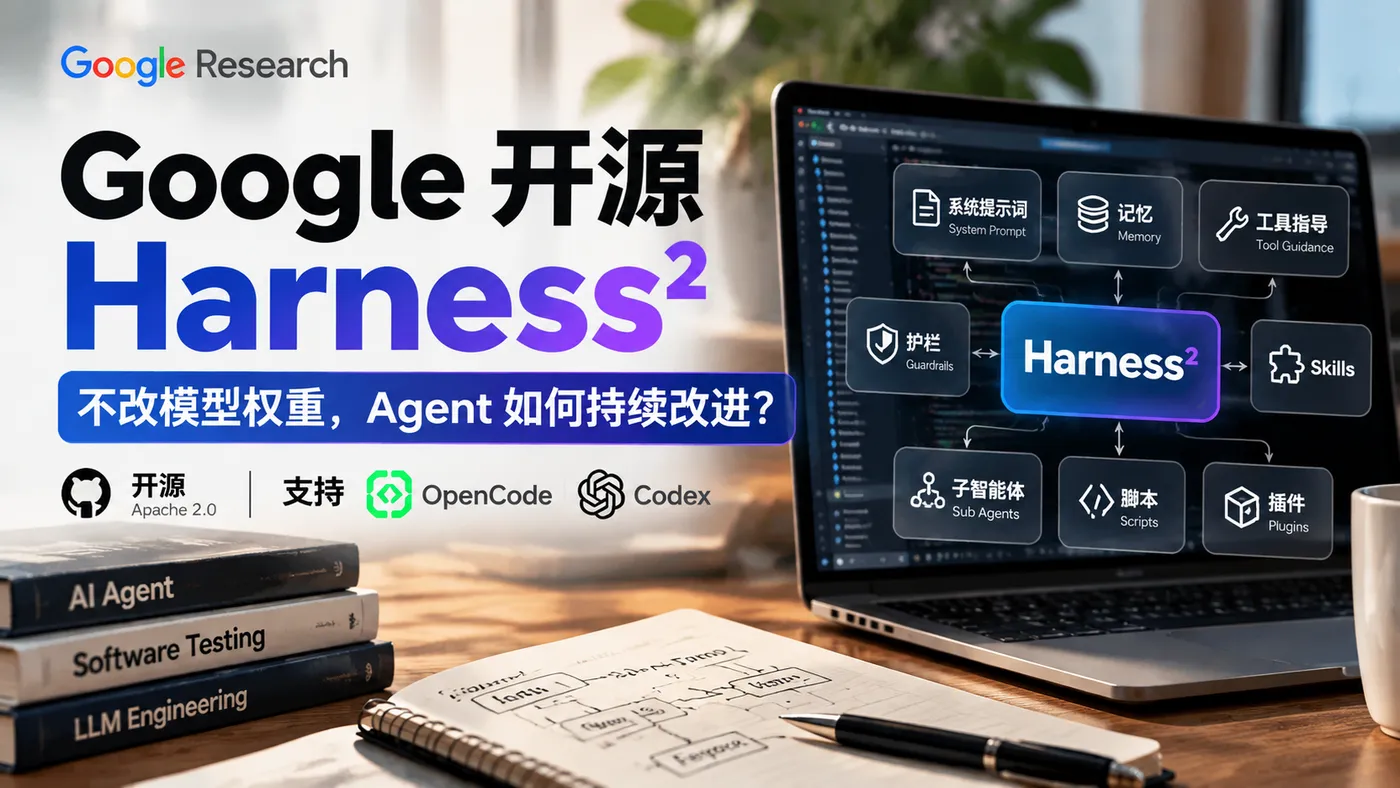
Google Research 开源的 Harness²,尝试把这项工作也交给 Agent。
它不修改模型权重,而是通过调整提示词、记忆、工具指导、Skills、子智能体等组件,让 Agent 根据执行过程中的反馈,尝试改进自己的工作方式。
项目采用 Apache 2.0 协议,支持 OpenCode 和 Codex,默认使用 OpenCode。需要说明的是,Harness² 是研究项目,并非谷歌官方支持的商业产品。
一、Agent 执行效果不好,问题可能出在模型之外
一个 AI Agent 能不能把任务做好,不只取决于模型本身。
模型负责理解和推理,Harness 则负责组织模型如何工作,包括如何构建上下文、调用工具、使用记忆,以及如何拆分和执行任务。
例如,让 Agent 分析一个代码仓库。
一种做法是直接读取大量文件,再根据上下文尝试解决问题。另一种做法是先分析目录结构,定位关键文件,再按需调用工具。
两种方式可能使用同一个模型,但执行效率、上下文利用率和任务完成情况可能存在差异。
这些围绕模型运行的组件,就是 Harness 工程需要处理的内容。
Harness² 将可调整的组件分为八类,包括系统提示词、护栏、记忆、工具指导、子智能体、Skills、脚本和插件。
过去,这些组件主要依靠工程师手动调整。Harness² 则尝试让 Agent 自己提出修改方案,通过实际执行观察不同方案的效果,再决定如何组合改进。
二、Harness² 如何让 Agent 改进自己的执行方式?
Harness² 的核心机制叫作 Propose–Probe–Compose,可以理解为“提出、探测、组合”。
假设 Agent 在处理一个复杂任务时表现不佳,系统会尝试提出多种 Harness 修改方案,让不同候选方案执行同一个任务,再比较它们产生的行为差异。
随后,系统根据执行证据组合出新的 Harness。
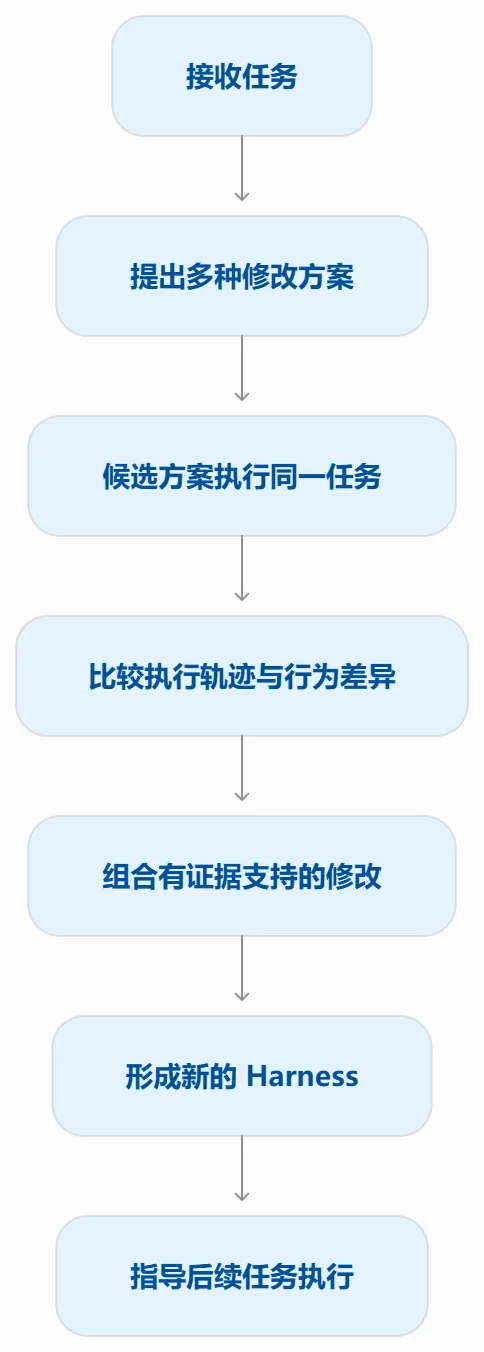
这套机制包含两个层次。
任务级递归:针对当前任务反复尝试不同的执行方式,寻找更合适的 Harness。
Harness 级递归:把已经采用的方案及有执行证据支持的经验保留下来,为后续任务的优化提供参考。
传统优化方法经常需要标准答案或明确的奖励信号。但在开放任务中,可能根本不存在唯一正确答案。
Harness² 尝试通过不同候选方案执行同一任务时产生的行为差异,寻找改进方向。
不过,行为发生变化,并不意味着任务一定完成得更好。系统仍然需要合理的评估方法,判断修改是否真正带来了收益。
这里也要区分一个概念:Harness² 改进的是模型周围的执行系统,并不是直接更新大模型的神经网络权重。
三、实验数据:部分基准成绩提升,代价是什么?
官方报告显示,仅进行一步 Harness² 优化,部分实验取得了以下最高增益:
| 评测基准 | 报告的最高提升 |
|---|---|
| WorkBuddy-Bench | 11.5 分 |
| JobBench | 4.5 分 |
| LAB 部分通过率 | 提高 11.8 个百分点 |
这些数据来自特定实验配置,不能直接理解为所有 Agent 的成功率都会提高相同比例。
Harness² 还提供两种递归方式:
- 并行递归:同时探索多种候选方案,扩大搜索范围。
- 顺序递归:将上一轮的改进和执行证据带入下一轮,逐步优化。
增加递归预算后,部分任务的表现还能继续提升。但每轮探索都可能产生额外的模型调用和任务执行成本。
如果成功率提高了几个百分点,Token 消耗却增长数倍,是否值得采用,就需要结合具体业务判断。
四、Agent 能自动修改自己,为什么还不能直接用于生产?
Harness² 展示了一种可行的研究方向,但要进入生产环境,还需要解决三个实际问题。
1. 评测分数提高,不代表整体能力都变好了
某个修改可能提高任务得分,却让 Agent 调用了更多工具、消耗更多 Token,或者破坏了原本稳定的执行流程。
因此,Harness 评估不能只看最终答案,还应该记录执行轨迹、任务成功率、延迟、成本和历史任务的回归情况。
对于测试开发团队,可以维护一组历史失败案例,每次修改 Harness 后重新运行,检查之前解决的问题是否再次出现。
2. 自动修改执行逻辑,需要安全边界
如果 Agent 只能调整提示词,风险相对容易控制。如果它还能修改脚本、工具和运行时逻辑,就可能产生非预期操作。
Harness² 官方仓库明确提醒:当前执行器默认允许网络访问,Codex 执行器会关闭沙箱。公开基准的评分规则可能通过互联网获取,因此正式评测需要额外配置网络限制。
这意味着,自动优化系统需要权限隔离、执行审计、回归验证和回滚机制。不能因为一次实验得分提高,就允许新配置直接进入生产环境。
3. 自我优化不能没有成本上限
候选方案越多,执行和比较的成本通常也越高。
工程团队需要为优化过程设置预算,并记录每次修改带来的收益。如果改进幅度不足以抵消新增成本,就应该拒绝这次修改。
Agent 能够修改自己,不代表它每次修改都值得保留。
五、Harness² 对 AI Agent 开发有什么启发?
Harness² 的思路可以应用到更广泛的 Agent 工程中。
以浏览器自动化测试为例,Agent 执行失败后,系统可以收集页面状态、工具调用记录、接口响应和异常日志,分析问题究竟来自元素定位、上下文不足、工具调用,还是测试断言设计不合理。
接下来,再针对具体问题提出修改,并使用历史任务验证修改效果。
实际落地可以从六件事开始:
- 收集 Agent 的执行轨迹和失败记录。
- 分析重复出现的失败模式。
- 提出提示词、Skills 或工具指导的修改方案。
- 使用固定回归任务验证修改效果。
- 对比成功率、执行成本和历史任务表现。
- 审核通过后再发布,出现回归时支持回滚。
这比直接让 Agent 自由修改整个测试平台更容易控制风险。
对于软件测试工程师来说,这也是一个值得研究的方向:测试不仅可以验证业务系统,还可以用于评估 Agent 的行为,判断它的每次改进是否有效。
六、Harness 工程会成为 Agent 开发的常规环节吗?
模型能力不断提升,Agent 周围的执行机制也在持续演进。
过去,工程师主要负责设计提示词、接入工具和编排工作流。未来,部分 Harness 调整工作可能由 Agent 辅助完成,工程师则需要设计评测标准、管理安全边界,并判断优化是否值得投入。
Harness² 目前展示的是这条路线在特定基准上的潜力,还不能据此认定所有 Agent 都能通过自我修改持续变强。
对于正在开发 AI Agent 的团队,可以先从记录执行轨迹、维护历史失败案例、建立回归评测和成本统计开始。没有这些基础,自动优化很容易变成反复修改,却无法证明结果是否更好。
如果你正在开发 AI Agent,你会允许它自动修改自己的提示词、Skills 和工具逻辑吗?你会设置哪些评测和回滚机制,确保它改完之后没有退步?
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。

