上一篇介绍了 Agent 常见的任务编排模式,包括提示链、路由、并行、反思、规划和多智能体协作。本篇从最容易落地的 Prompt Chaining(提示链) 开始,讨论如何将复杂任务拆分为多个独立、可验证的处理步骤。
在实际开发中,我们经常希望大模型一次完成多项工作。例如,读取一份技术故障报告,提取关键事实、分析事故影响、识别潜在风险,最后生成整改建议。最直接的实现方式,是向模型发送一个包含所有要求的 Prompt。但当原始文档较长、分析维度较多、输出结构复杂时,一次调用往往容易出现事实遗漏、分析与原文不一致、输出字段缺失等问题,而且很难定位错误究竟发生在哪个环节。
提示链提供了另一种实现方式:将复杂任务拆成多个具有明确输入输出的步骤,前一步的结果经过必要校验后,再交给下一步处理。它并没有改变大模型的能力,而是通过调整任务执行结构,提高结果的可控性和可维护性。
一、Prompt Chaining 的基本原理
Prompt Chaining 是一种顺序编排模式,也被称为流水线模式(pipline pattern)。每个步骤只处理任务中的一部分,并将结果作为后续步骤的输入,这种信息传递建立了一种依赖链,这也正是提示链模式名称的由来。例如,一份技术故障报告可以按照以下方式处理:
| 阶段 | 主要任务 | 输出结果 |
|---|---|---|
| 文档解析 | 获取正文、章节和来源信息 | Document |
| 事实提取 | 提取故障时间、影响范围、处置过程 | FactSet |
| 原因分析 | 根据事实识别问题和风险 | AnalysisResult |
| 建议生成 | 根据分析结果生成整改措施 | ActionPlan |
| 结果校验 | 检查结构、来源和业务规则 | ValidationResult |
文档解析、字段校验等环节可以使用确定性代码,而事实提取、原因分析和建议生成则更适合调用模型。因此,一条提示链不要求所有节点都是 LLM。它可以由 LLM 调用、普通函数、数据校验和业务规则共同构成。这种模式与自由 Agent Loop 的区别在于:
| Prompt Chaining | Agent Loop |
|---|---|
| 处理步骤通常预先确定 | 执行路径可以动态调整 |
| 每个步骤有明确的输入输出 | 模型可以动态选择工具和行动 |
| 适合流程清晰、结果可验证的任务 | 适合开放式探索和不确定任务 |
| 容易定位具体步骤的错误 | 更依赖执行轨迹分析 |
LangGraph 当前也将 Prompt Chaining 定义为一系列顺序 LLM 调用,适用于能够拆成较小、可验证步骤的任务,并支持在步骤之间加入 Gate 检查。
二、任务拆分的依据
并不是把一个 Prompt 随意拆成三段,就能提高结果质量。合理的拆分应该依据任务职责、数据依赖和校验方式。以前面的故障报告为例,如果直接要求模型同时完成“提取事实、判断原因、评估风险和生成建议”,模型可能在生成建议时引入原文并未明确支持的结论。更合理的设计是区分三个阶段。
第一阶段:提取事实。 只要求模型从文档中提取客观信息,例如故障开始时间、影响系统、异常现象和已执行的处置操作,并保留对应的原文引用。此时不允许模型自行推测故障原因。
第二阶段:分析事实。 根据第一阶段已经确认的信息识别风险和可能原因,对缺少证据的结论明确标记为待确认,而不是补充假设性事实。
第三阶段:生成结果。 基于确认后的事实和分析结论生成整改建议、处理优先级和待确认事项。
这三个阶段分别回答:发生了什么、意味着什么、下一步应该怎样处理。
拆分以后,每个步骤的职责更加明确,也更容易针对不同问题优化 Prompt 或更换模型。不过,任务并不是拆得越细越好。每增加一个 LLM 节点,都会增加请求延迟、Token 消耗以及数据传递和异常处理成本。因此,拆分应以是否存在独立职责、明确的数据契约和可验证的中间结果为主要依据,而不是以步骤数量衡量。
三、在步骤之间增加校验关口
提示链真正有工程价值的地方,不只是分阶段调用模型,而是可以在中间结果不满足要求时阻止后续执行。例如:
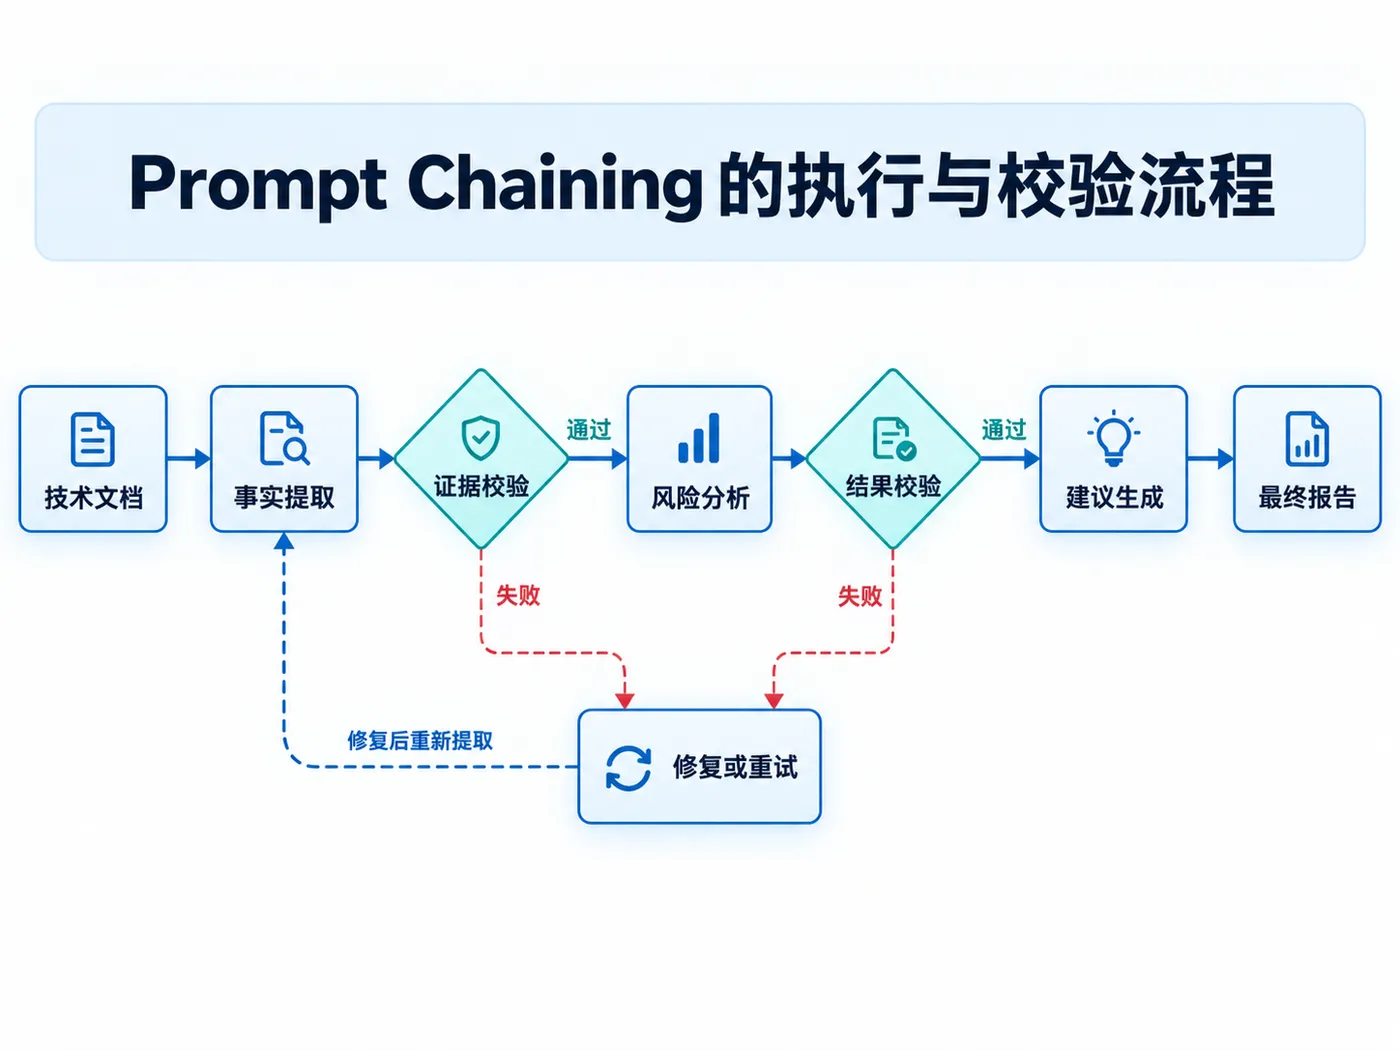
实际实现时,修复或重试应返回具体失败节点,而不是一律重新提取全部事实。这些 Gate 可以分为三个层次:
| 校验层次 | 主要检查内容 | 实现方式 |
|---|---|---|
| Schema Validation | 字段、类型、枚举是否符合约定 | JSON Schema / DTO |
| Business Validation | 日期、状态、业务约束是否正确 | 确定性程序 |
| Semantic Validation | 结论是否具有充分证据 | 规则检查 + 必要的模型审查 |
其中,Schema 校验只能保证数据结构符合契约,并不能证明模型提取的事实正确。例如,模型返回的故障时间符合日期格式,但该时间根本没有出现在原始报告中,仍然属于事实错误。
因此,对于事实提取任务,建议保留原文片段及其来源标识,并由程序验证引用是否能够对应到真实文档。结构校验保证结果可以被程序处理,证据和业务校验进一步判断结果是否值得信任。
四、代码示例:生成故障整改报告
这里不引入完整 Agent Framework,而是使用 Java 21 展示提示链的核心逻辑。为简化代码,假设已经封装好统一的模型适配接口,能够根据 Java 类型生成结构化结果。首先定义三个阶段的数据结构:
record Fact(
    String id,
    String quote
) {
   }

record FactSet(
    List<Fact> facts
) {
   }

record Finding(
    String description,
    String factId
) {
   }

record AnalysisResult(
    List<Finding> findings
) {
   }

record Report(
    String summary,
    List<String> actions
) {
   }
其中,Fact 保存从文档中提取的事实,Finding 保存基于事实得到的分析结论。factId 用于将分析结果关联到对应证据。为了避免绑定具体模型 SDK,定义一个简单接口:
interface ModelGateway {

    <T> T generate(
        String instruction,
        Object input,
        Class<T> resultType
    );
}
接下来完成三个模型处理步骤:
Report buildReport(
        String source,
        ModelGateway model) {


    // Step 1:事实提取
    FactSet facts = model.generate(
        "只提取原文明确存在的事实,保留原文片段",
        source,
        FactSet.class
    );

    // Gate 1:检查事实来源
    if (facts.facts().isEmpty() ||
        facts.facts().stream().anyMatch(
            f -> !source.contains(f.quote())
        )) {

        throw new IllegalStateException(
            "事实证据校验失败"
        );
    }

    // Step 2:原因与风险分析
    AnalysisResult analysis = model.generate(
        "仅依据已有事实进行分析,不得新增事实",
        facts,
        AnalysisResult.class
    );

    // Gate 2:检查分析结果的证据引用
    Set<String> ids = facts.facts().stream()
        .map(Fact::id)
        .collect(Collectors.toSet());

    if (analysis.findings().stream().anyMatch(
        f -> !ids.contains(f.factId())
    )) {

        throw new IllegalStateException(
            "分析结果存在无效证据引用"
        );
    }

    // Step 3:生成整改报告
    return model.generate(
        "根据已确认事实和分析结论生成整改报告",
        Map.of("facts", facts, "analysis", analysis),
        Report.class
    );
}
这是一段用于说明编排逻辑的简化代码,并非完整的生产实现。其中使用原文包含关系进行证据检查,只适合演示;正式项目应根据文档解析结果保存 documentId、sectionId、文本位置等信息,并继续校验最终报告中的结论和整改措施。
这段代码最重要的是三个模型调用之间的关系:FactSet → AnalysisResult → Report。每个阶段都有清晰的数据类型,前两个阶段设置了必要的校验关口,上一阶段没有通过检查时,不会继续生成下一阶段的结果。相比把所有要求拼接在一个 Prompt 中,这种实现更容易定位故障、编写测试并维护业务规则。
五、上下文隔离与中间结果管理
提示链的一个常见实现问题,是将此前所有步骤的 Prompt、模型回答和原始文档不断累积到下一阶段。例如,第一步提取了 50 条事实,第二步分析时又加入大量历史消息,第三步生成报告时继续附带前面所有内容。随着流程增加,上下文可能不断膨胀,最终削弱拆分步骤带来的收益。更合理的方式是每个步骤只接收完成当前工作所需的数据。在故障报告案例中:
| 阶段 | 主要输入 | 不必重复传入 |
|---|---|---|
| 事实提取 | 原始文档、字段定义 | 历史分析过程 |
| 风险分析 | 已确认事实、相关业务规则 | 无关文档章节、提取过程日志 |
| 建议生成 | 分析结论、关键证据、整改约束 | 前面完整的模型对话 |
这与此前介绍的 Context Engineering 并不冲突,而是将上下文管理落实到多个独立模型调用中。此外,中间结果应该以结构化对象保存,而不是只能存在于模型对话历史里。对于执行时间较长、成本较高的任务,还可以持久化每个阶段的结果,以支持断点恢复、结果回放和独立重试。
需要注意:摘要不能天然替代原始证据。 如果后续步骤需要核对精确事实,应同时保留必要的原文引用,避免在多次模型转述过程中逐渐偏离原始资料。
六、失败处理与局部重试
提示链引入多个执行步骤以后,失败处理也应该从“整个任务重新执行”转为“识别失败位置并针对性恢复”。例如事实提取阶段出现格式错误,可以修正输出格式或有限次数重新提取;风险分析阶段产生无效证据引用,可以重新执行分析,而不必重新解析整份文档。不同错误适合不同处理方式:
| 错误类型 | 推荐处理 |
|---|---|
| 网络超时、限流 | 有界重试与退避 |
| JSON 格式错误 | 校验后针对性重试 |
| Schema 不匹配 | 修正结构或重新生成 |
| 引用不存在 | 返回原步骤重新分析 |
| 原始资料缺失 | 请求补充资料 |
| 业务规则冲突 | 拒绝继续或转人工 |
| 多次生成仍不合格 | 终止并保留失败状态 |
这里最重要的是区分可重试错误和信息本身不充分。如果原始报告没有明确故障发生时间,无论重复调用多少次模型,也不应该要求它生成一个确定时间。系统应明确保留缺失项,必要时请求补充。另外,对于涉及数据库写入、审批提交等有副作用的步骤,重试必须考虑幂等性,不能因为上一次调用超时就直接重复执行。
因此,工程实现中除了 Prompt 和数据契约,还应该明确每个阶段的超时、最大重试次数、失败状态和恢复策略。
七、2026 年主流框架与模型接口的实现方式
随着模型接口和 Agent Framework 的发展,Prompt Chaining 已经不再依赖纯字符串拼接。
结构化输出成为中间数据契约
OpenAI Responses API 支持通过 text.format 配置 JSON Schema,并使用 strict 模式约束输出结构;SDK 还支持将结果直接映射为类型化对象。
DeepSeek 当前 Responses API 同样提供 json_schema 输出选项,而 Chat Completions 中的 JSON Output 则仍采用 json_object。不同接口和模型对 Schema 的支持范围需要分别确认,不能简单假设行为完全一致。
这使得提示链可以采用:Java DTO / JSON Schema → Model Output → Runtime Validation的方式构建中间结果,而不必依赖 Prompt 中反复强调“严格按照以下格式输出”。不过,原生结构化输出仍然不等于业务内容正确,因此程序校验和证据检查依然不可省略。
Workflow 框架负责执行编排
LangGraph 当前提供 Graph API 和 Functional API 两种组织方式。对于包含明确节点、分支和状态依赖的提示链,可以采用 State Graph;对于步骤较少、逻辑相对简单的任务,也可以通过普通函数或 Functional API 编排。对于 Java 企业应用,使用 Spring AI、LangChain4j 或已有 Workflow Engine 同样可以实现类似逻辑。具体框架并不是 Prompt Chaining 成立的前提。
评估从最终结果扩展到中间结果
随着可观测和 Evaluation 能力的完善,现在还可以分别评价事实提取、分析和报告生成等步骤,而不是只在最后检查一份报告。例如,事实提取阶段关注召回率和原文匹配率,风险分析阶段关注证据支持程度,最终报告阶段关注完整性和可执行性。这种分阶段评估方式能够帮助开发者更准确地定位问题,而不是在最终结果不理想时反复修改整条 Prompt。
八、性能、成本与模式选型
Prompt Chaining 提高了任务执行过程的可解释性,但也引入了额外的模型请求。假设一个任务拆成三个顺序执行的 LLM 阶段,总耗时通常接近各阶段耗时之和,再加上数据校验和其他处理开销。因此,它并不天然比单次模型调用更快。设计时应该同时评估:
| 维度 | 关注重点 |
|---|---|
| 结果质量 | 是否减少遗漏、错误和无依据结论 |
| 响应时间 | 串行调用增加了多少延迟 |
| Token 成本 | 多阶段 Prompt 是否增加消耗 |
| 可维护性 | 是否可以独立调整某个阶段 |
| 失败恢复 | 是否能够局部重试 |
| 可观测性 | 是否可以定位到具体失败步骤 |
其中一个常见优化方式,是针对不同步骤选择不同模型。例如,简单分类或字段提取使用成本较低的模型,复杂分析阶段使用推理能力更强的模型。但这种模型分工应通过评估数据验证,不能假设小模型一定能可靠完成所有提取任务。对于能够一次调用完成、输出结构简单的任务,没有必要强行引入提示链;对于存在多个相互独立子任务的情况,后续介绍的 Parallelization 往往更加合适。
因此:Prompt Chaining 更适合步骤明确、存在顺序依赖、能够检查中间结果的任务,而不是所有复杂任务的默认实现。
九、小结
Prompt Chaining 是 Agent 设计模式中最基础的一种任务编排方式,它通过把复杂任务拆成多个独立步骤,使每次模型调用承担更加明确的职责。但它的工程价值并不只是将一个 Prompt 拆成多个 Prompt,而在于建立一套完整的多阶段处理机制:明确职责、类型化输出、中间结果校验、上下文隔离、局部重试与过程评估。
与自由 Agent Loop 相比,提示链的执行路径通常是预先确定的,因此更容易控制、测试和维护;但这也意味着它不适合执行路径高度不确定的开放式任务。在生产系统中,提示链完全可以与 RAG、Tool Calling、Structured Output 和 Workflow 结合,而不必为了使用它专门创建一个复杂 Agent。最终可以概括为:提示链的重点不是增加模型调用次数,而是将复杂任务组织成多个可验证、可维护的处理阶段。
上一篇回顾:
https://developer.aliyun.com/article/1770497?spm=a2c6h.13148508.setting.16.354f4f0eLaGZAk
下一篇将继续介绍 Routing(路由模式)——根据任务类型选择不同处理路径。
Prompt Chaining 解决的是多个步骤如何顺序执行,而 Routing 将进一步解决:面对不同类型的用户请求,系统应该选择哪一条处理流程、哪一个模型或者哪一种 Agent 能力。