前面的文章,我们已经分别介绍了 Context Engineering、Function Calling、Structured Output 和 RAG。这些能力单独看并不复杂,但真正进入 Agent 开发后,还需要回答一个问题:
谁来决定什么时候调用模型、什么时候执行工具、拿到工具结果以后是否继续,以及什么时候结束任务?
答案就是 Agent Loop。
从这一篇开始,我们正式进入“第一个 Agent 应用”。先不使用 LangChain、LangGraph、Spring AI 或其他 Agent Framework,而是用最基础的模型 API,手写一个能够“思考—调用工具—观察结果—继续执行”的最小 Agent。因为只有自己实现一次,才真正知道框架帮我们做了什么。
一、普通大模型调用和 Agent 到底差在哪里
最普通的大模型应用通常只有一次请求:
用户
 ↓
Prompt
 ↓
LLM
 ↓
Answer

例如:用户:北京今天适合户外活动吗?模型生成一段回答,请求结束。但如果模型不知道实时天气,就需要调用天气服务:
用户
 ↓
LLM
 ↓
get_weather("北京")
 ↓
天气 API
 ↓
结果返回 LLM
 ↓
LLM 再次判断
 ↓
最终回答

如果任务更复杂,还可能继续调用第二个、第三个工具。因此 Agent 真正增加的是一个循环:
while 任务未完成:
    调用模型
    判断是否需要工具
    执行工具
    把结果放回上下文

这个 while,就是最小 Agent 的骨架。
二、最小 Agent 其实只需要五个组件
先把各种框架、Memory、RAG、多 Agent 全部放到一边,一个能够运行的最小 Agent 只需要:
| 组件 | 作用 |
| LLM Client | 调用大模型 |
| Messages | 保存当前上下文 |
| Tool Registry | 注册 Agent 可以使用的工具 |
| Tool Executor | 执行模型选择的工具 |
| Agent Loop | 控制模型与工具循环执行 |
整个结构可以压缩成:
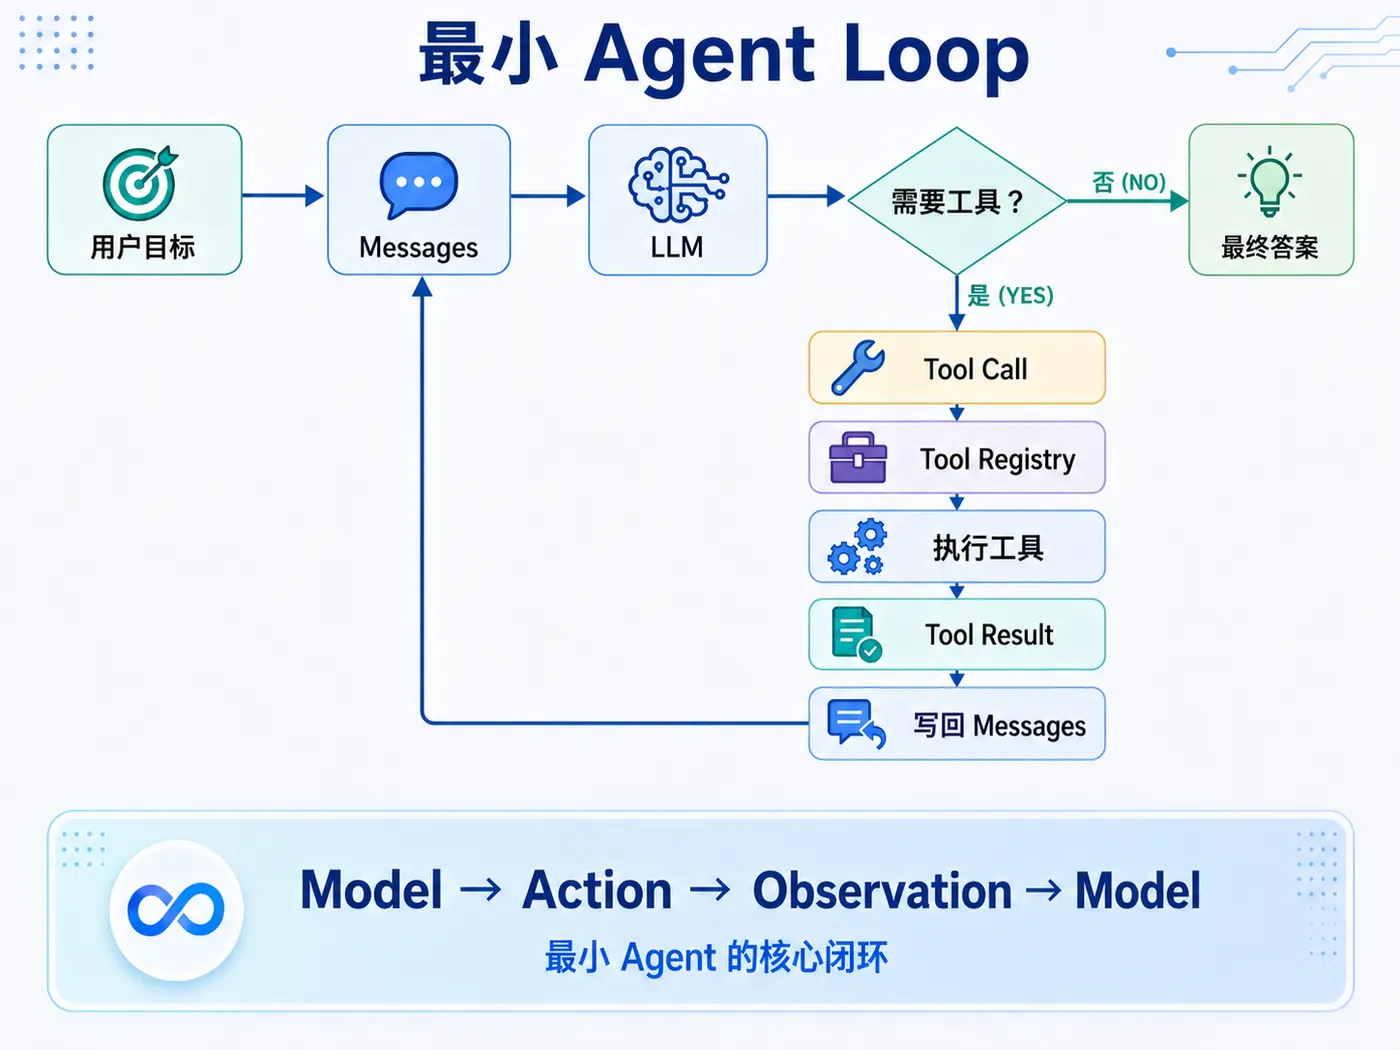
 编辑
也就是前面介绍 ReAct 时看到的工作循环,现在第一次真正落实到代码中。
三、先定义 Tool:Agent 能做什么必须由程序决定
假设我们的最小 Agent 只有两个工具:
get_weather
查询城市天气
calculator
执行数学计算

不要让模型自己“发明”工具。程序需要显式注册:
public interface Tool {
    String name();
    String description();
    JsonNode parameters();
    String execute(JsonNode arguments) throws Exception;
}

例如天气工具:
public class WeatherTool implements Tool {
    @Override
    public String name() {
        return "get_weather";
    }
    @Override
    public String description() {
        return "查询指定城市的实时天气";
    }
    @Override
    public JsonNode parameters() {
        return Json.parse("""
        {
          "type": "object",
          "properties": {
            "city": {
              "type": "string"
            }
          },
          "required": ["city"]
        }
        """);
    }
    @Override
    public String execute(JsonNode args) {
        String city = args.get("city").asText();
        // 实际项目中调用天气 API
        return """
        {
          "city": "%s",
          "weather": "小雨",
          "temperature": 26
        }
        """.formatted(city);
    }
}

这里其实已经用到了前面介绍的 Function Calling:
名称告诉模型调用哪个能力,Description 帮助模型判断什么时候使用,JSON Schema 约束参数结构,真正的执行逻辑仍然由程序负责。
四、Tool Registry:不要写一大堆 if / else
工具越来越多以后,如果这样处理:
if ("get_weather".equals(name)) {
    ...
} else if ("calculator".equals(name)) {
    ...
}

很快就会失控。最简单的方法是建立 Registry:
Map<String, Tool> tools = new HashMap<>();
tools.put("get_weather", new WeatherTool());
tools.put("calculator", new CalculatorTool());

模型返回:
{
  "name": "get_weather",
  "arguments": {
    "city": "上海"
  }
}

Agent Runtime 根据名称找到:
Tool tool = tools.get(toolCall.name());

然后执行:
String result =
        tool.execute(toolCall.arguments());

所以:
模型负责选择 Tool,程序负责确认 Tool 是否存在并真正执行。
这个责任边界非常重要。
五、真正的核心:手写 Agent Loop
有了模型和工具以后,Agent Loop 本身其实非常短:
record ToolCall(
      String id,
      String name,
      Map<String, Object> arguments
) {  }
record ModelResponse(
      String content,
      List<ToolCall> toolCalls
) {  }

public String run(String userInput) {
    List<Message> messages = new ArrayList<>();
    messages.add(Message.system(
        "你是一个可以调用工具完成任务的智能助手。"
    ));
    messages.add(Message.user(userInput));
    int maxSteps = 10;
    for (int step = 1; step <= maxSteps; step++) {
        ModelResponse response =
                llm.chat(messages, toolSchemas());
        // 先保存模型本轮输出
        messages.add(response.message());
        // 没有工具调用,说明模型准备返回结果
        if (response.toolCalls().isEmpty()) {
            return response.content();
        }
        // 执行所有工具调用
        for (ToolCall call : response.toolCalls()) {
            Tool tool = tools.get(call.name());
            if (tool == null) {
                messages.add(
                    Message.tool(
                        call.id(),
                        "ERROR: tool not found"
                    )
                );
                continue;
            }
            try {
                String result =
                        tool.execute(call.arguments());
                messages.add(
                    Message.tool(
                        call.id(),
                        result
                    )
                );
            } catch (Exception e) {
                messages.add(
                    Message.tool(
                        call.id(),
                        "ERROR: " + e.getMessage()
                    )
                );
            }
        }
    }
    throw new IllegalStateException(
        "Agent exceeded max steps"
    );
}

暂时忽略各种 SDK 差异,这段代码已经是一个真正意义上的最小 Agent。它完成了:
调用模型
   ↓
读取 Tool Call
   ↓
找到工具
   ↓
执行工具
   ↓
获得 Observation
   ↓
写回上下文
   ↓
再次调用模型

直到模型不再请求工具,循环结束。
六、跑一次完整任务,会发生什么
例如用户输入:
查询上海现在的天气,并计算 3 个人出差两天、每天每人交通费 120 元,总交通预算是多少?最后给我一个简短的出行建议。
第一次调用模型:
LLM
 ↓
get_weather(city="上海")

Agent 执行天气工具:
{
  "city": "上海",
  "weather": "小雨",
  "temperature": 26
}

然后把 Tool Result 放回 Messages。
第二次调用模型时,它已经知道天气,但还需要计算:
LLM
 ↓
calculator("3 * 2 * 120")

工具返回:
720

再次写回上下文。
第三次调用模型:
LLM
 ↓
已经拥有:
用户目标
+ 天气结果
+ 计算结果
 ↓
最终回答

最终可能得到:
上海目前有小雨,建议携带雨具。3 人出差 2 天,按每天每人 120 元计算,交通预算共 720 元。
整个执行过程可以画成:
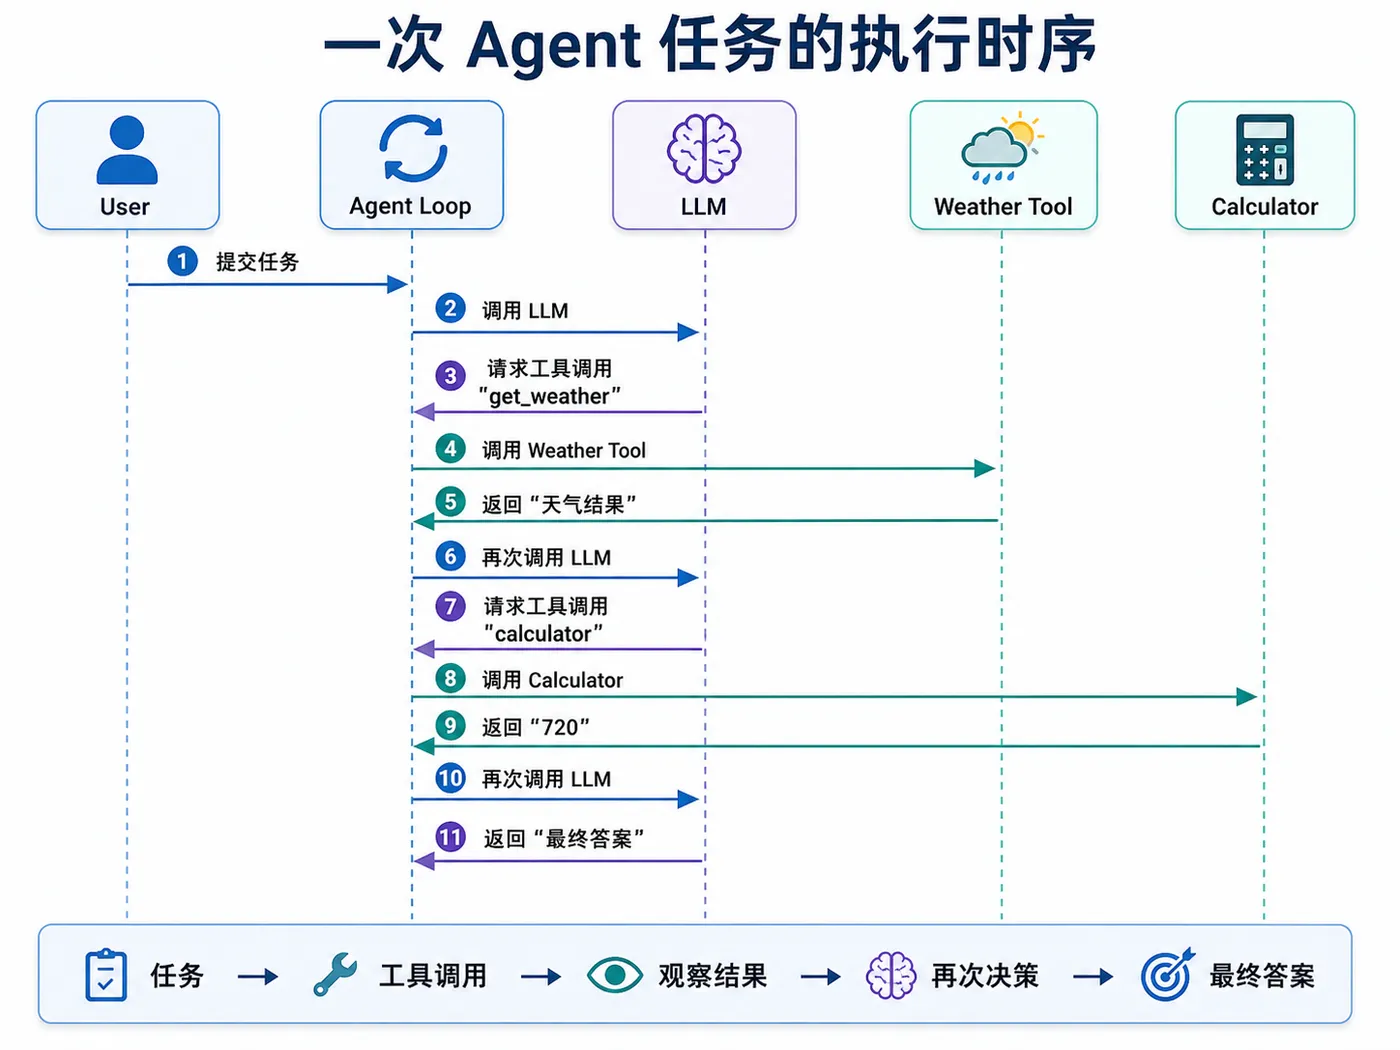
 编辑
这里没有预先写死:
先查天气
再算费用
最后回答

真正决定下一步的是模型。这也是 Agent 与固定 Workflow 最核心的区别之一。
七、为什么 Tool Result 一定要重新交给模型
这是第一次写 Agent 时很容易犯的错误。有人会认为:
模型调用天气工具
 ↓
天气工具返回结果
 ↓
直接把天气结果返回用户

这样做实际上切断了 Agent Loop。Tool 的结果不是最终答案,而是:
模型下一轮决策需要观察到的新信息。
因此:
Tool Result
     ↓
加入 Messages
     ↓
再次调用 Model

这就是 ReAct 中的:Observation。模型看到 Observation 后,才能判断:
任务完成了吗?
还缺什么信息?
需要再调用其他工具吗?
是否可以生成最终结果?

所以 Agent Loop 不是简单的“模型调用工具”,而是:
Model → Action → Observation → Model
形成闭环。
八、什么时候结束循环?
最简单的终止条件是:
模型没有再返回 Tool Call

也就是:
if (response.toolCalls().isEmpty()) {
    return response.content();
}

但生产系统不能只相信模型自己会停下来。至少还需要:
最大 Step
工具调用次数
任务超时
Token Budget
用户取消
异常终止

例如:
int maxSteps = 10;

这样即使模型出现:
调用 A
 ↓
调用 B
 ↓
又调用 A
 ↓
又调用 B

也不会无限执行。因此:
Agent Loop 必须拥有程序层面的终止条件,而不能把“什么时候结束”完全交给模型。
九、工具失败时,不一定应该立即结束 Agent
假设天气 API 超时。一种实现是:
Tool Error
 ↓
整个任务失败

但 Agent 更有价值的地方是,可以把错误本身作为 Observation:
{
  "error": "weather service timeout"
}

再交给模型。模型可能决定:
重试
换一个工具
跳过这个步骤
告诉用户当前无法获取天气

所以更加合理的是:
try {
    result = tool.execute(...);
} catch (Exception e) {
    result = "ERROR: " + e.getMessage();
}
messages.add(toolResult);

当然,这不代表可以无限重试。仍然需要:Retry Limit + Timeout + Max Steps 来兜底。
十、日志真正应该记录什么
普通 API 日志通常只记录:
Request
Response
Latency

Agent 不够。因为一次用户请求可能经历很多 Step。至少应该记录:
Run
 ├─ Step 1
 │   ├─ Model Request
 │   ├─ Tool Call
 │   └─ Tool Result
 │
 ├─ Step 2
 │   ├─ Model Request
 │   ├─ Tool Call
 │   └─ Tool Result
 │
 └─ Step 3
     └─ Final Answer

例如:
runId     = r-001
step      = 2
tool      = calculator
arguments = 3*2*120
result    = 720
latency   = 8ms

否则用户只说:
“这个 Agent 算错了。”
开发人员很难知道到底是:模型选错工具、参数生成错误、工具执行错误,还是模型理解 Tool Result 时出错。这也是为什么后面进入生产级 Agent 后,“Trace”会比普通日志更加重要。
十一、这个最小 Agent 已经包含了哪些前置知识
回头看前面的文章,会发现我们其实已经把一个 Agent 所需的基础零件全部准备好了。
Context Engineering
负责这一轮应该把什么信息交给模型。在当前代码里就是:
List<Message> messages;

Function Calling
负责模型怎样表达自己想调用哪个工具。对应:
Tool Call
name
arguments

Structured Output
负责模型怎样按照确定的数据结构与程序通信。Tool 参数本身就是一种 Structured Output。
RAG
如果再注册一个:
search_knowledge

工具:
Agent
 ↓
search_knowledge
 ↓
RAG
 ↓
相关知识
 ↓
Tool Result
 ↓
Agent

RAG 就自然进入了 Agent Loop。所以前面几篇并不是相互独立的技术点。进入这一篇以后,它们第一次真正连接起来。
十二、到这里,其实已经能看懂 Agent Framework 在做什么
把我们的代码继续完善,很快会出现更多需求:
工具越来越多
Messages 越来越长
任务需要恢复
工具需要权限
需要流式输出
需要并行 Tool Call
需要审批
需要 Retry
需要日志和 Trace
需要 Session
需要 Sandbox

于是最开始几十行的:
while(...)

会逐渐变成一个完整 Runtime。这就是 Agent Framework 和 Agent Harness 开始出现的原因。
十三、再看 DeepSeek Harness:复杂 Harness 的核心仍然是这个 Loop
最近 DeepSeek 开源了官方 DeepSeek Harness(dsh)。它目前仍处于 Developer Preview,官方明确提醒正在快速迭代,并可能出现破坏兼容性的变化;架构上采用 “Everything is a Plugin” 的方式,由 Cordis 驱动,Model Adapter、Tool Registry、Session Log,甚至 Agent Loop 本身都作为可替换组件存在。它的核心结构可以简化理解成:
Session Log
     ↓
System Prompt
+
Tool Schemas
+
History
     ↓
Agent Loop
     ↓
LLM Adapter
     ↓
Assistant Message
     ↓
Tool Call
     ↓
Tool Registry
     ↓
Tool Execute
     ↓
Tool Result
     ↓
Session Log
     ↓
下一 Step

DeepSeek Harness 官方架构文档对一次 Turn 的描述也非常接近这个过程:从 Session Log 取得输入并组装 Prompt 和 Tool Schema,调用模型,将 Tool Call 送入工具执行管线,再把模型可见的结果写回日志,并据此决定是否进入下一 Step。与我们前面几十行代码相比:
| 手写最小 Agent | DeepSeek Harness |
List<Message> |
Session Event Log |
Map<String, Tool> |
Scoped Tool Registry |
for / while |
Agent Loop |
llm.chat() |
LLM Adapter |
| Tool 执行 | Guarded Tool Pipeline |
try/catch |
Error / Recovery Extension Points |
| 直接拼 Prompt | System Prompt Assembly |
| 内存上下文 | 可持久化、可回放 Session |
也就是说,虽然代码复杂度完全不是一个量级,但最底层的逻辑并没有改变:
获取上下文 → 调用模型 → 执行 Action → 记录 Observation → 再次决策。
十四、DeepSeek Harness 最值得初学者关注的,不是插件有多少
如果现在直接研究 DeepSeek Harness 的全部代码,很容易被 Plugin、Cordis、Event、Session、Scope、Sandbox 等大量工程概念淹没。对于刚开始学习 Agent 的开发者,更值得关注的是它背后的几个设计变化。
第一,从 Messages List 变成 Session Log
我们的 Demo 直接维护:
List<Message>

复杂系统则需要解决:恢复、回放、分支、Trace、持久化和上下文重建。DeepSeek Harness 因此把 Session Log 作为模型上下文的事实来源,下一次模型请求从日志中重新推导 History。
第二,从 Tool Map 变成 Tool Registry
Demo 中:
Map<String, Tool>

就够了。但生产系统还需要:Tool Scope、权限、Schema、执行前检查、执行后处理和 Sandbox。于是简单工具表逐渐演变成工具执行管线。
第三,从 while 循环变成 Agent Runtime
我们的:
for (step = 0; step < maxSteps; step++)

最终需要处理:Turn、Step、取消、继续、错误恢复、输入插入、状态持久化以及多种执行扩展点。Agent Loop 于是逐渐从一段控制代码,演变成 Runtime 的核心。
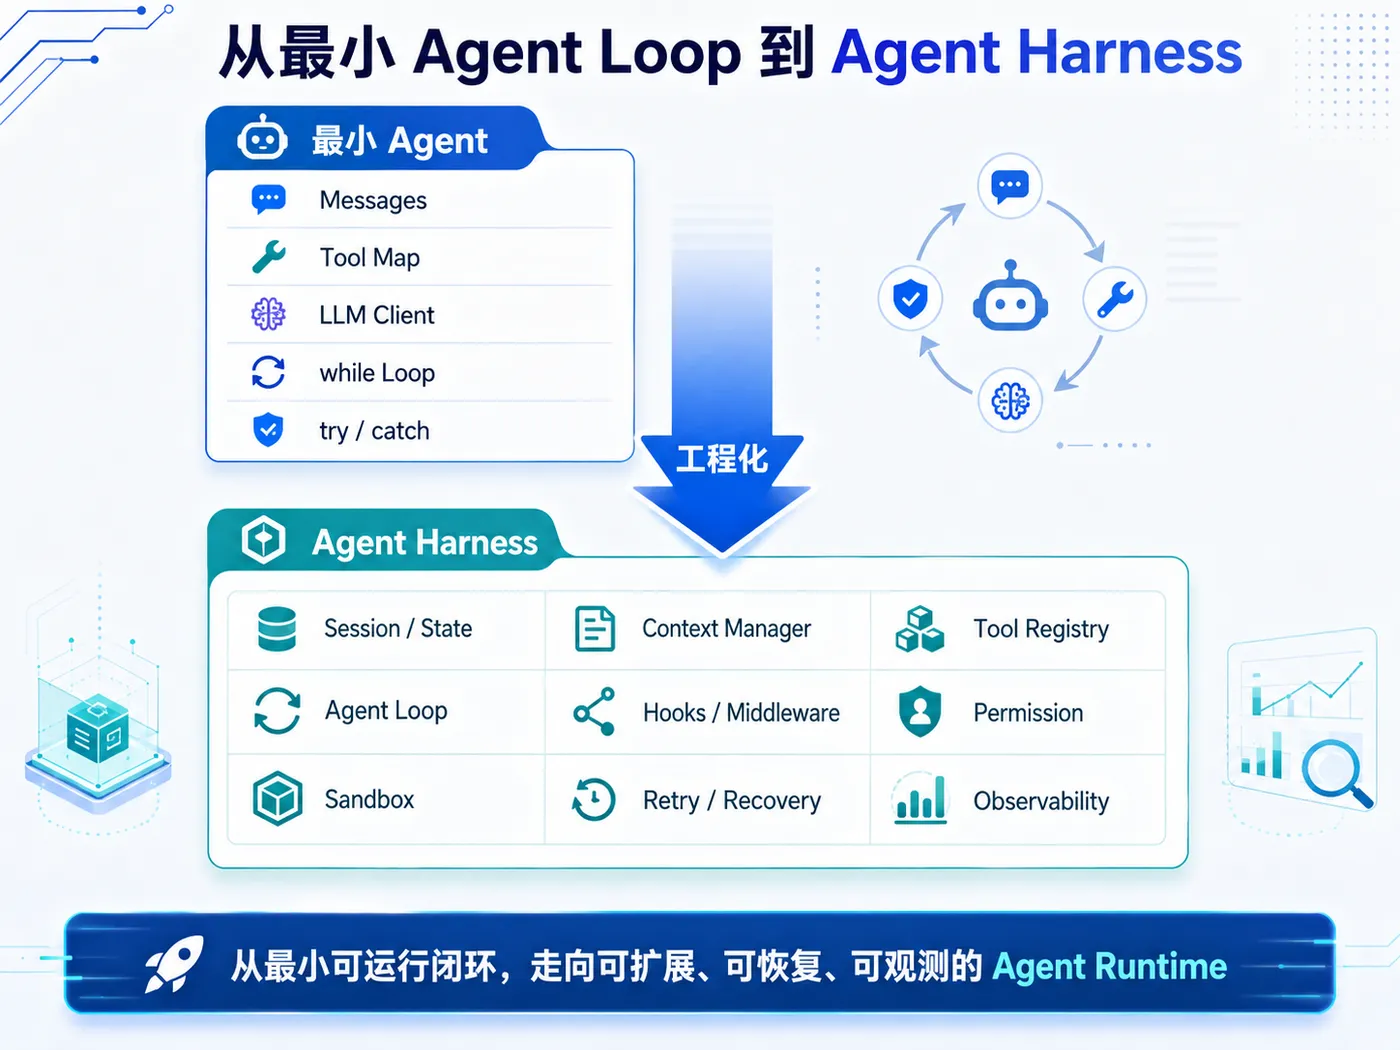
 编辑
这也解释了为什么本系列后面还会单独讨论 Agent Harness。
十五、最小 Agent 不应该解决哪些问题
这一篇的目标不是写一个“生产级 Agent”。因此暂时不应该把:
Memory
Multi-Agent
Graph Workflow
MCP
A2A
Sandbox
复杂 Planning
长期任务
Checkpoint

全部塞进来。否则读者最终看到的又会是另一个框架。最小 Agent 的真正价值,是把核心机制暴露出来:
messages
+
tools
+
model
+
loop

只要理解了这四部分,后面无论使用 Spring AI、LangChain4j、LangGraph,还是阅读 DeepSeek Harness,都可以继续追问:
这个框架把我的 Messages 放在哪里?
Tool Registry 在哪里?
谁负责执行 Agent Loop?
Tool Result 怎样进入下一轮模型上下文?
终止、错误和恢复由谁负责?
这比记住某个框架的 API 更重要。
十六、小结
前面的文章一直在拆解 Agent:
Context
Function Calling
Structured Output
RAG

这一篇第一次把它们重新组合起来。因此:
Agent 并不是某个框架提供的特殊对象,Agent 首先是一种运行机制。
模型提供理解和决策能力;Tool 提供外部能力;Context 保存当前状态;而 Agent Loop 把它们持续连接起来。
DeepSeek Harness 这样的工程化项目进一步说明,当这个简单 Loop 需要支持 Session、权限、Sandbox、恢复、扩展和可观测性时,它就会逐渐演变成完整的 Agent Harness。官方当前实现甚至把 Agent Loop 本身也设计成可替换插件,说明“Loop 是核心,但不应该成为不可扩展的硬编码核心”。
上一篇回顾:
https://developer.aliyun.com/article/1756061?spm=a2c6h.13148508.setting.15.31fa4f0eYl1atu
下一篇将真正进入使用主流框架开发 Agent:
到时候我们再来看 Spring AI、LangChain4j、LangGraph 等框架究竟帮助开发者封装了什么。