pdf版下载链:https://pan.quark.cn/s/9cc742e9c2a8
05 Transformer:架构、注意力机制与位置编码
难度: ⭐⭐⭐⭐
更新:2026-10-12
考点: Transformer、Self-Attention、BERT、GPT、位置编码
📋 目录
- Transformer基础
- 注意力机制
- BERT与GPT
- 优化技巧
- 速记卡片
一、Transformer基础
Q1: 什么是Transformer?为什么要引入Transformer?
💡 答案要点
Transformer = 以注意力、前馈网络、残差与归一化为核心的序列建模架构家族。原论文是 Encoder-Decoder 序列到序列模型,现代实现还包括 Encoder-only 和 Decoder-only。
为什么需要Transformer?
RNN/LSTM 的问题:
| 问题 | 说明 | 影响 |
|---|---|---|
| 串行计算 | 必须逐个处理token | 训练慢,无法并行 |
| 长程依赖 | 梯度消失/爆炸 | 难以捕捉远距离关系 |
| 信息瓶颈 | 所有信息压缩到隐状态 | 信息丢失 |
Transformer 的优势:
┌─────────────────────────────────────────────────────────┐
│                  Transformer 架构                        │
└─────────────────────────────────────────────────────────┘

输入序列 → Embedding + 位置编码
     ↓
Encoder (N × 6 层)
├── Multi-Head Self-Attention
├── Add & Norm
├── Feed-Forward Network
└── Add & Norm
     ↓
Decoder (N × 6 层)
├── Masked Multi-Head Self-Attention
├── Add & Norm
├── Encoder-Decoder Cross-Attention
├── Add & Norm
├── Feed-Forward Network
└── Add & Norm
     ↓
Linear + Softmax → 输出概率分布
核心创新:
- Self-Attention(自注意力)
- 每个token都能直接"看到"所有其他token
- 标准全注意力的分数计算量为 O(n²d),注意力矩阵为 O(n²);训练时可并行
- Multi-Head Attention(多头注意力)
- 多个注意力头,捕捉不同维度的关系
- 头数、头维度和 KV 头数是独立的架构权衡,不存在固定最优值
- 位置编码(Positional Encoding)
- 注入序列位置信息
- sin/cos 函数编码
- 残差连接 + Layer Norm
- 改善深层网络的梯度传播
- 稳定训练
性能对比(机器翻译任务):
| 模型 | BLEU | 训练时间 | 参数量 |
|---|---|---|---|
| LSTM | 25.3 | 10天 | 200M |
| Transformer Base | 27.3 | 12小时 | 65M |
| Transformer Big | 28.4 | 3.5天 | 213M |
面试话术:
"Transformer 通过自注意力替代 RNN 的时间步串行依赖,使训练阶段可以并行处理 token。代价是标准全注意力的计算量随序列长度平方增长;自回归推理还要考虑 KV Cache 容量和内存带宽,因此长上下文通常要结合 GQA/MQA、FlashAttention、稀疏或混合架构优化。"
Q2: Transformer的Encoder和Decoder有什么区别?
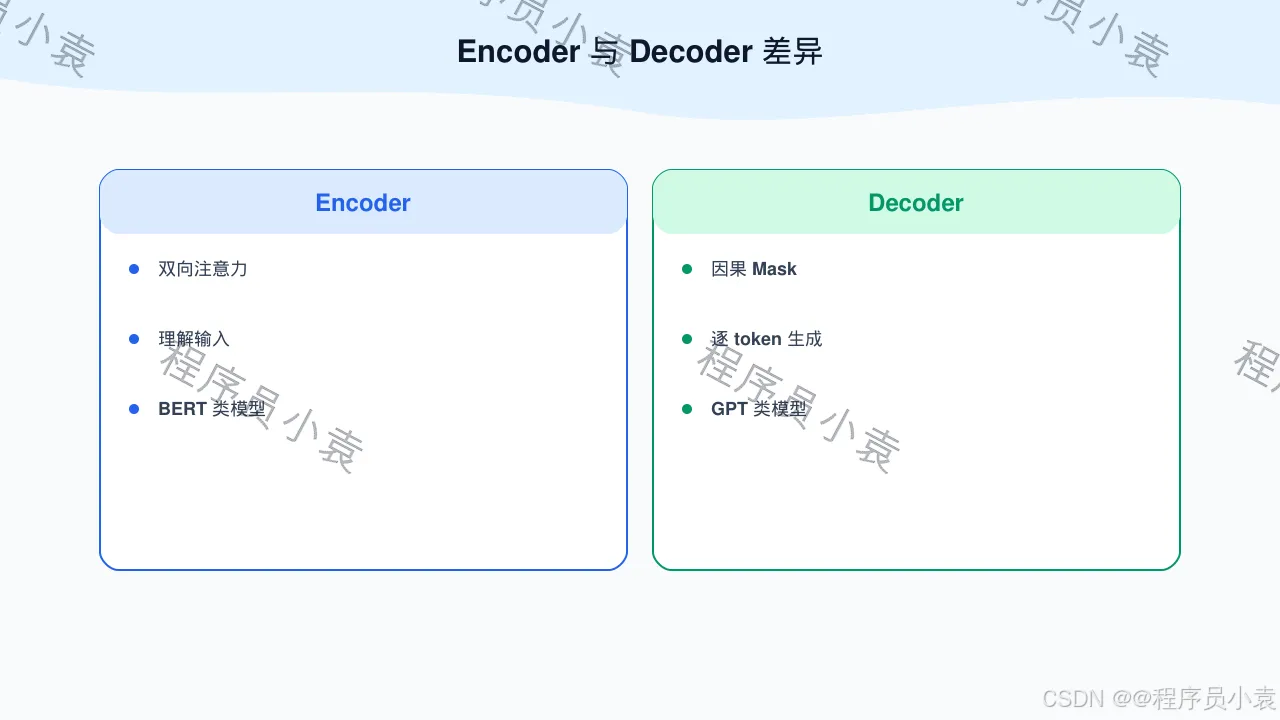
图解:Encoder 与 Decoder 差异
💡 答案要点
核心区别:典型 Encoder 自注意力可双向读取输入;自回归 Decoder 的自注意力使用 causal mask。原始 Encoder-Decoder Transformer 还有 Cross-Attention,而 GPT 类 Decoder-only 模型通常没有 Encoder,也就没有这层 Cross-Attention。
Encoder(编码器):
# Encoder 结构(重复N次,通常N=6)
for layer in range(N):
    # 1. Multi-Head Self-Attention
    # 可以看到整个输入序列(双向)
    attn_output = MultiHeadAttention(
        Q=x, K=x, V=x  # Query、Key、Value 都来自输入
    )
    x = LayerNorm(x + attn_output)  # 残差 + 归一化

    # 2. Feed-Forward Network
    ffn_output = FeedForward(x)
    x = LayerNorm(x + ffn_output)
特点:
- ✅ 双向注意力(可以看到前后文)
- ✅ 并行处理所有token
- ✅ 输出:编码后的表示(上下文向量)
Decoder(解码器):
# Decoder 结构(重复N次,通常N=6)
for layer in range(N):
    # 1. Masked Multi-Head Self-Attention
    # 只能看到当前及之前的token(单向)
    masked_attn = MaskedMultiHeadAttention(
        Q=y, K=y, V=y,  # 来自目标序列
        mask=causal_mask  # 上三角mask
    )
    y = LayerNorm(y + masked_attn)

    # 2. Encoder-Decoder Cross-Attention
    # Query来自Decoder,Key和Value来自Encoder输出
    cross_attn = MultiHeadAttention(
        Q=y,  # 来自 Decoder
        K=encoder_output,  # 来自 Encoder
        V=encoder_output   # 来自 Encoder
    )
    y = LayerNorm(y + cross_attn)

    # 3. Feed-Forward Network
    ffn_output = FeedForward(y)
    y = LayerNorm(y + ffn_output)
特点:
- ⚠️ 单向注意力(Masked,只能看之前的)
- ✅ 包含Cross-Attention(连接Encoder和Decoder)
- ⚠️ 自回归生成(逐个token生成)
关键差异对比:
| 维度 | Encoder | Decoder |
|---|---|---|
| Self-Attention | 双向(无mask) | 单向(有mask) |
| Cross-Attention | ❌ 无 | 原始 Seq2Seq Decoder 有;Decoder-only 通常无 |
| 输入 | 源序列(如英文) | 目标序列(如中文) |
| 输出 | 编码表示 | 生成序列 |
| 应用 | BERT(仅Encoder) | GPT(仅Decoder,无 Encoder Cross-Attention) |
Mask 机制详解:
# Encoder: 无mask,所有token都能互相看到
Input:  [I, love, AI]
Attention Matrix:
      I   love  AI
I    ✓    ✓    ✓
love ✓    ✓    ✓
AI   ✓    ✓    ✓

# Decoder: Causal Mask,只能看当前及之前
Input:  [我, 喜欢, 人工智能]
Attention Matrix:
        我  喜欢  人工智能
我      ✓   ✗    ✗
喜欢    ✓   ✓    ✗
人工智能 ✓   ✓    ✓
面试话术:
"Encoder 通常用双向 Self-Attention 编码输入;自回归 Decoder 用 causal mask 防止看到未来 token。原始 Seq2Seq Decoder 通过 Cross-Attention 读取 Encoder 输出,但 GPT 类 Decoder-only 模型没有 Encoder Cross-Attention。"
二、注意力机制
Q3: Self-Attention(自注意力)是如何计算的?
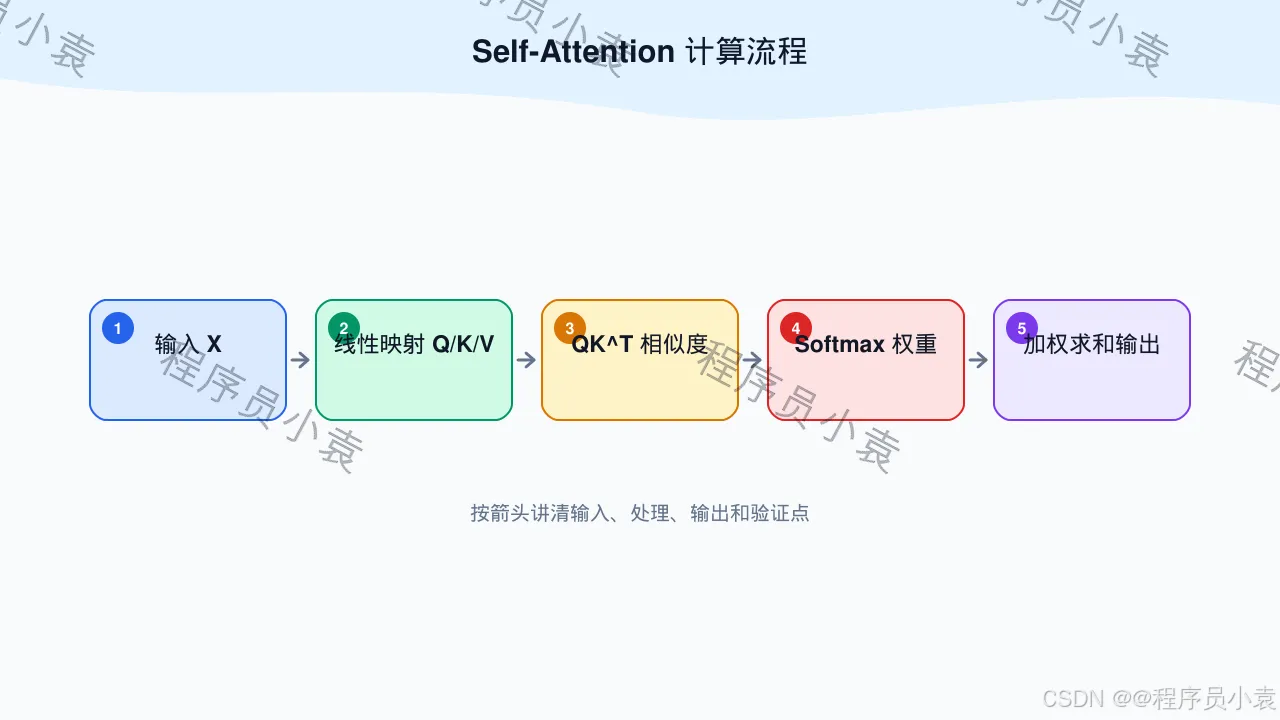
图解:Self-Attention 计算流程
💡 答案要点
Self-Attention = 让序列中的每个元素都能关注其他所有元素
数学公式:
Attention(Q, K, V) = softmax(QK^T / √d_k) V
详细步骤:
- 生成 Q、K、V:
# 输入:X (batch_size, seq_len, d_model)
# 例如:(1, 5, 512)

# 通过线性变换生成 Q、K、V
Q = X @ W_Q  # (batch_size, seq_len, d_k)
K = X @ W_K  # (batch_size, seq_len, d_k)
V = X @ W_V  # (batch_size, seq_len, d_v)

# W_Q, W_K, W_V 是可学习的权重矩阵
# d_k = d_v = d_model / num_heads (通常 64)
- 计算注意力分数:
# 点积计算相似度
scores = Q @ K.T  # (batch_size, seq_len, seq_len)
# 例如:(1, 5, 5)

# 缩放(防止梯度消失)
scores = scores / math.sqrt(d_k)

# 应用mask(可选,Decoder用)
if mask is not None:
    scores = scores.masked_fill(mask == 0, -1e9)
- Softmax归一化:
# 每一行做softmax,得到注意力权重
attention_weights = softmax(scores, dim=-1)
# (batch_size, seq_len, seq_len)

# 权重和为1
assert attention_weights.sum(dim=-1) == 1.0
- 加权求和:
# 用注意力权重加权V
output = attention_weights @ V
# (batch_size, seq_len, d_v)
完整示例(序列长度=3):
# 输入
X = [[1.0, 0.5],  # token 1
     [0.8, 1.0],  # token 2
     [0.5, 0.9]]  # token 3

# 假设 W_Q = W_K = W_V = I(单位矩阵)
Q = K = V = X

# 1. 计算相似度矩阵
scores = Q @ K.T
# [[1.25, 1.3, 0.95],
#  [1.3,  1.64, 1.3],
#  [0.95, 1.3, 1.06]]

# 2. 缩放(假设 d_k=2)
scores = scores / sqrt(2)
# [[0.88, 0.92, 0.67],
#  [0.92, 1.16, 0.92],
#  [0.67, 0.92, 0.75]]

# 3. Softmax
attention_weights = softmax(scores, dim=-1)
# [[0.32, 0.35, 0.33],  # token 1 对 3 个token的注意力
#  [0.28, 0.44, 0.28],  # token 2 对 3 个token的注意力
#  [0.29, 0.37, 0.34]]  # token 3 对 3 个token的注意力

# 4. 加权求和
output = attention_weights @ V
# [[0.77, 0.80],  # token 1的输出
#  [0.76, 0.87],  # token 2的输出
#  [0.74, 0.82]]  # token 3的输出
为什么要缩放(除以√d_k)?
问题:
  当 d_k 很大时(如512),QK^T 的值会很大
  → Softmax 梯度接近0(饱和)
  → 梯度消失

解决:
  除以 √d_k,将方差缩放到1
  → 保持Softmax输入在合理范围
  → 梯度稳定
面试话术:
"Self-Attention通过 Q、K、V 三个矩阵计算。先用 QK^T 算相似度,除以√d_k 防止梯度消失,然后Softmax归一化得到权重,最后加权求和V得到输出。核心是让每个token都能直接关注其他所有token。"
Q4: Multi-Head Attention(多头注意力)是什么?为什么要用多头?
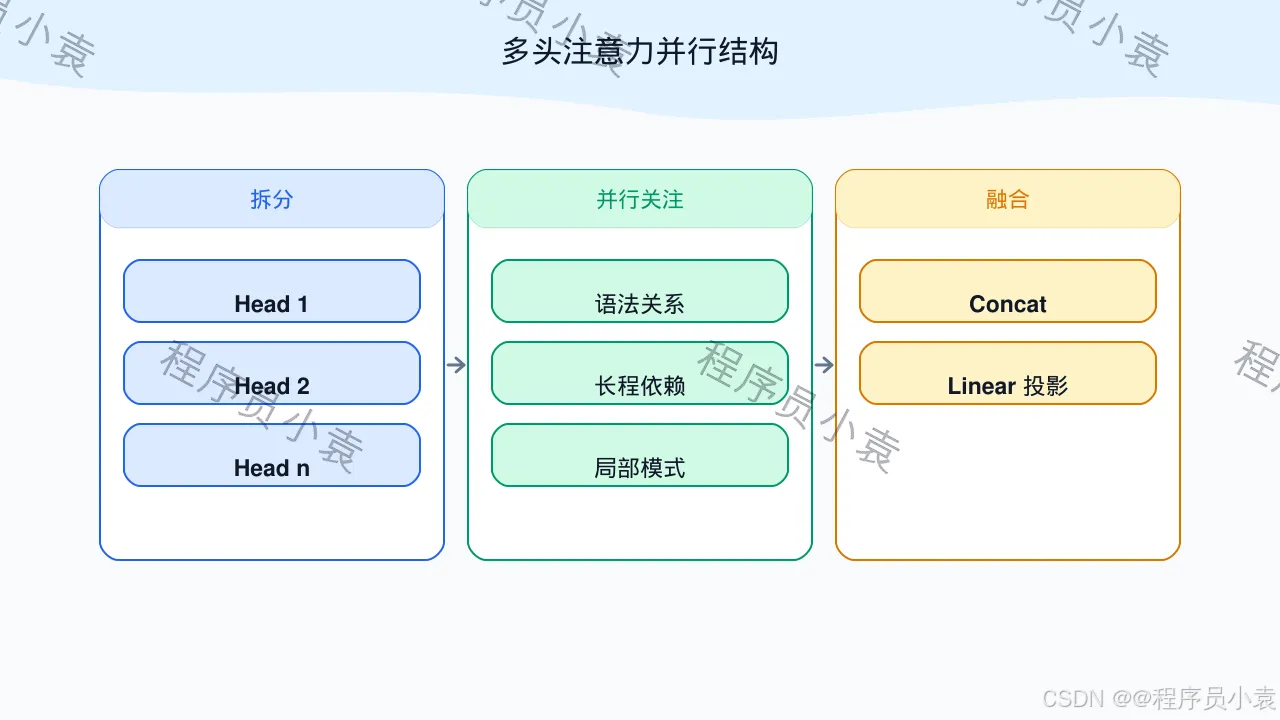
图解:多头注意力并行结构
💡 答案要点
Multi-Head Attention = 多个Self-Attention并行,捕捉不同类型的关系
为什么需要多头?
单头的局限:
单个注意力头只有一个投影子空间,表达与分工能力受限
例如:
  "我 爱 吃 苹果"

单头可能只关注:
  语法关系:"我" ← "爱"(主谓)

但错过了:
  语义关系:"吃" ← "苹果"(动宾)
  共指关系:"我" → "我"(指代)
多头的优势:
多个头可以学习不同的模式:
  Head 1: 语法关系(主谓宾)
  Head 2: 语义关系(实体-动作)
  Head 3: 位置关系(相邻词)
  Head 4: 长程依赖(句首-句尾)
  ...
  其他 Head: 其他模式
架构:
class MultiHeadAttention:
    def __init__(self, d_model=512, num_heads=8):
        self.num_heads = num_heads
        self.d_k = d_model // num_heads  # 64

        # 每个头有独立的 Q、K、V 权重
        self.W_Q = nn.Linear(d_model, d_model)
        self.W_K = nn.Linear(d_model, d_model)
        self.W_V = nn.Linear(d_model, d_model)

        # 输出投影
        self.W_O = nn.Linear(d_model, d_model)

    def forward(self, Q, K, V, mask=None):
        batch_size = Q.size(0)

        # 1. 线性变换并分头
        # (batch, seq_len, d_model) → (batch, seq_len, num_heads, d_k)
        Q = self.W_Q(Q).view(batch_size, -1, self.num_heads, self.d_k)
        K = self.W_K(K).view(batch_size, -1, self.num_heads, self.d_k)
        V = self.W_V(V).view(batch_size, -1, self.num_heads, self.d_k)

        # 转置以并行计算多头
        # (batch, num_heads, seq_len, d_k)
        Q = Q.transpose(1, 2)
        K = K.transpose(1, 2)
        V = V.transpose(1, 2)

        # 2. 每个头独立计算注意力
        scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.d_k)

        if mask is not None:
            scores = scores.masked_fill(mask == 0, -1e9)

        attention = F.softmax(scores, dim=-1)
        output = torch.matmul(attention, V)

        # 3. 合并多头
        # (batch, num_heads, seq_len, d_k) → (batch, seq_len, d_model)
        output = output.transpose(1, 2).contiguous()
        output = output.view(batch_size, -1, self.num_heads * self.d_k)

        # 4. 输出投影
        output = self.W_O(output)

        return output
可视化示例(8个头):
输入:"The cat sat on the mat"

Head 1(主语-谓语):
  cat → sat (0.9)

Head 2(谓语-宾语):
  sat → mat (0.8)

Head 3(修饰关系):
  the → cat (0.7)
  the → mat (0.6)

Head 4(位置关系):
  on → the (0.9)

...

最终输出 = Concat(Head1, Head2, ..., Head8) @ W_O
参数与工程权衡:
| 方案 | 参数量 | 主要影响 |
|---|---|---|
| MHA,固定 d_model | Q/K/V/O 投影总参数量通常不因“切成几个头”而线性增加 | 头数改变每头维度、并行粒度与表示子空间 |
| GQA/MQA | 主要减少 K/V 投影和 KV Cache | 解码带宽更低,但 KV 共享过多可能损失质量 |
面试话术:
"Multi-Head Attention 让模型在多个表示子空间并行做内容寻址。头数没有跨模型通用的最佳值;推理系统还会把 Query 头数与 KV 头数分开设计,形成 GQA 或 MQA,以换取更小的 KV Cache。"
Q5: 位置编码(Positional Encoding)是什么?为什么需要它?
图解:位置编码如何注入顺序信息
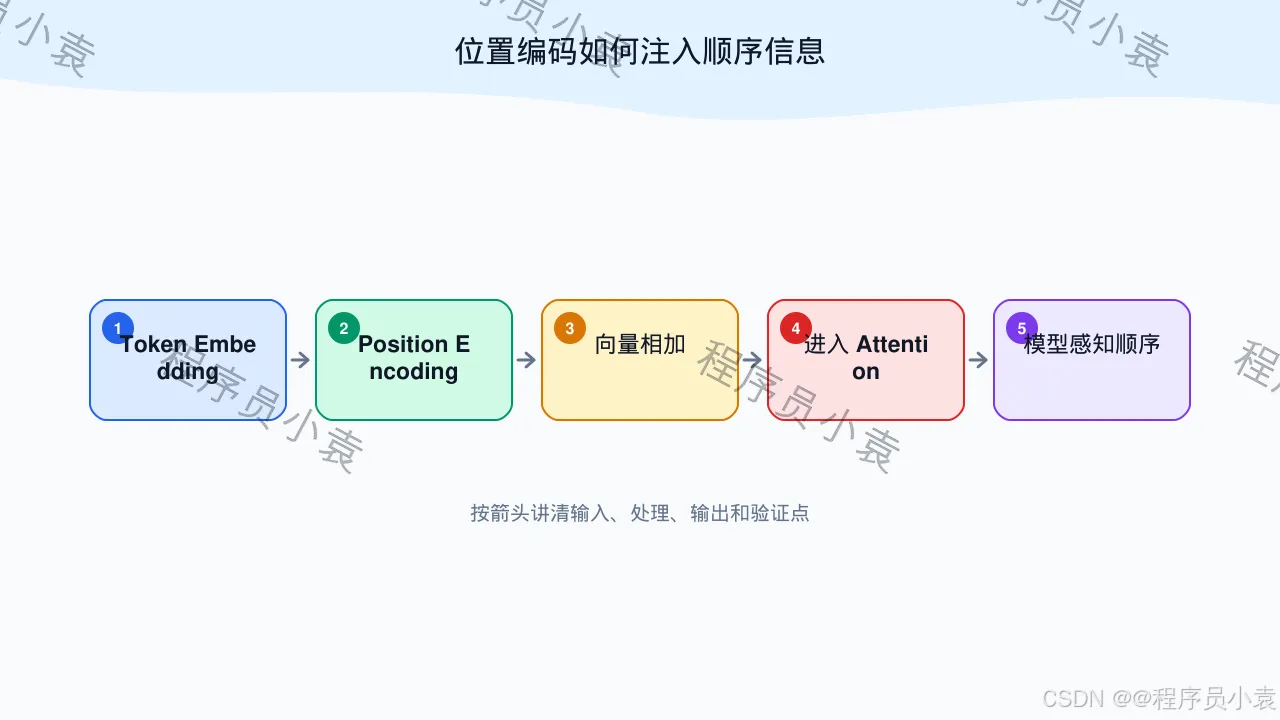
💡 答案要点
位置编码 = 给每个token注入位置信息
为什么需要?
问题:
  Self-Attention 是置换不变的(permutation-invariant)

例子:
  "我 爱 你" 和 "你 爱 我"
  如果没有位置编码,Attention 输出可能相同
  → 无法区分顺序

解决:
  加入位置信息,让模型知道每个token的位置
Transformer 的位置编码(Sinusoidal):
公式:
PE(pos, 2i)   = sin(pos / 10000^(2i/d_model))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))

其中:
  pos: 位置(0, 1, 2, ...)
  i:   维度索引(0 到 d_model/2)
  d_model: 模型维度(如512)
实现:
def positional_encoding(max_len, d_model):
    # 创建位置矩阵
    position = torch.arange(max_len).unsqueeze(1)  # (max_len, 1)

    # 创建维度矩阵
    div_term = torch.exp(
        torch.arange(0, d_model, 2) *
        -(math.log(10000.0) / d_model)
    )  # (d_model/2,)

    # 初始化位置编码
    pe = torch.zeros(max_len, d_model)

    # 偶数维度用sin
    pe[:, 0::2] = torch.sin(position * div_term)

    # 奇数维度用cos
    pe[:, 1::2] = torch.cos(position * div_term)

    return pe

# 使用
pe = positional_encoding(max_len=100, d_model=512)
# pe.shape: (100, 512)

# 加到输入上
x = embedding(input_ids) + pe[: input_ids.size(1)]
为什么用sin/cos?
优势:
- 确定性:位置固定,不需要学习
- 可定义性:公式可计算任意位置,但不等于模型能在训练长度外保持质量
- 周期性:不同位置间有规律的相对关系
相对位置关系:
# PE(pos + k) 可以表示为 PE(pos) 的线性组合
# 这让模型能学习相对位置

例如:
  PE(5) 和 PE(10) 的距离
  = PE(1) 和 PE(6) 的距离
  (相对距离都是5)
可视化(前10个位置,前64维):
位置  维度0  维度1  维度2  维度3  ...
0     0.00   1.00   0.00   1.00
1     0.84   0.54   0.01   1.00
2     0.91  -0.42   0.02   1.00
3     0.14  -0.99   0.03   1.00
...
其他位置编码方案:
| 方案 | 优点 | 缺点 | 应用 |
|---|---|---|---|
| Sinusoidal | 无需学习,可计算任意位置 | 超出训练分布仍可能退化 | 原始 Transformer |
| Learned | 可学习、灵活 | 通常受训练时最大位置表限制 | BERT |
| RoPE | Q/K 旋转后点积显式依赖相对位置 | 原生 RoPE 不保证训练长度外泛化 | 多种公开 Decoder-only 模型 |
| ALiBi | 对注意力分数加入距离偏置 | 与预训练配置绑定,不能假定零成本替换 | BLOOM 等公开模型 |
现代改进:RoPE(Rotary Position Embedding):
# LLaMA/GPT-NeoX 使用
# 核心思想:在注意力计算时旋转 Q 和 K

def apply_rotary_emb(q, k, cos, sin):
    # 旋转 Q 和 K
    q_rot = rotate_half(q)
    k_rot = rotate_half(k)

    q = q * cos + q_rot * sin
    k = k * cos + k_rot * sin

    return q, k

# 性质:
#   - 绝对位置通过旋转注入,Q/K 点积呈现相对位置依赖
#   - 训练长度外通常需要位置插值、频率缩放或继续训练
面试话术:
"原始 Transformer 把 sin/cos 位置编码加到输入;RoPE 则旋转 Q/K,使点积显式依赖相对位移。公式能算到更远位置不代表模型会外推,扩窗必须用长文本困惑度、检索、复制和真实任务验证,不能只跑 Needle-in-a-Haystack。"
三、BERT与GPT
Q6: BERT 和 GPT 有什么区别?
💡 答案要点
核心区别:BERT是双向理解,GPT是单向生成
架构对比:
| 维度 | BERT | GPT |
|---|---|---|
| 架构 | 仅Encoder | 仅Decoder |
| 注意力 | 双向(无mask) | 单向(causal mask) |
| 训练目标 | MLM + NSP | 自回归语言模型 |
| 任务类型 | 理解(分类、NER) | 生成(文本生成) |
| 参数 | 110M-340M | 117M-175B |
BERT(Bidirectional Encoder Representations from Transformers):
┌─────────────────────────────────────────────────────────┐
│                    BERT 架构                             │
└─────────────────────────────────────────────────────────┘

输入:"The [MASK] sat on the mat"
  ↓
Embedding + Positional Encoding
  ↓
Transformer Encoder (12/24 层)
├── Multi-Head Self-Attention(双向)
└── Feed-Forward Network
  ↓
输出:每个token的上下文表示
  ↓
任务头(分类/NER/...)
训练目标1:MLM(Masked Language Model)
# 随机mask 15%的token
原文:"The cat sat on the mat"
Mask: "The [MASK] sat on the [MASK]"

# 预测被mask的词
损失 = CrossEntropy(预测, ["cat", "mat"])

# 15%中的策略:
#   80%: 替换为 [MASK]
#   10%: 替换为随机词
#   10%: 保持不变
训练目标2:NSP(Next Sentence Prediction)
# 判断两句话是否连续
输入:
  A: "The cat sat on the mat."
  B: "It was very comfortable."
  Label: IsNext (1) or NotNext (0)

损失 = BCELoss(预测, Label)
GPT(Generative Pre-trained Transformer):
┌─────────────────────────────────────────────────────────┐
│                    GPT 架构                              │
└─────────────────────────────────────────────────────────┘

输入:"The cat sat on"
  ↓
Embedding + Positional Encoding
  ↓
Transformer Decoder (12/96 层)
├── Masked Multi-Head Self-Attention(单向)
└── Feed-Forward Network
  ↓
输出:下一个token的概率分布
  ↓
预测:"the" (概率0.8)
训练目标:自回归语言模型
# 预测下一个词
输入:"The cat sat"
目标:"on"

# 训练时并行计算所有位置的损失
损失 = Σ CrossEntropy(预测[i], 目标[i])

# 推理时自回归生成
generated = []
for i in range(max_len):
    next_token = model.predict(generated)
    generated.append(next_token)
能力对比:
| 任务 | BERT | GPT |
|---|---|---|
| 文本分类 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ |
| 命名实体识别 | ⭐⭐⭐⭐⭐ | ⭐⭐ |
| 问答 | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| 文本生成 | ⭐ | ⭐⭐⭐⭐⭐ |
| 摘要 | ⭐⭐ | ⭐⭐⭐⭐⭐ |
| 对话 | ⭐ | ⭐⭐⭐⭐⭐ |
实际应用:
BERT 擅长:
# 1. 分类
"This movie is great!" → Positive (0.95)

# 2. NER(命名实体识别)
"Apple was founded by Steve Jobs"
→ [Apple: ORG], [Steve Jobs: PER]

# 3. 问答
Context: "Paris is the capital of France."
Question: "What is the capital of France?"
Answer: "Paris" (span: [0, 5])
GPT 擅长:
# 1. 文本生成
Prompt: "Once upon a time"
Output: "there was a brave knight..."

# 2. 对话
User: "How are you?"
GPT: "I'm doing well, thank you!"

# 3. 代码生成
Prompt: "Write a Python function to sort a list"
Output: "def sort_list(arr): return sorted(arr)"
为什么BERT用双向,GPT用单向?
BERT:
  目标是理解语言
  双向能看到完整上下文
  例如:"bank"(银行 vs 河岸)需要前后文判断

GPT:
  目标是生成语言
  必须单向,否则"作弊"
  生成时只能看已生成的部分
面试话术:
"BERT 是理解型模型,用双向Encoder + MLM训练,擅长分类、NER。GPT 是生成型模型,用单向Decoder + 自回归训练,擅长文本生成、对话。BERT看完整上下文理解语义,GPT逐个生成token。"
四、优化技巧
Q7: Transformer 训练时有哪些优化技巧?
💡 答案要点
核心优化方向:
- 学习率调度
- 正则化
- 训练稳定性
计算效率
学习率调度(Warmup + Decay):
# Warmup阶段:线性增加学习率
def get_lr(step, d_model, warmup_steps=4000):
    # Transformer 原论文方案
    lr = d_model ** (-0.5) * min(
        step ** (-0.5),
        step * warmup_steps ** (-1.5)
    )
    return lr

# 为什么需要Warmup?
# - 初始时权重随机,梯度不稳定
# - 小学习率让模型"热身"
# - 然后逐渐增大到峰值
# - 最后逐渐衰减

# 典型曲线:
#   0-4K步:线性增加 0 → peak_lr
#   4K步后:按 1/√step 衰减
- Label Smoothing(标签平滑):
# 问题:Hard Label容易过拟合
hard_label = [0, 0, 0, 1, 0]  # one-hot

# 解决:Label Smoothing
smooth_label = [0.02, 0.02, 0.02, 0.92, 0.02]
# 真实类别:0.92(1 - smoothing)
# 其他类别:0.02(smoothing / (n_classes - 1))

class LabelSmoothingLoss(nn.Module):
    def __init__(self, n_classes, smoothing=0.1):
        super().__init__()
        self.smoothing = smoothing
        self.n_classes = n_classes

    def forward(self, pred, target):
        # pred: (batch, n_classes)
        # target: (batch,) 类别索引

        confidence = 1.0 - self.smoothing
        smooth_value = self.smoothing / (self.n_classes - 1)

        # 构造smooth label
        smooth_label = torch.full_like(pred, smooth_value)
        smooth_label.scatter_(1, target.unsqueeze(1), confidence)

        # KL散度损失
        loss = -torch.sum(smooth_label * torch.log_softmax(pred, dim=1), dim=1)
        return loss.mean()

# 效果取决于任务、数据和系数,需要消融验证
- Dropout 策略:
class TransformerLayer(nn.Module):
    def __init__(self, d_model=512, dropout=0.1):
        super().__init__()
        self.dropout = dropout

    def forward(self, x):
        # 1. Attention Dropout
        attn_output = self.attention(x)
        attn_output = F.dropout(attn_output, p=self.dropout, training=self.training)

        # 2. Residual Dropout
        x = x + attn_output

        # 3. FFN Dropout
        ffn_output = self.ffn(x)
        ffn_output = F.dropout(ffn_output, p=self.dropout, training=self.training)

        x = x + ffn_output

        return x

# 典型配置:
#   Attention Dropout: 0.1
#   Residual Dropout: 0.1
#   FFN Dropout: 0.1
#   Embedding Dropout: 0.1
- 梯度裁剪(Gradient Clipping):
# 防止梯度爆炸
max_grad_norm = 1.0

for batch in dataloader:
    loss = model(batch)
    loss.backward()

    # 裁剪梯度
    torch.nn.utils.clip_grad_norm_(
        model.parameters(),
        max_grad_norm
    )

    optimizer.step()
    optimizer.zero_grad()
- Mixed Precision Training(混合精度):
from torch.cuda.amp import autocast, GradScaler

scaler = GradScaler()

for batch in dataloader:
    optimizer.zero_grad()

    # FP16 前向传播
    with autocast():
        loss = model(batch)

    # 缩放损失,FP16 反向传播
    scaler.scale(loss).backward()

    # 更新权重(FP32)
    scaler.step(optimizer)
    scaler.update()

# 优势:
#   - 可利用低精度 Tensor Core 并减少部分激活/通信开销
#   - 实际速度、显存和精度变化取决于硬件、dtype、算子与缩放策略
- 批量大小优化:
# 问题:GPU显存有限,batch_size受限

# 解决:梯度累积
accumulation_steps = 4
effective_batch_size = batch_size * accumulation_steps

optimizer.zero_grad()
for i, batch in enumerate(dataloader):
    loss = model(batch) / accumulation_steps
    loss.backward()

    if (i + 1) % accumulation_steps == 0:
        optimizer.step()
        optimizer.zero_grad()

# 效果:
#   原来:batch_size=32,每步更新
#   现在:batch_size=32×4=128,每4步更新
#   显存不变,效果更好
- 并行训练:
# 数据并行(Data Parallel)
model = nn.DataParallel(model)

# 分布式数据并行(Distributed Data Parallel,推荐)
model = nn.parallel.DistributedDataParallel(model)

# 模型并行(Model Parallel,超大模型)
# 不同层放在不同GPU
class ModelParallel(nn.Module):
    def __init__(self):
        super().__init__()
        self.encoder = nn.Sequential(*layers[:6]).to('cuda:0')
        self.decoder = nn.Sequential(*layers[6:]).to('cuda:1')

    def forward(self, x):
        x = self.encoder(x.to('cuda:0'))
        x = self.decoder(x.to('cuda:1'))
        return x
典型配置(Transformer Base):
| 参数 | 值 |
|---|---|
| d_model | 512 |
| n_heads | 8 |
| d_ff | 2048 |
| n_layers | 6 |
| dropout | 0.1 |
| warmup_steps | 4000 |
| label_smoothing | 0.1 |
| max_grad_norm | 1.0 |
| batch_size | 25K tokens |
| optimizer | Adam(β1=0.9, β2=0.98, ε=1e-9) |
面试话术:
"Transformer 训练要同时看优化稳定性与系统效率:学习率 warmup/decay、正则化、梯度裁剪、混合精度、梯度累积和分布式并行。混合精度的收益不能报固定倍数,应在目标硬件上比较吞吐、显存、溢出率和最终质量。"
Q8: Q K V矩阵的详细计算过程是什么?
图解:Q/K/V 的角色分工
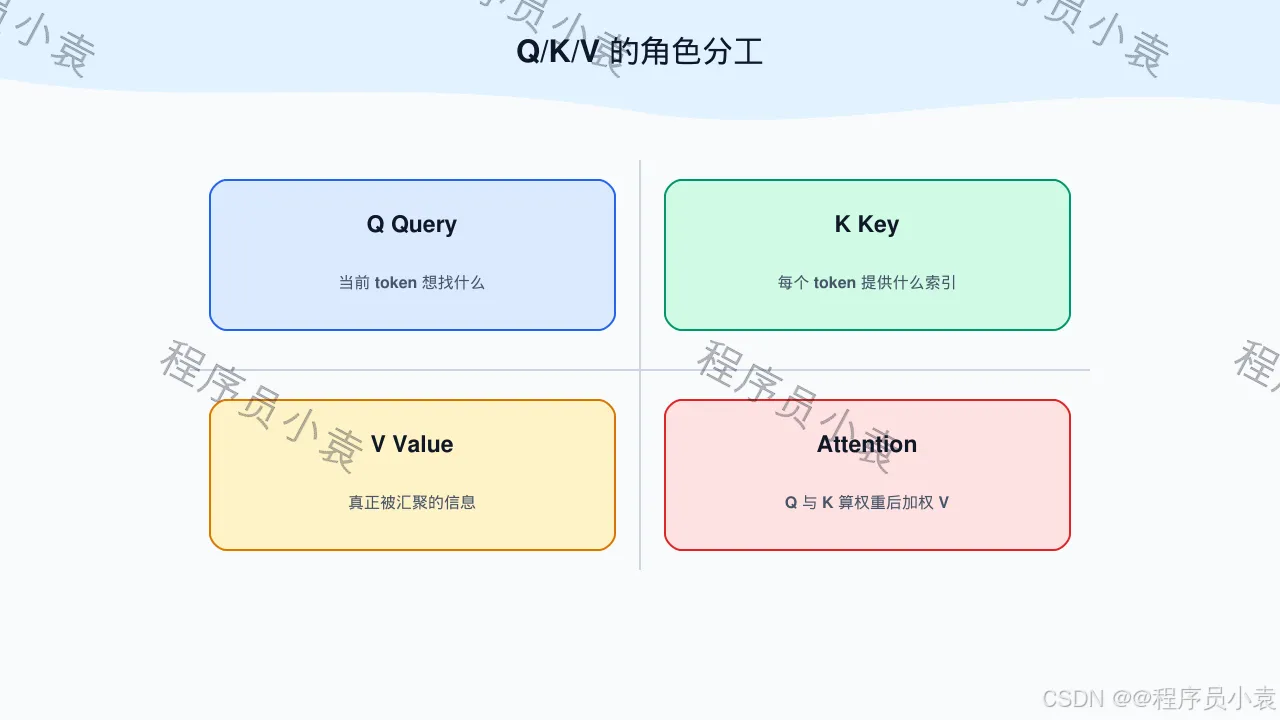
💡 答案要点
Q K V = Query(查询)、Key(键)、Value(值)
生成过程
步骤1: 输入embedding
# 输入序列: "我 爱 AI"
input_ids = [101, 234, 567]  # token IDs
embeddings = embedding_layer(input_ids)  # shape: (3, 512)
# 每个token → 512维向量

# 加上位置编码
position_encodings = get_position_encoding(3, 512)
input_repr = embeddings + position_encodings  # shape: (3, 512)
步骤2: 线性变换生成Q K V
# 3个可学习的权重矩阵
W_Q = nn.Linear(512, 512)  # Query权重
W_K = nn.Linear(512, 512)  # Key权重
W_V = nn.Linear(512, 512)  # Value权重

# 生成Q K V
Q = W_Q(input_repr)  # shape: (3, 512)
K = W_K(input_repr)  # shape: (3, 512)
V = W_V(input_repr)  # shape: (3, 512)
为什么需要3个矩阵?
- Q(查询): "我想找什么信息?"
- K(键): "我能提供什么信息?"
- V(值): "我包含什么信息?"
类比搜索引擎:
Q = 用户搜索词 "Python教程"
K = 文档标题 ["Python入门", "Java教程", "Python高级"]
V = 文档内容 [实际的Python教程文本]

步骤:
1. Q与每个K计算相似度 → 注意力分数
2. 用分数加权V → 最终输出
Multi-Head Attention详细计算
步骤1: 拆分成多个头
num_heads = 8
d_model = 512
d_k = d_model // num_heads  # 512 / 8 = 64

# 将Q K V reshape成多头
Q_multi = Q.view(batch_size, seq_len, num_heads, d_k)
# shape: (batch, 3, 8, 64)

K_multi = K.view(batch_size, seq_len, num_heads, d_k)
V_multi = V.view(batch_size, seq_len, num_heads, d_k)

# 转置: (batch, num_heads, seq_len, d_k)
Q_multi = Q_multi.transpose(1, 2)  # (batch, 8, 3, 64)
K_multi = K_multi.transpose(1, 2)
V_multi = V_multi.transpose(1, 2)
步骤2: 每个头独立计算Attention
# Scaled Dot-Product Attention
scores = torch.matmul(Q_multi, K_multi.transpose(-2, -1))
# shape: (batch, 8, 3, 3)
# 3×3矩阵: 每个token对所有token的注意力分数

# 缩放 (防止梯度消失)
scores = scores / math.sqrt(d_k)  # 除以√64 = 8

# Softmax归一化
attention_weights = F.softmax(scores, dim=-1)
# shape: (batch, 8, 3, 3)

# 加权求和
output = torch.matmul(attention_weights, V_multi)
# shape: (batch, 8, 3, 64)
步骤3: 拼接所有头
# 转置回来
output = output.transpose(1, 2)  # (batch, 3, 8, 64)

# 拼接
output = output.contiguous().view(batch_size, seq_len, d_model)
# shape: (batch, 3, 512)  # 8×64 = 512

# 最终线性变换
output = W_O(output)  # W_O: (512, 512)
完整示例(数值):
# 假设seq_len=3, d_k=4 (简化)
Q = [[1,0,1,0],   # token1的Query
     [0,2,0,2],   # token2的Query
     [1,1,1,1]]   # token3的Query

K = [[0,1,0,1],   # token1的Key
     [1,1,1,1],   # token2的Key
     [2,2,2,2]]   # token3的Key

# 步骤1: Q × K^T
scores = Q @ K.T
# [[1,2,4],
#  [4,4,8],
#  [2,4,8]]

# 步骤2: 缩放
scores = scores / sqrt(4) = scores / 2
# [[0.5,1,2],
#  [2,2,4],
#  [1,2,4]]

# 步骤3: Softmax
weights = softmax(scores, dim=-1)
# [[0.18, 0.24, 0.58],   # token1关注token3最多
#  [0.12, 0.12, 0.76],   # token2关注token3最多
#  [0.09, 0.24, 0.67]]   # token3关注自己最多

# 步骤4: 加权求和Value
output = weights @ V
面试话术:
"Q K V的本质是3种视角看同一个信息。Q是'我要找什么',K是'我能匹配什么',V是'我的内容是什么'。Multi-Head让模型从8个不同角度理解文本,比如一个头关注语法,另一个关注语义。"
Q9: 位置编码的详细原理是什么?为什么用sin/cos?
💡 答案要点
位置编码 = 让模型知道token的位置信息
为什么需要位置编码?
问题: Attention是排列不变的
# 不同顺序,Attention输出相同!
input1 = ["狗", "咬", "人"]
input2 = ["人", "咬", "狗"]

# Self-Attention(input1) ≈ Self-Attention(input2)
# 因为只看相似度,不看顺序
解决: 加入位置信息
embedding_with_pos = word_embedding + positional_encoding
Sin/Cos位置编码公式
PE(pos, 2i) = sin(pos / 10000^(2i/d_model))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))

其中:
- pos: 位置(0, 1, 2, ...)
- i: 维度索引(0 到 d_model/2)
- d_model: embedding维度(如512)
具体计算示例:
import numpy as np

def get_positional_encoding(max_len, d_model):
    pe = np.zeros((max_len, d_model))

    for pos in range(max_len):
        for i in range(0, d_model, 2):
            # 偶数维度: sin
            pe[pos, i] = np.sin(pos / (10000 ** (i/d_model)))

            # 奇数维度: cos
            if i+1 < d_model:
                pe[pos, i+1] = np.cos(pos / (10000 ** (i/d_model)))

    return pe

# 示例: max_len=100, d_model=512
pe = get_positional_encoding(100, 512)

# 位置0的编码
print(pe[0])  # [sin(0/1), cos(0/1), sin(0/464), cos(0/464), ...]

# 位置1的编码
print(pe[1])  # [sin(1/1), cos(1/1), sin(1/464), cos(1/464), ...]
为什么选sin/cos?
优势1: 表示相对位置
# 数学性质: sin/cos的线性组合
sin(α + β) = sin(α)cos(β) + cos(α)sin(β)
cos(α + β) = cos(α)cos(β) - sin(α)sin(β)

# 意味着: PE(pos+k)可由PE(pos)线性变换得到
# 模型容易学习相对位置关系
优势2: 可计算未见过的位置
# 训练: max_len=512
# 推理: len=1024  # 超出训练长度

# sin/cos是连续函数,编码本身可以计算
pe_1024 = get_positional_encoding(1024, 512)
# 但模型质量是否外推必须实测,不能由公式直接推出
优势3: 不同频率捕捉不同范围
# 高频(i接近0): 变化快,区分近距离位置
PE(pos, 0) = sin(pos / 1)  # 周期短,变化快

# 低频(i接近d_model): 变化慢,表达较长尺度
PE(pos, 511) = sin(pos / 10000)  # 周期长,变化慢
可视化:
Position 0: [0.00, 1.00, 0.00, 1.00, 0.00, 1.00, ...]
Position 1: [0.84, 0.54, 0.01, 1.00, 0.00, 1.00, ...]
Position 2: [0.91,-0.42, 0.02, 1.00, 0.00, 1.00, ...]
           ↑ 快变化  ↑ 慢变化
其他位置编码方法
| 方法 | 原理 | 优缺点 | 应用 |
|---|---|---|---|
| Sin/Cos | 固定公式 | 可计算新位置,但质量不保证外推 | 原始Transformer |
| Learned PE | 可学习embedding | 适应任务,但通常受位置表长度限制 | BERT |
| RoPE | 旋转位置编码 | 相对位置性质好,原生扩窗仍会退化 | 多种公开 Decoder-only 模型 |
| ALiBi | 注意力偏置 | 省去位置向量,仍需按训练设置评测 | BLOOM、MPT |
RoPE简介(LLaMA使用):
# 不是加法,而是旋转
# Q和K乘以旋转矩阵
Q_rot = rotate(Q, position)
K_rot = rotate(K, position)

# 性质: Q/K 点积包含相对位置依赖
# 扩展上下文通常还需位置缩放和长上下文训练/微调
面试话术:
"Sin/Cos 编码用不同频率表达不同尺度的位置关系;RoPE 把相对位置信息引入 Q/K 点积;ALiBi 直接加入距离偏置。它们都不保证把模型无损扩展到任意长度,长上下文仍要结合训练分布、缩放策略、注意力质量、显存和评测验证。"
五、速记卡片
Transformer 核心概念
| 概念 | 一句话解释 |
|---|---|
| Transformer | 基于自注意力的序列模型,可并行训练 |
| Self-Attention | 每个token关注所有其他token |
| Multi-Head | 多个注意力头捕捉不同关系 |
| Positional Encoding | sin/cos函数注入位置信息 |
注意力机制
| 公式/概念 | 说明 |
|---|---|
| Attention(Q,K,V) | softmax(QK^T/√d_k)V |
| 缩放因子 | √d_k,防止梯度消失 |
| Causal Mask | 上三角mask,生成时只看之前 |
| Cross-Attention | Q来自Decoder,K/V来自Encoder |
BERT vs GPT
| 维度 | BERT | GPT |
|---|---|---|
| 架构 | Encoder only | Decoder only |
| 注意力 | 双向 | 单向(masked) |
| 训练 | MLM + NSP | 自回归LM |
| 任务 | 理解(分类/NER) | 生成(对话/摘要) |
优化技巧
| 技巧 | 效果 |
|---|---|
| Warmup | 稳定训练,先升后降学习率 |
| Label Smoothing | 缓解过度自信,收益需按任务消融 |
| Gradient Clipping | 防梯度爆炸,clip=1.0 |
| Mixed Precision | 利用低精度硬件并降低部分内存开销,收益依实现而定 |
| Gradient Accumulation | 模拟大batch,不增显存 |
六、2026新架构:Transformer + SSM 混合模型(Mamba)
Q10: 什么是SSM(状态空间模型)?2026年Transformer+SSM混合架构为什么是重要趋势?
图解:Transformer + SSM 混合架构
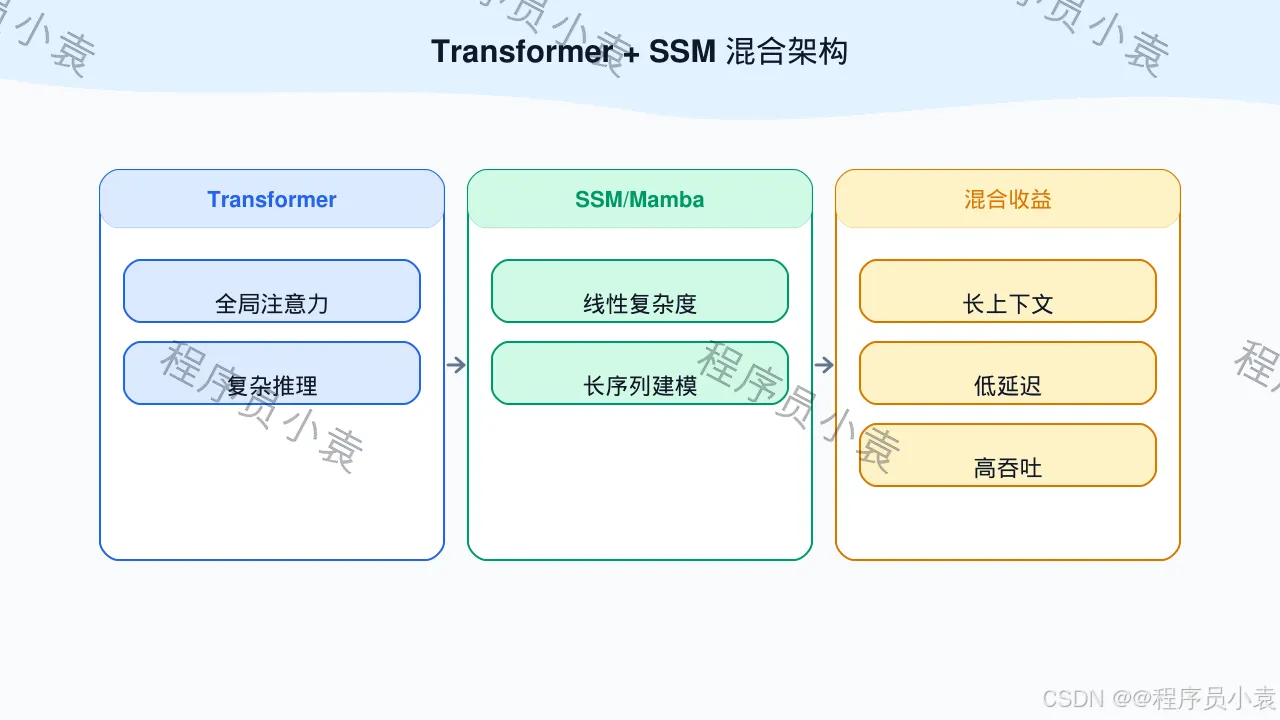
💡 答案要点
为什么2026年面试开始问这个:
SSM(如 Mamba 系列)与 Attention 混合是长序列建模的重要研究路线,但不能在缺少公开技术报告时断言闭源模型采用了某种内部结构。面试重点应放在混合架构的动机和权衡:Attention 擅长内容寻址与全局交互,SSM 以近线性序列复杂度维护状态,两者组合试图兼顾质量、吞吐与长上下文成本。
SSM(状态空间模型)是什么:
SSM将序列建模视为一个"状态转移系统":
输入序列 x(t) → 状态空间模型 → 输出序列 y(t)
                    ↑
              隐状态 h(t)

核心方程(连续形式):
  h'(t) = Ah(t) + Bx(t)     ← 状态更新
  y(t)   = Ch(t) + Dx(t)    ← 输出生成

离散化后(实际计算形式):
  h_t = Ah_{t-1} + Bx_t     ← 线性 recurrence
  y_t = Ch_t
| 特性 | 全注意力 Transformer | 选择性 SSM(以 Mamba 为例) |
|---|---|---|
| 训练序列计算 | 注意力部分 O(n²d) | 扫描/卷积式实现近似随 n 线性增长 |
| 自回归单步状态 | KV Cache 随历史长度增长 | 固定大小递归状态 |
| 内容寻址 | 可直接比较当前 Query 与历史 Key | 历史被压缩进状态,精确复制/检索可能更难 |
| 并行训练 | 矩阵乘法生态成熟 | 依赖硬件感知扫描、卷积和融合内核 |
| 可解释性 | 注意力权重也不等于因果解释 | 隐状态同样不天然可解释 |
Mamba的核心创新:Selection Mechanism(选择性机制)
传统SSM对所有输入用相同的静态矩阵——这和"不根据输入调整"的CNN一样,限制了表达能力。
Mamba的关键洞察:让SSM的参数变成输入的函数
静态 SSM:      h_t = Āh_{t-1} + B̄x_t
Mamba(选择性):离散化步长 Δ、B、C 等由输入决定

→ 模型能"选择性遗忘"无关信息,"选择性记住"关键信息
→ 但不要简化成“所有状态矩阵都随输入变化”
为什么需要Transformer + SSM混合架构:
┌─────────────────────────────────────────────────┐
│          2026年大模型混合架构                    │
├─────────────────────────────────────────────────┤
│  Transformer层:擅长全局注意力                   │
│  → 复杂推理、多跳关系、长距离依赖                │
│  → 瓶颈:O(n²) 显存,n越长越贵                  │
├─────────────────────────────────────────────────┤
│  SSM层:擅长线性长程依赖                         │
│  → 简单模式识别、长程记忆、归纳偏置              │
│  → 瓶颈:表达复杂推理关系不如Transformer        │
├─────────────────────────────────────────────────┤
│  混合目标:                                      │
│  → 用较少注意力层降低 KV Cache 与解码带宽         │
│  → 保留部分全局内容寻址、复制和 in-context 能力    │
│  → 质量、吞吐、首 Token 延迟需在目标任务上实测     │
└─────────────────────────────────────────────────┘
截至 2026-10-12 可核验的公开案例:
| 模型/报告 | 公开策略 | 可以得出的结论 |
|---|---|---|
| Jamba | 交错 Transformer、Mamba,并在部分层使用 MoE | 混合比例是质量、内存和吞吐的设计变量 |
| NVIDIA Mamba-2-Hybrid / Nemotron-H | 以 Mamba/Mamba-2 层为主,保留少量注意力层 | 公开消融显示纯 SSM 在复制、ICL 等任务上可能弱于混合模型 |
面试话术:
"SSM 与 Attention 的核心差异是历史信息的保存方式:Attention 保留可内容寻址的 KV,Mamba 把历史压缩进固定状态。混合架构用少量注意力层补足复制、检索和 ICL,用 SSM 层降低长输出时的状态与带宽成本。不能只比较大 O;还要在目标硬件上看 prefill、decode、batch、上下文长度和质量。对于未公开架构的闭源模型,我不会根据上下文长度或速度反推其内部实现。"
⭐ 面试加分项:
- 能画出Mamba block的结构图(SSM + 线性投影 + 激活函数)
- 理解Mamba的硬件感知并行性(通过并行扫描算法解决recurrence的并行难题)
- 区分“训练扫描近线性”和“自回归单步固定状态”,避免把两者混为一谈
- 知道 Mamba 的选择性主要体现在输入相关的离散化步长及 B、C 等参数;不要笼统写成所有状态矩阵都动态
七、推理高频考点:MHA、MQA、GQA 与 FlashAttention(Q11)
Q11: MQA/GQA 和 FlashAttention 都能加速注意力,它们解决的是同一个问题吗?
💡 答案要点
不是。MQA/GQA 改模型结构与 KV Cache 形状,FlashAttention 改同一注意力公式的执行算法。
| 方法 | Query 头 / KV 头 | 主要收益 | 主要代价 |
|---|---|---|---|
| MHA | H / H | 每个 Query 头有独立 K/V 表示 | KV Cache 最大 |
| GQA | H / G,且 1 < G < H | KV Cache 与解码带宽约缩小到 G/H | 共享 K/V 带来容量权衡 |
| MQA | H / 1 | KV Cache 最小、解码带宽低 | 共享最强,质量更依赖训练与任务 |
| FlashAttention | 不改变头数 | 分块、在线 softmax、重计算,减少 HBM 读写和中间张量 | 精确全注意力的 FLOPs 仍是二次;收益依赖硬件、形状和内核支持 |
单层 KV Cache(忽略量化、对齐和张量并行)的近似元素数:
2 × batch × sequence_length × num_kv_heads × head_dim
↑ K 和 V
因此排障要先判断瓶颈:
- 长输出 decode 内存带宽/KV 容量不足:优先看 GQA/MQA、KV 量化、分页管理和 batch 策略。
- 训练或 prefill 的注意力中间张量/HBM IO 过大:优先看 FlashAttention、变长批处理和 kernel 形状。
- 理论上下文变长但答案质量下降:这是位置外推、训练分布和检索能力问题,不能靠 FlashAttention 修复。
- 吞吐提升但单请求延迟没降:分别测 TTFT、TPOT、prefill/decode,不用单一 tokens/s 下结论。
面试话术:
"GQA/MQA 是模型侧减少 KV 头,直接缩小 KV Cache;FlashAttention 是系统侧用 IO-aware 分块精确计算同一个 softmax attention。两者正交,可以同时使用。FlashAttention 把中间存储降为随序列长度近线性,但没有把全注意力的算术复杂度从 O(n²) 变成 O(n)。"
长度外推排障框架
扩窗至少分四层验证:位置编码是否覆盖新长度、是否有足量长序列训练、注意力/KV 内核是否支持该形状、模型是否真正利用远端信息。评测同时覆盖长文本困惑度、位置分桶检索、精确复制、多跳问答和真实业务任务;只测“大海捞针”容易高估能力。
主要公开来源(截至 2026-10-12)参考
- Attention Is All You Need
- RoFormer / RoPE
- YaRN 与 LongRoPE
- Multi-Query Attention 与 Grouped-Query Attention
- FlashAttention、FlashAttention-2、FlashAttention-3
- Mamba、Mamba-2
- Jamba 公开技术报告 与 NVIDIA Mamba 混合架构实证研究
📝 更新记录
| 日期 | 更新内容 |
|---|---|
| 2026-10-12 | 核验 RoPE/长度外推、GQA/MQA、FlashAttention 与 SSM/Mamba;移除闭源架构猜测;新增 Q11 推理排障 |
| 2026-04-13 | 新增 Q10 Transformer+SSM混合架构(Mamba核心原理、2026年主流模型混合策略) |
| 2026-03-05 | 新增 Transformer 架构与注意力机制面试题 7 道 |