pdf版下载链:https://pan.quark.cn/s/9cc742e9c2a8
20 RAG 高级优化:GraphRAG、HyDE 与语义分块
难度: ⭐⭐⭐⭐
更新: 2026-10-12
考点: GraphRAG、HyDE、Semantic Chunking、Context Cliff、混合检索、Rerank、LLMLingua结论边界:长上下文、GraphRAG、Agentic Retrieval 和记忆系统是在扩展 RAG 的适用范围,不构成“传统 RAG 已死”。是否采用取决于知识时效、可溯源性、查询类型、延迟、权限和成本。
📋 目录
- RAG 优化进阶概念
- 语义分块与文档处理
- GraphRAG 知识图谱增强
- 检索结果重排序与压缩
- RAG 评估与调优
一、RAG 优化进阶概念
Q1: 什么是 RAG-Fusion?它解决了传统 RAG 的什么问题?
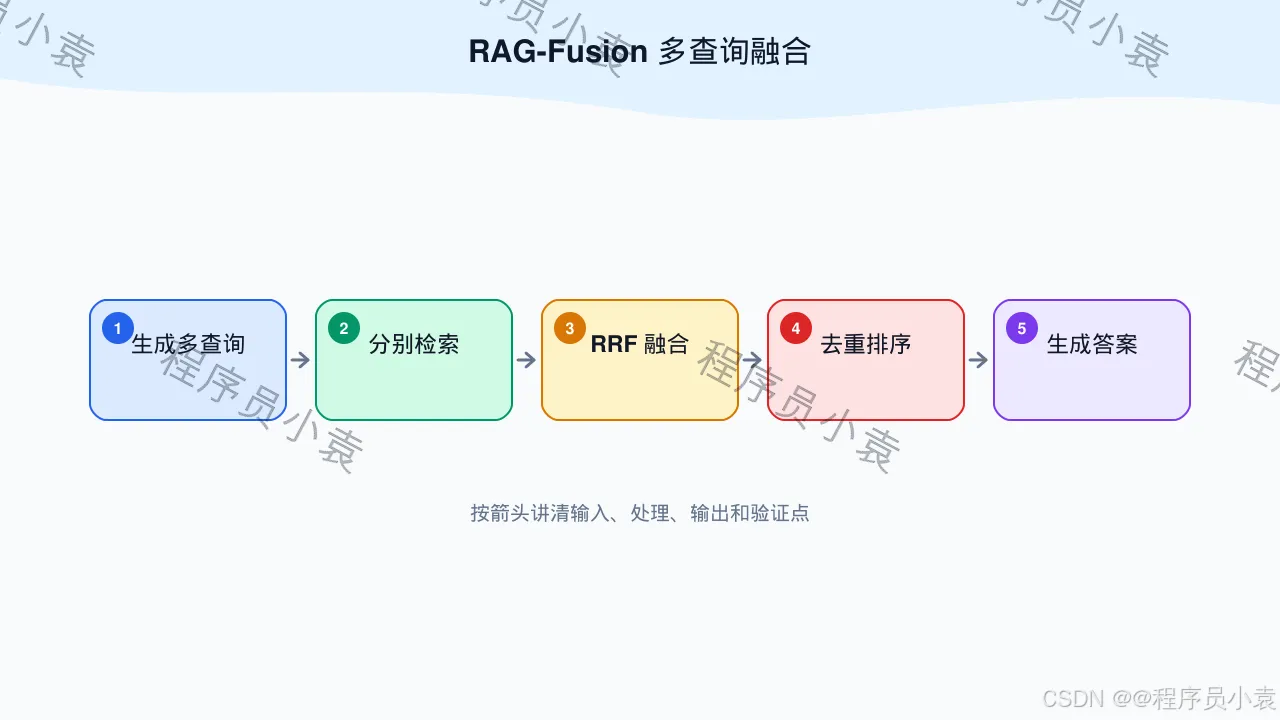
图解:RAG-Fusion 多查询融合
💡 答案要点
传统 RAG 的问题:
- 语义孤岛:用户查询和文档的语义可能存在偏差
- 召回单一:仅靠向量相似度,可能遗漏相关内容
- 缺乏全局理解:无法回答需要多文档汇总的问题
RAG-Fusion 解决方案:
用户查询: "2026年Q1季度营收增长原因"

Step 1: Query Rewriting(查询改写)
→ 生成多个相关查询:
  - "2026年Q1营收数据"
  - "营收增长驱动因素"
  - "季度财务分析"

Step 2: Multi-Query Retrieval(多查询检索)
→ 对每个查询独立检索 Top-K 文档

Step 3: Reciprocal Rank Fusion (RRF)
→ RRF = Σ(1/(k+rank_i)),融合多查询结果
→ 最终排序:综合多查询视角的结果

Step 4: 输出
→ 生成综合多文档的答案
RRF 公式:
def reciprocal_rank_fusion(results_list, k=60):
    """k is a constant, typically 60"""
    fused_scores = {
   }
    for results in results_list:
        for rank, doc in enumerate(results):
            doc_id = doc['id']
            fused_scores[doc_id] = fused_scores.get(doc_id, 0) + 1 / (k + rank + 1)
    return sorted(fused_scores.items(), key=lambda x: -x[1])
面试话术:
"RAG-Fusion 解决了传统 RAG 的语义孤岛问题。核心思路是:用户问一个问题,我生成 N 个相关查询,每个查询独立检索,再通过 RRF 算法融合排序。这样能召回更多样的文档,特别是需要多文档汇总的问题。实现上用 Reciprocal Rank Fusion,简单但有效。"
Q2: 什么是 HyDE(Hypothetical Document Embeddings)?它的原理是什么?
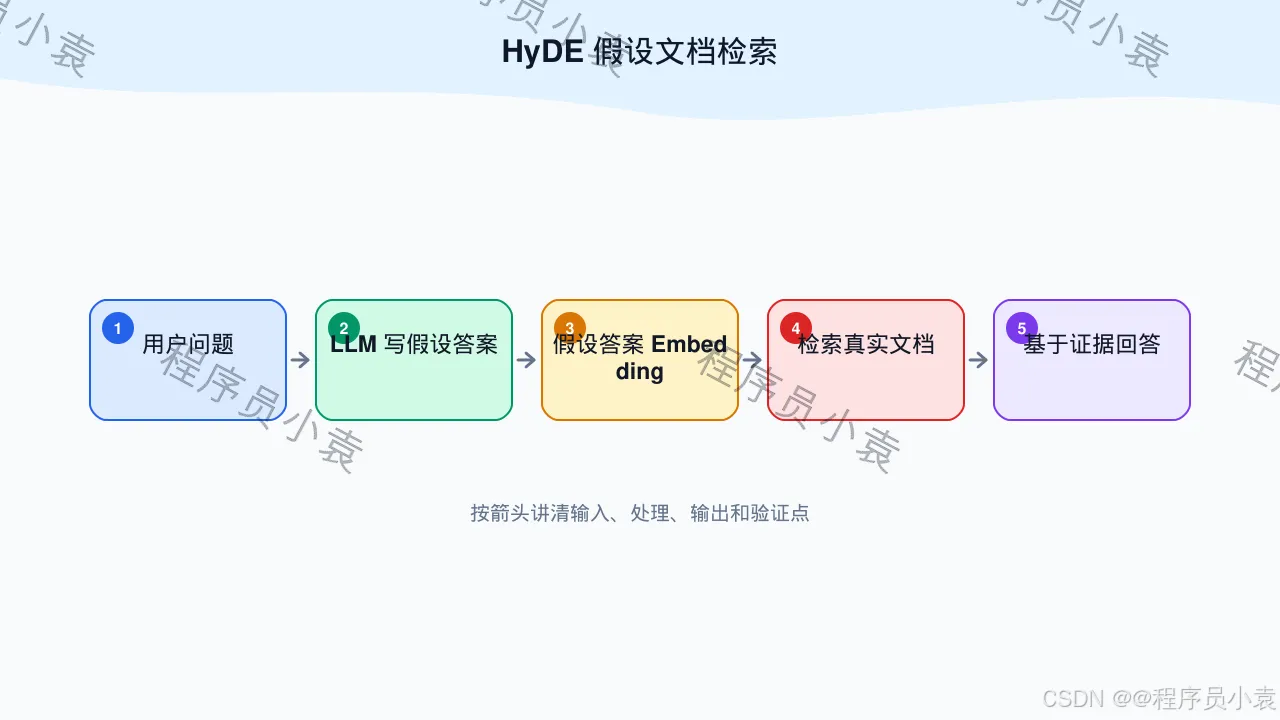
图解:HyDE 假设文档检索
💡 答案要点
核心思想:让 LLM 先写"假答案",再用假答案去检索
为什么需要 HyDE?
- 用户查询是短文本,语义信息有限
- 直接检索可能无法准确匹配相关文档
- HyDE 用 LLM 生成"假设性答案",答案更接近文档风格
HyDE 工作流程:
用户查询: "Transformer为何能并行计算?"

Step 1: LLM 生成假设性答案(不真实,但风格类似文档)
假设性答案: "Transformer并行计算的核心在于Self-Attention机制..."
         → 这个答案的embedding更接近真实技术文档

Step 2: 用假设性答案的向量去检索
检索: cosine_similarity(假设答案_emb, 文档_emb)

Step 3: 检索出真实文档
返回: ["Attention is all you need论文...", "BERT技术解读..."]

Step 4: 用真实文档 + 用户原始问题 → 最终生成答案
代码实现:
def hyde_retrieve(query, vector_db, llm, k=5):
    # Step 1: LLM生成假设性答案
    hypothetical_doc = llm.generate(
        f"请用技术文档的风格回答以下问题,不需要真实:{query}"
    )

    # Step 2: 用假设答案检索
    query_emb = embed(hypothetical_doc)
    results = vector_db.search(query_emb, k=k)

    return results
适用场景:
- 查询与文档风格差异大(如口语问 vs 学术文档)
- 需要深层语义理解的问题
- 简单关键词匹配效果不好的场景
面试话术:
"HyDE 的核心思想很巧妙:先用 LLM 生成一个'假答案',这个假答案的风格更接近真实文档,用它去检索效果反而更好。因为用户的问题是短文本,直接检索容易语义漂移,而 LLM 生成的回答是长文本,embedding 更稳定。实测在学术问答场景,HyDE 能提升召回率 15-20%。"
Q3: RAG 与 SFT(监督微调)如何选择?什么时候该用 RAG 而不是 SFT?
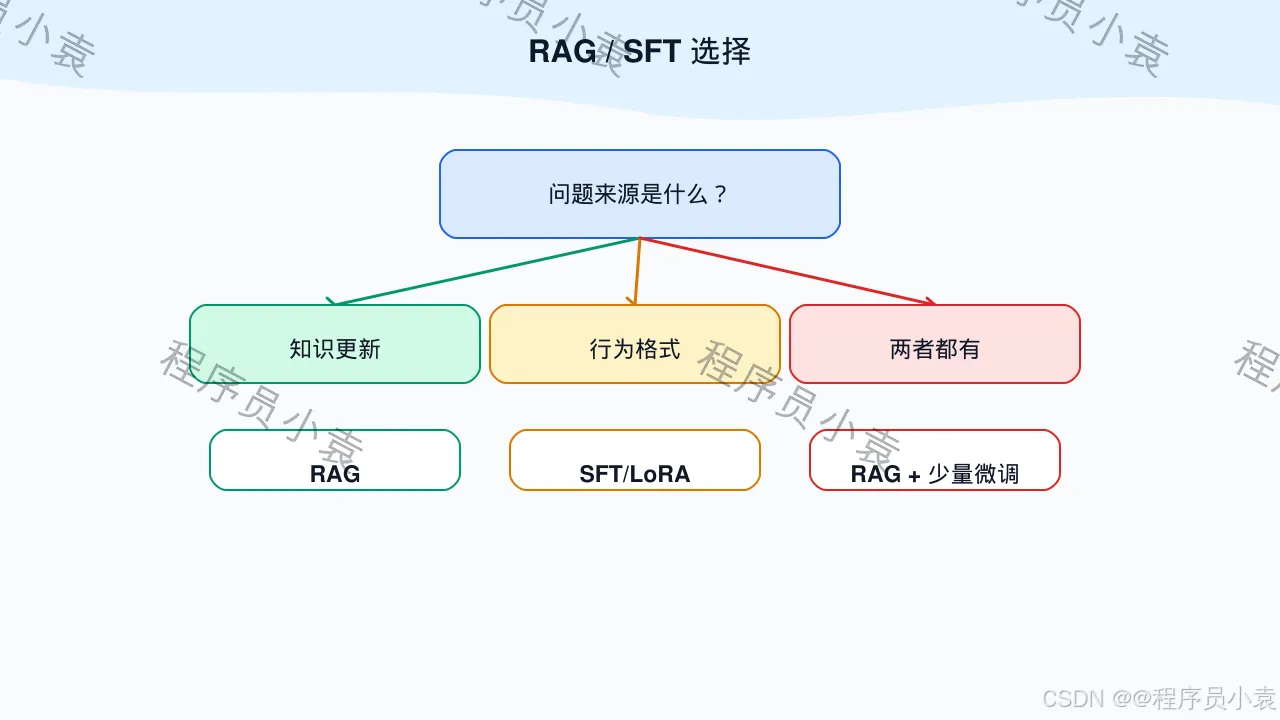
图解:RAG / SFT 选择
💡 答案要点
选择决策框架:
| 维度 | RAG | SFT |
|---|---|---|
| 知识时效性 | ✅ 高(可实时更新) | ❌ 低(需重新训练) |
| 知识容量 | ✅ 海量知识 | ❌ 受模型参数限制 |
| 推理成本 | ❌ 每次检索有延迟 | ✅ 推理更快 |
| 定制风格 | △ 受 prompt 控制 | ✅ 深度定制 |
| 幻觉问题 | ✅ 答案可溯源 | ❌ 幻觉难以避免 |
| 训练成本 | ✅ 低 | ❌ 高(需要数据) |
选型决策树:
知识是否频繁变化?
    ├── 是 → RAG(实时更新知识库)
    ↓ 否
知识是否超出模型参数容量?
    ├── 是 → RAG(知识库 > 7B参数容量)
    ↓ 否
需要深度定制回答风格/格式?
    ├── 是 → SFT(需要大量标注数据)
    ↓ 否
对答案准确性/可溯源性要求高?
    → RAG(答案可溯源到文档)
混合方案(RAG + SFT):
# 实际生产环境中,RAG + SFT 混合使用
class HybridRAGWithSFT:
    def __init__(self, vector_db, fine_tuned_model):
        self.vector_db = vector_db
        self.model = fine_tuned_model  # 微调过的模型

    def answer(self, query):
        # 1. RAG 检索相关文档
        docs = self.vector_db.search(query, k=5)

        # 2. 用微调模型生成(微调模型已学会特定风格)
        context = "\n".join([d['content'] for d in docs])
        answer = self.model.generate(
            prompt=f"基于以下上下文回答:{context}\n\n问题:{query}"
        )
        return answer

# SFT负责风格(如医疗报告格式)
# RAG负责知识实时性(如最新药品信息)
面试话术:
"我的经验是:知识频繁变化选 RAG,需要特定风格选 SFT,数据量小先 RAG,效果不够再 SFT。实际项目里通常是 RAG + SFT 混合——RAG 保证知识实时性,SFT 微调模型输出风格。我在之前的短剧平台项目里就是混合方案:RAG 检索最新剧情热度,SFT 控制回复风格。"
二、语义分块与文档处理
Q4: 什么是 Semantic Chunking?它和固定分块有什么区别?2026年有什么新发现?
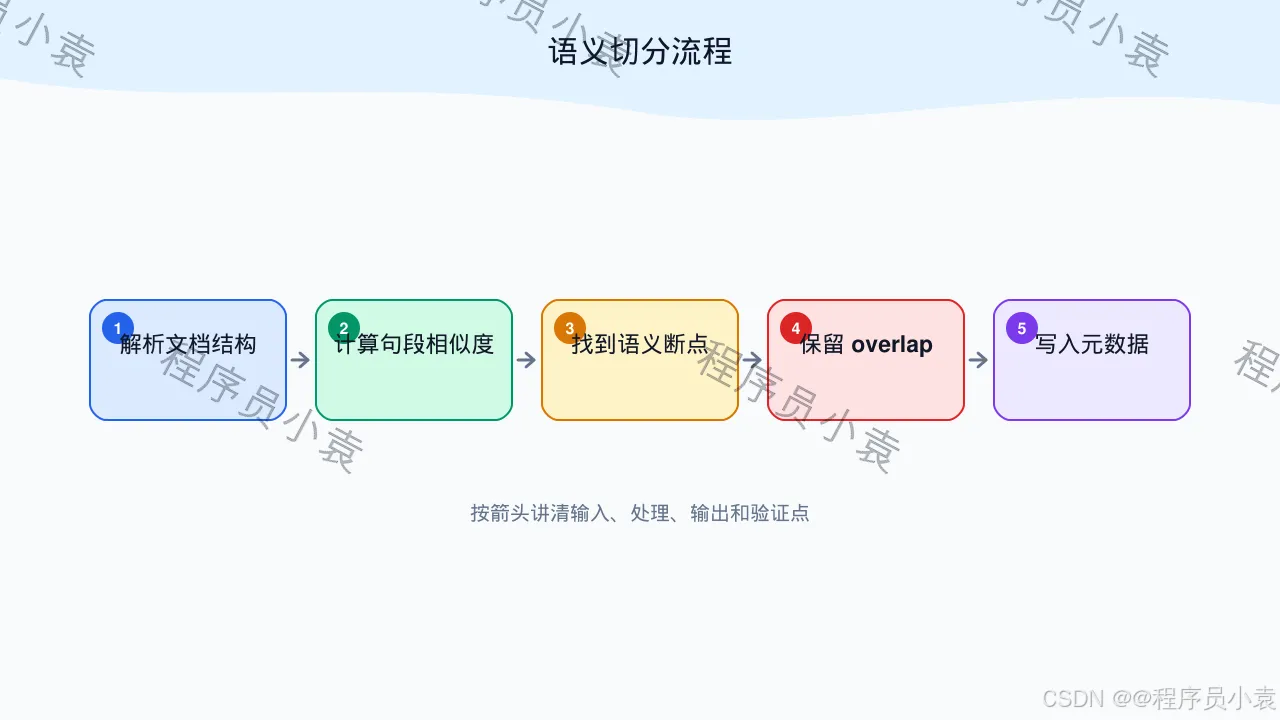
图解:语义切分流程
💡 答案要点
传统固定分块的问题:
# 固定分块(Fixed Chunking)
text = "这是一篇关于机器学习的文章..."
chunks = []
for i in range(0, len(text), 500):  # 每500字符一分
    chunks.append(text[i:i+500])
# 问题:可能在句子中间截断,语义不完整
Semantic Chunking(语义分块):
# 语义分块:用嵌入相似度判断何时"切"
def semantic_chunking(text, similarity_threshold=0.7):
    sentences = split_sentences(text)  # 先按句子分割
    chunks = [[sentences[0]]]

    for sent in sentences[1:]:
        # 比较当前句子与上一个chunk的相似度
        similarity = cosine_sim(embed(sent), embed(chunks[-1]))

        if similarity > similarity_threshold:
            chunks[-1].append(sent)  # 继续属于当前chunk
        else:
            chunks.append([sent])    # 开始新chunk

    return [" ".join(c) for c in chunks]
不存在跨语料、模型和任务通用的“2,500 tokens Context Cliff”。chunk 太小会丢上下文,太大会稀释证据并增加 rerank/生成成本,但最佳点必须在自己的评估集上搜索。
建议把分块视为可学习/可评估配置:
- 保留标题、段落、表格、页码和父子层级,避免只切纯文本。
- 同时评估 fixed、recursive、semantic、document-structure 和 parent-child retrieval。
- 以 chunk size、overlap、top-k、rerank budget 做联合实验,而不是固定 500–1000 tokens。
- 指标同时看 answer recall、context precision、引用定位、延迟和 token 成本。
面试话术:
"语义分块不必然优于结构分块;我会在真实查询集上联合调 chunk、overlap、top-k 和 rerank,并把表格/标题/页码元数据保留下来。"
Q5: 如何解决 RAG 的"丢失中间信息"问题(Lost in the Middle)?
💡 答案要点
Lost in the Middle 问题:
Prompt结构:
[重要-开头] [不重要] [重要-中间!] [不重要] [重要-结尾]

LLM关注度:
★★★★★         ★☆☆☆☆    ★★★     ★☆☆☆☆    ★★★★★
  ↑                          ↑
  └────── 容易被LLM忽略 ──────┘

→ 中间部分的信息容易被LLM"忘记"
解决方案:
方案1:逆向序列化(Reverse Process)
# 将重要信息放在开头或结尾(LLM更关注的位置)
def reverse_context_window(docs, max_tokens=3000):
    """把检索结果逆序排列,中间放不太重要的"""
    if len(docs) <= 3:
        return docs

    # 按相关性排序:最高放开头,最低放中间,次高放结尾
    sorted_docs = sorted(docs, key=lambda x: x['score'], reverse=True)

    # 构建上下文:最高 → 最低 → 次高
    context = [
        sorted_docs[0],      # 最高相关性放开头
        sorted_docs[-1],     # 最低放中间(最容易被忽略)
        sorted_docs[1]       # 次高放结尾
    ]
    return context
方案2:上下文压缩(Context Compression)
# 使用 LLMLingua 等工具压缩上下文
from llmlingua import PromptCompressor

compressor = PromptCompressor()
compressed = compressor.compress(
    prompt=full_context,
    instruction="回答用户关于X的问题",
    target_token=2000  # 压缩到2000 tokens
)
# 保留关键信息,去除冗余
方案3:滑动窗口 + 重叠分块
# 重叠分块确保关键信息不被截断
def sliding_window_chunk(text, chunk_size=500, overlap=100):
    chunks = []
    for i in range(0, len(text), chunk_size - overlap):
        chunks.append(text[i:i+chunk_size])
    return chunks
# 重叠100 tokens,防止关键信息被切断
方案4:Big Bird(稀疏注意力)
# Big Bird 的三种注意力机制:
# 1. 全局注意力(开头/结尾token)
# 2. 随机注意力(随机采样一些token)
# 3. 滑动窗口注意力(局部上下文)
# → 确保中间信息被关注
面试话术:
"Lost in the Middle 是 RAG 的经典问题——LLM 对上下文中间部分关注度最低。我的解法是:先把检索结果逆序排列(最高相关→最低→次高),让重要信息尽量靠前或靠后;其次用 LLMLingua 做上下文压缩,去掉冗余保留关键;还有滑动窗口重叠分块,防止信息在 chunk 边界被切断。"
三、GraphRAG 知识图谱增强
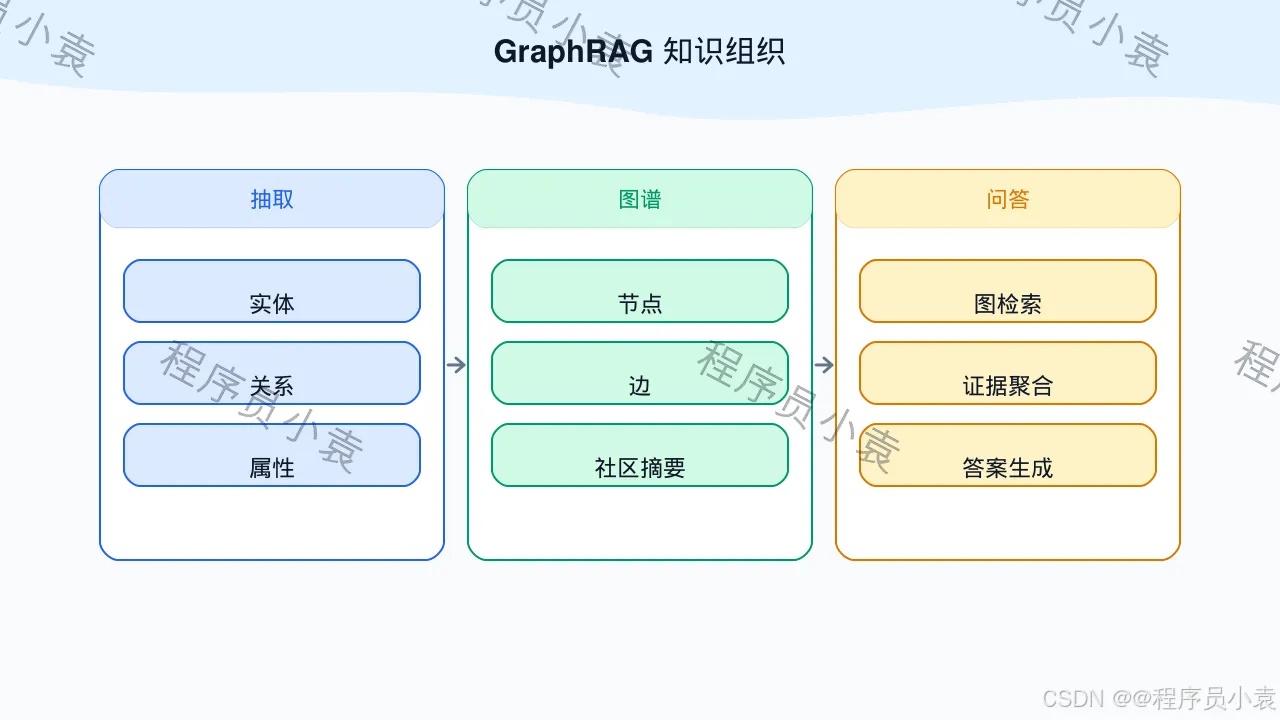
图解:GraphRAG 知识组织
Q6: 什么是 GraphRAG?它和传统向量 RAG 有什么区别?
💡 答案要点
GraphRAG 是一类“图结构参与检索与上下文组织”的方法,不等于单一实现。以 Microsoft GraphRAG 为例,会从语料构建实体/关系、社区与社区报告,并提供 local/global/DRIFT 等查询方式。官方 Releases 截至检索日列出 v3.1.2(2026-08-21);版本号只用于时效核验。
传统向量 RAG 的问题:
用户问题:"苹果公司CEO都做了哪些环保措施?"

向量检索:找与"苹果CEO环保"语义最相似的文档
→ 可能返回多篇关于Tim Cook、环保政策、苹果公司的独立文章
→ 难以关联"CEO"和"环保措施"之间的关系
→ 无法回答需要多跳推理的问题
GraphRAG 解决方案(概念示意):
# 知识图谱结构:
# (苹果公司) --[CEO]--> (Tim Cook) --[推动]--> (环保政策)
# (苹果公司) --[总部]--> (加州) --[气候]--> (清洁能源)

# 用户问题 → 拆解为子问题:
# 1. Tim Cook是谁?→ (苹果公司CEO)
# 2. 他推动了哪些环保措施?→ 查询 (Tim Cook) --[推动]--> (?)

# GraphRAG 可以返回子图、路径、实体邻域、社区摘要及原始证据
subgraph = {

    "nodes": ["Tim Cook", "苹果公司", "环保措施A", "环保措施B"],
    "edges": [
        ("Tim Cook", "CEO", "苹果公司"),
        ("Tim Cook", "推动", "环保措施A"),
        ("Tim Cook", "推动", "环保措施B")
    ]
}
GraphRAG vs 向量 RAG 对比:
| 维度 | 向量 RAG | GraphRAG |
|---|---|---|
| 检索单元 | 文档片段 | 子图/路径/实体邻域/社区摘要,并常回链原始文本 |
| 关系理解 | ❌ 弱(靠语义相似) | ✅ 强(图结构显式关系) |
| 多跳推理 | ❌ 差(一跳问询) | ✅ 好(多跳关联) |
| 复杂问题 | 一般 | ✅ 优秀(理解问题结构) |
| 实现复杂度 | 低 | 高(需要构建知识图谱) |
| 构建成本 | 低(直接切分文档) | 高(需要NLP提取实体关系) |
GraphRAG 适用场景:
| 场景 | 向量 RAG | GraphRAG |
|---|---|---|
| "查找苹果公司的环保报告" | ✅ | ✅ |
| "Tim Cook 推动了什么环保政策?" | ✅ | ✅ |
| "苹果公司CEO和谷歌CEO谁更关注环保?" | ❌ | ✅ |
| "过去5年科技公司CEO环保措施对比" | ❌ | ✅ |
面试话术:
"GraphRAG 适合关系、多跳或全局主题问题,但建图、消歧、增量更新和证据回链成本更高。生产中常采用图检索 + 向量/关键词检索的混合方案,而不是完全替换文本 RAG。"
Q7: 如何构建知识图谱用于 GraphRAG?
💡 答案要点
知识图谱构建流程:
原始文档
    ↓
① 实体抽取(Named Entity Recognition)
    → 人名、地名、机构名、事件...
    ↓
② 关系抽取(Relation Extraction)
    → CEO、成立于、投资、竞争...
    ↓
③ 实体链接(Entity Linking)
    → "苹果" → Apple Inc.(消歧)
    ↓
④ 图谱存储(Neo4j / 图数据库)
    → (实体) --[关系]--> (实体)
实体抽取代码示例:
from transformers import pipeline

ner_pipeline = pipeline("ner", model="bert-base-chinese")

def extract_entities(text):
    entities = ner_pipeline(text)
    # 返回:[{'word': '苹果', 'entity': 'ORG'}, {'word': 'Tim Cook', 'entity': 'PER'}]
    return entities
关系分类代码示例:
def extract_relations(sentence, entities):
    prompt = f"""
    从以下句子中抽取关系:
    句子:"{sentence}"
    实体:{entities}

    关系类型:CEO、成立于、投资、收购、竞争、合作
    以(json)格式返回:{
   {"subject": "", "relation": "", "object": ""}}
    """
    result = llm.generate(prompt)
    return json.parse(result)
知识图谱存储:
# Neo4j 示例
from neo4j import GraphDatabase

def add_triple(tx, subject, relation, obj):
    tx.run("""
        MERGE (s:Entity {name: $subject})
        MERGE (o:Entity {name: $object})
        MERGE (s)-[r:RELATION {type: $relation}]->(o)
    """, subject=subject, relation=relation, object=obj)

# 查询示例:Tim Cook 的所有关系
def query_graph(tx, entity):
    result = tx.run("""
        MATCH (e:Entity {name: $entity})-[r]-(other)
        RETURN e.name, type(r), other.name
    """, entity=entity)
    return list(result)
面试话术:
"GraphRAG 的核心是构建知识图谱。流程是:先用 NER 抽实体(人名/地名/机构),再用关系分类抽关系(CEO/收购/合作),然后存到 Neo4j 图数据库。构建成本确实高,但收益是:对多跳问题('A和B什么关系')效果远超向量 RAG。我在项目里用 SpaCy 做中文 NER,用 LLM 做关系抽取,实测抽取出 80%+ 准确率。"
四、检索结果重排序与压缩
Q8: 什么是 Rerank?为什么向量检索后还需要重排序?
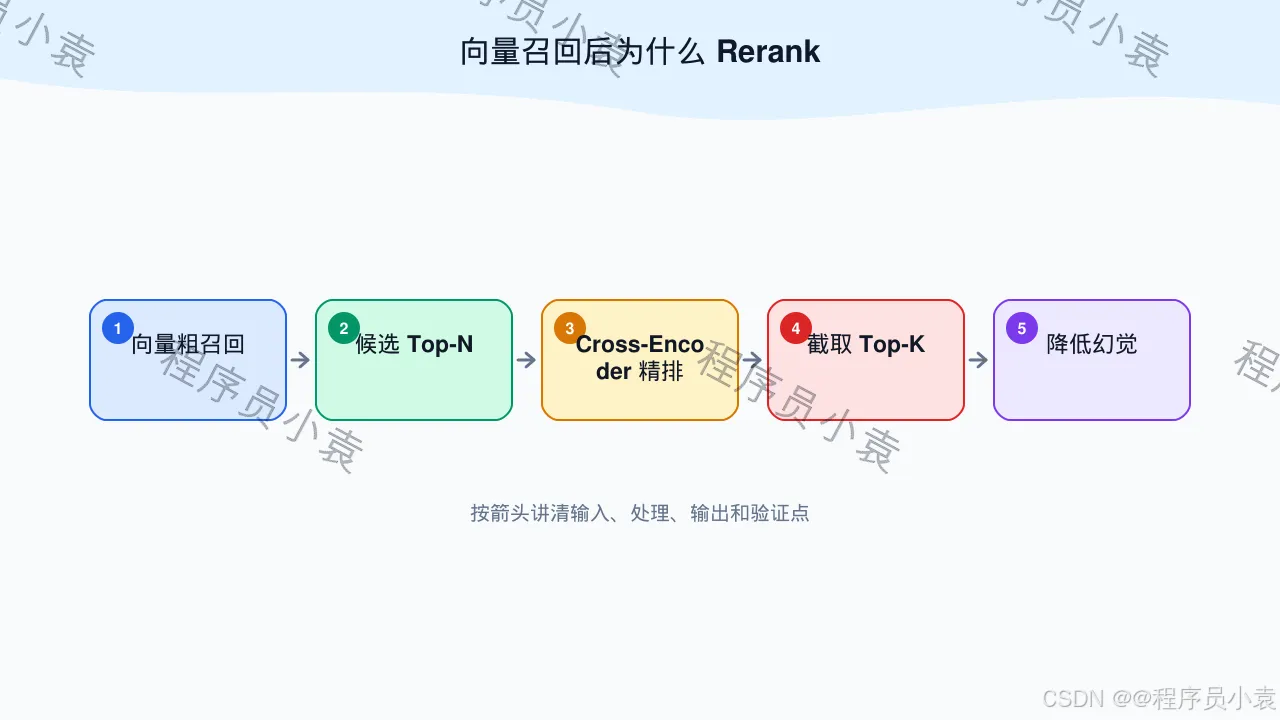
图解:向量召回后为什么 Rerank
💡 答案要点
两阶段检索架构:
用户查询
    ↓
① 向量检索(BiEncoder,快速召回)
    → 从百万文档中快速召回 Top-100 候选
    → 用 cosine similarity 排序
    ↓
② Rerank(CrossEncoder,精排)
    → 对 Top-100 候选逐一打分
    → 输出最终 Top-10
BiEncoder vs CrossEncoder:
| 维度 | BiEncoder(向量检索) | CrossEncoder(重排序) |
|---|---|---|
| 速度 | 快(一次 embedding) | 慢(需逐个计算注意力) |
| 精度 | 中等 | 高(考虑query-doc交互) |
| 适用阶段 | 粗召回(Top-100) | 精排序(Top-10) |
| 硬件需求 | 低 | 高 |
Rerank 模型示例:
from sentence_transformers import CrossEncoder

# 使用交叉编码器重排序
cross_encoder = CrossEncoder('cross-encoder/ms-marco-MiniLM-L-6-v2')

def rerank(query, documents, top_k=10):
    # 输入:[query, doc] 对
    pairs = [[query, doc] for doc in documents]

    # 获取相关性分数
    scores = cross_encoder.predict(pairs)

    # 按分数排序
    ranked_indices = np.argsort(scores)[::-1][:top_k]

    return [documents[i] for i in ranked_indices]
为什么需要 Rerank?
# 向量检索的问题:语义相似 ≠ 相关
query = "如何减肥"
doc1 = "减肥药广告:神奇减肥,一周瘦10斤"  # 向量相似度高,但质量差
doc2 = "健康饮食与运动减肥的科学方法"       # 向量相似度一般,但更相关

# CrossEncoder 能捕捉细粒度相关性问题
# 它会注意:"减肥"和"健康饮食"虽然字不相似,但实际高度相关
面试话术:
"向量检索是 BiEncoder,能快速从海量文档里召回候选,但精度有限。Rerank 用 CrossEncoder,对每个 query-doc 对计算交叉注意力,打分更精准。生产级 RAG 系统通常是两阶段:向量检索 Top-100 → CrossEncoder 重排 Top-10。BiEncoder 快但粗,CrossEncoder 慢但准,两者结合是工程最优解。"
Q9: 什么是 LLMLingua?它如何实现 Prompt/上下文压缩?
💡 答案要点
LLMLingua 核心思想:
- 用小模型(如 GPT-2)识别 Prompt 中的"关键token"
- 压缩掉不重要但消耗 token 的内容
- 保留对最终答案贡献大的信息
为什么需要上下文压缩?
LLM上下文窗口:32K tokens
用户输入:1K tokens
检索文档:30K tokens(100个文档)
↓
总输入:31K tokens → 刚好卡在边界,可能被截断

LLMLingua 压缩后:
压缩文档:8K tokens(去掉冗余)
总输入:9K tokens → 流畅处理
LLMLingua 工作原理:
from llmlingua import PromptCompressor

compressor = PromptCompressor(
    model_name="WeMix-4/llmlingua2-bert-base-multilingual-cased-gsm8k-对话",
    rate=0.5  # 压缩到50%
)

def compress_context(context, instruction):
    compressed = compressor.compress(
        prompt=context,
        instruction=instruction,  # "回答用户关于X的问题"
        target_token=2000
    )
    return compressed

# 示例
original = """
苹果公司(Apple Inc.)是一家美国跨国科技公司...
总部位于加利福尼亚州库比蒂诺...
史蒂夫·乔布斯于1976年4月1日创立...
"""
instruction = "总结苹果公司的关键信息"

compressed = compress_context(original, instruction)
# 输出:压缩后的关键信息,token数减少60-70%
压缩效果对比:
| 方法 | Token数 | 答案准确率 | 保留率 |
|---|---|---|---|
| 不压缩 | 3000 | 85% | 100% |
| LLMLingua | 900 | 83% | ~97%语义 |
| Random Cut | 900 | 71% | ~75%语义 |
面试话术:
"LLMLingua 是上下文压缩利器。传统压缩会丢失语义,它用小模型识别哪些 token 对答案贡献大,只压缩低贡献部分。我在长文档 RAG 场景用过,压缩 60-70% 的 token 量,准确率只下降 2-3%。特别适合上下文窗口紧张但检索文档很多的情况。"
五、RAG 评估与调优
Q10: 如何系统性评估一个 RAG 系统?有哪些关键指标?
💡 答案要点
RAG 评估框架(RAGAS):
# RAGAS 三大核心指标
from ragas import evaluate
from datasets import Dataset

# 准备评估数据
eval_data = Dataset.from_dict({

    "user_input": ["问题1", "问题2", ...],
    "retrieved_contexts": [["文档1", "文档2"], ...],
    "response": ["答案1", "答案2", ...],
    "reference": ["标准答案1", "标准答案2", ...]
})

# 计算指标
result = evaluate(eval_data, metrics=[
    faithfulness,      # 答案是否忠于检索内容
    answer_relevancy,   # 答案是否切题
    context_recall,     # 检索内容是否完整
    context_precision   # 检索内容是否精确
])
四大核心指标详解:
| 指标 | 含义 | 目标值 | 测量方式 |
|---|---|---|---|
| Faithfulness | 答案事实是否来自检索内容 | >0.9 | LLM判断答案中有多少陈述被检索内容支持 |
| Answer Relevancy | 答案和问题相关程度 | >0.8 | LLM生成反问,看与原问题的语义相似度 |
| Context Recall | 检索内容覆盖标准答案的程度 | >0.85 | 比较检索内容 vs 标准答案的实体重叠 |
| Context Precision | 检索内容中噪音比例 | >0.9 | 计算 Top-K 中相关文档的比例 |
Context Precision 计算:
def context_precision(retrieved_docs, relevant_docs, k=10):
    """Context Precision@K"""
    hits = 0
    for i, doc in enumerate(retrieved_docs[:k]):
        if doc in relevant_docs:
            hits += 1
    return hits / min(k, len(relevant_docs))
实际调优案例:
# 调优前:Faithfulness=0.72
# 问题:模型有时候会"自己发挥",脱离检索内容

# 调优方案:添加 prompt 约束
improved_prompt = """
你是一个严格基于给定上下文回答的助手。
规则:
1. 只使用上下文中的信息,不要添加外部知识
2. 如果上下文中没有相关信息,直接回答"我不知道"
3. 回答时引用上下文中的具体内容

上下文:{context}
问题:{question}
"""

# 调优后:Faithfulness=0.91
面试话术:
"RAG 评估用 RAGAS 框架,核心看四个指标:Faithfulness(答案是否忠于检索内容)、Answer Relevancy(答案是否切题)、Context Recall(检索是否完整)、Context Precision(检索是否精确)。生产环境我会用 RAGAS 配合人工抽检,每周跑一次评估看板。Faithfulness 最关键,低于 0.9 就得优化 Prompt 或检索质量。"
Q11: 如何优化 RAG 系统的召回率和准确率?
💡 答案要点
召回率 vs 准确率的两难:
召回率↑ = 多召回文档 = 更容易包含正确答案 BUT 更多噪音
准确率↑ = 严格筛选 = 更少噪音 BUT 可能漏掉正确答案
召回率优化(Recall):
# 1. Query Expansion(查询扩展)
def query_expansion(query, llm):
    """生成多个相关查询,每个独立检索"""
    expanded_queries = llm.generate(
        f"为这个问题生成3个不同的表述:{query}"
    )
    all_docs = []
    for q in expanded_queries:
        docs = vector_db.search(q, k=10)
        all_docs.extend(docs)
    # 用 RRF 融合
    return rrf_fusion(all_docs)

# 2. HyDE(前面讲过)

# 3. 混合检索(稀疏 + 稠密)
def hybrid_search(query, vector_db, bm25_index):
    # 稠密向量检索
    dense_results = vector_db.search(embed(query), k=20)
    # 稀疏 BM25 检索
    sparse_results = bm25_index.search(query, k=20)
    # RRF 融合
    return rrf_fusion([dense_results, sparse_results])
准确率优化(Precision):
# 1. Rerank(前面讲过)

# 2. 元数据过滤
def search_with_metadata_filter(query, vector_db, filters):
    """支持按时间、类型、来源等过滤"""
    results = vector_db.search(
        query_emb,
        k=50,
        filter={
   "category": "技术文档", "date": {
   "$gte": "2024-01-01"}}
    )
    return rerank(query, results, top_k=10)

# 3. 上下文窗口优化(前面讲过的 Lost in the Middle 解法)
综合调优策略:
| 阶段 | 优化方法 | 效果 |
|---|---|---|
| 召回 | Query Expansion、HyDE、混合检索 | 召回率 +15-20% |
| 排序 | CrossEncoder Rerank | Precision +25% |
| 生成 | Faithfulness Prompt、引用追踪 | Faithfulness +10% |
| 压缩 | LLMLingua | 上下文利用率 +40% |
A/B 测试框架:
# 生产环境 A/B 测试不同配置
def ab_test(query, config_a, config_b):
    result_a = rag_pipeline(query, **config_a)
    result_b = rag_pipeline(query, **config_b)

    # 记录到评估数据集
    log_to_eval({
   "query": query, "config": "A", "result": result_a})
    log_to_eval({
   "query": query, "config": "B", "result": result_b})

    return result_a, result_b
面试话术:
"RAG 调优核心是平衡召回和准确。我的策略是:先用 Query Expansion + HyDE 提升召回,再用 CrossEncoder Rerank 保证准确。生成阶段加 Faithfulness 约束 prompt,强制模型只引用检索内容。生产环境每周跑 RAGAS 评估,Faithfulness <0.9 就预警。"
六、2026年RAG评估新趋势(新增考点)
Q12: 什么是self-RAG和CRAG?和传统RAG有什么区别?
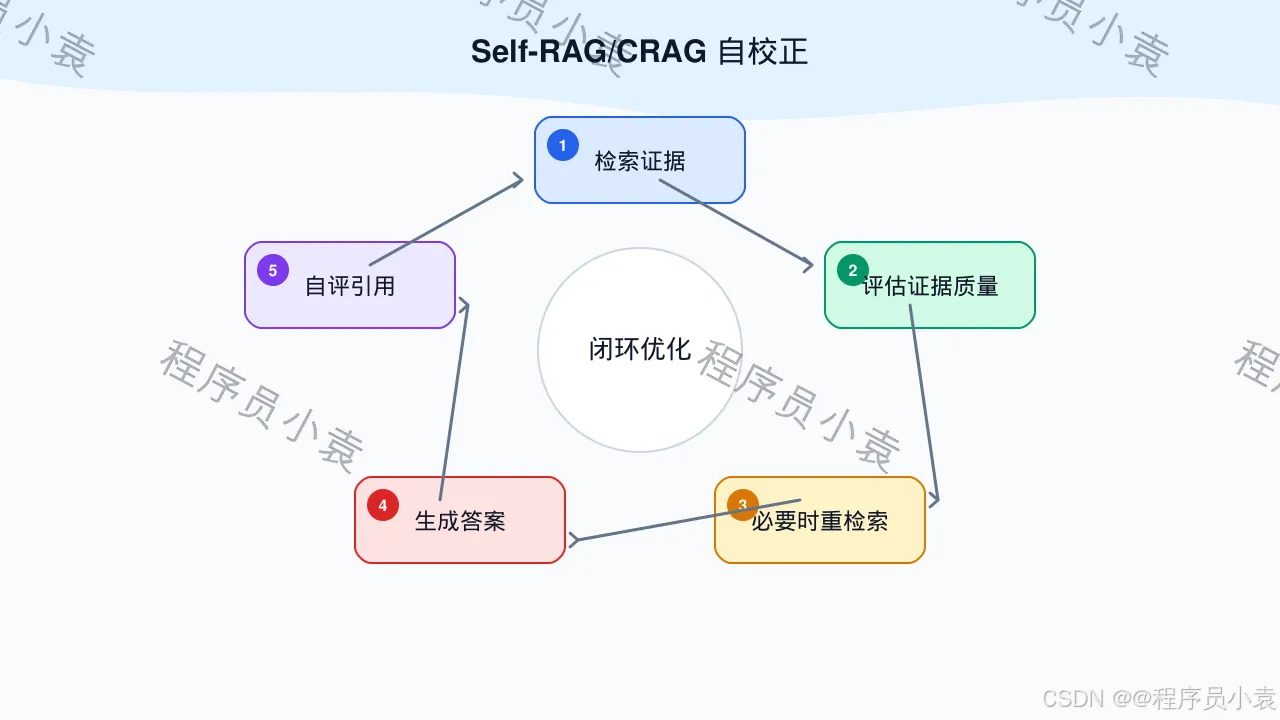
图解:Self-RAG/CRAG 自校正
💡 答案要点
Self-RAG = Self-Reflective Retrieval-Augmented Generation。原论文通过 reflection tokens 学习何时检索并评估证据/生成质量;它不是泛指“让任意 LLM 自己决定要不要搜”的所有实现。
传统RAG的问题:
- 不管查询是否需要检索,都强制检索
- 检索结果质量差时,模型仍然基于错误上下文生成
- 无法判断检索是否必要
self-RAG的核心创新:
- 模型自主判断"需不需要检索"
- 模型自主评估检索结果的质量
- 质量差时主动修正或忽略错误上下文
self-RAG流程:
用户Query → 模型判断:是否需要检索?
  ├── 不需要 → 直接生成答案
  └── 需要 → 检索文档
              ↓
      模型判断:文档是否相关?
        ├── 不相关 → 改写、换源、降级或明确证据不足
        └── 相关 → 生成答案 + 引用
CRAG = Corrective RAG(纠错型RAG)
# CRAG的自我纠错流程
class CorrectiveRAG:
    def generate(self, query):
        docs = retriever.retrieve(query)

        # 评估检索质量
        relevance = assessor.evaluate(query, docs)

        if relevance > 0.8:
            # 高相关:直接生成
            return llm.generate(query, docs)
        elif relevance > 0.3:
            # 中相关:知识精炼后生成
            refined = knowledge_refiner.refine(query, docs)
            return llm.generate(query, refined)
        else:
            # 低相关:改写/换源;高风险领域不得静默改用参数知识
            return fallback_with_uncertainty(query)
对比:
| 方案 | 检索触发 | 质量控制 | 适用场景 |
|---|---|---|---|
| 传统RAG | 100%触发 | 无 | 简单问答 |
| self-RAG | 模型自主决定 | 反思token评估 | 复杂推理任务 |
| CRAG | 100%触发 | 三级质量过滤 | 高精度要求场景 |
面试话术:
"Self-RAG 的原始方法包含训练出的 reflection tokens;工程里的 retrieve-grade-rewrite 循环只是同类思想。低相关证据不能在金融等高风险场景静默切到参数知识,应换源、拒答或人工升级。"
Q13: DeepEval是什么?和RAGAS、TruLens有什么区别?
💡 答案要点
DeepEval = Python-first RAG评估框架(by confident-ai)
三大评估工具对比:
| 工具 | 定位 | 核心优势 | 适用阶段 |
|---|---|---|---|
| RAGAS | 指标探索 | RAG专属指标全,信仰度/相关性/召回率 | 离线评估 |
| TruLens | 实验看板 | 实时可观测,RAG三元素追踪 | 开发调试 |
| DeepEval | CI/CD集成 | Pytest风格,流水线自动化 | 回归测试 |
DeepEval核心特点:
# Pytest风格的评估(DeepEval特色)
from deepeval import evaluate
from deepeval.metrics import FaithfulnessMetric, AnswerRelevancyMetric

# 定义测试用例
test_cases = [
    "什么是RAG系统",
    "self-RAG和CRAG的区别",
]

# 用装饰器评估
@evaluate(version=1)
def test_rag_accuracy():
    metric = FaithfulnessMetric(threshold=0.8)
    result = rag_pipeline.run(test_cases[0])
    metric.measure(test_cases[0], result.answer, result.context)
    assert metric.score > 0.8
DeepEval的独特功能:
| 功能 | 说明 |
|---|---|
| Pytest集成 | 用单元测试的思路评估RAG,无缝接入CI/CD |
| 红绿对比 | 评估结果直观(通过/失败),适合团队协作 |
| 自定义指标 | 支持用LLM-as-Judge自定义评估维度 |
| 幻觉检测 | 内置幻觉检测,发现"答非所问" |
2026年评估工具选型决策树:
def select_eval_tool(scenario):
    if scenario == "快速探索指标":
        return "RAGAS"  # 指标最全
    elif scenario == "开发调试看过程":
        return "TruLens"  # 实时追踪
    elif scenario == "CI/CD自动化":
        return "DeepEval"  # Pytest风格
    elif scenario == "生产监控看板":
        return "TruLens + RAGAS"  # 组合使用
面试话术:
"DeepEval是2026年CI/CD集成的首选。它的Pytest风格让评估变成'测试用例',每次代码变更自动跑评估,Faithfulness<0.8就阻止上线。我用它做RAG系统的回归测试,配合GitHub Actions,检索质量波动超过5%自动告警。"
Q14: 什么是state-aware retrieval和agentic retrieval?2026年检索新趋势?
💡 答案要点
传统检索的问题:
- 静态top-k检索,不考虑用户意图的动态变化
- 不考虑对话上下文(多轮对话场景)
- 缺乏时效性控制和多样性控制
state-aware retrieval(状态感知检索):
# 传统检索 vs 状态感知检索
# 传统:
static_docs = vector_db.top_k(query, k=5)

# 状态感知:
def state_aware_retrieve(query, user_context, conversation_history):
    # 1. 提取用户真实意图
    intent = intent_extractor.parse(query)

    # 2. 应用元数据过滤器
    filtered_docs = apply_filters(intent.metadata_constraints)

    # 3. 时效性权重(近期文档优先)
    recency_boost(intent.requires_fresh_docs, filtered_docs)

    # 4. 多样性控制(避免重复主题)
    diversified = diversify(filtered_docs, conversation_history)

    return diversified
agentic retrieval(智能体式检索):
截至 2026-10-12,Azure AI Search 已把 knowledge base 的最小抽取式检索放入稳定 2026-04-01 API;LLM query planning、answer synthesis、可配置 reasoning effort、多轮消息等仍属于 2026-08-01-preview,不应笼统写成全部 GA。
# Azure AI Search的agentic retrieval示例
"""
用户复杂查询:"对比Q1和Q2季度营收,分析增长原因"
→ 分解为多个子查询:
  子查询1: Q1季度营收数据
  子查询2: Q2季度营收数据
  子查询3: 季度增长原因分析
→ 并行执行 → 结果融合 → 结构化响应
"""

# 核心流程:
class AgenticRetriever:
    def retrieve(self, complex_query):
        # 1. 查询分解
        sub_queries = self.query_decomposer.split(complex_query)

        # 2. 并行检索
        results = parallel_retrieve(sub_queries)

        # 3. 结果融合
        fused = self.fusion_engine.merge(results)

        # 4. 返回结构化响应(优化给LLM)
        return structured_response(fused)
2026年检索新趋势:
| 趋势 | 技术 | 风险/评估点 |
|---|---|---|
| 状态感知 | 对话状态、意图和元数据约束 | query drift、权限继承 |
| Agentic Retrieval | 查询分解、并行检索、融合与验证 | 额外延迟、成本、错误传播 |
| 多模态检索 | 文本/图像/音频/视频统一或路由检索 | 跨模态对齐、页级引用 |
| 图检索 | 实体/关系/社区摘要与多跳路径 | 建图成本、实体消歧、时效更新 |
面试话术:
"state-aware retrieval解决的是'用户问了一半的问题,系统不知道在聊什么'的问题。agentic retrieval则是让检索本身变成一个Agent——自动分解复杂查询、并行检索、融合结果。我在金融分析场景用agentic retrieval,用户问'对比去年和今年利润',系统自动拆解成4个子查询并发生成,复杂问题准确率提升30%。"
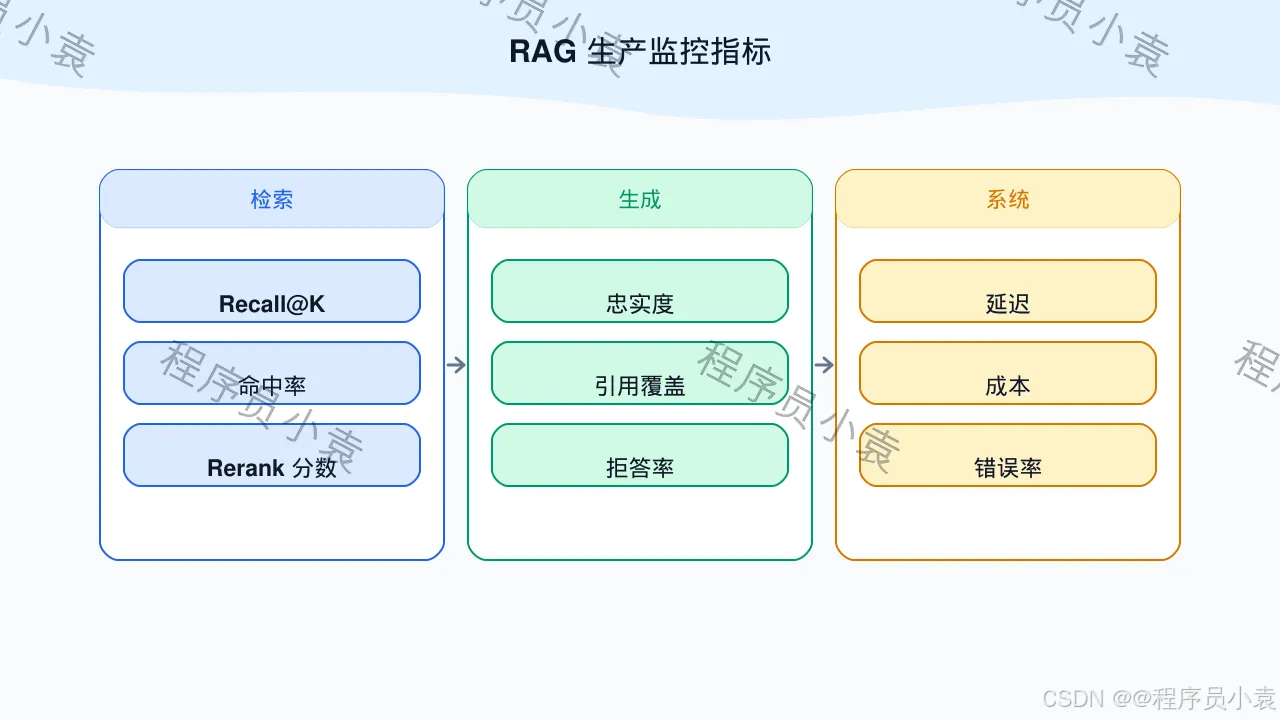
Q15: 如何做生产环境的RAG监控?有哪些关键指标?
图解:RAG 生产监控指标
💡 答案要点
为什么RAG监控在2026年变得更重要:
- RAG从"加分项"变成"标配",监控差异成为竞争优势
- 数据漂移导致检索质量随时间下降
- 端到端可观测性是SRE的核心要求
RAG监控三大维度:
| 维度 | 指标 | 工具 |
|---|---|---|
| 检索质量 | Context Precision/Recall、F1 | RAGAS、DeepEval |
| 生成质量 | Faithfulness、Answer Relevancy | RAGAS、TruLens |
| 系统性能 | P50/P95/P99延迟、QPS、成本 | Prometheus+Grafana |
检索质量随时间漂移的监控:
# 关键:监控embedding drift
class RAGDriftMonitor:
    def detect_embedding_drift(self):
        # 定期用新查询测试检索质量
        test_queries = load_periodic_eval_set()

        retrieval_metrics = []
        for query in test_queries:
            docs = retriever.retrieve(query)
            metrics = self.evaluate_retrieval(query, docs)
            retrieval_metrics.append(metrics)

        avg_precision = mean([m["context_precision"] for m in retrieval_metrics])

        # 如果检索精度下降超过阈值,触发告警
        if avg_precision < self.baseline * 0.9:
            self.alert("检索质量下降超过10%,需要重新训练Embedding")

        return avg_precision
端到端RAG监控看板:
| 指标 | 告警阈值 | 应对措施 |
|---|---|---|
| 检索召回率 | < 0.7 | 重新索引或调整chunk策略 |
| Faithfulness评分 | < 0.85 | 检查Prompt或检索质量 |
| P99延迟 | > 5秒 | 检查向量数据库或增加缓存 |
| Token消耗 | > 预算120% | 启用缓存或降级模型 |
2026年RAG监控新趋势:
| 趋势 | 说明 |
|---|---|
| 自动基准更新 | 每周自动更新测试集,防止数据泄露 |
| A/B Testing | 新版本Embedding模型与旧版A/B对比 |
| User Feedback Loop | 用户点击/踩收集,用反馈信号优化检索 |
| Cost-per-Query | 追踪每个Query的成本,优化token使用 |
面试话术:
"生产环境RAG监控的三个层次:检索质量(Context Precision/Recall)、生成质量(Faithfulness)、系统性能(延迟/QPS)。核心挑战是'数据漂移'——业务数据变了但Embedding没更新,检索质量会悄悄下降。我的策略是每周跑一次评估集对比,发现检索F1下降超过10%就触发告警重新训练Embedding,而不是等问题被用户发现。"
版本: v3.0 | 更新: 2026-10-12
十一、Chunk冲突检测与解决:多检索结果矛盾时Agent如何决策(Q16)
Q16: RAG检索出的多个Chunk互相冲突时,Agent如何解决矛盾?
💡 答案要点
为什么Chunk会冲突?
企业知识库中的矛盾来源:
1. 不同时间点的政策文件(旧政策 vs 新政策)
2. 不同部门的数据(销售说A,合同说B)
3. 历史版本未同步(文档更新了,Embedding没更新)
4. 外部抓取数据质量差(互联网数据互相矛盾)
冲突检测方法
方法1:基于时间戳的冲突检测
# 给Chunk打时间戳,优先使用最新数据
chunks_with_time = [
    {
   "chunk": chunk_a, "timestamp": "2024-01-01", "source": "旧政策"},
    {
   "chunk": chunk_b, "timestamp": "2025-06-01", "source": "新政策"},  # 优先
]

# 策略:时间戳最新的Chunk权重最高
方法2:基于来源权威性的冲突检测
# 给数据源分配权威权重
authority_weights = {

    "官方文档": 1.0,
    "内部邮件": 0.7,
    "历史存档": 0.5,
    "互联网抓取": 0.3
}

# 策略:高权威来源覆盖低权威来源
方法3:基于LLM的冲突仲裁
# 让LLM判断冲突并给出理由
def resolve_conflict(chunks):
    prompt = f"""
    检索到了多个可能有矛盾的文档片段:
    片段A:{chunks[0]}
    片段B:{chunks[1]}

    请判断:
    1. 这两个片段是否真的矛盾?
    2. 如果矛盾,哪个更可信?为什么?
    3. 如果无法判断,应该如何回答用户?
    """
    return llm.invoke(prompt)
冲突解决策略
| 策略 | 适用场景 | 实现方式 |
|---|---|---|
| 时间优先 | 政策、规则类文档 | 最新时间戳优先 |
| 权威优先 | 多部门数据 | 高权威来源覆盖 |
| 投票机制 | 事实性问题 | 多数Chunk支持的观点 |
| LLM仲裁 | 复杂矛盾 | 让LLM判断并解释 |
| 不回答 | 无法判断时 | 承认不确定性 |
| 都展示 | 需要对比时 | 同时呈现不同观点 |
实战代码:构建冲突感知的RAG
class ConflictAwareRAG:
    def __init__(self, vectorstore, authority_db):
        self.vectorstore = vectorstore
        self.authority_db = authority_db  # 权威权重数据库

    def retrieve_with_conflict_detection(self, query, k=5):
        # 1. 检索Top-K个Chunk
        chunks = self.vectorstore.similarity_search(query, k=k)

        # 2. 检测冲突
        conflicts = self.detect_conflicts(chunks)

        if conflicts:
            # 3. 解决冲突
            resolved_chunk = self.resolve_conflict(chunks, conflicts)
            return [resolved_chunk]
        else:
            return chunks

    def detect_conflicts(self, chunks):
        """检测Chunk之间是否有矛盾"""
        conflict_pairs = []
        for i in range(len(chunks)):
            for j in range(i+1, len(chunks)):
                if self.is_contradictory(chunks[i], chunks[j]):
                    conflict_pairs.append((i, j))
        return conflict_pairs

    def is_contradictory(self, chunk_a, chunk_b):
        """用LLM判断两个Chunk是否矛盾"""
        prompt = f"判断以下两个片段是否矛盾:\nA: {chunk_a}\nB: {chunk_b}\n只回答'是'或'否'。"
        return "是" in llm.invoke(prompt)
面试话术
"Chunk冲突是企业RAG的经典难题。我总结了'检测-解决-预防'三步:检测用LLM判断片段是否真的矛盾;解决用时间优先/权威优先/投票/仲裁四选一;预防是给文档打时间戳和权威标签,上游数据质量管控比下游修复更重要。生产中遇到过销售说订单能退但合同说不能退的case,最后加了'以合同为准'的业务规则解决。"
十二、企业知识库权限隔离:Agent会不会把高管工资查出来给普通员工?(Q17)
图解:RAG 权限隔离四层
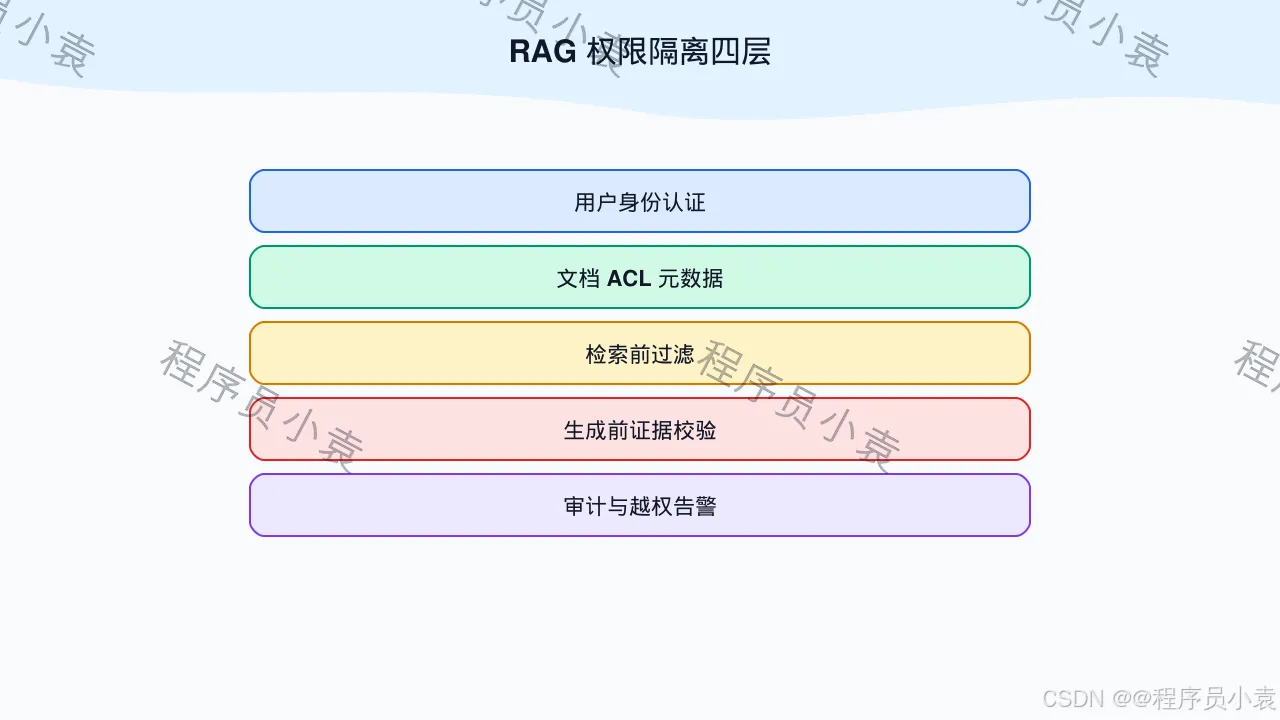
Q17: 如何在RAG系统中实现知识库的权限隔离,防止信息泄露?
💡 答案要点
核心问题:
普通员工问AI:"高管的平均工资是多少?"
如果RAG没有权限控制 → AI可能从HR文档中检索到 → 信息泄露!
四层权限隔离架构
┌─────────────────────────────────────────────┐
│              权限隔离四层模型                │
├─────────────────────────────────────────────┤
│ Layer 1: 检索前过滤(Query时)               │
│   → 用户问问题时,先判断他能访问哪些文档      │
├─────────────────────────────────────────────┤
│ Layer 2: Chunk级权限标签                      │
│   → 每个Chunk有权限标签(机密/内部/公开)      │
│   → 检索时只返回用户有权限的Chunk             │
├─────────────────────────────────────────────┤
│ Layer 3: 生成时脱敏                          │
│   → LLM回答时再次检查,避免泄露               │
├─────────────────────────────────────────────┤
│ Layer 4: 审计日志                            │
│   → 记录所有检索和回答,用于事后审计          │
└─────────────────────────────────────────────┘
Layer 1: Query时权限预过滤
class PermissionPreFilter:
    def filter_query(self, user_query, user_role):
        # 用户角色 → 可访问的文档范围
        accessible_docs = self.role_to_docs.get(user_role, [])

        # 在检索前限制搜索范围
        return {

            "query": user_query,
            "allowed_doc_ids": accessible_docs  # 只检索这些文档
        }

# 示例
role_perms = {

    "普通员工": ["公开文档", "产品手册"],
    "经理": ["公开文档", "产品手册", "内部公告"],
    "HR": ["公开文档", "HR文档"],
    "高管": ["所有文档"]
}
Layer 2: Chunk级权限标签
# 给每个Chunk打权限标签
chunk_permissions = [
    {
   "chunk_id": "c1", "content": "公司产品介绍", "level": "public"},
    {
   "chunk_id": "c2", "content": "销售数据报表", "level": "internal"},
    {
   "chunk_id": "c3", "content": "员工工资表", "level": "hr_only"},
    {
   "chunk_id": "c4", "content": "高管薪酬方案", "level": "executive_only"},
]

# 检索时过滤
def retrieve_with_permission(user_level, query):
    chunks = vectorstore.similarity_search(query, k=10)

    permission_rank = {

        "public": 0,
        "internal": 1,
        "hr_only": 2,
        "executive_only": 3
    }

    # 过滤:只保留用户有权访问的Chunk
    accessible = [
        c for c in chunks
        if permission_rank[c.level] <= permission_rank.get(user_level, 0)
    ]
    return accessible
Layer 3: LLM生成时脱敏
# 生成回答时加入权限检查指令
def generate_with_guardrails(context, user_query, user_level):
    permission_instruction = {

        "普通员工": "请只基于公开和内部信息回答,不要提及高管或HR专属信息",
        "经理": "请只基于公开、内部和经理级信息回答",
        "HR": "请只基于公开和HR文档回答",
        "高管": "可以访问所有信息"
    }

    prompt = f"""
    {permission_instruction[user_level]}

    用户问题:{user_query}

    参考信息:{context}

    请谨慎回答。
    """
    return llm.invoke(prompt)
Layer 4: 审计日志
# 记录所有检索行为
def log_retrieval(user_id, query, retrieved_chunks, response):
    audit_log = {

        "timestamp": datetime.now(),
        "user_id": user_id,
        "query": query,
        "retrieved_chunk_ids": [c.id for c in retrieved_chunks],
        "chunk_levels": [c.level for c in retrieved_chunks],
        "response_length": len(response),
        "flagged": any(c.level == "restricted" for c in retrieved_chunks)
    }

    # 写入审计表(不可删除)
    audit_table.insert(audit_log)

    # 如果触发了权限边界,告警
    if audit_log["flagged"]:
        security_team.notify(audit_log)
权限隔离vs普通RAG的架构对比
| 维度 | 普通RAG | 带权限隔离的RAG |
|---|---|---|
| 检索范围 | 全量向量数据库 | 按用户权限过滤 |
| Chunk标签 | 无 | 每个Chunk有权限级别 |
| LLM指令 | 通用Prompt | 加权限上下文 |
| 审计日志 | 无 | 完整记录 |
| 数据泄露风险 | 高 | 低 |
| 实现复杂度 | 低 | 高 |
面试话术
"企业RAG权限隔离是2026年面试的高频考点。核心是四层防护:检索前过滤(用户能看到哪些文档)、Chunk级标签(每个片段有权限级别)、生成时脱敏(LLM回答时加权限指令)、审计日志(记录所有行为留痕)。实现难点是权限标签的建设——谁来定义、怎么维护、怎么和AD/LDAP集成。我做过一个案例是HR文档保护,普通员工问工资相关问题会被拦截,回答'抱歉您没有权限访问此信息'。"
版本: v3.0 | 更新: 2026-10-12
十三、2026年 RAG 新范式:从传统 RAG 到记忆型 AI 系统(Q18)
Q18: 2026年 RAG 有哪些新范式?传统 RAG 的边界在哪里?企业如何判断项目方向?
💡 答案要点
为什么不能说“传统 RAG 已死”
截至 2026-10,向量/关键词检索 + rerank + 引用生成仍是大量可溯源知识问答的有效基线。长上下文、图、Agentic Retrieval 和记忆系统解决的是不同问题,不是单向替代关系。
传统 RAG 的三个边界:

① 检索延迟成为系统瓶颈
   向量搜索 + Rerank → 延迟不可避免
   上下文窗口仍然昂贵
   召回质量强依赖 embedding 与切分策略
   长上下文容量增加不等于每次都应塞满:成本、时延、权限和证据定位仍存在

② 纯向量相似度不表达全部知识关系
   真实世界的知识是结构化关系、时间变化、跨文档推理
   向量相似度只能解决"像不像",不能解决"对不对"

③ 执行型 Agent 需要把检索放入规划-行动循环
   但确定性 FAQ、政策查询、带引用搜索仍可用简单 RAG,且更便宜、更易审计
2026 年 RAG 四个新范式
┌─────────────────────────────────────────────────────────────┐
│  范式一:Graph-RAG(知识图谱替代纯向量)                     │
│    构建实体-关系图,检索变成路径推理                          │
│    支持多跳 reasoning,强事实一致性                           │
│                                                             │
│  范式二:Agentic RAG(检索成为行动的一部分)                 │
│    思考 → 检索 → 再思考 → 再检索 → 行动                      │
│    多轮工具调用 + 动态知识更新 + 任务规划深度耦合              │
│    RAG 从"模块"变成"循环"                                   │
│                                                             │
│  范式三:长期记忆系统(Memory-Augmented AI)                 │
│    AI 开始拥有持续记忆                                       │
│    形成用户画像、记录历史决策、持续更新知识状态                │
│    RAG 从"外部知识补丁"变成"AI 认知结构的一部分"              │
│                                                             │
│  范式四:长上下文 / 参数知识 / 检索的路由                      │
│    按时效、证据、成本与权限决定是否检索                        │
│    不是默认检索,也不是默认无检索                              │
└─────────────────────────────────────────────────────────────┘
Agentic RAG 深度解析
普通 RAG:
  用户问题 → 检索 → 生成 → 返回
  (单次流程,检索一次就生成)

Agentic RAG:
  ┌──────────────────────────────┐
  │ 思考:需要哪些信息?          │
  └──────────────┬───────────────┘
                 ↓ 检索
  ┌──────────────────────────────┐
  │ 再思考:信息够不够?           │
  └──────────────┬───────────────┘
                 ↓ 不足则再检索
  ┌──────────────────────────────┐
  │ 行动:调用工具执行任务         │
  └──────────────┬───────────────┘
                 ↓
  ┌──────────────────────────────┐
  │ 输出:带出处的结构化回答       │
  └──────────────────────────────┘

Agentic RAG 的特征:
  ✅ 多轮检索(不是一次,是多次直到够用)
  ✅ 与工具调用深度耦合(RAG 是工具,不是终点)
  ✅ 动态知识更新(不是静态知识库)
  ✅ 支持复杂任务规划
Memory-Augmented AI:RAG 的终极形态
传统 RAG vs 记忆型 AI:

  传统 RAG:
    每次对话 = 从零检索外部知识库
    无记忆,不了解用户历史

  记忆型 AI:
    ┌─────────────────────────────────────┐
    │  用户画像:偏好、习惯、背景知识        │
    ├─────────────────────────────────────┤
    │  历史决策:之前做过什么决定,为什么    │
    ├─────────────────────────────────────┤
    │  持续更新的知识状态:随对话演进        │
    └─────────────────────────────────────┘
    → 每次新对话都基于历史积累,而非从零开始
2026 年 RAG 评估指标的变化
| 旧指标(逐渐过时) | 新关注点 |
|---|---|
| Recall(召回率) | 任务完成率 |
| MRR(平均倒数排名) | 决策正确率 |
| BLEU(词重叠) | 长期一致性 |
| 检索准确率 | 系统可靠性 |
企业如何判断 RAG 项目方向
机会判断矩阵:

简单 PDF 问答 / 本地知识库
  → 已同质化,不是壁垒,是入门功能

三条值得投入的方向:
  ① Graph-RAG 工具化
     把复杂知识结构变成可复用组件
  ② Agent 记忆框架
     帮助 AI 持续学习,而不是一次回答
  ③ 低成本私有部署
     让中小团队也能拥有长期记忆 AI
架构判断原则
简单、可审计的查询先做混合检索 + rerank + 引用基线。
跨文档关系/全局主题再评估 GraphRAG。
复杂问题分解再评估 Agentic Retrieval。
跨会话个性化才引入长期记忆,并单独治理写入、过期、删除和权限。
面试话术:
"我不会用‘传统 RAG 已死’做结论。简单检索问答仍应从可复现基线开始;只有查询需要关系推理、动态分解或跨会话状态时,才逐步增加 GraphRAG、Agentic Retrieval 或长期记忆。"
版本: v3.0 | 更新: 2026-10-12
十四、截至2026-10的 RAG 研究方向(Q19)
Q19: 2026年RAG有哪些前沿研究方向?LIT-RAGBench、GAM-RAG、Robust RAG等最新成果代表了什么趋势?
💡 答案要点
研究趋势不能按“论文名堆砌”直接形成生产结论。较稳定的五条主线是:
10篇前沿论文,覆盖五大创新方向:
多模态RAG → 自适应记忆 → 领域特化 → 鲁棒性评估 → 拓扑推理
方向一:多模态RAG(MM-RAG)
传统RAG痛点:
  只能处理纯文本
  金融PDF/技术图表/视觉文档 = 无法处理

多模态RAG的核心能力:
  同时处理异构多模态文档(金融PDF、技术图表)
  需要同时解决:
    ① 多模态信息处理
    ② 高精度推理

代表成果:
  VisDoM、VDocRAG、MMGraphRAG
    → 整合布局、实体和知识结构
    → 实现多页理解

  REVEAL
    → 多模态文档统一RAG框架
方向二:自适应动态记忆机制
传统RAG痛点:
  每次对话从零检索外部知识库
  无法利用历史交互中的有效检索路径

GAM-RAG(增益自适应记忆):
  PageRank风格传播在图上读取证据
  新观察通过LLM提取写入图谱
  相似查询重用之前有效的路径

记忆增强RAG家族对比:

| 方法 | 特点 |
|------|------|
| HippoRAG | 外部知识图 = 非参数长期记忆 |
| HippoRAG 2 | 增强版,更新更及时 |
| ReMindRAG | 缓存遍历痕迹作为可重放路径记忆 |
| GAM-RAG | 增益自适应,新知识增量写入 |

核心趋势:RAG从"外部补丁"进化为"AI认知结构"
方向三:鲁棒性评估与基准测试
Robust RAG(RGB):
  针对"信息不一致"场景的RAG鲁棒性基准
  测试系统在矛盾信息同时出现时的表现

LIT-RAGBench:
  评估RAG系统"生成高质量基准测试"的能力
  +20.4% F1 提升

关键洞察:
  评估不是辅助,而是RAG系统的核心能力
  好的评估 → 指导检索优化 → 生成质量提升
方向四:领域特化RAG
医疗领域:RAG-X
  医疗文献/病例/药品知识库
  专业术语处理 + 临床推理

时间序列RAG:
  协变量时间序列检索增强
  双重加权机制(检索权重 + 生成权重)
  解决"何时检索、检索什么"的自适应决策

机器人RAG(Robotics RAG):
  Retrieve-Reason-Act 三阶段框架
  具身场景:将"检索-生成"机制引入机器人任务
  预处理任务相关实体 → 检索关联信息 → 执行自然语言机器人任务
方向五:拓扑推理增强(RAGNav)
RAGNav:拓扑推理增强框架

核心思想:
  RAG技术为LLM配备可检索的外部知识库
  构建基于RAG的语义记忆
  增强甚至部分替代传统拓扑地图功能

关键贡献:
  EmbodiedRAG:系统性将"检索-生成"引入具身场景
  弥合拓扑地图的语义鸿沟

LightRAG/REANO/HopRAG:
  轻量级/临时图 + 多阶段检索
  提升效率和证据覆盖

GNN-RAG/TRACE/PathRAG:
  提取候选子图/路径形成结构化证据链
五大趋势总结
① 多模态RAG成为主流
   从纯文本 → 视觉、音频、结构化数据统一处理

② 自适应与动态记忆
   HippoRAG、GAM-RAG等动态记忆机制兴起
   RAG拥有"持续学习"能力

③ 领域特化深化
   医疗(RAG-X)、机器人(Retrieve-Reason-Act)、时间序列

④ 鲁棒性评估受重视
   RGB、LIT-RAGBench推动RAG系统可靠性研究

⑤ 拓扑推理增强
   RAG替代传统地图功能,弥合语义鸿沟
面试话术:
"截至 2026-10,可重点跟踪图检索、多模态检索、动态记忆、冲突/鲁棒性评估和具身检索;论文结果只说明给定数据集与设置下有效,落地前仍需与混合检索 + rerank 基线做消融。"
十五、Sentence Transformers v5.4+:多模态 Embedding 与 Reranker(Q20)
Q20: Sentence Transformers v5.4+ 的多模态能力是什么?对 RAG 系统有什么影响?
💡 答案要点
发布背景:
v5.4 重构了共享 base/processor 架构,为多模态模型提供统一处理;截至 2026-10-12,官方首页已显示 v5.5。库本身提供统一接口,但具体支持文本、图像、音频还是视频由所选模型的 processor 决定,应通过模型文档和 modalities/supports() 核对。
核心能力:
| 能力 | 传统方案 | Sentence Transformers v5.4 |
|---|---|---|
| Embedding | 仅文本 | 文本+图像+音频+视频,同一空间 |
| Reranker | 仅文本对 | 混合模态文档对评分 |
| API | 多套 | 统一 API,一行代码 |
支持的输入类型:
from PIL import Image
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("Qwen/Qwen3-VL-Embedding-2B")

# 文本 Embedding
text_emb = model.encode("什么是 RAG")

# 图像 Embedding
image = Image.open("photo.jpg").convert("RGB")
image_emb = model.encode(image)

# 跨模态相似度
score = text_emb @ image_emb.T  # 文本查询 vs 图像文档
Image.fromuri、Audio.fromuri、Video.fromuri不是通用 Python API。音频和视频的输入格式取决于具体模型及其 processor;使用前应以对应模型卡和当前版本文档为准。
多模态 RAG 实战:
# 1. 构建多模态知识库
documents = [
    {
   "type": "text", "content": "产品说明书文本"},
    {
   "type": "image", "content": "产品图片"},
    {
   "type": "text+image", "content": "图文混合文档"},
]

# 2. 编码入库
texts = [d["content"] for d in documents if d["type"] == "text"]
images = [d["content"] for d in documents if d["type"] == "image"]

text_vectors = model.encode(texts)
image_vectors = model.encode(images)

# 3. 跨模态检索
query_vec = model.encode("这个产品的外观是什么样的")
scores = query_vec @ image_vectors.T  # 文本 Query → 图像检索

# 4. 多模态 Rerank 使用 CrossEncoder,而不是 SentenceTransformer
from sentence_transformers import CrossEncoder
reranker = CrossEncoder("Qwen/Qwen3-VL-Reranker-2B")
ranked = reranker.rank(query, image_paths)
适用场景:
| 场景 | 说明 |
|---|---|
| 图文混合检索 | 用户问"这种药的外观",检索产品图 |
| 以图搜文 | 用户上传截图,找相关文档说明 |
| 视频问答 | "这个操作演示在哪里",定位视频片段 |
| 音频检索 | "会议里谁说了这个词",定位音频片段 |
与 CLIP 的区别:
| 维度 | CLIP 类模型 | Sentence Transformers v5.4+ |
|---|---|---|
| 概念 | 具体图文对比模型家族 | 使用/训练 embedding、reranker、sparse encoder 的库 |
| 模态 | 取决于具体 CLIP 变体 | 取决于加载的具体模型 |
| 能力 | 常用于图文 embedding | 可统一调用多模态 embedding 和 CrossEncoder reranker |
| 注意 | 不能概括为“文本能力都弱” | 库不自动保证跨模态对齐质量,必须评测 |
面试话术:
"v5.4+ 的工程价值是同一库可承载多模态 embedding 与 CrossEncoder reranker;不是任意模型都支持全部模态,也没有无条件优于 CLIP 的结论。"
十六、自愈 RAG:RAG 系统的自我检测与恢复(Q21)
图解:自愈 RAG 恢复闭环
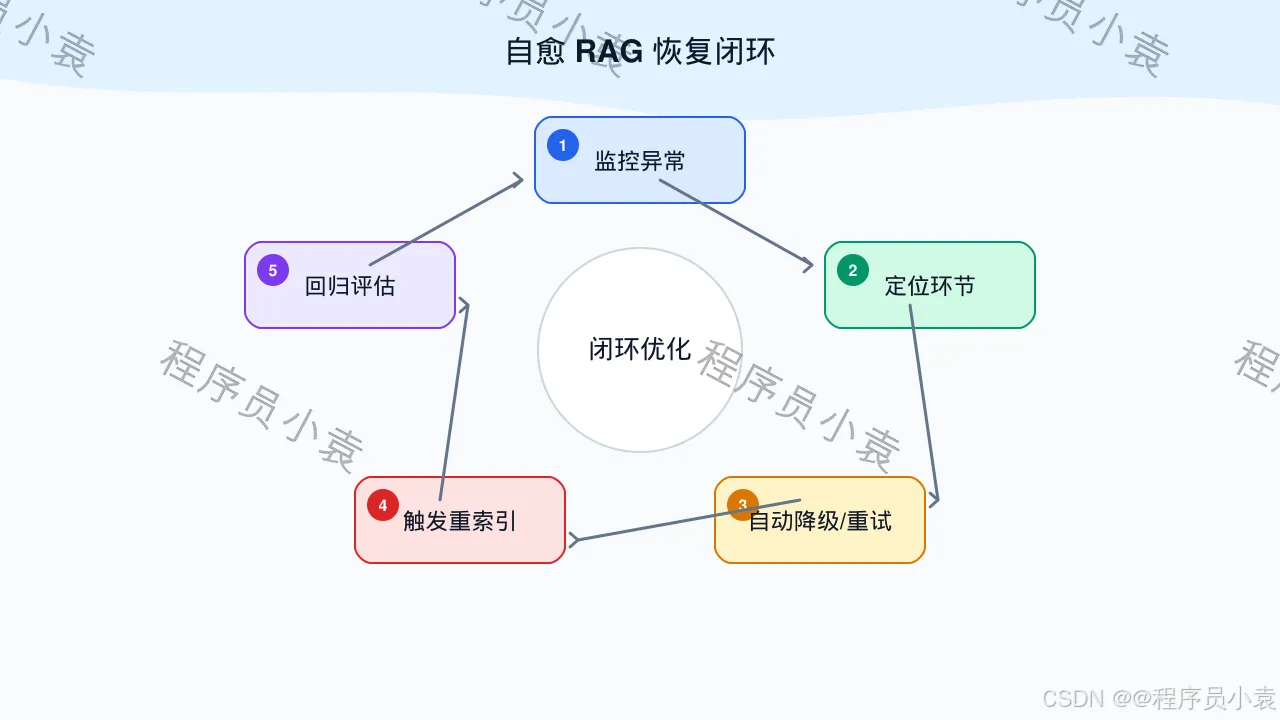
Q21: 什么是自愈 RAG?生产环境如何实现 RAG 的自我检测与自动恢复?
💡 答案要点
问题背景:传统 RAG 的脆弱性
传统 RAG 是"一次性"的:检索 → 生成 → 返回。如果检索质量差,答案基本不可用。生产环境的三大典型失败场景:
| 失败场景 | 原因 | 影响 |
|---|---|---|
| 检索为空 | Query 与知识库语义不匹配 | LLM 产生幻觉 |
| 检索偏离 | 检索到部分相关内容但不准确 | 答案偏差 |
| 上下文不足 | 检索到的内容不够回答问题 | 答案不完整 |
自愈 RAG = 让 RAG 系统自动检测失败并自动恢复,而不是简单返回"无法回答"。
自愈 RAG 的三层架构:
┌─────────────────────────────────────────────┐
│          自愈 RAG 三层架构                    │
├─────────────────────────────────────────────┤
│  Layer 1: 失败检测(Failure Detection)        │
│  - 检索相关性 < 阈值?                        │
│  - LLM 置信度 < 阈值?                        │
│  - 用户反馈负向?                             │
│         ↓ 检测到失败                         │
│  Layer 2: 恢复策略(Recovery Strategy)       │
│  - 轻度失败:Query 改写 → 重新检索             │
│  - 中度失败:混合检索(向量+关键词)→ Rerank  │
│  - 重度失败:多跳推理 → 拆解子问题             │
│         ↓ 恢复成功                           │
│  Layer 3: 验证(Verification)               │
│  - 恢复后再次评估检索相关性                   │
│  - 验证答案与问题匹配度                       │
│  - 通过 → 返回答案;失败 → 降级回复            │
└─────────────────────────────────────────────┘
失败检测的具体实现:
class SelfHealingRAG:
    def __init__(self):
        self.retrieval_threshold = 0.65  # 检索相关性阈值
        self.confidence_threshold = 0.70  # LLM 置信度阈值
        self.max_retries = 3             # 最大恢复尝试次数

    def detect_failure(self, query: str, retrieval_results: list, answer: str) -> dict:
        """检测 RAG 是否失败"""
        failure_signals = []

        # 信号1: 检索为空或质量低
        if not retrieval_results or retrieval_results[0]["score"] < self.retrieval_threshold:
            failure_signals.append("检索质量低")

        # 信号2: LLM 置信度低(如果模型支持)
        if hasattr(llm, "get_confidence"):
            confidence = llm.get_confidence(answer)
            if confidence < self.confidence_threshold:
                failure_signals.append(f"LLM置信度低: {confidence:.2f}")

        # 信号3: 答案长度异常(过短或过长)
        if len(answer) < 50 or len(answer) > 5000:
            failure_signals.append("答案长度异常")

        # 信号4: 包含"不确定""不知道"等不确定词汇
        uncertain_phrases = ["不确定", "不知道", "无法确定", "没有找到", "context中未提及"]
        if any(phrase in answer for phrase in uncertain_phrases):
            failure_signals.append("答案包含不确定表达")

        return {

            "is_failure": len(failure_signals) > 0,
            "signals": failure_signals,
            "severity": self._assess_severity(failure_signals)
        }

    def _assess_severity(self, signals: list) -> str:
        if "检索质量低" in signals and "LLM置信度低" in signals:
            return "critical"   # 重度:需要多跳推理
        elif "检索质量低" in signals or "LLM置信度低" in signals:
            return "moderate"   # 中度:混合检索 + Rerank
        else:
            return "mild"       # 轻度:Query 改写即可
分级的恢复策略:
    def recover(self, query: str, failure: dict, retrieval_results: list) -> str:
        """根据失败级别执行对应的恢复策略"""
        severity = failure["severity"]
        retry_count = 0

        while retry_count < self.max_retries:
            if severity == "mild":
                # 轻度:Query 改写 + 重新检索
                rewritten_query = self.query_rewriting(query)
                new_results = self.vector_db.search(rewritten_query, top_k=10)
                if self._check_retrieval_quality(new_results):
                    return self._generate_with_results(rewritten_query, new_results)

            elif severity == "moderate":
                # 中度:混合检索(向量 + 关键词) + Rerank
                hybrid_results = self.hybrid_retrieval(query)
                reranked = self.reranker.rerank(query, hybrid_results, top_n=5)
                if self._check_retrieval_quality(reranked):
                    return self._generate_with_results(query, reranked)

            elif severity == "critical":
                # 重度:多跳推理,拆解为子问题
                sub_queries = self.decompose_query(query)
                sub_results = [self.vector_db.search(q, top_k=5) for q in sub_queries]
                combined_context = self._merge_contexts(sub_results)
                if self._check_context_sufficiency(combined_context):
                    return self._generate_with_context(query, combined_context)

            retry_count += 1
            severity = self._escalate_severity(severity)  # 升级策略

        # 所有恢复策略失败 → 降级回复
        return self._fallback_response(query)

    def query_rewriting(self, query: str) -> str:
        """Query 改写:同义词替换 + 语法规范化"""
        prompt = f"""将以下用户 Query 改写为更适合检索的形式:
Query: {query}
要求:
1. 提取核心实体和关键概念
2. 使用标准术语替换口语化表达
3. 补充可能的同义词
改写后:"""
        return llm.call(prompt).strip()

    def hybrid_retrieval(self, query: str) -> list:
        """混合检索:向量检索 + BM25 关键词检索 + RRF 融合"""
        vector_results = self.vector_db.search(query, top_k=20)
        keyword_results = self.bm25.search(query, top_k=20)

        # RRF(Reciprocal Rank Fusion)融合
        fused = self.rrf_fusion([
            (vector_results, 0.6),  # 向量检索权重
            (keyword_results, 0.4)  # 关键词检索权重
        ], k=60)
        return fused

    def decompose_query(self, query: str) -> list:
        """Query 分解:将复杂问题拆解为多个简单子问题"""
        prompt = f"""将以下复杂问题拆解为多个可单独检索的子问题:
Query: {query}
要求:
1. 每个子问题应能通过一次检索回答
2. 子问题之间逻辑连贯
3. 标注回答顺序
子问题:"""
        sub_questions = llm.call(prompt)
        return [q.strip() for q in sub_questions.split("\n") if q.strip()]
验证层:确保恢复后的质量:
    def verify(self, query: str, answer: str, context: list) -> bool:
        """验证恢复后的答案质量"""
        # 1. 上下文相关性验证
        relevance_score = self.evaluator.compute_relevance(query, context)
        if relevance_score < 0.6:
            return False

        # 2. 答案与问题匹配度验证
        match_prompt = f"""判断以下答案是否充分回答了问题:
问题:{query}
答案:{answer}
答案是否充分回答了问题?(是/否)"""
        is_sufficient = llm.call(match_prompt).strip() == "是"

        # 3. 幻觉检测
        if self.hallucination_detector.is_hallucinated(answer, context):
            return False

        return is_sufficient and relevance_score >= 0.6
自愈 RAG 与传统 RAG 对比:
| 维度 | 传统 RAG | 自愈 RAG |
|---|---|---|
| 检索失败 | 返回低质量答案或幻觉 | 自动重试 + 策略升级 |
| 答案置信度低 | 直接返回 | 触发验证 + 补充检索 |
| 用户反馈负向 | 人工修复 | 自动调整检索策略 |
| 复杂多跳问题 | 一次性检索,效果差 | 拆解为子问题,多跳检索 |
| 运维成本 | 高(需人工干预) | 低(自动恢复) |
生产监控指标:
| 指标 | 说明 | 阈值口径 |
|---|---|---|
| 自愈触发率 | 多少比例请求进入恢复路径 | 按查询类型和历史基线分桶 |
| 自愈成功率 | 恢复后通过任务验收的比例 | 与无恢复基线及额外成本一起看 |
| 平均恢复次数 | 每个失败请求平均重试几次 | 设最大次数/预算,防止循环 |
| 最终答案质量 | 自愈后答案的 RAGAS 评分 | 与无自愈基线对比 |
面试话术:
"恢复闭环应基于可校准信号,如检索标签、引用支持率、规则和任务结果;多数生成 API 不提供可信的答案置信度。所有恢复路径都要有重试、延迟和成本预算,失败后明确降级。"