本文面向后端与平台工程师。代码为教学示意,省略了错误处理与部分安全细节,不可直接用于生产;接口字段以各模型官方文档为准。
很多团队第一次接触 LLM Gateway,是从一个很小的需求开始的:把散落在各个服务里的模型 API Key 收回来。做着做着就会发现,大模型调用和普通 HTTP 调用有几个根本不同:一次请求可能持续几十秒、响应是流式的、成本由 Token 而不是请求数决定。这几个不同,决定了 LLM Gateway 在架构上和传统 API 网关有明显区别。本文从一次请求的完整链路讲起,把概念、架构和核心能力落到代码和数字上。
一、LLM Gateway 是什么
LLM Gateway(大语言模型网关)是位于应用与大语言模型服务之间的代理层,对外提供统一的模型调用接口,对内负责鉴权、路由、Token 限流与计量、缓存、流式转发和可观测。
与传统 API 网关相比,LLM Gateway 需要处理三个特殊之处:
维度 |
传统 API 调用 |
LLM 调用 |
单次时长 |
毫秒到百毫秒 |
数秒到数十秒 |
响应形式 |
一次性返回 |
SSE 流式逐段返回 |
成本单位 |
请求数 |
输入 Token + 输出 Token |
结果确定性 |
确定 |
不确定,相同输入可能不同输出 |
二、LLM Gateway 的请求链路:一次流式调用经过什么
以 OpenAI 兼容接口为例,应用发出的流式请求如下:
http
POST /v1/chat/completions HTTP/1.1
Host: llm-gateway.internal
Authorization: Bearer vk-team-a-xxxx
Content-Type: application/json
{
"model": "general-chat",
"messages": [{"role": "user", "content": "总结这份周报的三个要点"}],
"stream": true,
"stream_options": {"include_usage": true}
}
这里有两个细节:Authorization 中是网关签发的虚拟密钥,而不是模型厂商的真实密钥;model 字段是网关定义的路由别名,具体发往哪个模型由网关决定。stream_options.include_usage 让上游在流的末尾返回 Token 用量,这是网关结算的依据。
网关返回的是 SSE 事件流:
text
data: {"choices":[{"delta":{"content":"一、"}}]}
data: {"choices":[{"delta":{"content":"本周完成"}}]}
data: {"choices":[],"usage":{"prompt_tokens":812,"completion_tokens":156}}
data: [DONE]
在网关内部,这次请求依次经过:
1. 鉴权:解析虚拟密钥,映射到团队、应用和配额。
2. Token 预估与预占:估算输入 Token,加上 max_tokens,从团队的 TPM 令牌桶中预占。
3. 缓存查询:精确缓存或语义缓存命中则直接返回。
4. 路由选择:在别名对应的候选模型中选择端点。
5. 上游转发:替换为真实密钥,转换为目标模型的原生格式。
6. 流式回传:逐段转发给客户端,同时累积输出用于检测与计量。
7. 结算:用上游返回的 usage 修正预占量,写入计量与账单。
三、LLM Gateway 的核心能力:三段关键代码
能力一:流式代理
LLM Gateway 的核心代码,是一个"边收边发"的流式代理。下面是基于 Python 异步框架的示意:
python
async def proxy_stream(req, route):
upstream = route.pick_endpoint()
usage, first_token_at = None, None
async with http.stream("POST", upstream.url,
headers=upstream.auth_headers(),
json=upstream.adapt(req.body)) as resp:
async for line in resp.aiter_lines():
if not line.startswith("data: "):
continue
payload = line[6:]
if payload == "[DONE]":
yield "data: [DONE]\n\n"
break
chunk = upstream.normalize(json.loads(payload))
if first_token_at is None and chunk.has_content():
first_token_at = now() # 记录首字时间
if chunk.usage:
usage = chunk.usage # 末尾的用量
yield f"data: {json.dumps(chunk.to_dict())}\n\n"
await settle(req.consumer, usage) # 按真实用量结算
这段代码中有三个值得注意的工程点:上游连接要设置合理的读超时(按两次数据块之间的间隔,而不是整次请求时长);客户端中途断开时要及时取消上游请求,否则会继续产生费用;如果上游没有返回 usage,需要用本地分词器估算并标记为估算值。
能力二:Token 限流——预占与结算
按请求数限流对 LLM 几乎没有意义,一个 10 万 Token 的请求和一个 100 Token 的请求成本相差上千倍。LLM Gateway 通常按每分钟 Token 数(TPM)做令牌桶限流,但输出 Token 数在请求时未知,所以要分两步:
python
def reserve(consumer, est_input, max_tokens):
need = est_input + max_tokens # 按最坏情况预占
if not bucket[consumer].try_take(need):
raise RateLimited(retry_after=bucket[consumer].wait_time(need))
return need
def settle(consumer, reserved, usage):
actual = usage.prompt_tokens + usage.completion_tokens
bucket[consumer].refund(reserved - actual) # 多退
meter.record(consumer, usage)
预占按"输入预估 + max_tokens"计算,结算时退回多占的部分。如果应用不设置 max_tokens,网关应给一个默认上限,否则预占量会过大,导致限流过早触发。多实例部署时,令牌桶状态放在 Redis 等共享存储中,用原子操作完成预占与退还。
能力三:回退——只在首个 Token 之前
流式场景下的重试有一个硬约束:一旦已经向客户端输出了内容,就不能再透明地切换到另一个模型,否则用户会看到两段拼接在一起的回答。所以回退逻辑是:
python
for endpoint in route.fallback_chain():
try:
stream = await open_stream(endpoint, req)
first = await asyncio.wait_for(stream.first_chunk(), timeout=ttft_timeout)
return chain_stream(first, stream) # 首个数据块到达后不再切换
except (UpstreamError, asyncio.TimeoutError, RateLimited):
metrics.fallback.inc(endpoint.name)
continue
raise AllEndpointsFailed()
首字超时(ttft_timeout)是这里的关键参数,设得太短会误判正常的长提示词请求,设得太长会让用户等待过久,建议按模型和提示词长度分档设置。
四、LLM Gateway 的缓存:精确缓存与语义缓存
精确缓存 以请求的规范化内容(模型、消息、关键参数)的哈希作为键,命中条件严格,适合重复的系统调用、批处理任务。
语义缓存 把用户问题转为向量,与历史问题做相似度比较,超过阈值即返回历史答案。它能覆盖"同一个问题的不同问法",但阈值的选择是一个权衡:阈值太低,会把意思不同的问题当成相同;太高则命中率低。实践中常见的做法是按场景分别设置阈值、只对无个性化上下文的问答启用、为缓存条目设置过期时间,并抽样评估缓存答案的正确率。
此外还要区分网关缓存与模型厂商的提示词缓存:后者在模型侧对相同的长前缀给予计价折扣,网关能做的是保持系统提示词和检索内容的前缀稳定,以提高命中率。
五、LLM Gateway 的部署架构:在 Kubernetes 上运行
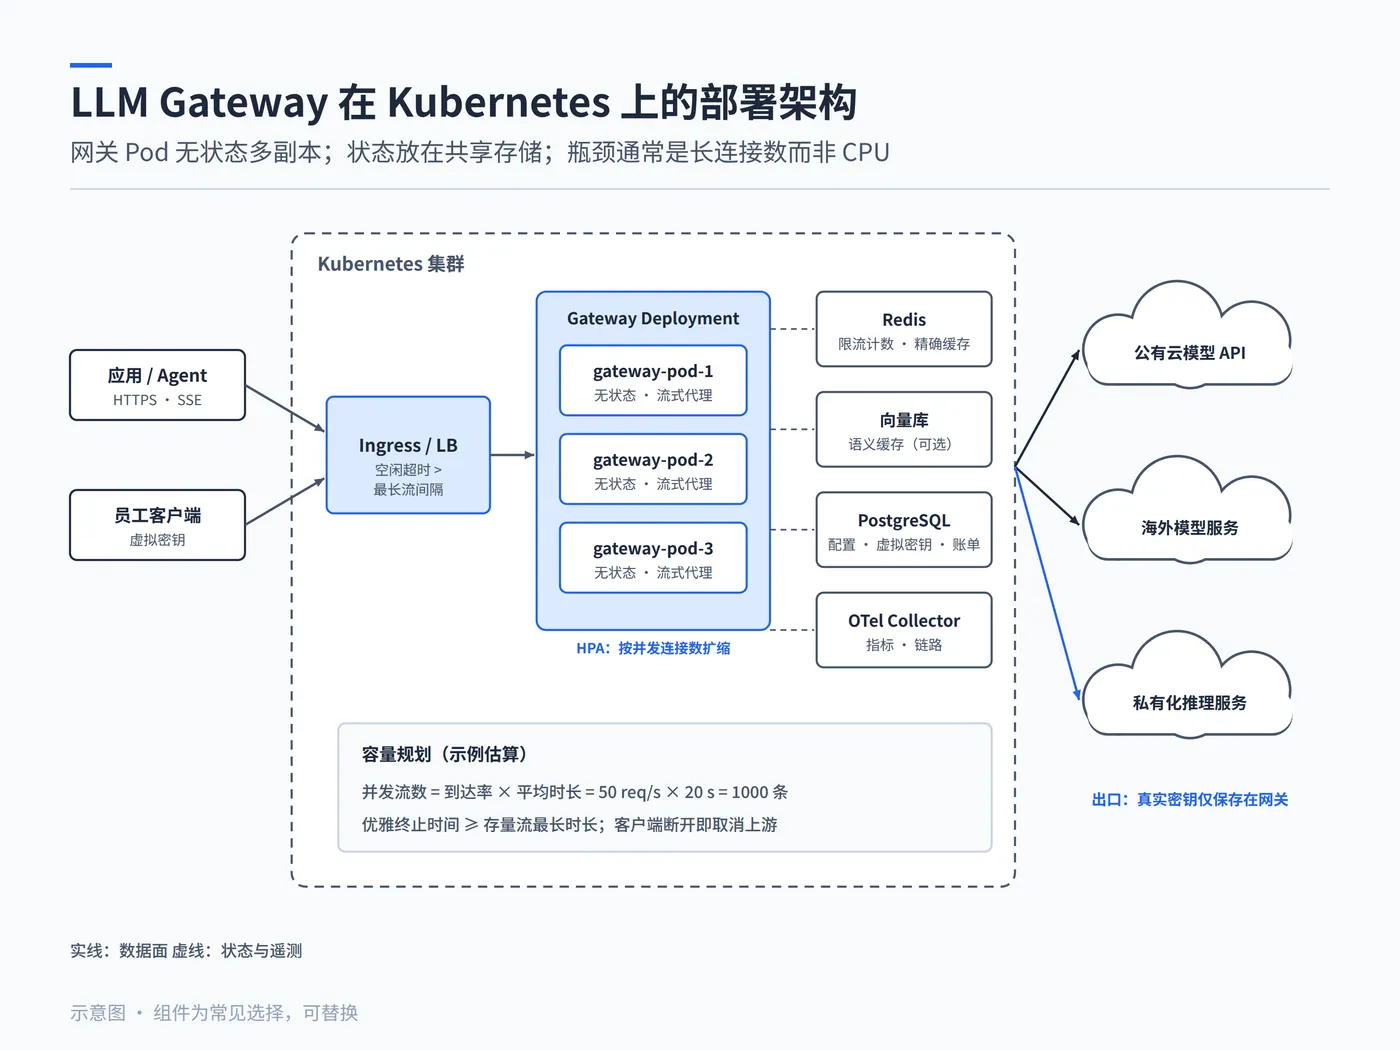
LLM Gateway 在 Kubernetes 上的部署架构
一个典型的生产部署包含:
- 网关 Pod(无状态,多副本):处理请求,按 CPU 与并发连接数做水平扩缩。
- Redis:存放限流计数、精确缓存和会话状态。
- 向量库:语义缓存(可选)。
- PostgreSQL:存放配置、虚拟密钥、计量与账单数据。
- OpenTelemetry Collector:汇总指标与链路,转发到监控平台。
容量规划:并发连接比 QPS 更重要
LLM Gateway 的瓶颈通常不是 CPU,而是长连接数量。用利特尔法则估算:
text
并发流数 = 请求到达率 × 平均请求时长
示例估算:50 请求/秒 × 20 秒 = 1000 条并发流
1000 条并发流意味着网关要同时保持约 1000 个客户端连接和 1000 个上游连接。规划时要关注:每个 Pod 的连接数上限与内存占用、负载均衡器和入口控制器的空闲超时(必须大于流式请求可能的最长间隔,否则长回答会被中途切断)、滚动发布时的优雅终止时间(要足够让存量流完成)。
部署位置
应用集中在一个云上时,网关与应用同集群部署即可;应用和模型分布在多云、多地域时,可以按地域部署多套数据面、共享一个控制面,并关注网关到模型服务之间的网络时延。对 Prompt 内容不能出企业网络的场景,也有把网关数据面私有化部署在企业接入层的做法,例如犀思云私有 AI 网关将脱敏与审计放在企业本地接入设备上完成。
附:数据来源与参考资料
- stream_options.include_usage 与 SSE data: [DONE](来源:OpenAI 兼容接口文档)
- 利特尔法则 L = λW(来源:排队论通用结论)
- 私有AI网关本地脱敏与审计(来源:犀思云官网产品资料)
说明:文中配置与代码为教学示意;时延、比例与容量为量级示意或示例估算,以实测为准;协议与法规以官方原文为准。