
当越来越多的业务逻辑交给 Agent 执行、越来越多的代码由 AI 生成,一个新问题被推到台前:谁来审计 Agent 本身?
我在业余时间开发并开源了 agent-security-scanner —— 一个 结合llm的代码设计的安全扫描器。它不追求"报得越多越好",而是回答一个更朴素的问题:**扫描器报出的每一条漏洞,能不能拿出完整证据?
产品纯个人思考独立制作,大佬轻喷,如有讨论下方有联系方式。
一、为什么做:Agent 代码正处在安全真空地带
传统工具看不见 Agent 的攻击面。
Agent 应用 = 大模型 + 工具调用 + 权限体系 + 多智能体协作。传统静态扫描擅长的判断是"这一行调了危险 API",但 Agent 时代真正的风险藏在链路和关系里:外部输入怎么一路流进 eval、低权限 Agent 怎么借高权限 Agent 的手干活、一句藏在网页里的指令怎么劫持 Agent 的目标。这些是数据流问题和拓扑问题,逐行扫描天然看不见。
AI 生成的代码,漏洞密度更高。
多家机构的开发者调查显示,全球 40% 以上的新代码已有 AI 参与;未经安全约束的 AI 生成代码,初始漏洞密度显著更高。AI 代码的问题恰恰是"单点看着都对,链路上处处漏风"——对这类漏洞,规则引擎只能给出高误报加深层漏检。
纯 LLM 审查不可信。
那把代码直接丢给大模型问"有没有漏洞"呢?会幻觉、不可复现、说不出依据。安全报告的第一属性是可信:同一段代码这轮报 3 条、下轮报 7 条,每条都"可能是真的"——这样的报告没法用,更进不了审计。
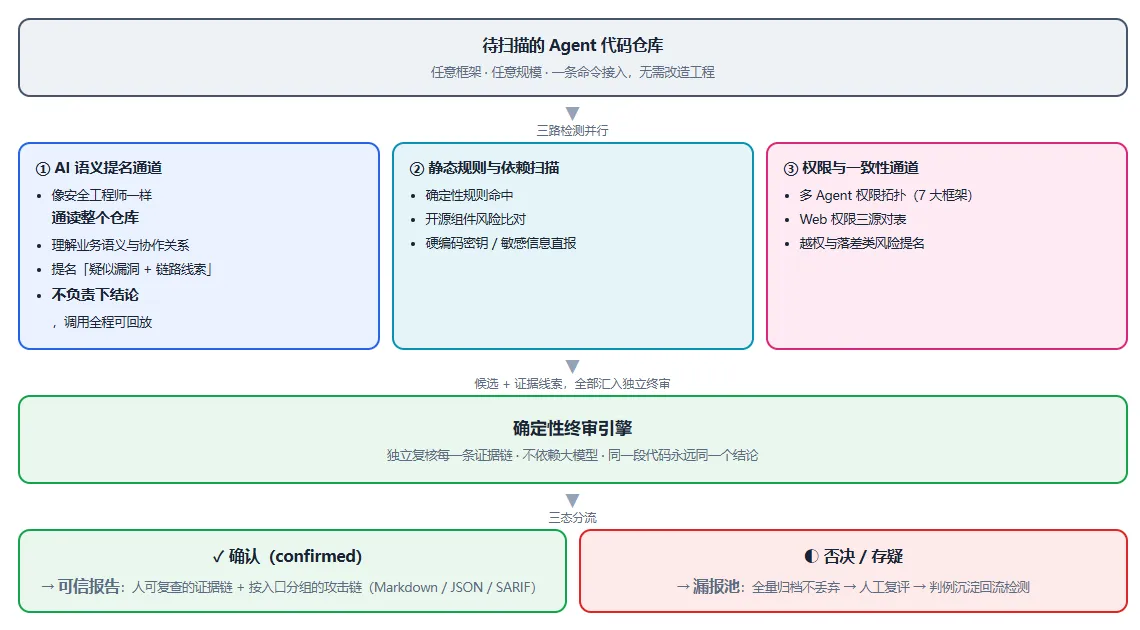
二、核心架构:双通道协同——AI 提名,证据拍板
整个引擎被拆成两个职责清晰的部分,外加一个不丢数据的闭环:
语义提名通道(管召回)。 像一位资深安全工程师那样通读整个仓库:理解业务语义、追踪跨文件数据流、识别 Agent 之间的协作关系,把"疑似漏洞 + 链路线索"提名出来。它不负责下结论——大模型的不确定性被有意隔离在这一环,且全部调用可回放复现。
确定性终审引擎(管精确)。 一个不依赖大模型的独立复核引擎,对每一条提名验证证据链:入口是否真实可达、数据是否真得流到危险点、权限是否真被绕过。验证通过的才标记为确认,并附上人可逐步复查的证据,以及按入口分组的攻击链——直接回答"攻击者从哪进来、经过哪几步、碰到什么"。
漏报池(管不丢)。 被否决与存疑的候选不做丢弃,全量归档供人工复评;人的每一次裁决又会沉淀回流,成为下一轮检测的养分。误报治理与漏报打捞共用这一个闭环。
一句话:AI 负责"找得到",证据负责"说得对"——两头都强,报告才可信。
三、大概流程:五步得到一份可信报告
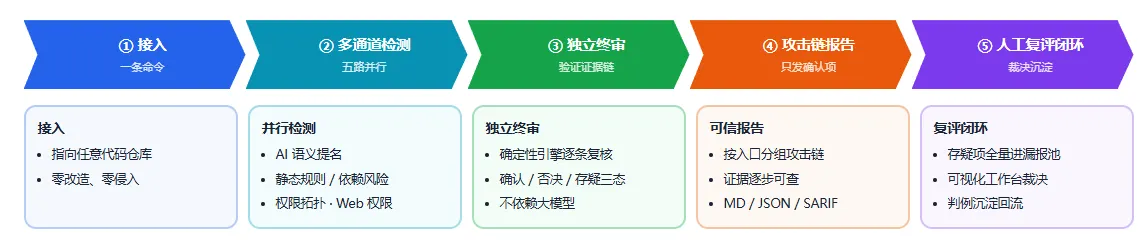
- 接入:指向任意代码仓库发起扫描,一条命令跑通,无需改造工程结构;
- 多通道并行检测:语义提名、静态规则、开源依赖风险、多 Agent 权限拓扑、Web 权限一致性,五路并进;
- 独立终审:全部候选汇入确定性验证引擎,逐条验证证据链,产出"确认 / 否决 / 存疑"三态结论;
- 攻击链报告:只有确认项进入报告(Markdown / JSON / SARIF),按入口分组、标注参数与链路每一跳,另附修复建议;
- 人工复评闭环:存疑项进漏报池,在可视化裁决工作台上人工判定,判定结果沉淀回流反哺检测。
四、核心能力
报"链路",不报"孤行"。 注入类漏洞执行"真实入口 + 完整链路"双要件:常量拼接的 eval 不算、外部不可达的危险点不算。安全工程师拿到的不是 200 条孤立告警,而是 3 条讲得清来龙去脉的攻击链。硬编码密钥、证件号、高熵凭证这类确定性风险则直接报告,不掺水分。
多 Agent 权限拓扑检测。 多智能体系统的权限问题是拓扑问题:每个 Agent 单独看都合规,连起来看却是越权链路——委托层层加码、身份原样透传、声明只读却挂满写工具、运行时自改策略。本项目把"谁有什么权限、把什么给了谁、谁能触达谁"建成权限图,以 23 类规则在图上检测,已适配 LangGraph、LangChain、CrewAI、MetaGPT、LlamaIndex、AgentScope、Pydantic-AI 七大主流框架。这一层能力,传统 SAST 和纯 LLM 审查都给不了。
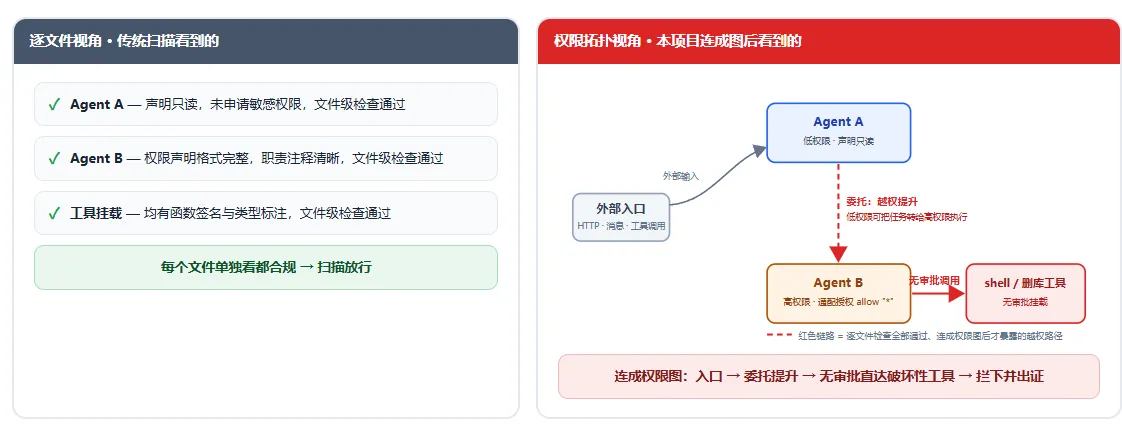
Web 权限一致性检测。 把声明侧的权限矩阵、配置、路由实际行为三份事实放在一起对表:"声明了鉴权但路由裸奔"的绝对落差直接定性;资源属主校验缺失的越权风险自动提名送审。
真实漏洞考出来的可信度。 内置 120+ 道考题的题库体系:20 个真实 CVE 逐一复刻成靶场(Gradio SSRF、Langflow 未授权执行、Superset 默认密钥等公开事件)、77 道基础题型(其中 12 道专门考察"看起来修了、其实没修干净"的半吊子修复变体)、外加 7 大框架实测题。引擎是考生,真值是考卷,判卷独立双侧对账,及格线只升不降——指标掉一点,验收直接亮红。
人在环上的裁决工作台。 Web 界面上对每条告警逐条裁决命中/误报,跨轮次聚合、可撤销、全程留痕;人工判例经程序化归纳变成规则草案,评审通过才准进运行时——经验可以沉淀,但不允许"脑补上线"。
多语言覆盖。 以 Python 为主战场,已扩展 TypeScript 与 Rust 代码的验证能力,报告统一输出。
五、差异化:不是又一个扫描工具
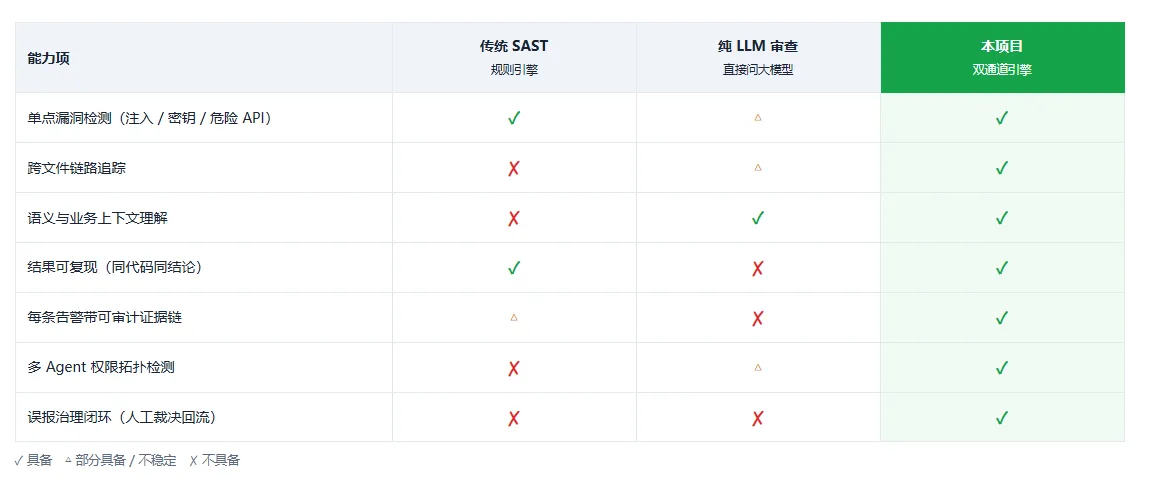
- 与传统 SAST 比:看得见跨文件链路、看得懂业务语义、看得见多 Agent 权限关系;
- 与纯 LLM 审查比:可复现、可审计、每条告警带证据链,误报有治理闭环;
- 与"LLM 套壳扫描器"比:判定权不在模型手里。大模型只负责提名,最终结论由确定性引擎基于证据拍板——这是架构级的差别,不是 prompt 调教能弥补的。
六、不自己给自己判卷:一套独立的评测体系
检测工具最容易自欺的地方,是"自己报的漏洞自己说报对了"。所以这个项目一半的功夫花在了引擎之外——给扫描器修了一套独立的考卷、判卷、及格线体系。检测能力不是"感觉变好了",是数字变好了,且每个数字可对账。
真实漏洞做考卷。
题库共 150+ 道,全部带人工冻结的标准答案: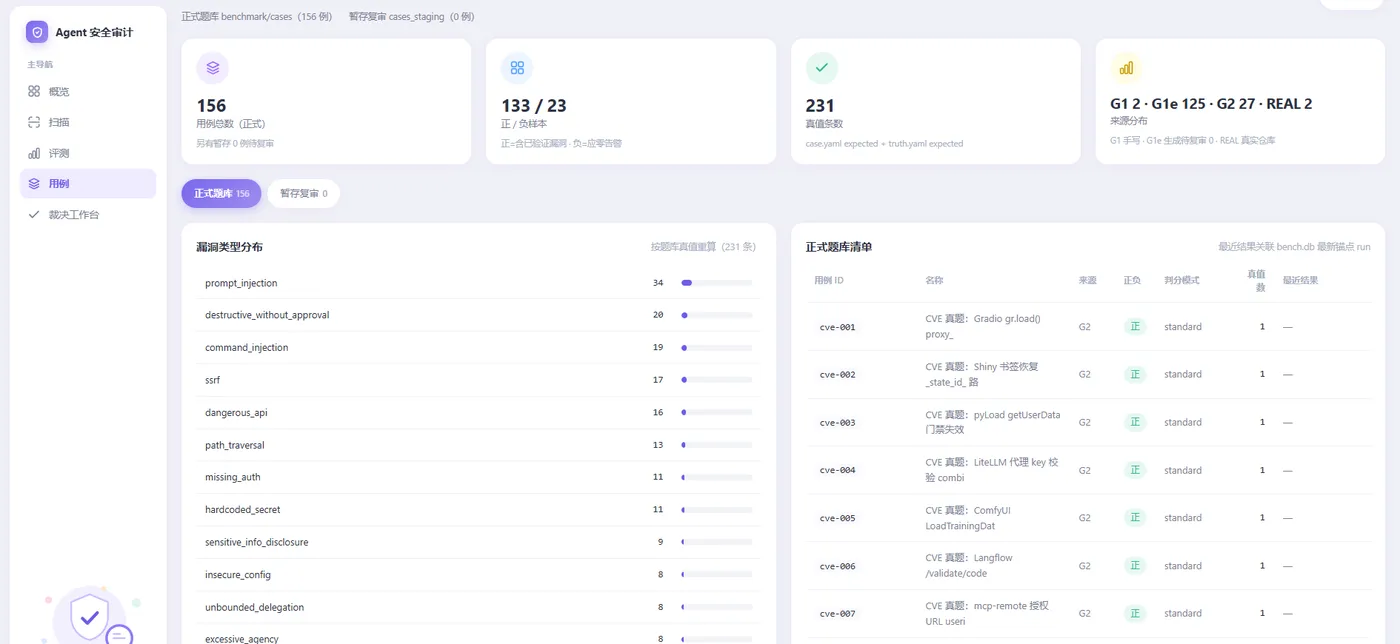
20 个真实 CVE 复刻靶场——Gradio SSRF、Langflow 未授权执行、Superset 默认密钥等公开安全事件,逐一还原成可扫描的工程,杜绝"自出题自答";
77 道基础题型——覆盖命令注入、SSRF、路径穿越、反序列化、硬编码密钥、信息泄露、越权等 13 个漏洞家族,其中 12 道专门考察"看起来修了、其实没修干净"的半吊子修复变体;
7 大主流框架实测题 + 多 Agent 权限场景——每道权限题还配一道"安全孪生"对照题:同一场景改成安全写法,扫描器必须闭嘴——一个考召回,一个考精确。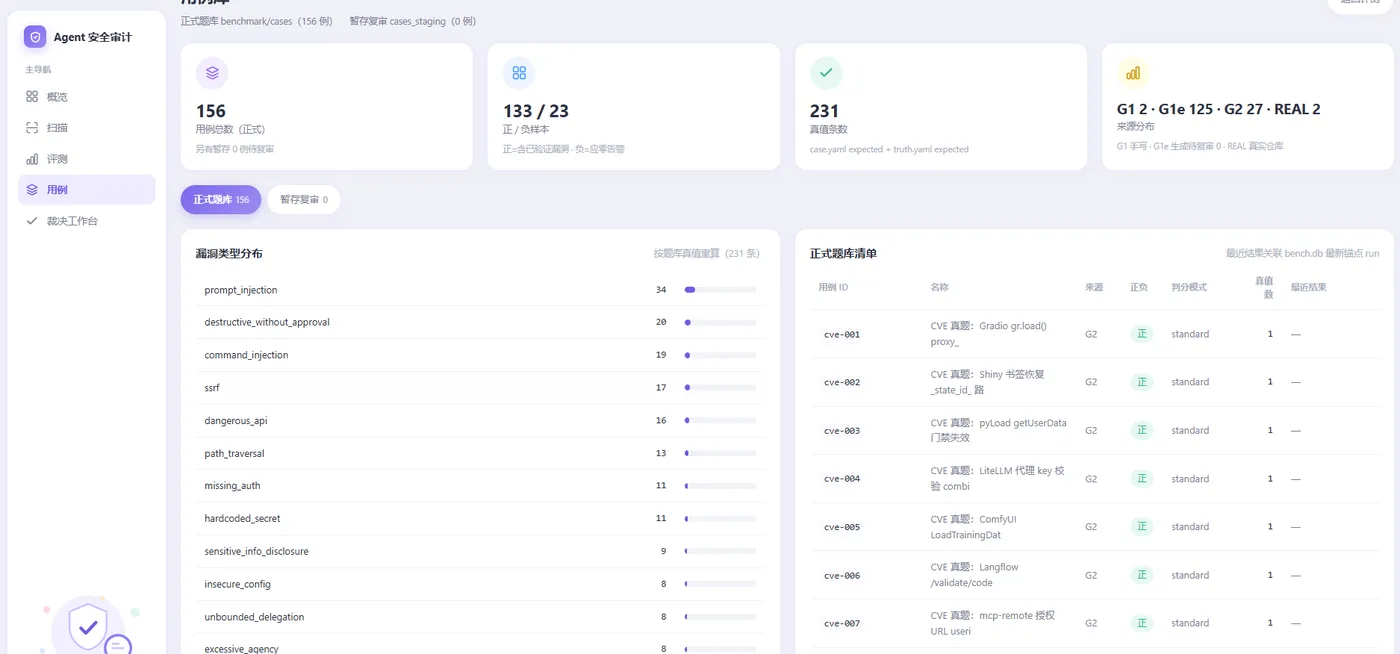
独立判卷,双侧对账。
判卷不是"扫描器报了就算对":每条标准答案去扫描结果里找"类别 + 位置"对得上的认领,对不上记漏报;反过来,扫描器报了但没有任何答案认领的,记误报。两边各记各的账,谁也糊弄不了谁。判卷规则自身也有纪律——语义类答案与技术类告警的等价关系必须逐条登记出生依据,没登记的一律不放宽,评分员也要持证上岗。
及格线只升不降。
各题库的及格线冻结在一键验收工具里,每次提交前全量回归:指标掉了,唯一正确的动作是回去修引擎,改考纲这条路被制度性堵死。AI 参与的部分全程可回放复现——回归时指标的任何变化只可能来自代码改动,不可能来自"模型今天状态好"。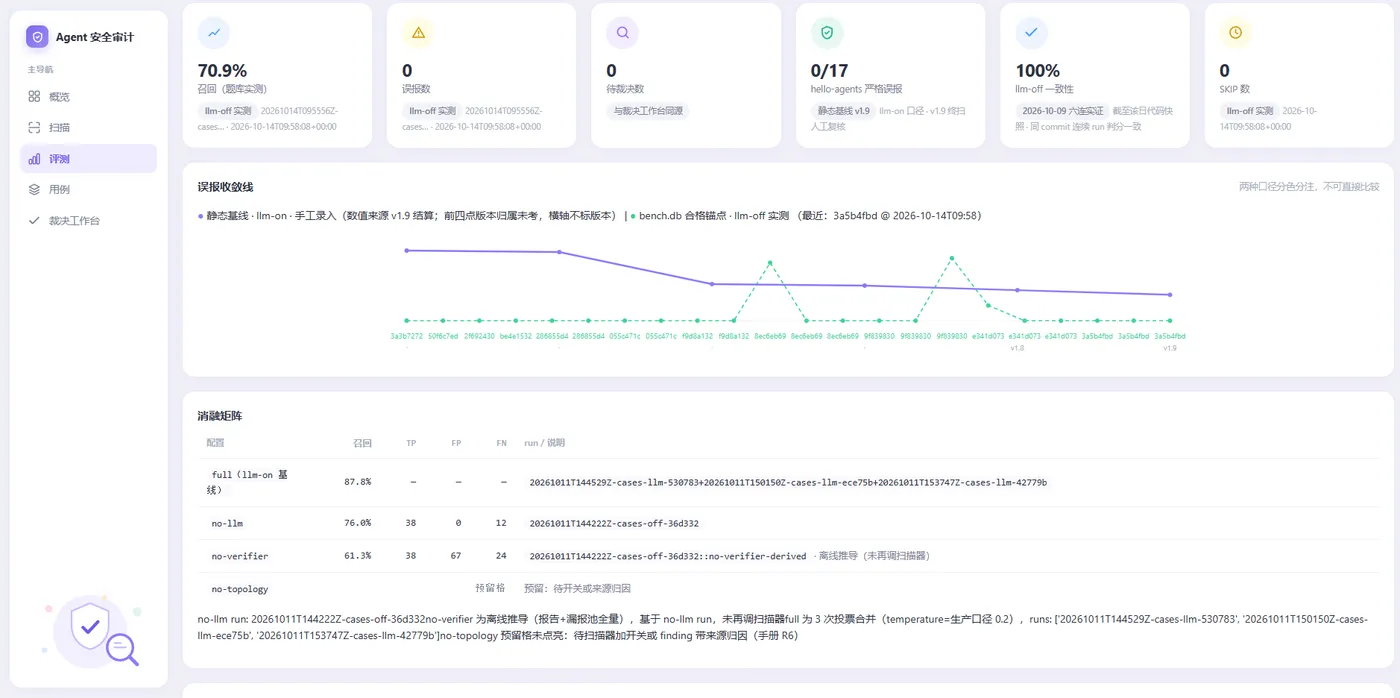
人在环上的裁决台。
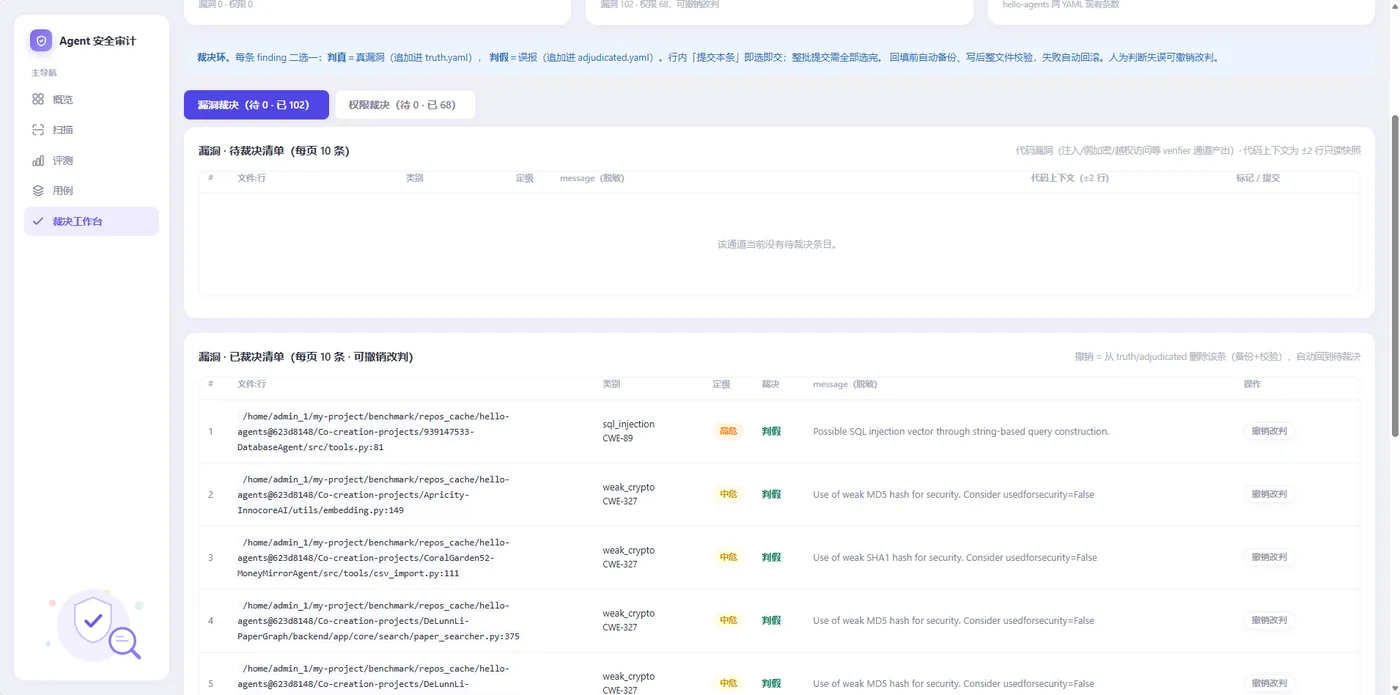
存疑与误报不会石沉大海:漏报池全量归档,在可视化裁决工作台上逐条人工判定,跨轮次聚合、可撤销、全程留痕。每一次人工裁决都会沉淀进可检索的案例库;积累的判例经程序化归纳(四道审查闸 + 留出验证)才能变成规则草案,评审通过才准进运行时——经验可以沉淀,但不允许脑补上线。
考出来的成绩,和如实标注的边界。
在这套体系下:多 Agent 权限题库召回率、精确率双 100%(37 个真值点全部命中、零误报);框架实测题库精确率 100%;全仓 1549 条自动化测试全绿.
AI 在加速写代码,也在加速写 Agent;安全能力不该滞后一个身位。这个项目想验证的是:把大模型的不确定性关进"提名"的笼子,把判定的权力交给证据——AI 时代的代码安全可以既聪明、又可信。
目前正在找工作中,欢迎大佬指导。


