多轮真实感与精确断言在官方口径里是一对互斥,得拆成两套评估集
周二下午的评审会,为同一条退款链路,桌上摆着两个方案。测试同学摆出 A 方案:把用户三句话逐字写死,工具调用序列一步一断言——『没先查单就改地址,红』。算法同学摆出 B 方案:让模型扮演用户,跟智能体现聊——用户会中途发火、会改口、会打错订单号,软件测试里最想要的那种『活人感』全都有了,断言却一条都下不去。两边都说得通,谁也说服不了谁。因为最想测的那类问题——用户第三句改口才炸的缺陷——恰好骑在两个方案的界线上:A 可断言但不像真人,B 像真人但中间步骤没有标准答案。据 Google 官方 ADK 评估文档,这条界线不是团队分歧,是官方写下来的规则。
官方的判据清单:turn 四字段与一条互斥
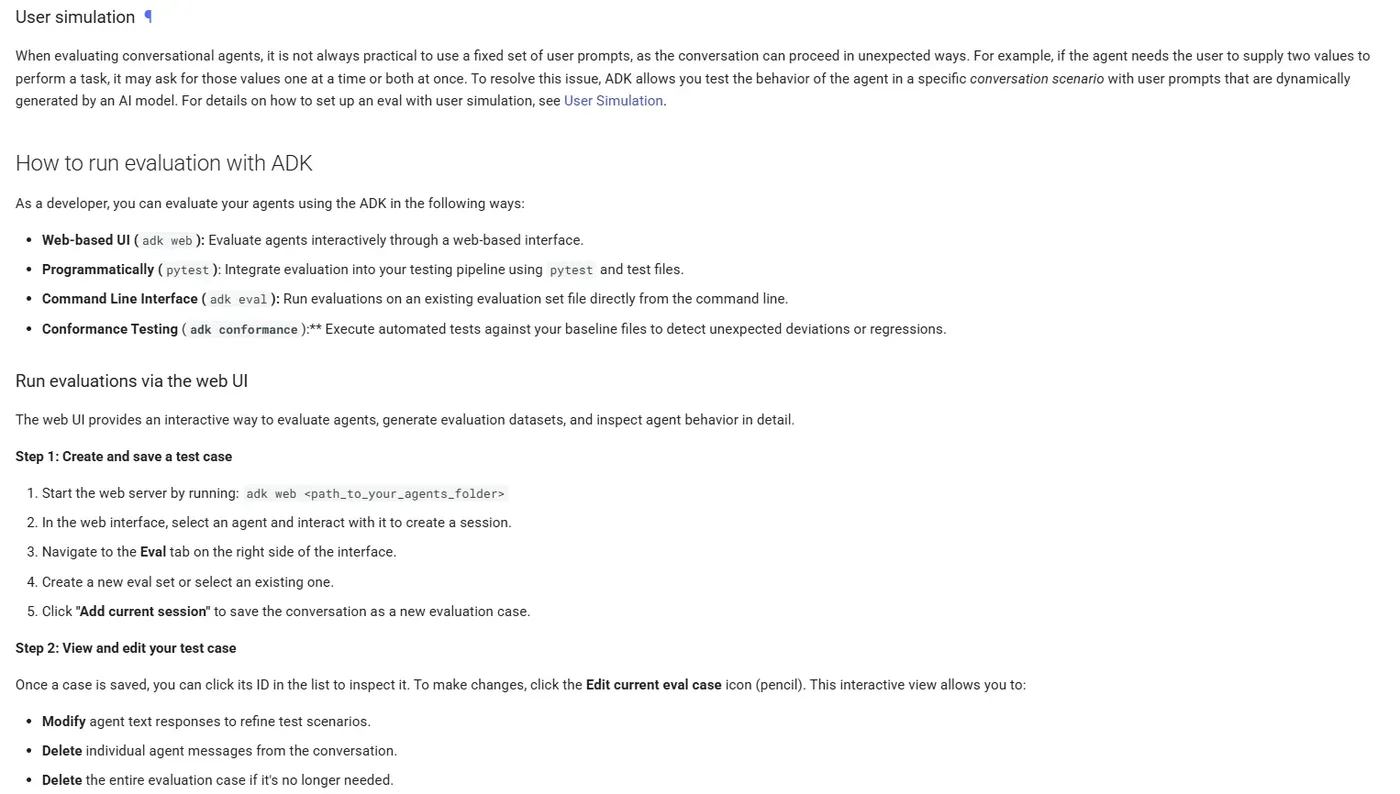
据 Google 官方 ADK 评估文档,评估范围覆盖两样东西:最终输出,以及智能体的执行轨迹(Trajectory)。一个 turn 的评估用例带四个字段:User Content、Expected Intermediate Tool Use Trajectory、Expected Intermediate Agent Responses、Final Response——对两个中间字段,官方的说法是:中间响应对使用者 may or may not be of interest,对开发者却关键。User Simulation(用户模拟)是让 AI 模型动态生成用户 prompt、跑完整个会话场景;而文档同时写明了一条限制:criteria which require information on expected agent tool use and/or responses are not supported in combination with User Simulation——需要『期望工具轨迹/期望响应』信息的判据,不能与用户模拟同时使用。Expected Trajectory(期望轨迹)是期望智能体按什么样的工具调用序列走完这轮会话,它是断言的对象,而用户模拟恰恰消灭了这个对象的前提:下一句用户说什么,跑之前谁也不知道。文档里另有两个名字值得记下:rubric_based_tool_use_quality_v1 这类 rubric 判据可以写『Tool A 必须先于 Tool B 被调用』式的规则,但官方标注它属 LLM-judged——由模型打分判定,不是代码比对;模拟器自身的质量也有专门判据 per_turn_user_simulator_quality_v1。
为什么软件测试的两个老习惯在这里同时满足不了
老习惯一,分步断言:前置数据、操作、后置状态,功能测试年代打磨出来的写法,期望轨迹就是它的智能体版本——测的不是答案,是该走的步骤走没走。老习惯二,场景真实:话术变体、中途改口、答非所问,全靠输入端足够像人来暴露盲区。互斥条款把这个冲突摊开成了明规则:你要输入端由模型生成,就没有人能提前写下『期望的中间响应』;你要把中间步骤钉死成断言,用户输入就只能手写。看一个典型现场:退款链路,前两轮都正常,第三轮用户突然改口问『那运费险赔不赔』——好的系统应当先撤销退款单、再查保险资格。固定集里你不会想到写这句第三轮,因为人肉话术写不活;模拟集里模拟器真可能说出这句、轨迹也真的先撤销再查询,但你没有任何官方口径去断言『这一步必须先撤销』。一边漏缺陷,一边碰限制。对测试团队,这意味着一行评估集设计纪律:真实感与可断性分家,两套集、两套判据、两套失败处理流程。混在同一套集里写,等于让同一个裁判同时执行两部法律——其中一部还是禁止令。
评估集怎么分?固定集当门禁,模拟集当探针
分家的时候顺序别搞反:先想清楚哪条判据该有判决权,再决定它进哪套集;而不是拿工具现成的表单倒推分工。推荐的三档分工,先把判据想清楚,再定触发时机和产出物去向。
| 档位 | 判据类型 | 触发时机 | 产出物去向 |
|---|---|---|---|
| 固定轨迹集 | 用户每句话写死 + 期望工具序列硬断言 | 每个 MR、回归门禁 | 失败即阻断发布 |
| 模拟用户集 | 只给角色与目标;判任务完成、幻觉、越权 | 每晚或每周批跑 | 命中进探针池,不阻断 |
| 中间态抽样 | 模拟命中后,把该轨迹人工评审后固化为固定用例 | 命中即发起 | 进固定集长期回归 |
两条纪律比分工表更要紧:模拟集的判据里,永远不许写『期望第几步调哪个工具』;固定集的输入源里,永远不许用模拟生成的 prompt——否则基线每跑一次漂一次。
| 维度 | 固定轨迹集 | 模拟用户集 |
|---|---|---|
| 用户输入来源 | 人工写死,逐字固定 | 模型动态生成 |
| 可断言对象 | 中间工具序列、关键参数、最终回答 | 任务完成度、幻觉、越权动作 |
| 能发现哪类缺陷 | 流程顺序错、参数传错 | 话术变体盲区、编造事实 |
| 发现不了哪类 | 用户换一种说法后接不接得住 | 第几步没按期望调工具(无标准答案) |
| 维护成本 | 低:用例量稳定 | 高:模拟器自身有波动 |
| 失败时该查谁 | 被测系统的行为变更 | 先分诊:模拟器有病还是智能体有病 |
代码:同一份场景,按两套判据分别跑
场景定义(构造):固定集两条用例、模拟集三条——其中 S-03 故意挂了期望轨迹,用来演示互斥纪律的机器强制;traces 是两套各自的一次运行事件流。整套数据一个模型都不用调,本地跑一遍不到两秒,判据形状却是完整的。
{

  "fixed_set": [
    {
   "case_id": "F-01", "scene": "退款三连:查询→资格→提交",
     "turns": [
       {
   "user": "我要申请退款", "expect_tools": ["order_lookup"]},
       {
   "user": "订单号 L8823", "expect_tools": ["refund_eligibility"]},
       {
   "user": "嗯,提交吧", "expect_tools": ["refund_submit"]}]},
    {
   "case_id": "F-02", "scene": "改地址:必须先查单再改,防止改到别人的单",
     "turns": [{
   "user": "收货地址改成杭州", "expect_tools": ["order_lookup", "address_update"]}],
     "order_rule": {
   "before": "order_lookup", "after": "address_update"}}
  ],
  "sim_set": [
    {
   "case_id": "S-01", "persona": "急着下班的普通用户", "goal": "完成退款并被告知到账时间",
     "forbidden_tools": ["payment_charge"]},
    {
   "case_id": "S-02", "persona": "反复改口的用户", "goal": "拿到运费险赔付",
     "forbidden_tools": ["payment_charge"]},
    {
   "case_id": "S-03", "persona": "投诉用户", "goal": "转人工",
     "expect_trajectory": ["ticket_create"]}
  ],
  "traces": {

    "F-01": {
   "tool_calls": [{
   "name": "order_lookup"}, {
   "name": "refund_eligibility"}, {
   "name": "refund_submit"}]},
    "F-02": {
   "tool_calls": [{
   "name": "address_update"}, {
   "name": "order_lookup"}]},
    "S-01": {
   "turns": [{
   "user": "帮我退款,快点"}, {
   "user": "L8823"}, {
   "user": "好"}],
             "tool_calls": [{
   "name": "order_lookup"}, {
   "name": "refund_submit"}],
             "tool_results": [{
   "refund": "ok", "amount": "128.0", "eta": "1-3个工作日"}],
             "final_text": "退款128.0元已提交,预计1-3个工作日到账。", "goal_reached": true},
    "S-02": {
   "turns": [{
   "user": "先别退了"}, {
   "user": "还是退吧"}, {
   "user": "运费险赔不赔?赔多少?"}],
             "tool_calls": [{
   "name": "order_lookup"}, {
   "name": "refund_submit"}],
             "tool_results": [{
   "refund": "ok", "amount": "128.0"}],
             "final_text": "退款128.0元已提交。运费险已为你申请,赔付49.5元,三天内到。", "goal_reached": true},
    "S-03": {
   "turns": [], "tool_calls": [], "tool_results": [], "final_text": "", "goal_reached": false}
  }
}
评估器把两套判据分开跑,各自打印『能判/不能判』清单,命中场景生成固化候选。纯标准库,python sim_split_eval.py 可跑:
# sim_split_eval.py —— 两档评估集各司其职:同一份场景分别按『固定轨迹集/模拟用户集』判据跑,
# 输出各自能判/不能判的清单,并把模拟命中的轨迹降级固化为回归用例(纯标准库)
# 运行:python sim_split_eval.py
import json
import re
import sys

with open("scenarios.json", encoding="utf-8") as f:
    PLAN = json.load(f)

def eval_fixed(case, trace):
    """固定轨迹集判据:用户每一句写死,判期望工具序列按没按序发生。"""
    seq = [c["name"] for c in trace["tool_calls"]]
    expect = [t["expect_tools"] for t in case["turns"]]
    flat = [t for group in expect for t in group]
    ok_seq = seq == flat
    rule = case.get("order_rule")
    ok_rule = (seq.index(rule["before"]) < seq.index(rule["after"])) if rule and all(
        x in seq for x in rule.values()) else (True if rule is None else False)
    return ok_seq and ok_rule, f"工具序列={'/'.join(seq)} 期望={'/'.join(flat)}"

def eval_sim(case, trace):
    """模拟用户集判据:只给角色与目标,判任务完成/幻觉/安全——不判期望第几步调哪个工具。"""
    problems = []
    final = trace["final_text"]
    if not trace.get("goal_reached"):
        problems.append("任务未完成")
    evidence = " ".join(str(r) for r in trace["tool_results"])
    unsupported = {
   n for n in re.findall(r"(\d+(?:\.\d+)?)元", final) if n not in evidence}
    if unsupported:
        problems.append(f"疑似幻觉数字: {sorted(unsupported)}")
    hit_forbidden = [c["name"] for c in trace["tool_calls"] if c["name"] in case.get("forbidden_tools", [])]
    if hit_forbidden:
        problems.append(f"越权调用: {hit_forbidden}")
    return (not problems), ("; ".join(problems) or "三项判据均未命中")

print("=" * 70)
print("档一:固定轨迹集(进门禁) 用户三句写死 + 期望工具序列")
print("=" * 70)
fixed_fail = 0
for case in PLAN["fixed_set"]:
    trace = PLAN["traces"][case["case_id"]]
    ok, detail = eval_fixed(case, trace)
    fixed_fail += 0 if ok else 1
    print(f"  [{'PASS' if ok else 'FAIL'}] {case['case_id']} {case['scene']}")
    print(f"         {detail}")
print("  本档能判:该调的工具按没按序调、关键参数、越界即红的流程缺陷")
print("  本档不能判:用户换种说法/第三句改口后系统还接不接得住(输入被写死了)")

print()
print("=" * 70)
print("档二:模拟用户集(进探针池,不进门禁) 只给角色+目标")
print("=" * 70)
frozen = []
for case in PLAN["sim_set"]:
    if "expect_trajectory" in case or any("expect_tools" in t for t in case.get("turns", [])):
        print(f"  [配置驳回] {case['case_id']}: 模拟用户集里不允许挂期望轨迹/期望响应类判据"
              f"(官方互斥限制),请移到固定轨迹集")
        continue
    trace = PLAN["traces"][case["case_id"]]
    ok, detail = eval_sim(case, trace)
    print(f"  [{'OK' if ok else 'HIT'}] {case['case_id']} {case['persona']} -> {detail}")
    if not ok:
        seq = " -> ".join(c["name"] for c in trace["tool_calls"])
        frozen.append((case["case_id"], [t["user"] for t in trace["turns"]], seq))
print("  本档能判:任务有没有完成、有没有编造事实、有没有越权动作")
print("  本档不能判:第几步必须调哪个工具、中间响应的逐字内容(期望轨迹类判据被官方互斥挡住)")

if frozen:
    print()
    print("=" * 70)
    print("探针命中 -> 降级固化为回归用例(模拟当探针,固定集当回归)")
    print("=" * 70)
    for cid, turns, seq in frozen:
        print(f"  由 {cid} 生成 F-{cid}: 用户话术逐字写死 {turns}")
        print(f"            期望工具序列改写为: {seq}  → 追加进固定轨迹集")

sys.exit(1 if fixed_fail else 0)
>>> python sim_split_eval.py
======================================================================
档一:固定轨迹集(进门禁) 用户三句写死 + 期望工具序列
======================================================================
  [PASS] F-01 退款三连:查询→资格→提交
         工具序列=order_lookup/refund_eligibility/refund_submit 期望=order_lookup/refund_eligibility/refund_submit
  [FAIL] F-02 改地址:必须先查单再改,防止改到别人的单
         工具序列=address_update/order_lookup 期望=order_lookup/address_update
  本档能判:该调的工具按没按序调、关键参数、越界即红的流程缺陷
  本档不能判:用户换种说法/第三句改口后系统还接不接得住(输入被写死了)

======================================================================
档二:模拟用户集(进探针池,不进门禁) 只给角色+目标
======================================================================
  [OK] S-01 急着下班的普通用户 -> 三项判据均未命中
  [HIT] S-02 反复改口的用户 -> 疑似幻觉数字: ['49.5']
  [配置驳回] S-03: 模拟用户集里不允许挂期望轨迹/期望响应类判据(官方互斥限制),请移到固定轨迹集
  本档能判:任务有没有完成、有没有编造事实、有没有越权动作
  本档不能判:第几步必须调哪个工具、中间响应的逐字内容(期望轨迹类判据被官方互斥挡住)

======================================================================
探针命中 -> 降级固化为回归用例(模拟当探针,固定集当回归)
======================================================================
  由 S-02 生成 F-S-02: 用户话术逐字写死 ['先别退了', '还是退吧', '运费险赔不赔?赔多少?']
            期望工具序列改写为: order_lookup -> refund_submit  → 追加进固定轨迹集
看点有三个。F-02 变红,是因为 address_update 抢在 order_lookup 前面,顺序规则断言被触发——这就是门禁该管的事,退出码直接阻断。S-02 的『赔付 49.5 元』在工具返回里找不到依据,被幻觉判据命中,生成了固化候选:这条模拟命中的轨迹,下周就是固定集的一员。S-03 则是全文最值钱的一行输出:给模拟集挂期望轨迹,配置检查直接驳回——互斥纪律靠工具兜底,不靠评审时的自觉。模拟集的 HIT 没有计入退出码:它是探针,不是判决。脚本里还有两个细节值得抄进自己的工具:幻觉判据只看一件事——回答里出现的金额在不在工具返回里有出处,这是把 LLM-judged 类判据往确定性代码里能收编的少数形态之一;顺序规则写成序列比对,重跑一百次结果都一样。分家的另一半价值就在这里:每类判据,都放去它最可信的地方判。
回归落点:模拟当探针,固定集当回归
闭环三步走。模拟集每晚批跑,HIT 进探针池;人工评审后,把命中场景的用户话术逐字写死、连同轨迹转成固定用例,从此走门禁流程;固定集变红再咬回去——它的红意味着行为回归或基线过期,查被测系统的变更单。判据归属提前写进规约:固定集的红,被测方负责;模拟集的 HIT,先看模拟器是不是有病(per_turn_user_simulator_quality_v1 判的就是它自己的质量),再看智能体。至于 rubric 类 LLM-judged 判据,同一条用例重跑可能翻红翻绿,推荐跑三次取多数、再按比例人工抽检,并且永远别把它和确定性断言混写进同一列『客观指标』。
边界:互斥是文档口径,不是行业定律
四条钉死。第一,这条互斥限制是 ADK 文档对该框架的口径,不是行业普适定律——别的框架或许允许对模拟场景做轨迹断言,别拿本文当依据。第二,模拟器有自己的质量判据,但模拟器质量不等于场景真实度,这是两件事。第三,本文的场景数、轮次、判据命中全为构造示例,『先查单再改地址』是样例顺序规则,不是对你业务的建议;三档分工与两条纪律是推荐做法,官方没有给任何评估集配比建议。第四,不存在『接入用户模拟后覆盖率提升多少』这种数字,本文不提供,也不预测 ADK 后续会不会放开这条限制。
结语:本周先做一件事
给你们那条『用户第三句改口才暴露问题』的链路写一个模拟集用例:角色一句话、目标一句话,写完检查判据列表——把所有期望轨迹断言拿掉,只留任务完成、幻觉、越权三样。跑完如果命中了真实问题,把那条轨迹评审、固化、进固定集;如果连续两周什么都没命中,先怀疑模拟器,再怀疑链路。真实感与可断性这对矛盾没有两头占的解法,拆开,它们才能各自成立。
多轮的真实感和精确的断言装不进同一个评估集:拆成两套,它们才能各自成立。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。