IDC权威报告:阿里云AI云存储市场份额位列第一

简介: IDC报告显示,阿里云以35.2%份额领跑2025年中国AI云存储市场,超第二至四名总和。依托全栈自研CPFS、KVCacheStore及Agentic Storage矩阵,覆盖训练、推理与Agent全场景,支撑超50%中国大模型公司。

近日,国际数据公司IDC发布《2025中国AI云存储市场份额》,报告显示,阿里云以35.2%的市场份额位居中国AI云存储市场首位,超越第二至第四名的总和,持续领跑中国AI云存储市场。
IDC表示,阿里云的领先优势来自对AI基础设施的长期投入,以及在AI场景中的规模化商业实践。
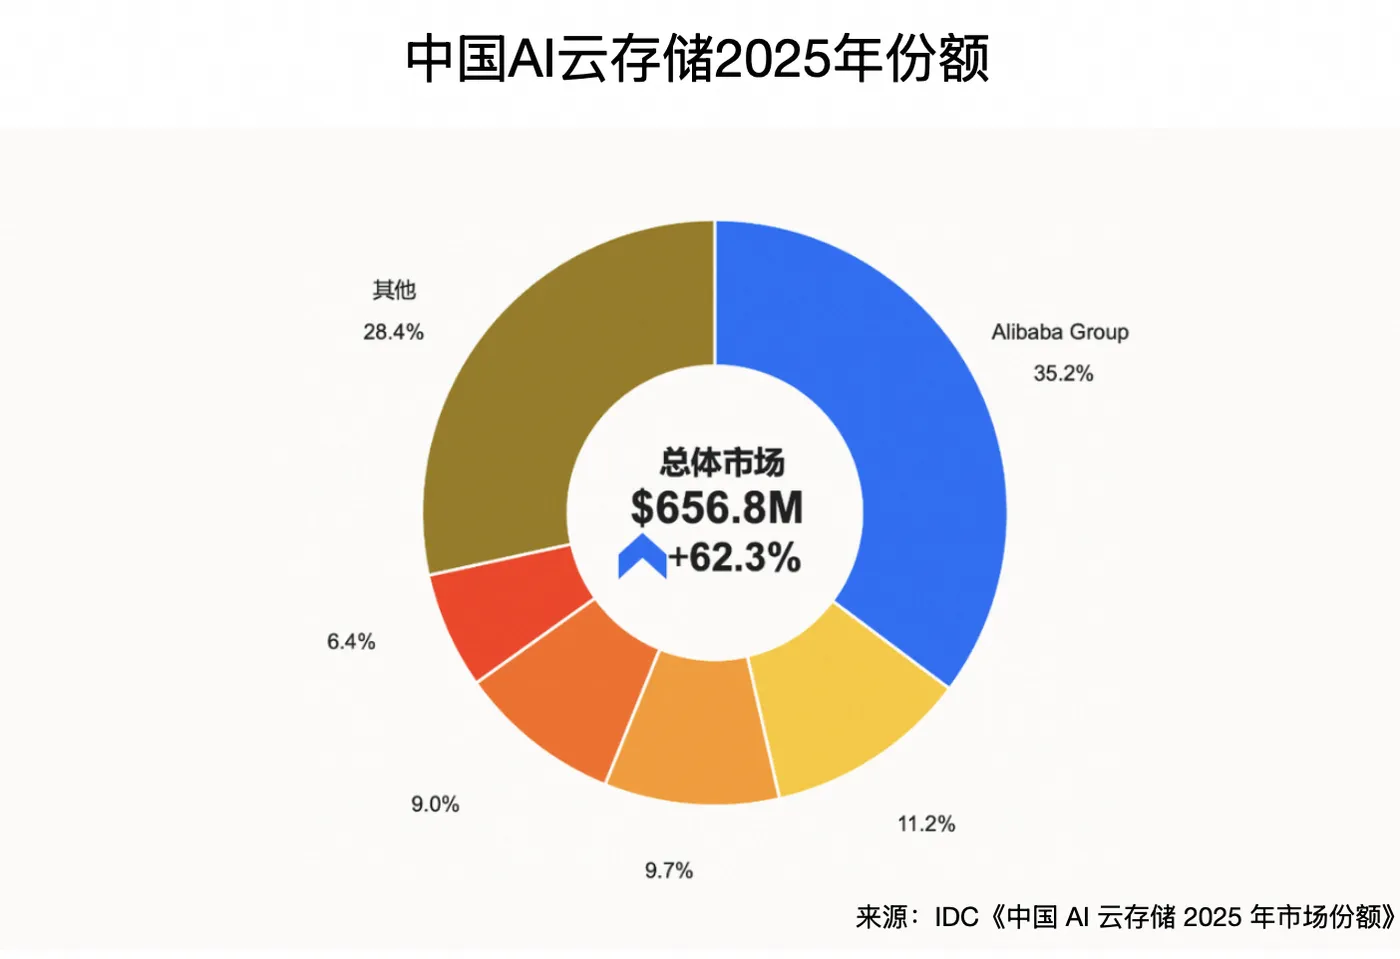

image.png


AI云存储是指面向模型训练与推理、AIGC、Agent记忆和管理等一系列AI相关工作提供的AI原生云存储或AI优化云存储服务。与通用存储相比,AI云存储可有效满足海量Checkpoint高并发快速读写、多模态数据管理、高并发小文件、向量检索等AI特有的数据需求,提升AI数据处理效率,降低AI成本。


IDC表示,领先优势来自阿里云对AI基础设施的长期投入,以及在AI场景中的规模化商业实践。报告显示,2025年上半年,AI原生云存储收入在中国AI云存储市场中的占比已超过90%,其中以面向训练的高性能文件存储占据主导。


目前,阿里云已构建覆盖数据预处理、训练、推理与Agent应用的全链路Agentic Storage产品矩阵。


训练方面, 阿里云打造了高性能数据存储底座——CPFS(Cloud Parallel File Storage),支撑公共云上的大规模模型训练。9 月22 日,云栖大会期间阿里云将正式推出新一代全栈自研CPFS,面向下一代AI训练集群设计,可支撑百万卡级模型训练。


在推理侧,KV Cache已成为影响大模型推理效率的关键基础设施。通过缓存已处理上下文的键值对,KV Cache可避免重复计算,从而降低首Token时延并提升推理吞吐。针对这一特性,阿里云推出KVCacheStore——全球首个公共云 G3.5层KV Cache存储产品。它可独立于算力部署,并支持弹性扩容,在保持高性能的同时显著提升推理服务效率与资源利用率。
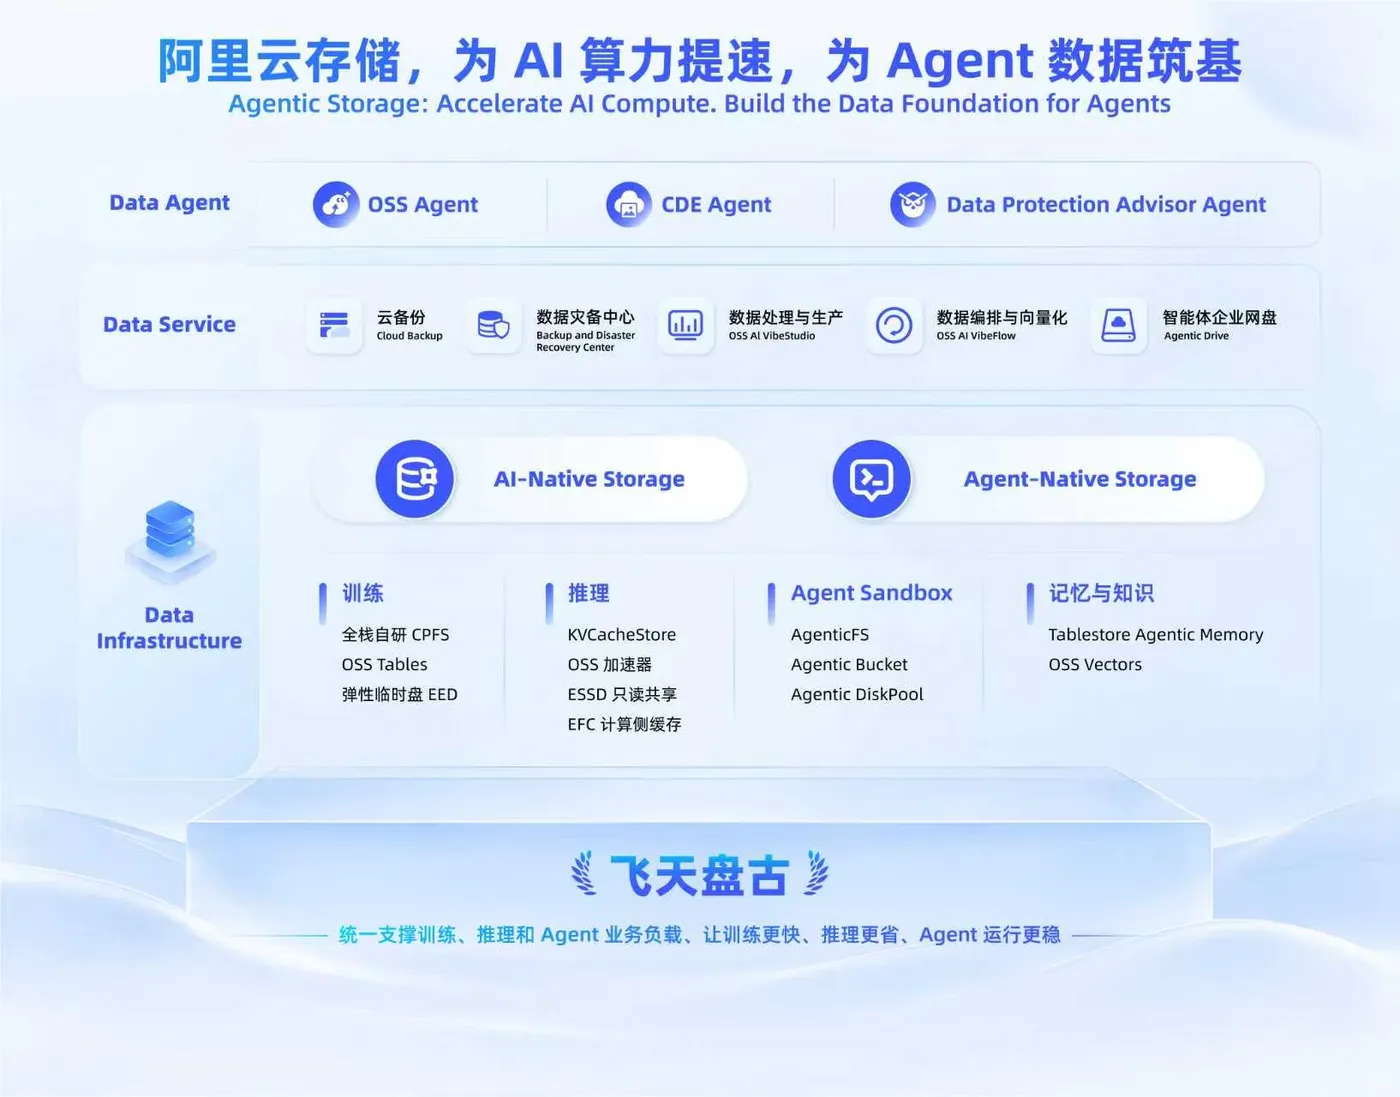

image.png


为满足Agent在百万级并发、安全隔离、长效记忆与知识管理等方面的刚性需求,阿里云还推出了AgenticFS、Agentic Bucket、Agentic DiskPool等产品,构建覆盖文件、对象和块存储的Agent Data Infra产品矩阵,支撑百万级 AgenticSpace的动态创建与稳定运行。


在记忆与知识管理方面,阿里云OSS Vectors提供低成本、大规模的向量存储底座。面向Agent上下文场景,Tablestore Agentic Memory全新升级,提供知识与记忆融合的原生上下文服务,并支持记忆整理、反思和Wiki知识编译等能力,帮助Agent持续积累与自主进化。


截止2026年8月,阿里云存储已累计服务超过数百万家企业客户,覆盖大模型训练、自动驾驶、具身智能、科学仿真等多个前沿场景,超过50%的中国大模型公司选择阿里云存储支撑模型训练。

相关文章
|
27天前
|
存储 人工智能 云栖大会
云栖大会 | 阿里云存储 3 大分论坛精彩预告:为 AI 算力提速,为 Agent 数据筑基
「阿里云存储」在云栖,我们将带来 3 场精心准备的分论坛、20+ 热门技术话题、重磅客户悉数到场,一手实战经验拆解。
291 2
|
15天前
|
存储 人工智能 自然语言处理
新一代全栈自研 CPFS 正式商业化: 为下一代 AI 训练集群设计
2026年9月,阿里云发布全栈自研新一代CPFS存储,支持百TB/s吞吐、亿级IOPS及100PiB单文件系统,显著提升大模型训练效率:启动耗时降50%、算力利用率升30%、存储成本降69%,已落地小鹏汽车等企业。
193 0
|
1月前
|
SQL 分布式计算 对象存储
Catalog 多了无法统一管理?Gravitino 一个入口统管 OSS Tables【详解 OSS Tables 系列】
本文介绍如何通过 Apache Gravitino 统一管理多源异构元数据(如 OSS Tables、Hive、JDBC 等),解决 Catalog 多、配置重复、元数据碎片化问题。Gravitino 作为元数据联邦层,提供统一命名空间与权限治理,并支持 Spark/Flink/Trino 等引擎通过单一 REST 接口跨源查询,显著降低运维与接入成本。
213 0
|
4月前
|
存储 数据采集 机器人
具身智能爆发背后,存储如何成为关键基础设施?
具身智能爆发式发展带来存储新挑战:多模态数据采集、仿真生成、清洗标注、分布式训练与低延迟推理各环节诉求迥异。阿里云以 OSS 统一底座(支持 QoS 管控、冷热分层、Vector Bucket 向量检索)+ CPFS 高性能训练引擎协同,构建全链路、高弹性、低成本存储方案。
794 0
具身智能爆发背后,存储如何成为关键基础设施?
|
1月前
|
弹性计算 人工智能 开发工具
内网带宽跑不满百 Gbps?OSS 三维调优实测帮你拉到位
本文详解AI训练场景下OSS百Gbps内网带宽调优方法,涵盖网络(ECS实例选型、VPC内网)、磁盘(避免落盘、ESSD配置)和并发(range分片、工具参数)三大维度,并提供Go SDK、ossutil、ossfs、Python SDK实测调优参数与性能对比,助用户突破带宽瓶颈。
216 0
内网带宽跑不满百 Gbps?OSS 三维调优实测帮你拉到位
|
3月前
|
存储 人工智能 安全
从文件柜到知识大脑:企业知识管理架构二十五年演进全记录
本文系统梳理企业知识管理25年演进史:从90年代纸质文件柜,到Wiki协作、Elasticsearch搜索、云文档协同,再到RAG智能问答,最终迈向全域知识网络与AI智能体时代。以技术架构变迁为脉络,揭示“人找知识”→“知识找人”的本质跃迁,兼具历史纵深与实践洞察。(239字)
283 0
|
3月前
|
消息中间件 存储 分布式计算
AutoMQ x 阿里云 OSS Tables:基于 Iceberg 构建流表一体的实时入湖
实时数据入湖效率影响分析时效。传统Kafka→Flink→Iceberg链路需维护同步任务与表优化,成本高、运维重。AutoMQ x OSS Tables新方案实现Kafka Topic自动物化为Iceberg表,并在OSS侧提供托管Catalog与自动化Compaction,端到端简化架构,零额外计算负担,支持Schema演进与CDC Upsert,大幅提升实时入湖可靠性与效率。(239字)
301 0
|
4月前
|
存储 人工智能 运维
拍封面,识唱片:UNHEARD 携手阿里云向量 Bucket,用 AI 重新定义实体唱片发现体验
UNHEARD 是一款专为黑胶爱好者打造的数字工具,依托阿里云 OSS 向量 Bucket 与百炼多模态模型,首创“以图搜碟”功能——拍封面即识专辑。集海量唱片数据库、唱片店地图、垂直社区于一体,助力用户轻松发现、识别、管理实体唱片。
973 0
拍封面,识唱片:UNHEARD 携手阿里云向量 Bucket,用 AI 重新定义实体唱片发现体验
|
4月前
|
存储 运维 数据管理
告别“大海捞针”:OSS Vector Bucket 如何赋能媒资管理平台
在 AI 时代,媒资平台面临多模态数据爆炸式增长的管理挑战。阿里云 OSS Vector Bucket 提供统一向量存储与语义检索能力,支持 30 亿级素材秒级精准查找,打破数据孤岛,降低成本,助力内容创作提效降本。
421 11
|
4月前
|
人工智能 自然语言处理 算法
800 家门店的便利零售如何低成本接入 AI 推荐?美好超市基于 OSS 向量 Bucket 的实践
本文讲述江苏头部连锁超市“美好超市”如何借助阿里云 OSS 向量 Bucket,零算法团队、免自建系统,快速实现语义搜索与智能推荐:购物车实时推荐、详情页智能搭配、自然语言问答购等场景全面升级,让 AI 推荐真正普惠中小企业。
392 0