
IDA Pro 9.5 (macOS, Linux, Windows) - 强大的反汇编程序、反编译器和多功能调试器
A powerful disassembler, decompiler and a versatile debugger. In one tool.
作者主页:sysin.org
摘要:IDA 9.5 新增 Dalvik、TriCore 和 Hexagon 三大反编译器,并全面提升 AVX、Armv9、MIPS、ARC 及游戏主机等平台的反汇编与反编译能力。
IDA Pro
一个强大的反汇编程序、反编译器和多功能调试器。集成在一个工具中。
IDA 9.5:3 个全新反编译器和 10 项平台更新
2026 年 10 月 6 日
优秀的工具始于扎实的基础。当每条指令都能正确解码、每个函数都能以清晰的伪代码呈现时,你就可以信任 IDA 展示的结果,并把时间投入到二进制文件本身。无论读取输出的是人还是驱动 IDA 的智能体,这一点都成立。IDA 9.5 将这种可靠性带到了三个全新的架构上,同时也进一步完善了几个已有的架构。
首先是全新的反编译器:
- Android DEX,即 Java 和 Kotlin 应用背后的字节码,现在可以反编译为 Java
- Infineon TriCore,即许多汽车 ECU 中使用的 CPU,现在可以反编译为 C
- Qualcomm Hexagon,即 Snapdragon 芯片中的 DSP,负责运行调制解调器、音频和摄像头处理流水线,现在同样可以反编译为 C
现有的反编译器也得到了进一步增强。AVX 代码现在可以以 C 的形式呈现,ARC 函数现在能够以正确的返回指令结束,而反编译器现在也理解 MIPS Release 6 以及一些游戏主机平台。在反汇编器方面,Armv9 获得了一批新的扩展支持。
下面,我们将通过实际示例逐一介绍这些更新,并在有帮助的地方展示前后对比。
关于版本授权需要说明一点:TriCore 和 Hexagon 反编译器仅提供给 IDA Pro。Dalvik 反编译器同时提供给 IDA Pro 和 IDA Home,因此如果你使用 Home 许可证分析 Android 应用,也可以使用它。
Dalvik:像阅读源代码一样阅读 APK
使用 Java 或 Kotlin 编写的 Android 应用会将代码以 DEX 字节码形式发布,而在 9.5 中,IDA 会将其显示为 Java,而不再是寄存器和 invoke-virtual。这不是额外附加在旁边的独立查看器,而是使用同一个数据库,你仍然可以像过去一样对其进行重命名、重新设置类型、添加注释和编写脚本。
打开 APK
加载一个 APK,选择 classes.dex,然后按 Tab。你会看到类视图:其中包含包、类、字段和方法,并且每个方法的伪代码都会直接显示出来。Multidex 应用会作为一个数据库加载,而对另一个 dex 文件中的函数进行调用时,会直接跳转到对应函数的函数体。
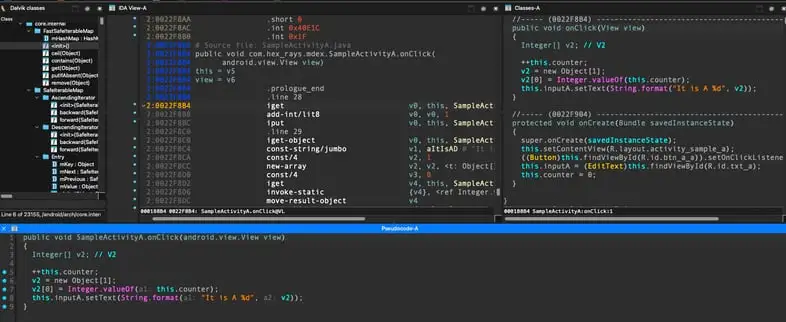
该视图中的所有内容都是数据库中的真实实体。重命名一个方法,它的调用者也会随之更新。使用 "Set type" 重新设置其类型,该功能接受 Java 语法,调用者的伪代码也会随之更新。虚调用还会引用子类中的重写方法,因此交叉引用会显示一个调用实际上可能跳转到哪里。
字符串拼接
像 "and=" + (a & b) 这样的字符串拼接通常会被编译成一系列 StringBuilder 操作:创建 builder、对每个部分调用 append(),然后调用 toString()。字节码看起来是这样的: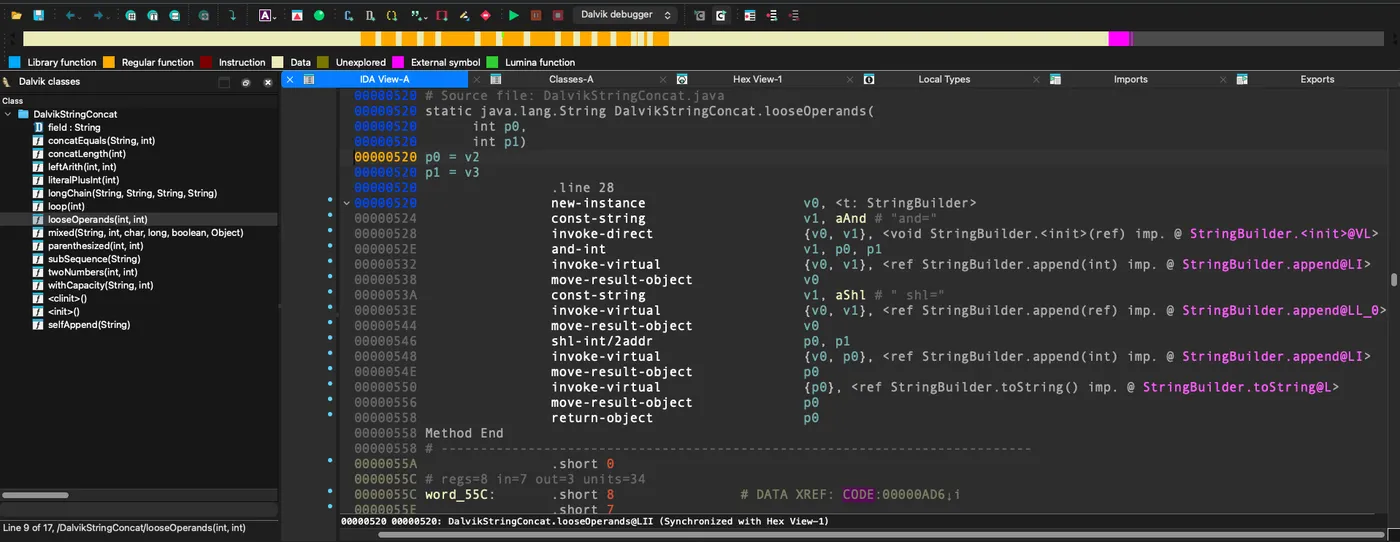
IDA 9.5 会将这一连串操作重新折叠为程序员最初编写的形式:
static String looseOperands(int p0, int p1)
{

  return "and=" + (p0 & p1) + " shl=" + (p0 << p1);
}
这里必须保留括号:如果没有括号,"and=" + p0 & p1 甚至无法通过编译。不过,并不是所有 builder 都会被折叠。当 + 会改变结果时,builder 会保持原样:
static String twoNumbers(int p0, int p1)
{

  return new StringBuilder().append(p0).append(p1).toString();
}
如果 builder 跨越多个语句存在,例如在循环中逐步填充,那么它也会保持原样。
混淆器没有抹掉的名称
混淆器会将字段重命名为 a、b、c。但序列化器不能这么做:网络上传输的 JSON 中仍然需要使用 sections,因此一个有意义的名称会保存在序列化器注解中。反编译器会读取这个名称:
class GsonModel
{

  static int requestCount;   // was c
  int sections;   // was a
  int pageLoad;   // was b
  ...
Gson、Moshi、Jackson 和 kotlinx.serialization 都支持相同的机制,名称也可以从 Kotlin 元数据和 DEX 调试信息中恢复。如果序列化名称不是有效的 Java 标识符,例如 nav-pag_name,那么它会作为原始字段上的注解保留下来。每次反编译时都会重新计算名称,而你手动设置的名称始终具有最高优先级。
在类视图中工作
第一天使用时,有几个值得了解的事项:
- Tab 在反汇编视图和类视图之间切换,两者会保持同步
- Ctrl+Shift+F6,或者在树状视图中的类上按住 Ctrl 并双击,可以打开第二个类视图,这样你就可以并排查看调用者和被调用者
- 常用的伪代码操作都可用:重命名、注释、"Set type"、反转 if、隐藏类型转换、折叠
类视图展示的所有内容也都可以通过脚本访问,C++ 和 IDAPython 中新增了类 API。Dalvik 是它的第一个后端。下面的代码可以将 APK 中的每个类导出到一个 .java 文件中,其中包括反编译后的函数体:
import ida_hexrays

if ida_hexrays.init_hexrays_plugin():
    classes = ida_hexrays.classes_t()
    if ida_hexrays.get_classes(classes):
        for c in classes:
            if c.outer:
                continue
            ok, lines = ida_hexrays.render_class(c)
            if ok:
                with open(c.name + ".java", "w") as f:
                    f.write("\n".join(lines))
SDK 中还提供了一个更完整的示例 list_classes.py,它还会打印光标所在类的结构概览。
TriCore:用 C 阅读你的 ECU
TriCore 固件通常以 flash dump 的形式交到你手中:没有符号,没有头文件,只有几 MB 的发动机控制代码。在 9.5 中,它可以反编译为 C。
TriCore 有两个方面需要的不仅仅是一个新的 lifter。
指针存储在 A 寄存器中
TriCore 有两组寄存器文件:用于数据的 D 寄存器和用于地址的 A 寄存器。调用约定也遵循这一划分。整数参数放在 d4-d7 中,指针参数放在 a4-a7 中,函数返回整数时使用 d2,返回指针时使用 a2。来看这个函数:
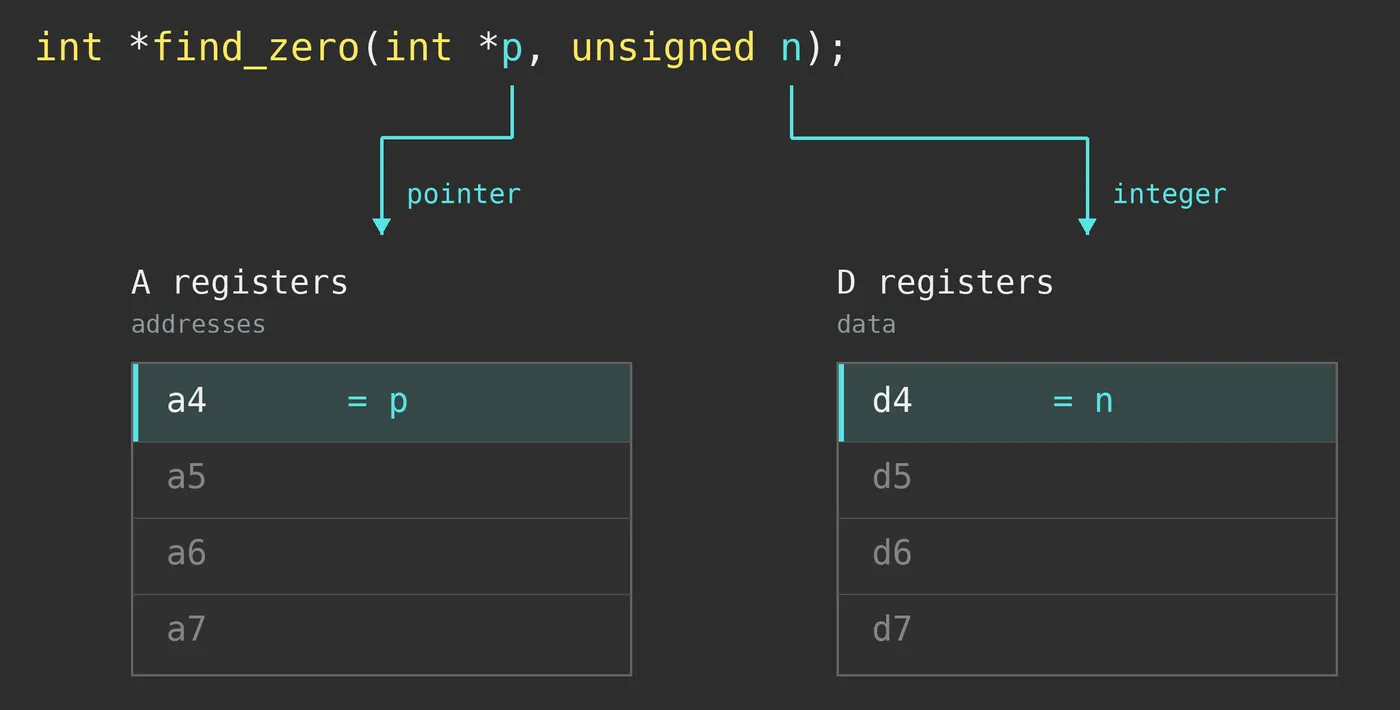
p 通过 a4 传入,而 n 通过 d4 传入。两者分别都是各自寄存器组中的“第一个参数”,因此机器代码与 find_zero(unsigned n, int *p) 的机器代码完全相同。参数的顺序根本不会出现在二进制文件中。9.5 让反编译器核心理解独立的地址寄存器。每个寄存器组分别进行填充,当某个参数无法放入所属寄存器组的寄存器时,就会放到栈上,而指针参数和返回值也会在 A 寄存器中得到识别。相同的函数会被反编译为:
int *__fastcall find_zero(int a1, int *a2)
{

  int *result; // a2
  int v3; // a3
  ...
要修改 ABI,请使用 "Options/Compiler"。要调整函数参数顺序,请使用 "Set item type"(或 Y 快捷键)。
除法步骤折叠
DIV 指令是在 TriCore 1.6 中加入的。较早的核心,以及大量仍然针对这些核心构建的代码,会通过多个步骤执行除法:dvinit 准备操作数,每个 dvstep 产生 8 位商,而 dvadj 修正符号。因此,一个有符号的 32 位除法就是 dvinit + 四次 dvstep + dvadj,可以直接连续写出,也可以像 Tasking 更常采用的方式一样,通过循环执行四次 dvstep:
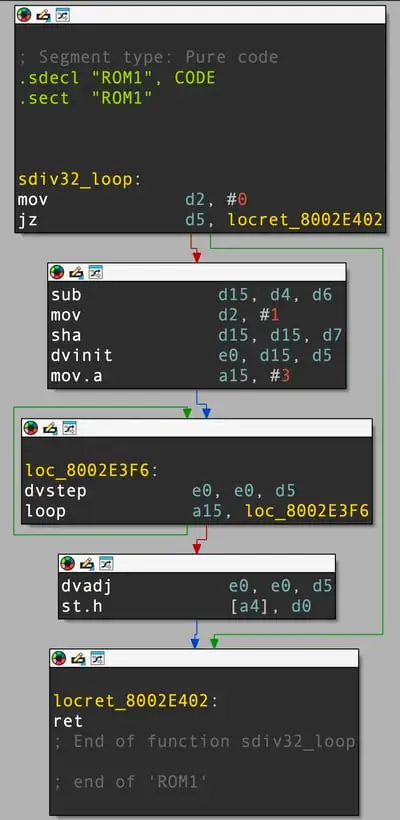
反编译器会展开循环、识别这一模式,并将其折叠为一个单独的除法操作。
int __fastcall sdiv32_loop(int a1, int a2, int a3, char a4, _WORD *a5)
{

  int result; // d2

  result = 0;
  if ( a2 != 0 )
  {

    *a5 = __sha(a1 - a3, a4) / a2;
    return 1;
  }
  return result;
}
反汇编器改进
- 在原始 flash dump 中,函数发现功能可以根据栈帧设置识别函数,并根据上下文保存识别中断处理程序
- 寄存器跟踪器可以解析诸如 e4 这样的 64 位寄存器对,即使两个半寄存器是由不同指令设置的
- 移位计数以及 BISR、SYSCALL 和 HVCALL 的立即数都会按照实际位宽进行解码
Hexagon:一切同时发生
Hexagon 指令会被分组成最多包含四条指令的 packet,而一个 packet 的执行方式就像一条单独的指令。这使得从上到下阅读反汇编代码变得困难,而在 9.5 中,反编译器会替你处理这一点。
谜题
下面是 Hexagon DSP 镜像中的 time(),包含它的全部三个 packet:
{
    call sys_time
    r16 = r0
    memd(sp + #-8+saved_r16_r17) = r17:16
    allocframe(#8)
}
{
    p0 = cmp.eq(r16, #0)
    r17:16 = memd(sp + #8+saved_r16_r17)
    if (!p0.new) memw(r16) = r0
}
{
    dealloc_return
}
从上到下阅读时,看起来函数首先调用 sys_time,然后将 r0 复制到 r16。Packet 2 看起来又恢复了 r16,然后通过它进行存储。那么最终写入内存的是什么,又写到了哪里?
实际上,一个 packet 中的指令通常看到的是 packet 开始执行时寄存器的状态,而它们产生的结果只有在 packet 结束时才会真正生效。即使一个 call 在 packet 中写在最前面,它仍然是最后执行的,这意味着只有 packet 中其他指令都执行完之后,控制流才会进入被调用函数。因此 r16 = r0 复制的是参数,而不是返回结果;而恢复 r16 的操作也不会影响旁边的存储操作。例外是 p0.new:.new 后缀要求使用同一个 packet 中产生的新值,在这里就是它正上方的比较结果。
因此,如果传入的指针不是 null,这个函数就会通过该指针存储 sys_time 的结果。反编译器应用相同的规则后,可以正确得到结果:

按照硬件的方式读取 Packet
为了做到这一点,反编译器会将一个 packet 整体进行 lifting,而不是一次处理一条指令:
- 分支和调用会移动到 packet 的末尾,这也会使调用参数位于 call 之前
- 如果一个寄存器既被 packet 读取又被覆盖,那么会先将其复制到其他位置,这样读取操作看到的就是旧值,除非它通过
.new请求新值 - 硬件循环的回边编码在 packet 的解析位中,而不是某条指令中,因此最终会被表示为循环
反汇编器改进
反汇编器在这一过程中也获得了大量改进。现在可以解析 GP-relative 操作数,并识别更多 switch 模式。处理器选项可以在 ida.cfg 中设置。
AVX 和 SSE:提升为 Intrinsics
9.5 对 AVX 和 AVX2 进行了 lifting,并且对 movq、movlhps 和 punpcklqdq 等 SSE 指令进行了更加精确的 lifting。大多数指令都会变成你手工编写时会使用的 intrinsics。位运算、标量 min/max、FMA 以及普通的加载和存储会变成普通 C 代码,然后反编译器可以进一步对其进行简化。
下面是几个前后对比:
Intrinsics
// 9.4
void __fastcall q__mm256_add_pd(__int64 _RCX)
{

  __asm
  {

    vmovapd ymm0, ymmword ptr [rcx]
    vaddpd  ymm0, ymm0, ymmword ptr [rdx]
  }
}

// 9.5
__m256d __fastcall q__mm256_add_pd(__m256d *m1, __m256d *m2)
{

  return _mm256_add_pd(*m1, *m2);
}
第二个参数和返回类型也恢复出来了。
折叠
编译器会通过将寄存器与自身进行 XOR 来将其清零,并使用掩码翻转或清除符号位。由于这些操作会被 lifting 为普通的 ^ 和 &,反编译器可以对其进行简化:
vpxor   xmm0, xmm0, xmm0
->  return 0.0;

vxorpd  xmm0, xmm0, xmmword ptr signmask_pd
->  *(_QWORD *)&result = *(_QWORD *)&a ^ signmask_pd;

vandpd  xmm0, xmm0, xmmword ptr absmask_pd
->  *(_QWORD *)&result = *(_QWORD *)&a & absmask_pd;
更容易阅读的数学运算
vmaxss  xmm0, xmm0, xmm1

vminss  xmm0, xmm0, xmm2
->  return fminf(fmaxf(a1, a2), a3);


vfmadd132sd xmm0, xmm1, xmm2
->  return a1 * a3 + a2;
向量加载中的字符串
这一项属于反汇编器改进。编译器经常使用 movups 每次复制 16 字节的短字符串字面量,而 IDA 过去会将每一部分定义为一个 xmmword。现在它可以识别出字符串:
; 9.4
movups  xmm0, cs:xmmword_140224F2C

; 9.5
movups  xmm0, xmmword ptr cs:aErrorUnknownGl ; "ERROR: UNKNOWN GLFW ERROR"
游戏主机:保存(以及恢复)你的进度
主机编译器经常通过共享辅助函数来保存和恢复被调用者保存寄存器。函数可能会在序言中调用其中一个辅助函数,或者以跳转到其中一个辅助函数的方式结束。9.5 反编译器可以通过名称,或者当二进制文件被剥离符号时通过其形态,在 PS3、Xbox 360 和 Wii U 上识别这些辅助函数,并将它们从伪代码中排除。
Sony PlayStation 3 (TM)
Cell 是一款运行 32 位指针代码的 64 位 PowerPC,而反编译器现在理解这种模型。指针为 32 位,寄存器保持 64 位,函数也会以正确的返回方式结束。TLS 变量同样可以得到解析,而通过 TOC 加载的字符串字面量会直接出现在伪代码中。此外,DWARF 会将浮点参数放入正确的 PowerPC 寄存器,因此接受 float 或 double 的函数现在能够获得正确的函数原型。
Microsoft Xbox 360 (TM)
一个跳转到恢复辅助函数的函数尾部:
// 9.4
  sub_80062000(v4);
  JUMPOUT(0x80078B0C);

// 9.5
  sub_80062000(v4);
  return v6;
AltiVec 和 VMX128 指令现在会变成与 Microsoft Xbox 360(TM) SDK 中命名方式一致的 intrinsics,而不再是 __asm:
do
{

  v4 = __vmaddfp(*result++, *a2++, v4);
  --a3;
}
while ( a3 != 0 );
缓存、屏障和特殊寄存器指令现在也会变成 intrinsics,而 .pdata 条目则会按照 Microsoft Xbox 360(TM) 的布局进行解码。
Nintendo Wii U (TM)
Green Hills 工具链拥有自己的辅助函数,其中一些还会分配栈帧。9.5 会像处理其他序言一样,将它们折叠到栈帧中。
Sony PSP (TM)
ELF 加载器现在还支持 PSP PRX 重定位。
Arm、MIPS 和 ARC:老朋友的新技巧
9.5 中并非所有内容都是全新的反编译器。IDA 多年来一直支持的三个架构也获得了一轮更新。
Armv9
Arm 反汇编器现在可以解码大量最新扩展:SVE2.1 和 SME2.1、SME2 点积和外积、带提示的条件分支(FEATHBC)、比较并分支(FEATCMPBR)、查找表(FEATLUT)、经过检查的指针运算(FEATCPA)、64 字节加载和存储(FEATLS64)、内存复制和设置(FEATMOPS),以及 SVE 和 SME 的 BF16、FP16 和 I16I64 变体。
最新加入的是来自 Armv9.5 的 FEATPAuthLR,苹果最新的内核已经在使用它。函数使用 PACIBSPPC 对返回地址进行签名,并通过 RETABSPPC 返回,后者以函数自身地址作为操作数。IDA 会创建这些函数、找到它们的结束位置,并将返回指令关联回函数:
_bzero
        PACIBSPPC
        STP             X29, X30, [SP,#-0x10+var_s0]!
        MOV             X29, SP
        ...
        MOV             SP, X29
        LDP             X29, X30, [SP+var_s0],#0x10
        RETABSPPC       _bzero
MIPS Release 6
Release 6 对 MIPS 指令集进行了整理,并重新利用释放出来的操作码来加入新指令。紧凑型分支和跳转没有延迟槽,seleqz/selnez 取代了 movz/movn,乘法和除法会将结果写入通用寄存器,而不是 HI/LO,浮点比较则会在 FP 寄存器中留下掩码,而不是设置条件标志。IDA 9.5 增加了对 MIPS32/64 Release 6 的解码和反编译支持:
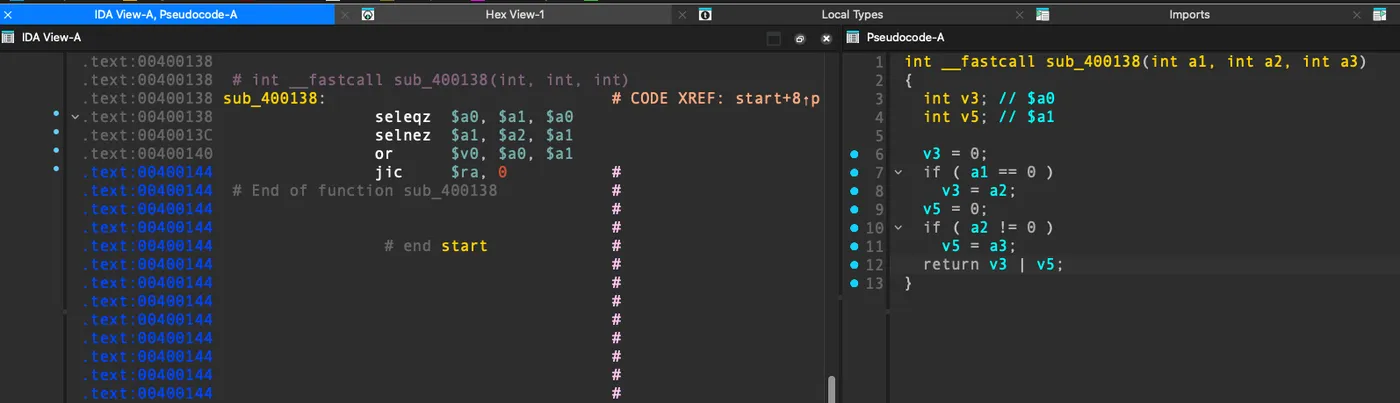
Release 6 会根据 ELF header 自动检测。对于原始固件镜像,可以在处理器选项中勾选 "Release 6 instruction set"。
ARC
ARC 反编译器现在支持 enter_s/leave_s、乘法、除法和取余指令、setcc、min/max,以及 bi/bih switch 跳转。它还能够识别用于保存和恢复寄存器的 MetaWare millicode 辅助函数,并恢复可变参数函数的参数。
// 9.4
void __fastcall sub_10006D9C(unsigned __int16 *a1)
...
  if ( v5[2] == 0 && v7 > 0xF1 )
    __asm {
    leave_s {
   r13,blink,pcl} }
  __asm {
    leave_s {
   r13,blink,pcl} }
}

// 9.5
int __fastcall sub_10006D9C(_WORD *a1)
...
    if ( v1[2] != 0 || v3 <= 0xF1 )
      return 132 * (unsigned __int16)v3 + 13;
    else
      return 108 * (unsigned __int16)v3 + 5821;
试试看
请访问原文链接或者作者主页。



