本文由 重庆典名科技有限公司『阿里云旗舰级代理商,钉钉六星级钻石服务商,千问办公FDE服务商』撰写,如需转载请注明!
过去两年,我们服务的企业客户里,几乎每一个都会在项目启动时问同一个问题:"我们该选哪个模型?"但在实际交付过程中,真正决定项目成败的,几乎从来不是这个问题的答案。
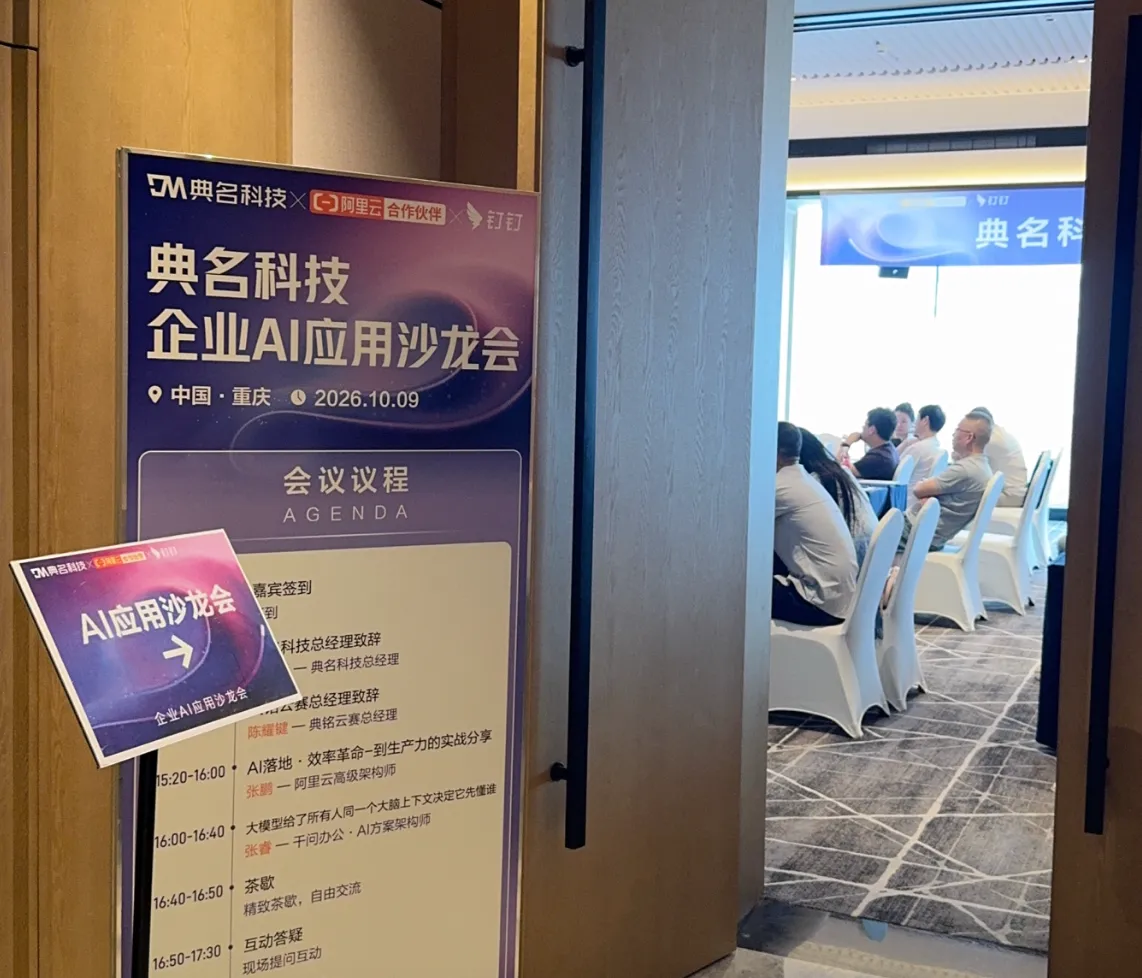
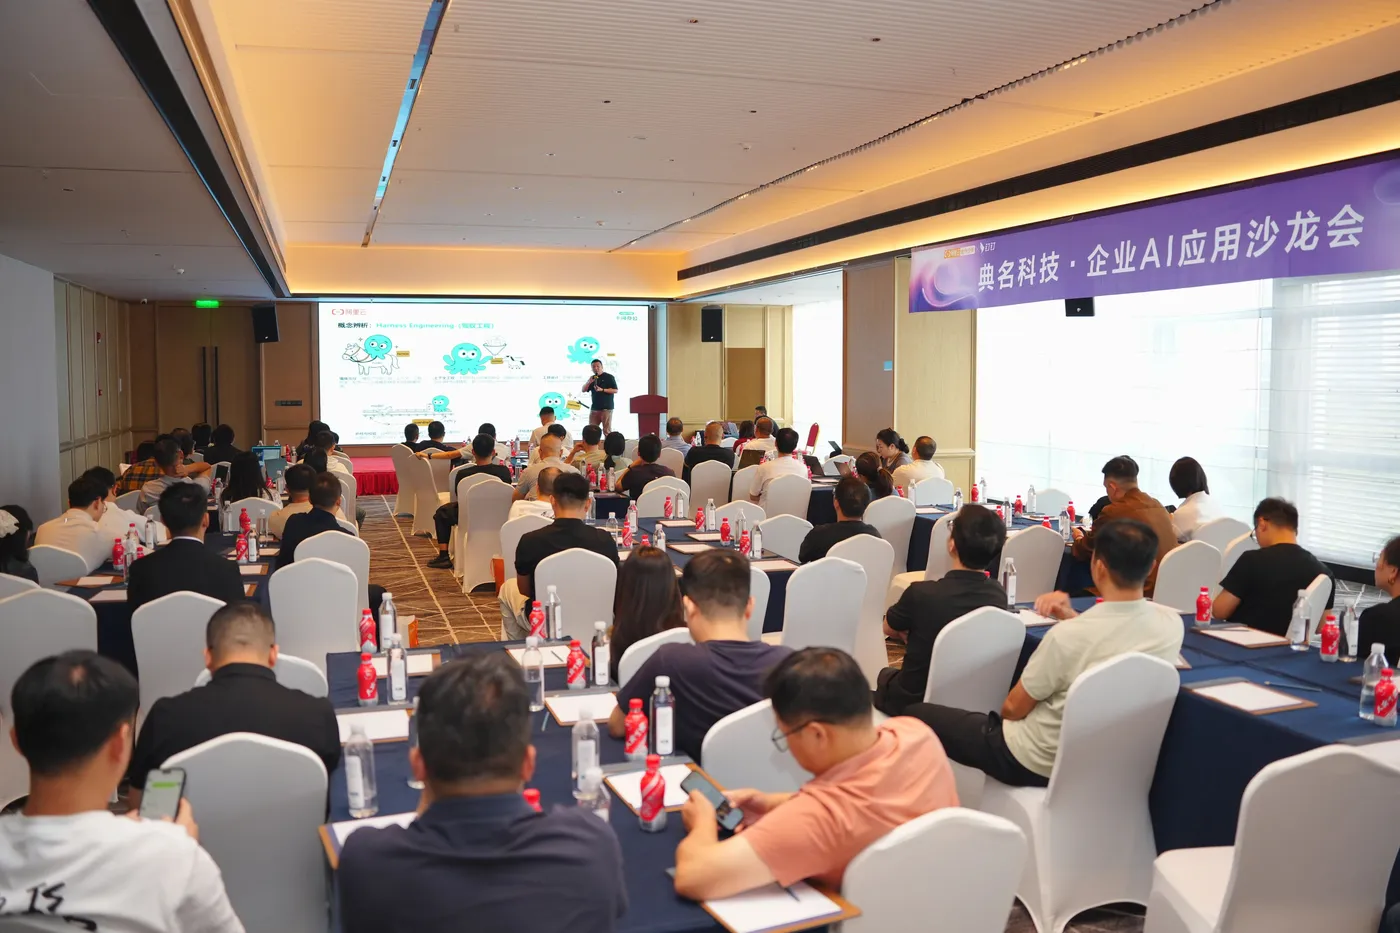
10月9日,在重庆举办的一场企业AI应用沙龙上,来自全国各地的100多名企业主和CIO把现场提问环节排得满满当当。有意思的是,被追问最多的不是模型参数和跑分,而是一个更现实的问题:为什么很多企业上了AI,效果却停留在"内部试用"和"演示汇报"层面?
现场有参会者引用了麦肯锡的调研数据:真正把AI用出价值的企业只有约5%,另有约75%的企业虽然做了投入,但更接近一场"表演"。这个数字和我们在客户现场看到的体感基本一致。
这篇文章把沙龙现场讨论密度最高的七个问题做一个整理复盘,附上我们自己在交付项目中的一些补充观察,供正在规划企业AI落地的技术团队参考。
一、先数字化,还是先智能化?
这是现场形成共识最明确的一个问题:先数字化、再智能化,顺序不能反。
很多企业想一步跨进"智能化",却发现自己并没有数字化基建——日常的沟通、审批、流程、数据从未被系统沉淀下来。没有结构化的业务数据,AI既"看不见"这家公司的运转方式,也无从学起。
一个正在发生的趋势是,作为办公与流程载体的IM平台(钉钉、企业微信、飞书等)正被重新定义为"企业上下文的容器":通讯录、权限、审批、会议纪要、群聊记录天然沉淀其上,这些恰恰是AI理解一个组织最需要的底层素材。如果这些数据还散落在个人电脑和口头沟通里,第一步要做的不是选模型,而是补数字化这一课。
二、上下文:模型趋同之后,差距从哪里来?
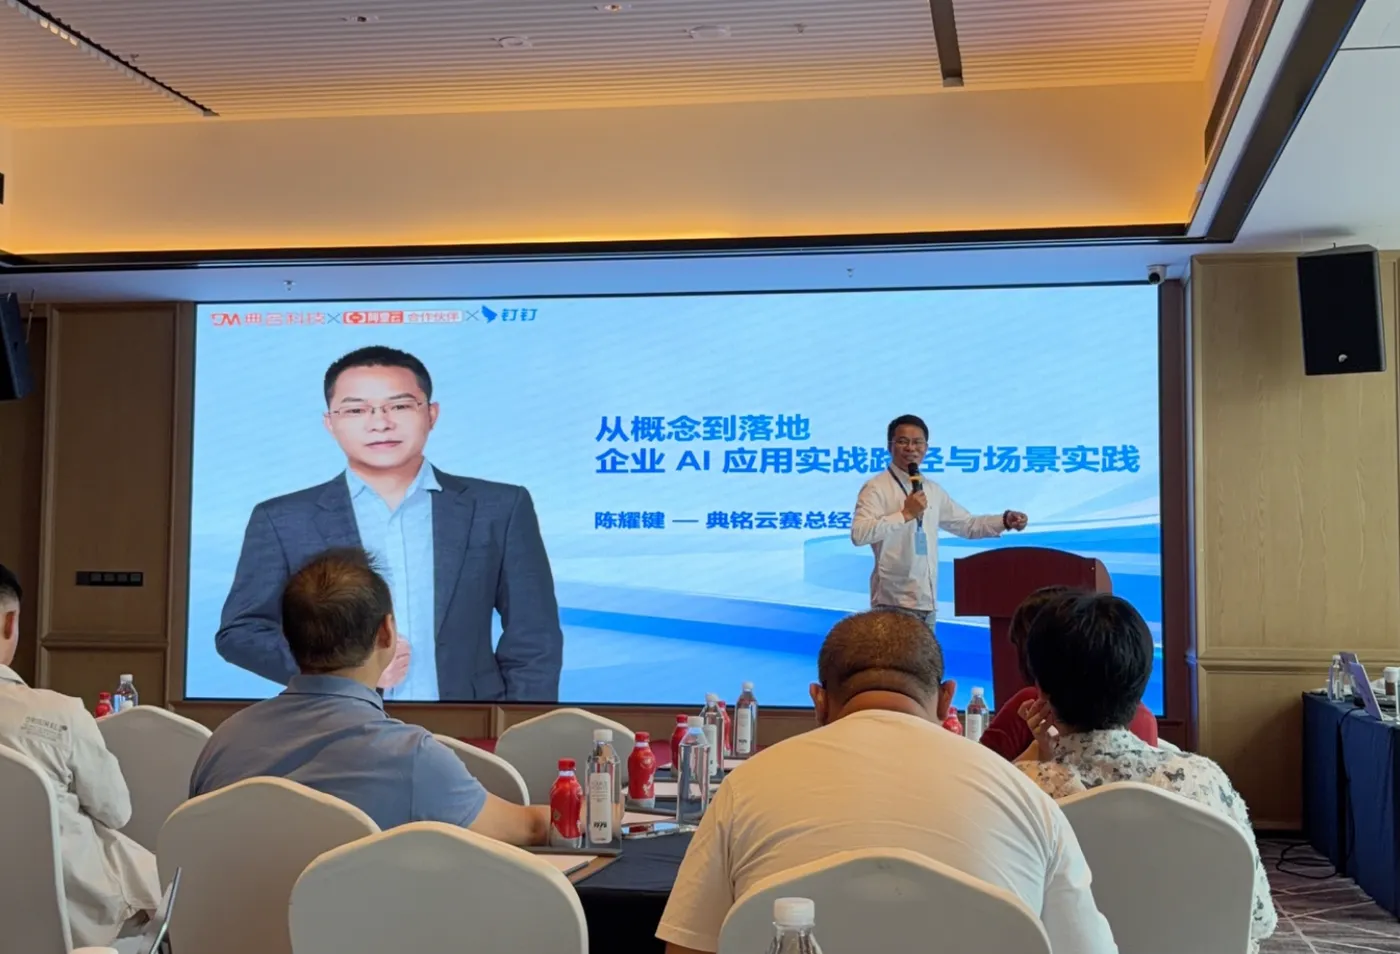
沙龙上被引用最多的一句话,来自千问办公CEO陈宇森在今年云栖大会上的判断:大模型是"同一个大脑",你喂给它的上下文,决定了它先懂谁。
打个比方:一个名校毕业、智商顶尖的新人,因为没有企业上下文,不知道某个项目为什么这么定、该找谁拍板;而一个有五年工龄的老员工,上个季度的方案为何被否、业务红线在哪里,往往门儿清。差别不在聪明,在于对组织的理解。
落到工程层面,这意味着当模型能力趋于同质后,企业之间拉开差距的变量,从"用了哪家模型"变成了"AI掌握了多少关于这家企业的知识"。前者是采购问题,后者是工程问题——这也是"上下文工程"这个概念近两年快速升温的原因。
三、智能体落地三要素:信息、工具、边界
抛开"提示词工程""上下文工程""驾驭工程"这些层出不穷的新词,现场对智能体(Agent)落地的拆解被归结为一套类似"带新人入职"的三要素方法论:
| 要素 | 做什么 | 解决什么问题 |
| 信息 | 把企业规范、知识、流程结构化 | 让AI"看得见"公司 |
| 工具 | 为AI开放账号、打通ERP/CRM等业务系统 | 让AI"干得了活"而不只是聊天 |
| 边界 | 明确哪些数据可读、可改、绝不能碰,设置验收与复核机制 | 让AI"靠得住" |
在三个要素之上,还有三个可复用的落地构件值得单独关注:
- Skill(技能):把一件事的做法沉淀成"技能手册",AI调用的是标准动作而不是自由发挥;
- 连接器:打通某个具体系统,让AI能读到该系统里的实时数据;
- 插件:面向财务、法务等具体角色打包一组能力的组合交付。
现场一位分享者给出的判断标准值得记下来:所有可复用的东西,对企业来说都是资产。给一个AI装上法务插件,它就是一个法务;装三份,就是三个法务——能力第一次具备了被批量复制的可能。
四、数据安全:分层防护,而不是一口答应或一口回绝
对企业决策者而言,现场提问最集中的仍是数据能否安全落地。这里把现场给出的分层方案整理成一张表:
| 安全层级 | 机制 | 适用场景 |
| 基础层 | 企业侧"碎纸机"机制:只做推理、云端不存储客户数据、不用于模型训练 | 大多数企业的日常场景 |
| 权限层 | AI可访问的内容完全绑定使用者在既有办公平台中的权限,个人单聊等隐私数据不因此被公司获取 | 涉及多部门数据隔离的组织 |
| 增强层 | 签署保密协议 | 有合规审计要求的客户 |
| 高阶层 | VPC私有云 / 本地化部署 | 数据强监管行业 |
需要特别说明的是B端与C端的差异:企业侧方案和个人侧产品在数据留存策略上完全不同,选型时建议直接向厂商索取数据流向说明,而不是套用个人版的使用经验。
五、存量系统打通:从RPA到MCP的渐进路径
第二道现实关口是与存量系统的打通。现场给出的路径是分层的,我们结合项目经验补充了适用判断:
- 低频场景:先以账号密码的RPA方式跑通。改造成本最低,适合先验证业务价值,但稳定性依赖界面不变;
- 高频或复杂场景:对软件进行改造、开放API或MCP接口。一次性投入更高,但长期稳定性好,是值得投入的方向;
- 一条红线:不直接向AI开放数据库写权限。所有写操作应经过业务系统校验,AI最多"建议",落库动作由系统完成。
六、知识库建设:清洗与检索优先于微调
现场多位技术背景参会者的困惑高度一致:海量非结构化数据与有限的上下文窗口之间的矛盾。把成堆PDF塞给模型显然不现实,那微调是不是出路?
现场分享者的判断是:核心不在喂多少数据,而在数据质量。建议的路径是:
- 先做数据清洗与结构化,把非结构化文档变成可检索的知识条目;
- 通过检索(RAG)与多轮调用,按需取回最相关的内容;
- 至于微调基础模型——"收益不高、耗资源,现阶段不建议动",除非有非常明确且稳定的领域语料和评测基准。
这个判断和我们自己的交付经验一致:大多数企业的知识库问题出在"脏"而不是"少",清洗和结构化的投入产出比远高于微调。
七、FDE:填平从"用到"到"用好"的鸿沟
沙龙上另一个被反复提及的角色是前沿部署工程师(FDE)。一个值得注意的行业信号是,OpenAI与Anthropic今年几乎同时强化了类似的驻场服务岗位——原因在于,除最头部的互联网公司外,多数企业把AI拿回去往往用不起来,中间缺的正是一个天天泡在客户现场、帮着找场景、做部署、跑出真实价值的人。
对企业侧而言,这类服务是留住客户的关键:AI像电,不好用就不会有第二次付费。我们在交付中的体感也是这样——模型能力越强,"最后一公里"的组织适配工作反而越重。
常见问题(FAQ)
问:我们企业数字化基础比较弱,现在上AI是不是太早了?
答:不建议跳过数字化直接上AI。可以先从IM平台沉淀通讯录、审批、流程数据做起,这些是AI理解组织最基础的上下文素材;数字化和智能化可以分阶段推进,但顺序不能反。
问:把ERP/CRM开放给AI,数据安全怎么保障?
答:分层处理——基础层依赖推理不留存机制;权限层把AI的访问范围绑定到使用者在办公平台中的既有权限;更高要求可以签保密协议或采用VPC私有云、本地化部署。同时守住一条红线:不直接向AI开放数据库写权限。
问:知识库文档很多,是先微调模型还是先做RAG?
答:先做数据清洗、结构化和检索。微调收益不高且耗资源,现阶段不建议动。大多数企业的知识库问题出在数据"脏"而不是"少",清洗和结构化的投入产出比更高。
结语
从这场沙龙的讨论密度可以看出,企业AI的叙事重心正在从"选哪个模型"转向"如何沉淀上下文、打通工具、管住边界"。当模型能力趋于同质,真正拉开差距的,是组织知识资产的沉淀和落地陪跑的能力。
对企业决策者来说,问题也因此变得更朴素:不是"要不要上AI",而是"有没有把公司的经验,变成AI读得懂、用得上的上下文"。
说明:文中麦肯锡调研数据为公开行业口径,具体比例以原报告发布为准。本文基于公开讨论内容的一般性整理,涉及产品能力以各厂商官网当期公示为准。
如需了解阿里云生态伙伴的服务能力,可在阿里云官方伙伴查询页(partner.aliyun.com)按企业全称检索验证。